
GPT-Live-1.1 กับ GPT-Realtime ต่างกันที่สถาปัตยกรรม GPT-Live-1.1 เป็นฟรอนต์เอนด์เสียงแบบฟูลดูเพล็กซ์ที่ส่งงานการคิดวิเคราะห์และเครื่องมือไปให้โมเดลแบ็กเอนด์แยกต่างหาก คิดค่าบริการ $0.05 ต่อนาทีที่ใช้งาน GPT-Realtime-2.1 เป็นโมเดล speech-to-speech โมเดลเดียวที่ฟัง คิดวิเคราะห์ เรียกใช้เครื่องมือ และพูดได้ในตัว คิดค่าบริการตามโทเคน เลือก GPT-Live-1.1 เมื่อคุณมีเอเจนต์ข้อความอยู่แล้ว เลือก Realtime เมื่อคุณต้องการให้โมเดลเดียวทำงานทุกอย่าง
OpenAI เปิดตัว GPT-Live-1.1 ใน API เมื่อวันที่ 20 พฤศจิกายน 2026 ตอนนี้คุณจึงมีสแต็กเสียงสองแบบที่มีเอนด์พอยต์ การคิดค่าบริการ และโมเดลเครื่องมือแตกต่างกัน โพสต์ GPT-Live vs GPT-Realtime ของเราเมื่อเดือนกรกฎาคมเปรียบเทียบฟีเจอร์ ChatGPT กับ API ส่วนโพสต์นี้เป็นการเทียบ API กับ API
ภาพรวม GPT-Live-1.1 vs GPT-Realtime
นี่คือการเปรียบเทียบสแต็กทั้งสองแบบ โดยอ้างอิงจากหน้าโมเดล GPT-Live-1.1, หน้าโมเดล gpt-realtime-2.1 และหน้าราคา OpenAI ณ วันที่ 20 พฤศจิกายน 2026:
| GPT-Live-1.1 | gpt-realtime-2.1 | |
|---|---|---|
| เอนด์พอยต์ | v1/live/sessions |
v1/realtime |
| การออกแบบ | เสียงแบบฟูลดูเพล็กซ์พร้อมแบ็กเอนด์ที่มอบหมายงาน | โมเดลคิดวิเคราะห์ speech-to-speech แบบเดียว |
| อินพุต | เสียง, ข้อความ | เสียง, ข้อความ, รูปภาพ |
| เอาต์พุต | เสียง, ข้อความ | เสียง, ข้อความ |
| การคิดค่าบริการ | $0.05/นาทีที่ใช้งาน, $0.02/นาทีแบบสแตนด์บาย | $32 ขาเข้า, $64 ขาออก ต่อ 1M โทเคนเสียง |
| การคิดวิเคราะห์และเครื่องมือ | โมเดลแบ็กเอนด์ คิดค่าบริการแยก | รวมอยู่ในโมเดลและราคาเดียวกัน |
| การเรียกฟังก์ชัน | ผ่านการมอบหมายงาน | session.tools |
| ทรานสปอร์ต | WebRTC, WebSocket, SIP (ขาเข้าและขาออก) | WebRTC, WebSocket, SIP (ขาเข้า) |
| ขีดจำกัดอัตรา | เซสชันพร้อมกัน | คำขอและโทเคนต่อนาที |
คู่มือ voice agents ของ OpenAI สรุปความแตกต่างไว้ในตารางสถาปัตยกรรม GPT-Live ใช้สำหรับ "บทสนทนาแบบฟูลดูเพล็กซ์ที่มีแบ็กเอนด์แยกต่างหาก" ส่วน Realtime API ใช้สำหรับ "เสียง การคิดวิเคราะห์ และการใช้เครื่องมือในเซสชันเดียว"
สถาปัตยกรรม: การมอบหมายงาน vs โมเดลเดียว
GPT-Live-1.1 แยกการพูดออกจากการคิด โมเดลเสียงจัดการบทสนทนาแบบเรียลไทม์และฟังในขณะที่พูด เมื่อมีคำขอที่ต้องการการคิดวิเคราะห์ การค้นหา หรือเครื่องมือ มันจะมอบหมายงานนั้นให้โมเดลแบ็กเอนด์และดำเนินบทสนทนาต่อไปในระหว่างที่งานนั้นทำงานอยู่
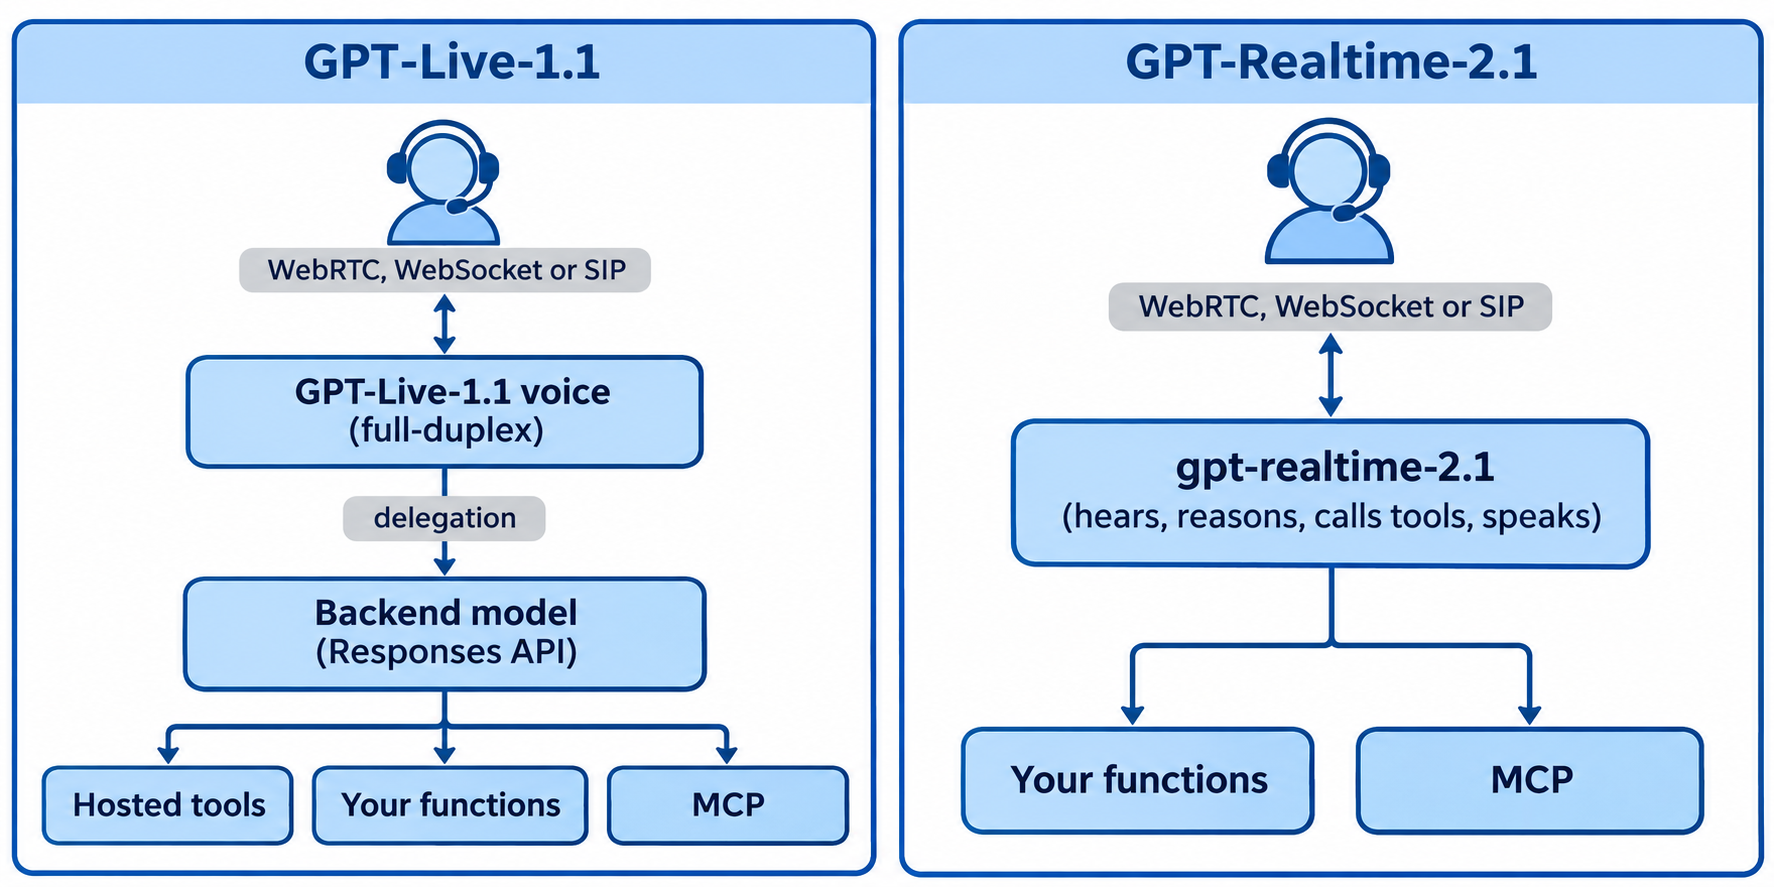
คุณตั้งค่าการมอบหมายงานครั้งเดียวตอนสร้างเซสชัน ตามคู่มือ live conversations ซึ่งมีสองโหมด:
responses: OpenAI รันแบ็กเอนด์ผ่าน Responses API คุณเลือกโมเดลในdelegation.responses.modelและเพิ่มinstructions,tools,tool_choice,reasoningและservice_tierเอกสารแนะนำให้เริ่มต้นด้วยgpt-6-lunaและเปลี่ยนไปใช้gpt-6-solสำหรับงานที่ยากขึ้นclient: แอปของคุณรันแบ็กเอนด์ GPT-Live ส่งอีเวนต์session.delegation.createdและคุณส่งผลลัพธ์กลับด้วยอีเวนต์อย่างsession.instructions.append
ไม่สามารถเปลี่ยนโหมดกลางเซสชันได้ การสลับหมายถึงต้องสร้างเซสชันใหม่ ส่วนการตั้งค่าแบ็กเอนด์ภายในเปลี่ยนได้ด้วย session.update
gpt-realtime-2.1 ใช้แนวทางตรงกันข้าม: โมเดลคิดวิเคราะห์เดียวตีความเสียง เรียกใช้เครื่องมือ และตอบเป็นเสียง ไม่มีโมเดลที่สอง ไม่มีการส่งต่อ และบริบททั้งหมดอยู่ในที่เดียว
ด้วย GPT-Live-1.1 คุณสลับแบ็กเอนด์ได้ หรือเก็บเอเจนต์ข้อความเดิมไว้ได้โดยไม่ต้องแตะชั้นเสียง ส่วน Realtime นั้นโมเดลเสียงคือตัวเอเจนต์เอง
ราคา: ต่อนาที vs ต่อโทเคน
GPT-Live-1.1 คิดค่าบริการตามเวลา ส่วน Realtime คิดตามโทเคน ทำให้ต้นทุนทั้งสองมีพฤติกรรมต่างกันมากเมื่อผู้โทรหยุดพูด พูดเรื่อยเปื่อย หรือถือสายไว้
| รายการต้นทุน | GPT-Live-1.1 | gpt-realtime-2.1 | gpt-realtime-2.1-mini |
|---|---|---|---|
| เสียง | $0.05/นาทีที่ใช้งาน, $0.02/นาทีแบบสแตนด์บาย | $32 ขาเข้า, $64 ขาออก ต่อ 1M โทเคน | $10 ขาเข้า, $20 ขาออก ต่อ 1M โทเคน |
| ข้อความ | คิดตามระยะเวลาเซสชัน | $4 ขาเข้า, $24 ขาออก ต่อ 1M โทเคน | $0.60 ขาเข้า, $2.40 ขาออก ต่อ 1M โทเคน |
| อินพุตแคช | ไม่มี | $0.40 ต่อ 1M โทเคน | $0.30 เสียง, $0.06 ข้อความ ต่อ 1M |
| การคิดวิเคราะห์และเครื่องมือ | โมเดลแบ็กเอนด์ตามอัตราของมันเอง | รวมอยู่ในราคาโทเคน | รวมอยู่ในราคาโทเคน |
GPT-Live คิดค่าบริการตามวินาที สาย 90 วินาทีจึงมีค่าเวลาเสียง $0.075 ไม่ใช่ $0.10 เซสชัน WebRTC คิดค่าบริการ 15 วินาทีระหว่างเริ่มต้นระบบ ซึ่งจะถูกชดเชยคืนเมื่อเริ่มทำงาน
สแตนด์บายคือคันโยกด้านต้นทุนที่ Realtime ไม่มี บน WebRTC ให้ตั้ง wake_policy.type เป็น "speech" และ idle_timeout_s เป็นจำนวนเต็มตั้งแต่ 5 ถึง 60 หลังจากไม่มีเสียงพูดตามจำนวนวินาทีนั้น เซสชันจะลดลงเหลือ $0.02 ต่อนาทีจนกว่าจะมีคนพูดอีกครั้ง สแตนด์บายมีเอกสารระบุไว้สำหรับ WebRTC เท่านั้น เซสชัน WebSocket และ SIP จึงคิดค่าบริการทุกวินาทีที่เชื่อมต่อที่อัตราการใช้งานปกติ
หากต้องการเปรียบเทียบทั้งสองแบบกับทราฟฟิกของคุณเอง ให้ใช้จุดคุ้มทุนแทนการเดา $0.05 ซื้อโทเคนเสียงขาเข้าได้ประมาณ 1,560 โทเคน หรือโทเคนเสียงขาออกประมาณ 780 โทเคนบน gpt-realtime-2.1 และประมาณ 5,000 โทเคนขาเข้าหรือ 2,500 โทเคนขาออกบน 2.1-mini ดึงจำนวนโทเคนเสียงต่อนาทีจากอีเวนต์การใช้งาน Realtime ของคุณ หากนาทีที่ใช้งานเฉลี่ยของคุณใช้มากกว่านั้น เวลาเสียงของ GPT-Live ก็ถูกกว่า จากนั้นบวกบิลโทเคนของโมเดลแบ็กเอนด์เพื่อดูภาพรวมทั้งหมด
Realtime รวมการคิดวิเคราะห์ไว้ในราคาโทเคน ส่วน GPT-Live เพิ่มบิลแบ็กเอนด์ต่องานที่มอบหมาย แต่ลดต้นทุนช่วงเงียบด้วยสแตนด์บาย สำหรับฝั่งโทเคน ดูคู่มือ gpt-realtime-2.1-mini ของเรา
การเรียกฟังก์ชันและเครื่องมือ
ทั้งสองสแต็กเรียกฟังก์ชันของคุณได้ แต่มาจากที่ต่างกัน
บน Realtime เครื่องมืออยู่บนเซสชัน คู่มือเครื่องมือ Realtime แสดงเครื่องมือ "type": "function" ใน session.tools ที่ส่งไปพร้อมกับ session.update ไคลเอนต์ของคุณรันฟังก์ชันและส่งคืนรายการ function_call_output เซิร์ฟเวอร์ MCP ระยะไกลก็ใช้ได้เช่นกัน: เพิ่มเครื่องมือด้วย "type": "mcp", server_label และ server_url แล้ว Realtime API จะเรียกเซิร์ฟเวอร์ให้คุณ นอกจากนี้ยังกำหนดขอบเขตเครื่องมือให้กับเทิร์นเดียวได้ด้วย response.tools
บน GPT-Live-1.1 เครื่องมืออยู่บนแบ็กเอนด์ คุณใส่เครื่องมือฟังก์ชัน เซิร์ฟเวอร์ MCP และเครื่องมือโฮสต์อย่าง web search, file search และ Code Interpreter ใน delegation.responses.tools อีเวนต์ของแบ็กเอนด์จะมาถึงคุณในซอง response.event และผลลัพธ์ฟังก์ชันของคุณจะส่งกลับเป็นรายการ function_call_output ตามด้วย response.create
ข้อดี: เสียงยังคงตอบสนองได้ดีในระหว่างที่เครื่องมือที่ช้าๆ กำลังทำงานในแบ็กเอนด์ ข้อเสีย: สองโมเดล สองสตรีมอีเวนต์ และสองบิล
การผลัดกันพูด การขัดจังหวะ และทรานสปอร์ต
นี่คือจุดที่ทั้งสองให้ความรู้สึกต่างกันมากที่สุดต่อผู้โทร
การผลัดกันพูด GPT-Live-1.1 เป็นฟูลดูเพล็กซ์: ประมวลผลเสียงขาเข้าในขณะที่สร้างเอาต์พุต จึงสามารถฟัง ส่งเสียงตอบรับ และปรับกลางประโยคได้ Realtime ทำงานเป็นเทิร์นที่ตรวจด้วย voice activity คู่มือ Realtime VAD ระบุสองโหมดใน session.audio.input.turn_detection.type:
server_vadโหมดเริ่มต้น ปรับแต่งด้วยthreshold,prefix_padding_msและsilence_duration_mssemantic_vadปรับแต่งด้วยeagerness(low,medium,highหรือautoซึ่งเท่ากับmedium)
Realtime จัดการการแทรกพูดขัดด้วย interrupt_response ส่วน GPT-Live ไม่ต้องการการตั้งค่านั้นเพราะมันฟังอยู่แล้วในขณะที่พูด
ทรานสปอร์ต ทั้งสองรองรับ WebRTC ในเบราว์เซอร์และ WebSocket บนเซิร์ฟเวอร์ การโทรศัพท์แตกต่างกัน ตามคู่มือ SIP GPT-Live รองรับ SIP ขาเข้าและขาออก และการโทรขาออก "ใช้ได้กับทุกองค์กรผ่าน Live API ไม่ใช่เอนด์พอยต์สร้างการโทรของ Realtime API" การโทร SIP ของ GPT-Live ที่เชื่อมต่อแล้วจำกัดที่ 2 ชั่วโมง คู่มือ SIP ของ Realtime ครอบคลุมการโทรขาเข้าผ่านเว็บฮุก realtime.call.incoming
ขีดจำกัดและบริบท
| ขีดจำกัด | GPT-Live-1.1 | gpt-realtime-2.1 |
|---|---|---|
| บริบท | 128,000 โทเคนต่อเซสชัน จัดการอัตโนมัติ | 128,000 โทเคน |
| โทเคนเอาต์พุตสูงสุด | ไม่เปิดเผย | 32,000 |
| คำสั่ง (instructions) | สูงสุด 16,384 โทเคน | ไม่เปิดเผย |
| ขีดจำกัดอัตรา | เซสชันพร้อมกัน ต่อโมเดล | 400 RPM และ 200,000 TPM บนระดับ Build |
GPT-Live นับจำนวนคอนเคอเรนซี ไม่ใช่โทเคน หน้า GPT-Live-1 ระบุ 50 เซสชันพร้อมกันบน Build, 300 บน Launch และ 500 บน Grow โดยไม่มีสิทธิ์เข้าถึงระดับ Free GPT-Live-1.1 มีขีดจำกัดแยกของตัวเอง และหน้ายังไม่เปิดเผยตัวเลข ดังนั้นควรตรวจสอบหน้าขีดจำกัดขององค์กรก่อนเปิดตัว
ขีดจำกัดของ Realtime ขยายได้ถึง 10,000 RPM บน Launch และ 20,000 RPM บน Grow
คุณควรใช้ OpenAI voice API ตัวไหน?
ใช้ GPT-Live-1.1 เมื่อเสียงเป็นชั้นที่วางทับบนเอเจนต์ที่คุณไว้วางใจอยู่แล้ว และใช้ Realtime เมื่อโมเดลเสียงควรเป็นตัวเอเจนต์เอง
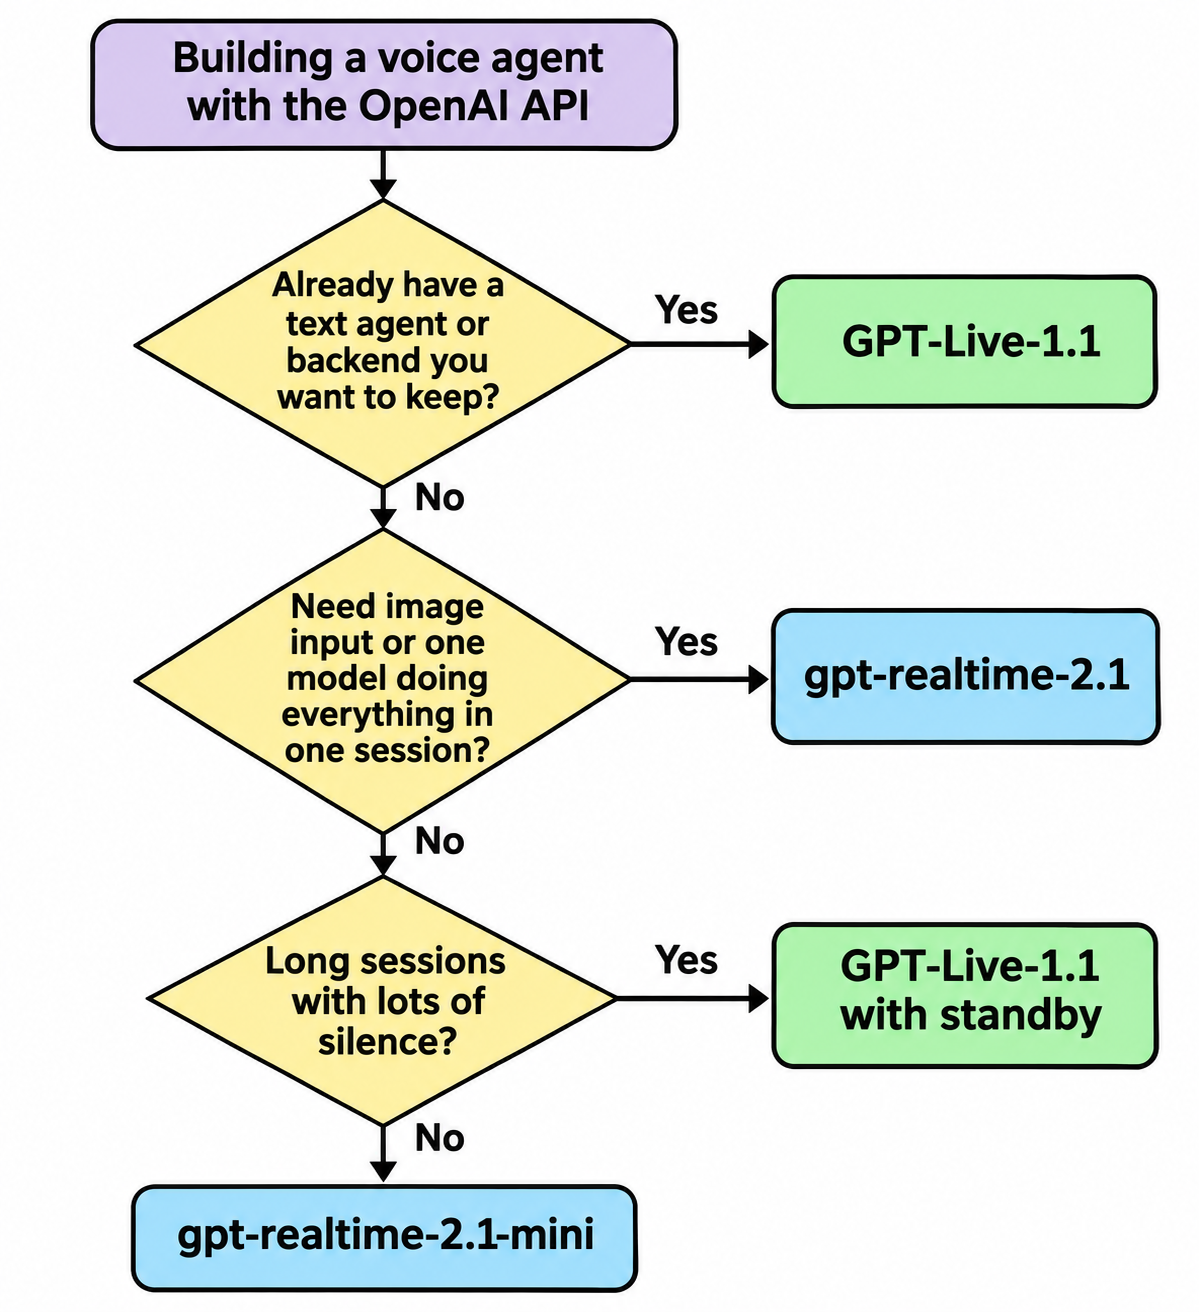
เลือก GPT-Live-1.1 เมื่อ:
- เพิ่มเสียงให้กับเอเจนต์ข้อความ บอทช่วยเหลือ หรือเวิร์กโฟลว์ที่มีอยู่โดยไม่ต้องสร้างใหม่
- เซสชันยาวที่มีช่วงเว้นว่าง เช่น การติว การโค้ช หรือคู่หู ที่สแตนด์บายคุ้มค่า
- การโทรศัพท์ขาออก ซึ่งมีเฉพาะ Live API เท่านั้นที่เสนอให้
- บทสนทนาที่ต้องการการพูดทับซ้อนและเสียงตอบรับอย่างเป็นธรรมชาติ
เลือก gpt-realtime-2.1 เมื่อ:
- เอเจนต์เสียงแบบครบในตัวเองที่ต้องการให้โมเดลเดียวคิดวิเคราะห์และลงมือทำ
- แอปที่ส่งรูปภาพพร้อมกับเสียง
- ทีมที่ต้องการสตรีมอีเวนต์เดียวและบิลเดียว
เลือก gpt-realtime-2.1-mini สำหรับงานเสียงสั้น ปริมาณสูง ต้นทุนต่ำ ที่ราคาต่อโทเคนคุ้มกว่าราคาต่อนาที คู่มือ GPT-Realtime-2 API ของเราครอบคลุมการตั้งค่า Realtime อย่างละเอียด
ให้ coding agent ของคุณทดสอบ tool API ด้วย Apidog CLI
ไม่ว่าสแต็กไหนจะชนะ ทั้งสองก็เรียกสิ่งเดียวกัน: tool API ของคุณ การค้นหาที่ช้าก็คือช่วงเงียบตายทั้งสองทาง ดังนั้นควรทดสอบความหน่วงและสัญญาของมันก่อนที่ผู้โทรจะได้ยิน ให้ Claude Code, Codex หรือ Cursor ทำสิ่งนั้นด้วย Apidog CLI
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
จากนั้นให้พรอมป์ต์เดียวกับเอเจนต์ของคุณ:
Import ./voice-tools-openapi.yaml into Apidog project <projectId>. Build a test scenario
that calls GET /orders/{order_id} and GET /customers/{id} in sequence, asserts 200 and
the fields my voice agent reads aloud, and fails any request slower than 800 ms.
Run it 20 times against staging and tell me which step is slowest.
เอเจนต์จะนำเข้าสเปก ตรวจสอบรูปร่างเพย์โหลด สร้างสถานการณ์ทดสอบ และรันมัน:
apidog import --project <projectId> --format openapi --file ./voice-tools-openapi.yaml
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointIds> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <envId> -n 20 --timeout-request 800 -r cli,json
-n 20 รันซ้ำเพื่อไม่ให้การตอบกลับที่โชคดีครั้งเดียวกลบหางที่ช้า และ --timeout-request 800 ทำให้การเรียกใดๆ ที่ช้าพอจะทำให้ผู้โทรต้องรอ ล้มเหลว เปลี่ยน -r cli,json เป็น -r junit ใน CI เพื่อให้การถดถอยบล็อกการดีพลอย ตามที่คู่มือ Apidog CLI CI/CD ของเราแสดงไว้ เพิ่งเริ่มต้นกับเวิร์กโฟลว์เอเจนต์ใช่ไหม? เริ่มจากApidog CLI ใน Claude Code แผนฟรีของ Apidog ครอบคลุมผู้ใช้สูงสุด 4 คน
คำถามที่พบบ่อย
อะไรถูกกว่า GPT-Live-1.1 หรือ GPT-Realtime? ขึ้นอยู่กับโทเคนเสียงต่อนาทีและแบ็กเอนด์ของคุณ เสียงของ GPT-Live มีค่าใช้จ่าย $0.05 ต่อนาทีที่ใช้งาน บวกโทเคนของโมเดลแบ็กเอนด์ บน gpt-realtime-2.1 นั้น $0.05 ซื้อโทเคนเสียงขาเข้าได้ประมาณ 1,560 โทเคน หรือโทเคนเสียงขาออก 780 โทเคน เปรียบเทียบกับบันทึกการใช้งานของคุณเอง
ใช้การเรียกฟังก์ชันกับ GPT-Live-1.1 ได้ไหม? ได้ ผ่านการมอบหมายงาน ใส่เครื่องมือฟังก์ชันใน delegation.responses.tools หรือรันแบ็กเอนด์เองในโหมด client delegation โมเดลเสียงไม่ได้รับรายการเครื่องมือโดยตรงเหมือน session.tools ของ Realtime
GPT-Realtime รองรับการคิดค่าบริการแบบสแตนด์บายไหม? ไม่ สแตนด์บายที่ $0.02 ต่อนาทีเป็นฟีเจอร์ของ GPT-Live และเฉพาะเซสชัน WebRTC ที่ตั้งค่าด้วย wake_policy และ idle_timeout_s เท่านั้น Realtime คิดค่าบริการตามโทเคนที่แต่ละเซสชันใช้
GPT-Live-1.1 โทรศัพท์ขาออกได้ไหม? ได้ สร้างเซสชันด้วย transport.type: "sip" และรายละเอียด SIP trunk ของคุณบน POST /v1/live/sessions เอกสารของ OpenAI ระบุว่า SIP ขาออกทำงานผ่าน Live API ไม่ใช่เอนด์พอยต์สร้างการโทรของ Realtime API
GPT-Live-1.1 รับอินพุตรูปภาพไหม? ไม่ หน้าโมเดลระบุเสียงและข้อความทั้งขาเข้าและขาออก หากเอเจนต์เสียงของคุณต้องมองเห็นรูปภาพ gpt-realtime-2.1 รับอินพุตรูปภาพที่ $5 ต่อ 1M โทเคน