
GPT-Live-1.1 คิดค่าบริการตามเวลา ไม่ใช่ตามจำนวน token OpenAI คิดค่าบริการเซสชันเสียงพูดที่ $0.05 ต่อนาทีที่ใช้งานจริง และ $0.02 ต่อนาทีในโหมดสแตนด์บาย โดยคิดค่าเป็นรายวินาทีโดยไม่ปัดขึ้นเป็นนาที ส่วนการเรียกโมเดลฝั่งแบ็กเอนด์และการเรียกใช้เครื่องมือจะถูกคิดค่าแยกต่างหากตามอัตราปกติ การสนทนาต่อเนื่อง 1 ชั่วโมงมีค่าเสียงพูด $3.00 ส่วนการจอดในโหมดสแตนด์บาย 1 ชั่วโมงมีค่าใช้จ่าย $1.20
ตารางราคามีไม่กี่บรรทัด สิ่งที่สำคัญคือพฤติกรรมของมันในแอปจริง ที่ซึ่งผู้โทรหยุดพัก แบ็กเอนด์ใช้เวลาประมวลผล และเซสชันถูกเปิดค้างไว้นานเกินไป ด้านล่างนี้คือตัวอย่างการคำนวณต้นทุน 3 กรณี พร้อมการตั้งค่าที่ช่วยให้ค่าใช้จ่ายคาดการณ์ได้
ภาพรวมราคา GPT-Live-1.1
GPT-Live-1.1 มีอัตราค่าเสียงพูด 2 แบบ และค่าใช้จ่ายแยกต่างหากสำหรับฝั่งแบ็กเอนด์ นี่คือสิ่งที่หน้าโมเดล GPT-Live-1.1 และหน้าราคาของ OpenAI ระบุไว้ ณ วันที่ 20 พฤศจิกายน 2026:
| รายการค่าใช้จ่าย | อัตรา | ต่อชั่วโมง | หมายเหตุ |
|---|---|---|---|
| เวลาเซสชันที่ใช้งานจริง | $0.05 ต่อนาที | $3.00 | การพูด ช่วงเงียบก่อนหมดเวลา idle timeout และการรองานฝั่งแบ็กเอนด์ |
| เวลาเซสชันโหมดสแตนด์บาย | $0.02 ต่อนาที | $1.20 | ใช้ได้เฉพาะ WebRTC ขณะที่การ inference ถูกหยุดชั่วคราว |
| โมเดล Responses ฝั่งแบ็กเอนด์ | อัตรา token ปกติ | แตกต่างกันไป | โมเดลที่คุณเลือกใช้สำหรับการมอบหมายงาน |
| Hosted tools | อัตราเครื่องมือปกติ | แตกต่างกันไป | Web search, file search, Code Interpreter และอื่น ๆ |
มี 3 รายละเอียดที่สำคัญกว่าอัตราที่ประกาศไว้:
- คิดค่าเป็นรายวินาที การโทร 90 วินาทีมีค่าใช้จ่าย $0.075 ไม่ใช่ $0.10; ระยะเวลาไม่ถูกปัดขึ้นเป็นนาทีเต็ม
- ราคาเท่ากับ GPT-Live-1 ทั้งสองโมเดลใช้อัตราเดียวกัน ดังนั้นการอัปเกรดไม่เปลี่ยนค่าเสียงพูด
- มีค่าใช้จ่ายเริ่มต้น 15 วินาที การสร้างเซสชัน WebRTC จะถูกคิดค่า 15 วินาทีขณะเริ่มต้นระบบ ซึ่งจะถูกคืนเมื่อเซสชันเริ่มทำงาน ค่าใช้จ่ายเพิ่มเติมจะเกิดขึ้นเฉพาะกับเซสชันที่คุณสร้างแล้วทิ้งไป
สำหรับข้อมูลพื้นฐานเกี่ยวกับสถาปัตยกรรมเสียงพูด ดูได้ที่ GPT-Live vs GPT-Realtime
นาทีแบบใดถือเป็น active และ standby
นาทีแบบ active คือช่วงเวลาที่การ inference กำลังทำงาน นาทีแบบ standby คือช่วงเวลาที่เซสชัน WebRTC ยังเชื่อมต่ออยู่แต่การ inference ถูกหยุดชั่วคราว รอรับเสียงพูด ช่องว่าง $0.03 ต่อนาทีระหว่างสองอัตรานี้คือตัวกำหนดส่วนใหญ่ของค่าเสียงพูดของคุณ
คู่มือต้นทุนของ OpenAI ระบุสิ่งที่นับเป็นเวลา active ดังนี้:
- ช่วงเวลาที่ผู้ใช้หรือโมเดลกำลังพูด
- ช่วงเงียบก่อนที่ idle timeout จะหมดเวลา
- เวลาที่รองานฝั่งแบ็กเอนด์ขณะการ inference ยังทำงานอยู่
การปิดไมค์ไม่ทำให้เข้าสู่โหมดสแตนด์บาย เซสชันยังคงคิดค่าที่ $0.05 ต่อนาที
โหมดสแตนด์บายต้องตั้งค่าสองอย่างตอนสร้างเซสชัน ตามที่ระบุในคู่มือ live conversations:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech" บอกให้เซสชันรอเสียงพูดก่อนเริ่มการ inference idle_timeout_s รับค่าจำนวนเต็มตั้งแต่ 5 ถึง 60 และจะส่งเซสชันกลับเข้าสู่โหมดสแตนด์บายหลังจากไม่มี transcript เข้าหรือออกเป็นเวลาตามจำนวนวินาทีที่กำหนด หากไม่ระบุ timeout การ inference จะทำงานต่อเนื่องจนกว่าเซสชันจะจบ และคุณจะไม่ได้อัตราสแตนด์บายเลย
ข้อควรระวังสองข้อ: โหมดสแตนด์บายใช้ได้เฉพาะ WebRTC ดังนั้นเซสชัน WebSocket และ SIP จะถูกคิดค่าทุกวินาทีที่เชื่อมต่อในอัตรา active และคำตอบแรกหลังออกจากสแตนด์บายอาจใช้เวลานานขึ้น
ตัวอย่างการคำนวณต้นทุน
อัตราค่าเสียงพูดเป็นอัตราที่ประกาศจริง ส่วนจำนวน token ฝั่งแบ็กเอนด์เป็นสมมติฐานเพื่อการอธิบาย ราคาแบ็กเอนด์มาจากหน้าราคาของ OpenAI: gpt-6-luna ที่ $0.10 input และ $0.50 output ต่อ 1M tokens, gpt-6-sol ที่ $2.00 input และ $10.00 output ต่อ 1M tokens (standard tier, short context) คู่มือการมอบหมายงานของ OpenAI แนะนำให้เริ่มด้วย gpt-6-luna และลองใช้ gpt-6-sol สำหรับงานแบ็กเอนด์ที่ซับซ้อนกว่า
ตัวอย่างที่ 1: สายแผนกซัพพอร์ตลูกค้า
สายซัพพอร์ตผ่านโทรศัพท์หรือ WebSocket นาน 6 นาที ไม่มีการใช้โหมดสแตนด์บาย ทั้ง 6 นาทีจึงถูกคิดเป็นเวลา active GPT-Live มอบหมายงานค้นข้อมูล 4 รายการไปยัง gpt-6-luna โดยแต่ละรายการใช้ input token ประมาณ 6,000 และ output token 400
| รายการ | การคำนวณ | ค่าใช้จ่าย |
|---|---|---|
| เสียงพูด | 6 นาที x $0.05 | $0.30 |
| Input ฝั่งแบ็กเอนด์ | 24,000 tokens x $0.10 / 1M | $0.0024 |
| Output ฝั่งแบ็กเอนด์ | 1,600 tokens x $0.50 / 1M | $0.0008 |
| ต่อสาย | $0.3032 |
เมื่อคิดเป็น 10,000 สายต่อเดือน คิดเป็นประมาณ $3,032 โดย $3,000 มาจากค่าเวลาเสียงพูด การลดเวลาสายเฉลี่ยลง 30 วินาทีช่วยประหยัดได้มากกว่าค่าใช้จ่ายแบ็กเอนด์ทั้งหมดเสียอีก
ตัวอย่างที่ 2: ผู้สอนภาษาในเบราว์เซอร์
เซสชันสอนภาษาผ่าน WebRTC นาน 30 นาทีโดยตั้ง idle_timeout_s ไว้ที่ 15 ผู้เรียนใช้เวลานานในการอ่านและคิด เซสชันจึงทำงานแบบ active 18 นาทีและสแตนด์บาย 12 นาที ผู้สอนมอบหมายคำอธิบาย 10 ครั้งไปยัง gpt-6-sol โดยแต่ละครั้งใช้ input token ประมาณ 8,000 และ output token 600
| รายการ | การคำนวณ | ค่าใช้จ่าย |
|---|---|---|
| เสียงพูด (active) | 18 นาที x $0.05 | $0.90 |
| เสียงพูด (สแตนด์บาย) | 12 นาที x $0.02 | $0.24 |
| Input ฝั่งแบ็กเอนด์ | 80,000 tokens x $2.00 / 1M | $0.16 |
| Output ฝั่งแบ็กเอนด์ | 6,000 tokens x $10.00 / 1M | $0.06 |
| ต่อเซสชัน | $1.36 |
หากไม่ใช้โหมดสแตนด์บาย เสียงพูด 30 นาทีเดียวกันจะมีค่าใช้จ่าย $1.50 แทนที่จะเป็น $1.14 โหมดสแตนด์บายจึงช่วยลดค่าเสียงพูดลง 24%
ตัวอย่างที่ 3: ผู้ช่วยบนเดสก์ท็อปที่เปิดตลอดเวลา
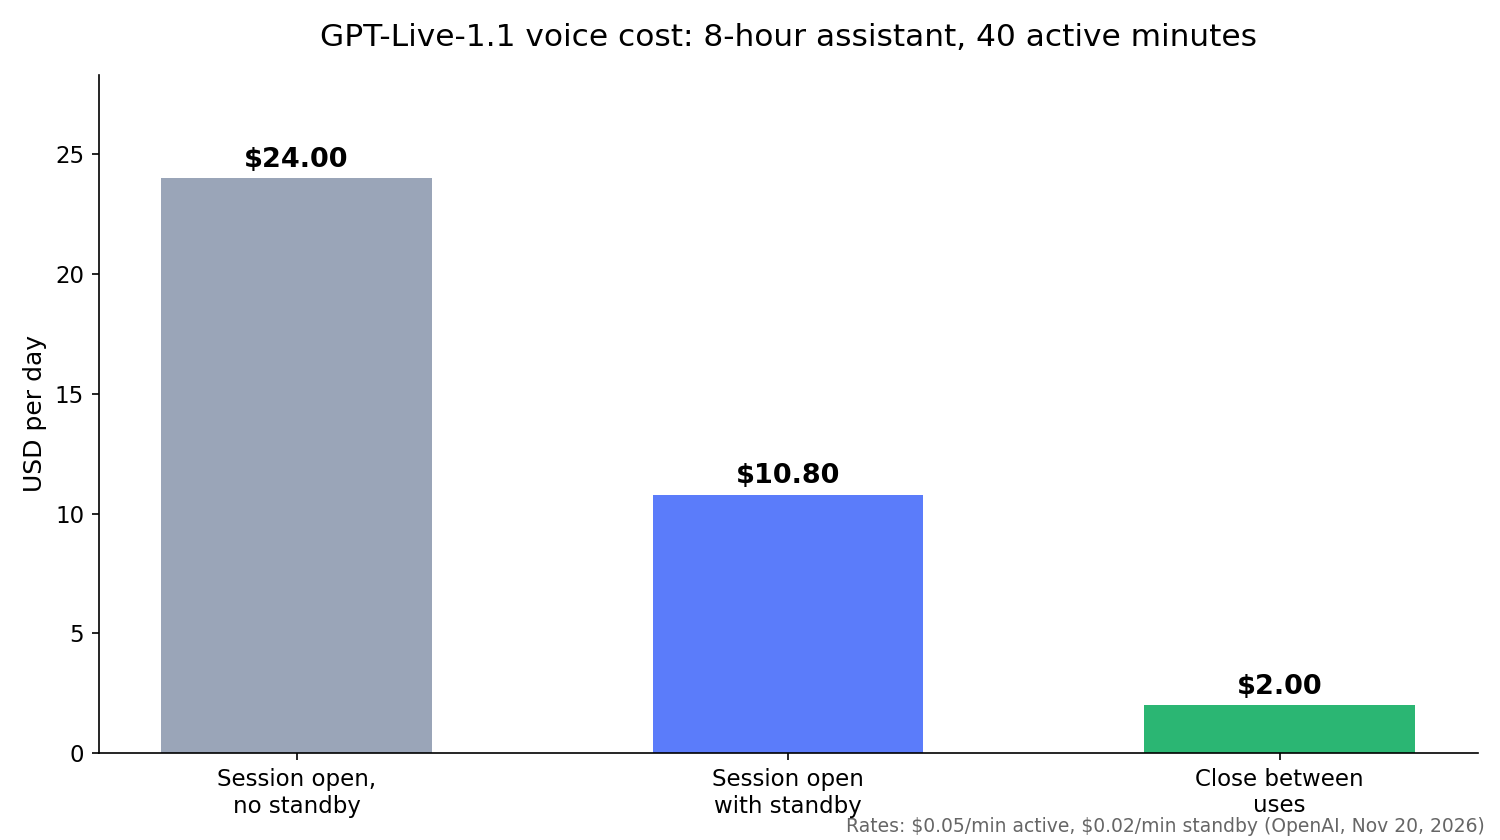
ผู้ช่วยถูกเปิดค้างไว้ตลอดวันทำงาน 8 ชั่วโมง แต่ผู้ใช้พูดคุยด้วยเพียง 40 นาทีเป็นช่วง ๆ ในกรณีนี้กลยุทธ์ที่คุณเลือกทำให้ค่าใช้จ่ายต่างกันมากกว่า 10 เท่า:
| กลยุทธ์ | การคำนวณ | ต่อวัน | ต่อเดือน (22 วันทำการ) |
|---|---|---|---|
| เปิดเซสชันค้างไว้ ไม่ใช้สแตนด์บาย | 480 นาที x $0.05 | $24.00 | $528.00 |
| เปิดเซสชันค้างไว้ ใช้สแตนด์บาย | 40 x $0.05 + 440 x $0.02 | $10.80 | $237.60 |
| ปิดเซสชันเมื่อไม่ใช้งาน | 40 นาที x $0.05 | $2.00 | $44.00 |
โหมดสแตนด์บายยังคงมีค่าใช้จ่าย $1.20 ต่อชั่วโมงที่ว่าง คู่มือของ OpenAI แนะนำให้ปิดเซสชันระหว่างช่วงเว้นวรรคที่ยาวนาน แล้วเริ่มเซสชันใหม่โดยโหลดประวัติที่บันทึกไว้เมื่อผู้ใช้กลับมา ค่าเริ่มต้น 15 วินาทีจะถูกคืนเมื่อเซสชันใหม่เริ่มทำงาน ดังนั้นเมื่อพิจารณาเฉพาะค่าเสียงพูด การปิดเซสชันคุ้มกว่า ข้อแลกเปลี่ยนคือคุณเสียการตื่นตัวทันที เซสชันที่ปิดอยู่ไม่สามารถได้ยินผู้ใช้ คุณจึงต้องใช้ push-to-talk หรือตัวตรวจจับ wake word ของคุณเอง
idle timeout ส่งผลต่อค่าใช้จ่ายของคุณอย่างไร
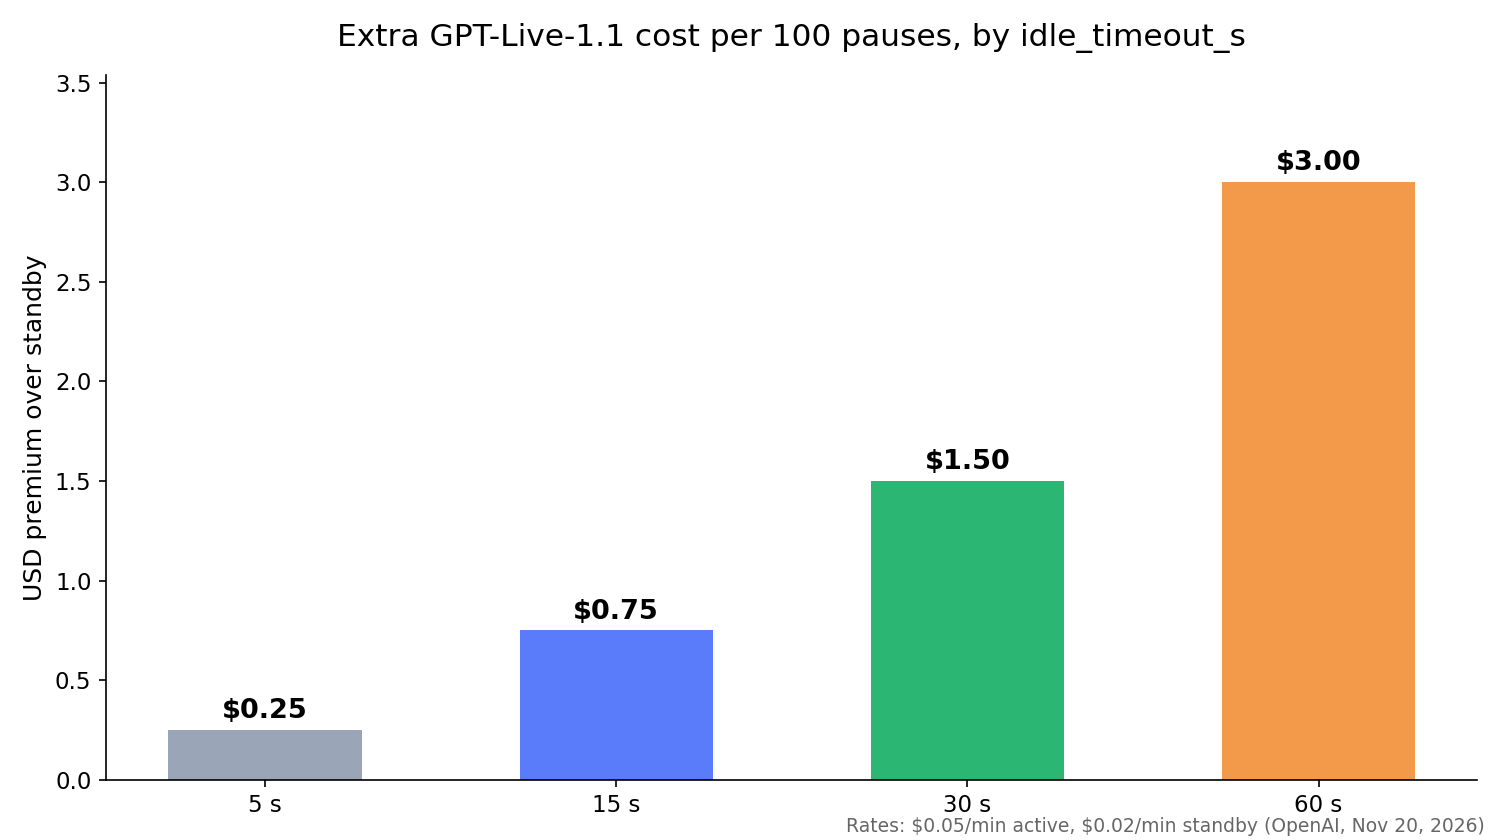
ทุกช่วงหยุดพักกินเวลาแบบ active จนกว่า idle timeout จะทำงาน timeout ที่สั้นกว่าจะเข้าถึงอัตราสแตนด์บายที่ถูกกว่าได้เร็วขึ้น แต่แลกมาด้วยวงจรหยุด-กลับมาที่มากขึ้น และคำตอบแรกหลังกลับมาแต่ละครั้งจะช้าลง
ส่วนต่างราคาต่อการหยุดพักหนึ่งครั้งคือความยาวของ timeout ที่ถูกคิดในอัตรา active ก่อนช่องว่าง $0.03 ระหว่างสองอัตรา เมื่อคิดเป็น 100 ครั้งต่อเซสชันหรือต่อวัน:
idle_timeout_s |
วินาทีแบบ active ต่อการหยุดพัก 1 ครั้ง | ส่วนต่างเทียบกับสแตนด์บาย ต่อการหยุดพัก 100 ครั้ง |
|---|---|---|
| 5 | 5 | $0.25 |
| 15 | 15 | $0.75 |
| 30 | 30 | $1.50 |
| 60 | 60 | $3.00 |
ตัวเลขเล็กมาก ซึ่งก็คือประเด็นสำคัญ: timeout ส่วนใหญ่คือการตั้งค่าด้านประสบการณ์ผู้ใช้ เลือกค่าที่ไม่ตัดจังหวะความคิดของผู้ใช้กลางคัน แล้วให้โหมดสแตนด์บายรองรับช่วงเว้นวรรคที่ยาว และใช้การปิดเซสชันรับมือช่วงที่ยาวมาก ๆ
เปรียบเทียบราคา GPT-Live-1.1 กับ GPT-Realtime
GPT-Live-1.1 คิดค่าตามนาที ส่วนโมเดล GPT-Realtime คิดค่าตาม token หน้าราคาของ OpenAI ระบุเสียงของ gpt-realtime-2.1 ที่ $32.00 ต่อ 1M input tokens และ $64.00 ต่อ 1M output tokens และเสียงของ gpt-realtime-2.1-mini ที่ $10.00 และ $20.00
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| หน่วยการคิดค่าบริการ | วินาทีของเซสชัน | input และ output tokens |
| อัตราค่าเสียงพูด | $0.05/นาที active, $0.02/นาที สแตนด์บาย | $32 / $64 ต่อ 1M audio tokens |
| การใช้เหตุผลและเครื่องมือ | แยกไปยังโมเดลฝั่งแบ็กเอนด์ | อยู่ในโมเดลเดียวกัน |
| รูปแบบต้นทุน | คงที่ต่อนาที | เพิ่มขึ้นต่อ turn เมื่อ context ใหญ่ขึ้น |
คู่มือต้นทุนของ OpenAI ระบุว่าเซสชัน Realtime จะส่งบทสนทนาทั้งหมดไปยังโมเดลในทุกครั้งที่ตอบ ทำให้ turn ที่ท้าย ๆ มีค่าใช้จ่ายสูงขึ้น ขณะที่หนึ่งนาทีของ GPT-Live มีราคาเท่ากันทั้งนาทีที่ 2 และนาทีที่ 40 ทำให้คาดการณ์ต้นทุนได้ง่าย คู่มือ GPT-Realtime-2 API ของเราอธิบายการตั้งค่าแบบอิง token เพิ่มเติม
ติดตามการใช้งานและหลีกเลี่ยงบิลที่พุ่งเกินคาด
GPT-Live รายงานการใช้เวลาเสียงพูดสะสมเป็นวินาทีผ่าน event session.usage.updated:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
การอัปเดตแต่ละครั้งจะแทนที่ยอดรวมก่อนหน้า อย่านำมาบวกกัน ให้ส่ง session.close รอ session.closed แล้วบันทึกค่า usage.seconds สุดท้าย การแยกเวลา active ออกจากสแตนด์บาย ให้จับเวลาช่วงระหว่าง event session.paused กับ session.resumed
นิสัยที่ช่วยให้ต้นทุนคงที่:
- ปิดเซสชันที่จบแล้ว เซสชันที่เปิดค้างไว้โดยไม่ได้ใช้ยังคงถูกคิดค่าบริการ
- เร่งความเร็วแบ็กเอนด์ การรองานที่มอบหมายถือเป็นเวลา active ทำให้เสร็จเร็วขึ้นหนึ่งนาที ประหยัดได้ $0.05
- ปิดเซสชันระหว่างงานยาว ปิดเสียงพูดขณะแบ็กเอนด์ทำงาน แล้วเปิดใหม่เมื่อผลลัพธ์พร้อม
- วางแผนรองรับ concurrency ขีดจำกัดนับจำนวนเซสชันพร้อมกัน โดย GPT-Live-1.1 มีขีดจำกัดแยกจาก GPT-Live-1 ซึ่งขีดจำกัดที่ประกาศคือ 50 (Build), 300 (Launch) และ 500 (Grow) ไม่รองรับ Free tier
ให้ Codex ช่วยทดสอบบันทึกการคิดค่าใช้จ่ายของคุณด้วย Apidog CLI
บันทึกการใช้งานของคุณคือโค้ดที่คุณเป็นเจ้าของ และบั๊กในส่วนนี้ทำให้การคิดราคาผิดพลาดในทุกสาย ทดสอบมันในทุก commit โดยไม่ต้องเปิดเซสชันเสียงจริง ด้วยค่าเสียง $0 และให้ coding agent ของคุณรันการทดสอบด้วย Apidog CLI
ติดตั้ง CLI, ล็อกอิน และเพิ่ม Apidog skill ให้กับ agent ของคุณ:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง Codex ด้วย prompt เดียว:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
Agent จะอ่าน schema ตรวจสอบ payload สร้าง test case และรันมัน:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
เปลี่ยน -r cli,json เป็น -r junit แล้วการรันชุดเดียวกันจะใส่ลง CI ได้เลย ดูที่ การรัน Apidog CLI ใน CI/CD pipeline ส่วน คู่มือ Apidog CLI ใน Codex อธิบายการตั้งค่า agent Apidog แผน Free รองรับทีมได้ถึง 4 ผู้ใช้
คำถามที่พบบ่อย
GPT-Live-1.1 มีค่าใช้จ่ายต่อนาทีเท่าไร? $0.05 ต่อนาทีแบบ active และ $0.02 ต่อนาทีแบบสแตนด์บาย คิดค่าเป็นรายวินาที การใช้งานฝั่งแบ็กเอนด์คิดค่าเพิ่ม
GPT-Live-1.1 แพงกว่า GPT-Live-1 หรือไม่? ไม่ OpenAI ระบุอัตรา active และสแตนด์บายเท่ากันสำหรับทั้งสองโมเดล
โหมดสแตนด์บายใช้ได้กับสายโทรศัพท์หรือไม่? ไม่ อัตราสแตนด์บายที่ถูกกว่าใช้ได้เฉพาะเซสชัน WebRTC ขณะการ inference หยุดชั่วคราว เซสชัน WebSocket และ SIP จะถูกคิดค่าเวลาที่เชื่อมต่อในอัตรา active
การเรียกโมเดลฝั่งแบ็กเอนด์รวมอยู่ในราคาต่อนาทีหรือไม่? ไม่ การเรียก Responses ที่มอบหมายจะถูกคิดค่าตามอัตรา token ของโมเดลที่เลือก พร้อมค่าเครื่องมือเพิ่มเติม
แล้วคำถามเรื่อง GPT-Live API จากเดือนกรกฎาคมล่ะ? ตอนนั้น GPT-Live เป็นเพียงฟีเจอร์เสียงของ ChatGPT ที่ยังไม่มี API ตามที่บทความอธิบายเรื่อง GPT-Live API ของเราระบุไว้ในขณะนั้น GPT-Live-1.1 คือโมเดลสำหรับ API ให้บริการผ่าน v1/live/sessions