
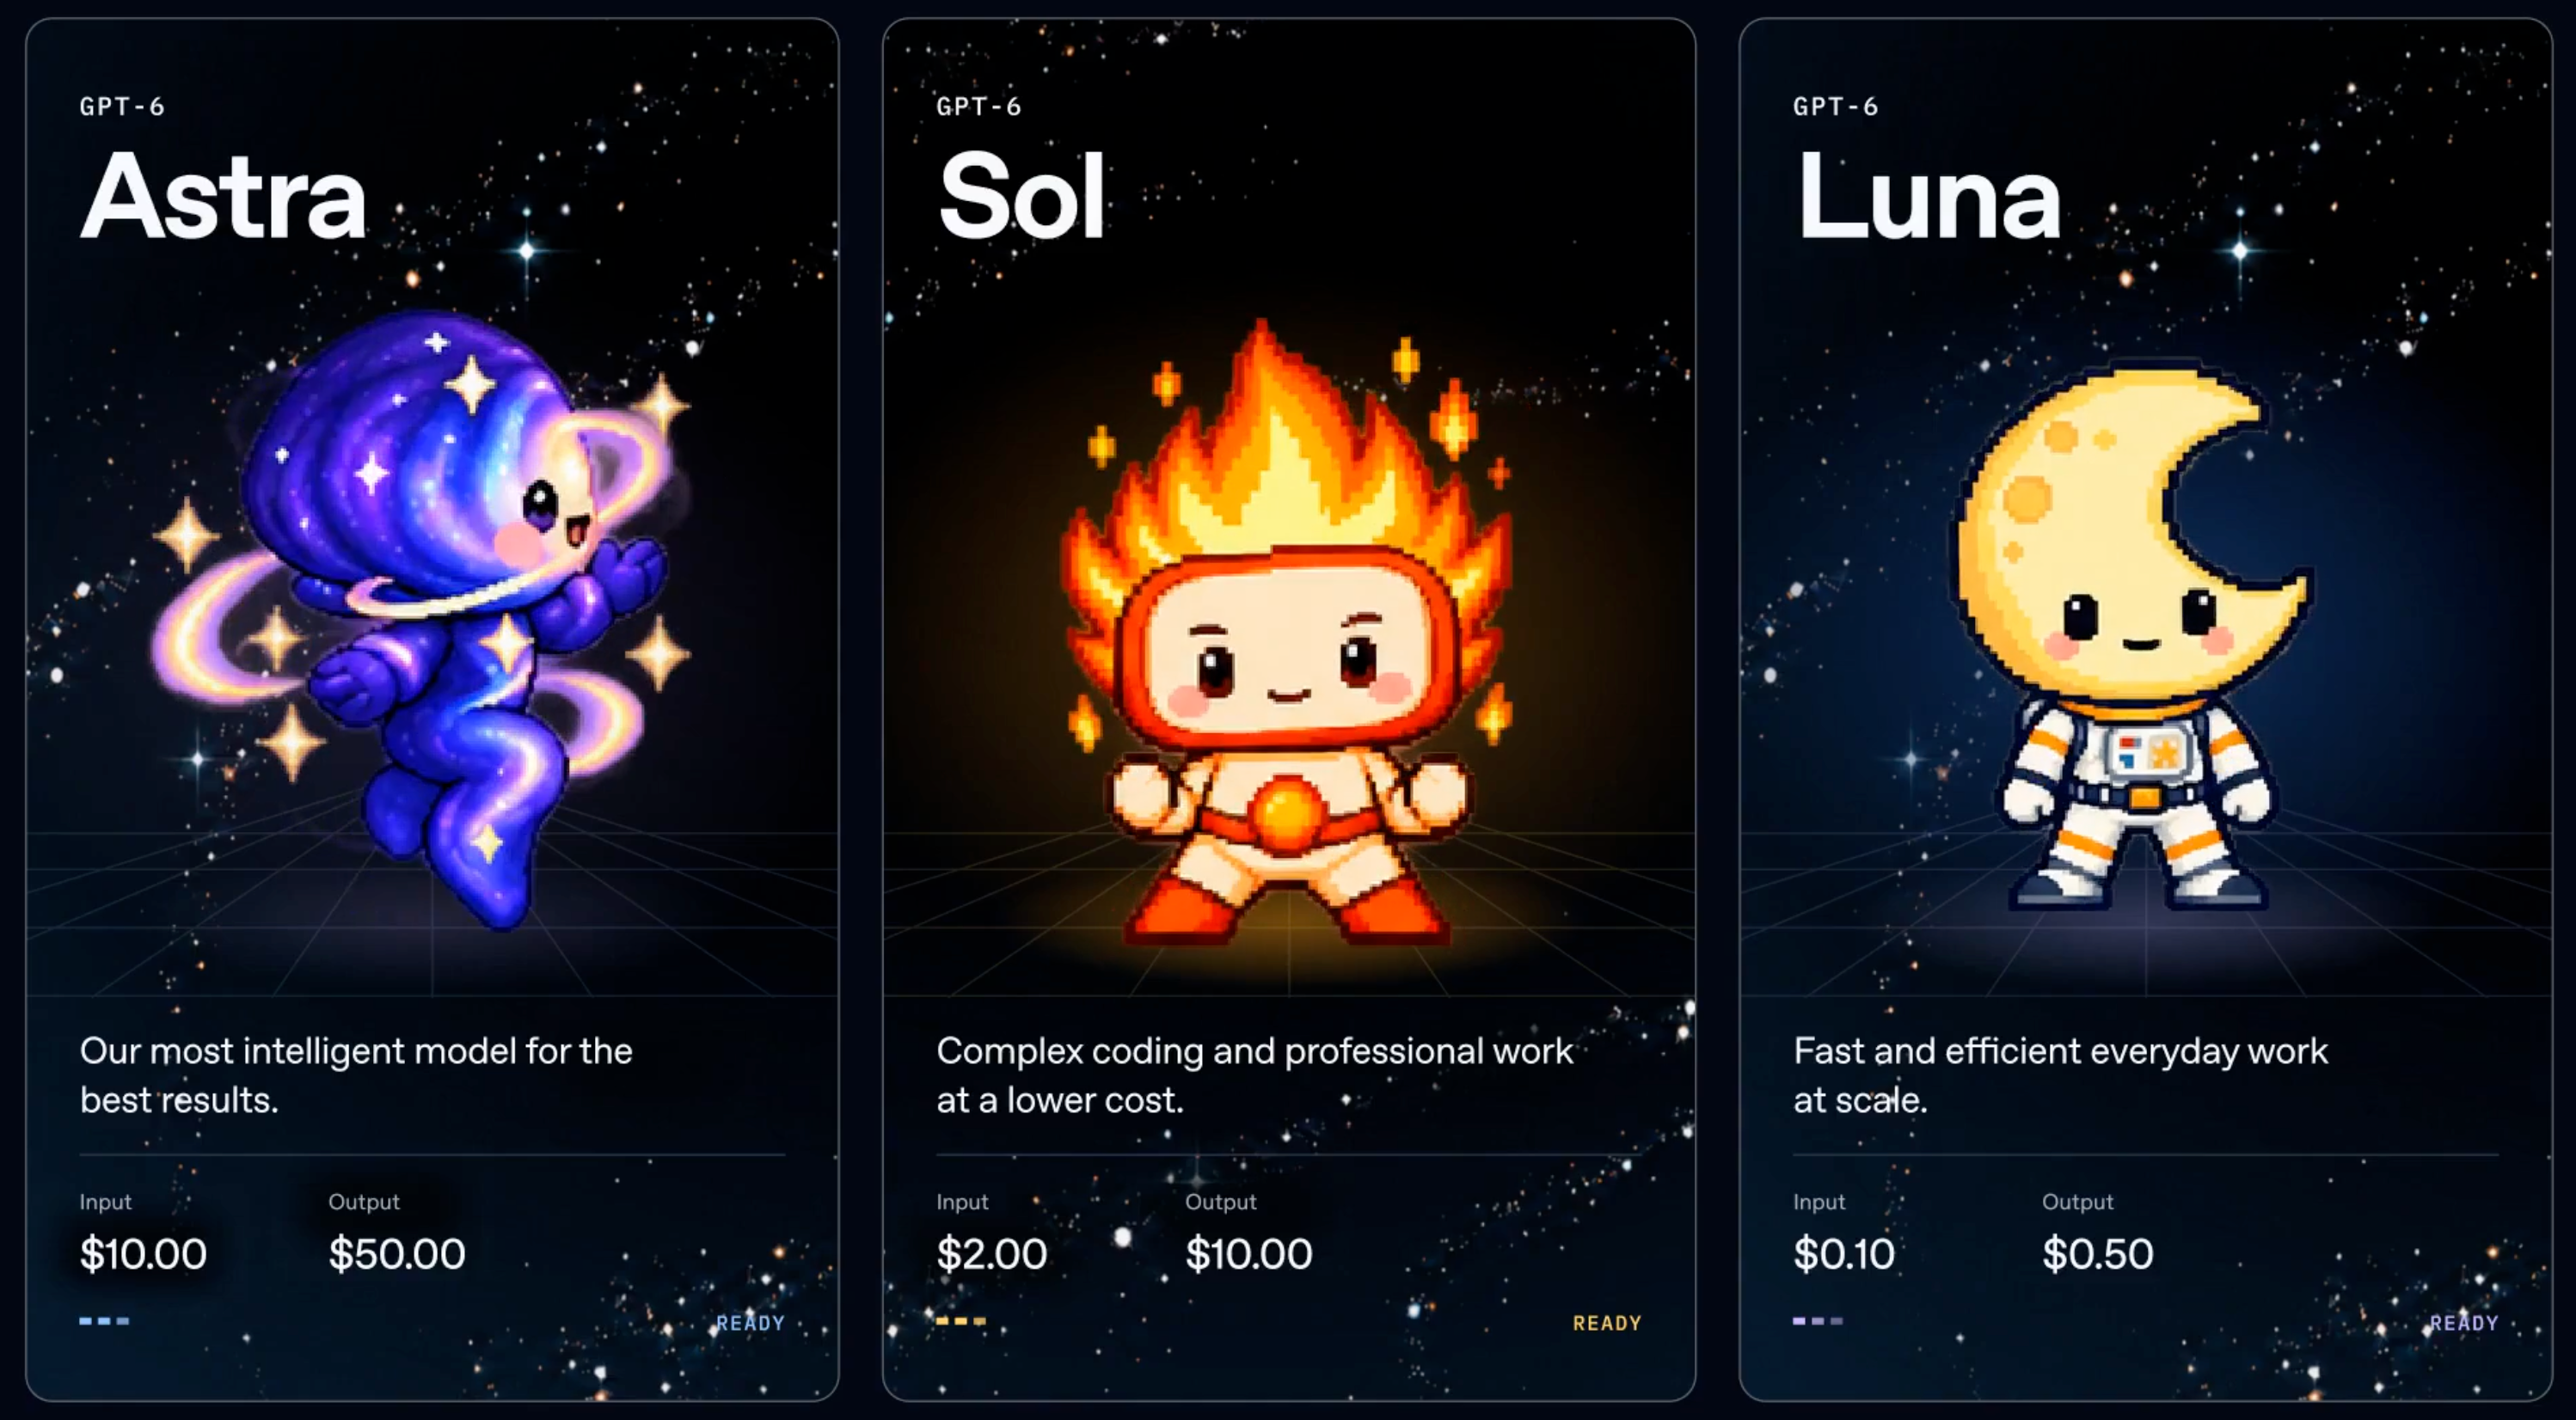
OpenAI ได้เปิดตัว GPT-6 Sol และ GPT-6 Luna เมื่อวันที่ 22 กันยายน 2026 โดยเข้าร่วมกับ GPT-6 Astra ในฐานะตระกูลสามระดับ สิ่งแรกที่ทีมส่วนใหญ่ทำคือเปิดหน้าการกำหนดราคา เห็น $0.10 ถัดจาก Luna และ $10 ถัดจาก Astra และสรุปว่าระดับสูงสุดมีราคาสูงกว่าร้อยเท่า
ตัวเลขนั้นเป็นจริง แต่ก็เป็นหน่วยที่ไม่ถูกต้องด้วย คุณไม่ได้ส่งโทเค็นไปยังการผลิต คุณส่งงานที่เสร็จสมบูรณ์: ตั๋วที่แก้ไขแล้ว, ไฟล์ที่ย้ายแล้ว, งานเบราว์เซอร์ที่เสร็จสมบูรณ์ โมเดลการให้เหตุผลจะตัดสินใจเองว่าต้องใช้โทเค็นเท่าใด และระดับความพยายามที่คุณส่งไปจะเปลี่ยนคำตอบได้เป็นอันดับหนึ่ง โมเดลราคาถูกที่ใช้ความพยายามสูงสุดอาจมีค่าใช้จ่ายต่องานที่เสร็จสมบูรณ์มากกว่าโมเดลราคาแพงที่ตอบกลับอย่างรวดเร็ว
คู่มือนี้เป็น GPT-6 รุ่นต่อจาก การเปรียบเทียบ GPT-5.6 Sol vs Terra vs Luna ของเรา โพสต์นั้นเปรียบเทียบระดับต่างๆ ตามราคาต่อล้านโทเค็น ซึ่งเป็นหน่วยที่ถูกต้องสำหรับรุ่นนั้น ส่วนโพสต์นี้เปรียบเทียบตามต้นทุนต่องาน เนื่องจากเป็นหน่วยที่ OpenAI ใช้เพื่ออธิบายความเหมาะสมของโมเดลใหม่ๆ
สามระดับตามข้อมูล
| โมเดล | API id | อินพุต $/M | เอาต์พุต $/M | อินพุตแบบแคช | บริบท | ดัชนีความฉลาด AA |
|---|---|---|---|---|---|---|
| GPT-6 Astra | ดู คู่มือ Astra API ของเรา | $10 | $50 | ไม่ระบุในตารางเปิดตัว | ไม่ระบุ | ไม่ได้เผยแพร่ |
| GPT-6 Sol | gpt-6-sol |
$2 | $10 | ลด 90% สำหรับการอ่าน | 872k | 48 |
| GPT-6 Luna | gpt-6-luna |
$0.10 | $0.50 | ลด 90% สำหรับการอ่าน | 1M | 37 |
มีสองสิ่งที่ทำให้คนประหลาดใจในตารางนั้น
ประการแรก Luna มีหน้าต่างบริบท (context window) ที่ใหญ่ที่สุดในสามรุ่น โมเดลที่ถูกที่สุดในตระกูลสามารถรับโทเค็นได้เต็มหนึ่งล้านโทเค็น ในขณะที่ Sol หยุดอยู่ที่ 872k หากปริมาณงานของคุณคือ "อ่านมาก ตัดสินใจน้อย" ระดับประหยัดจะไม่ใช่ข้อจำกัด
ประการที่สอง แถวของ Astra มีข้อมูลที่หายไป โพสต์เปิดตัว Sol และ Luna ไม่ได้ระบุหน้าต่างบริบท (context window) ของ Astra หรืออัตราการอ่านแบบแคช (cached-read rate) ซ้ำ และ Astra ไม่มีคะแนนดัชนี Artificial Analysis ที่เผยแพร่พร้อมกับอีกสองรุ่น สิ่งเหล่านี้คือช่องว่างในข้อมูลต้นฉบับ ไม่ใช่ค่าศูนย์
ทั้ง Sol และ Luna ถูกอธิบายว่ามีราคาถูกกว่า GPT-5.6 ถึง 50% และคำพูดของ OpenAI เองคือ การเปรียบเทียบนั้นเทียบกับราคา โปรโมชั่น ของ GPT-5.6 คำคุณศัพท์นั้นสำคัญพอที่เราจะให้ การวิเคราะห์โดยละเอียด ของมันเอง เมื่อเทียบกับอัตราตามรายการของ GPT-5.6 ที่เราบันทึกไว้ในตอนเปิดตัว ส่วนลดนั้นใหญ่กว่าที่พาดหัวข่าวระบุไว้
เหตุใดราคาต่อโทเค็นจึงไม่สามารถคาดการณ์ค่าใช้จ่ายของคุณได้อีกต่อไป
ตัวคูณสามตัวที่แยกกันอยู่ระหว่างตารางราคาและใบแจ้งหนี้
โทเค็นการให้เหตุผลคือโทเค็นเอาต์พุต เมื่อโมเดลคิดก่อนที่จะตอบ การคิดนั้นจะถูกคิดค่าใช้จ่ายในอัตราเอาต์พุต ซึ่งเป็นห้าเท่าของอัตราอินพุตในทั้งสามระดับ งานที่ส่งคืนคำตอบ 200 โทเค็นหลังจากการให้เหตุผล 8,000 โทเค็นจะถูกคิดค่าใช้จ่ายเหมือนคำตอบ 8,200 โทเค็น
ระดับความพยายามเป็นตัวปรับ ไม่ใช่สถานะคงที่ ตารางมาตรฐานของ OpenAI รายงานผลลัพธ์ตามการตั้งค่าความพยายาม: ต่ำ (low), ปานกลาง (medium), สูง (high), สูงมาก (xhigh), สูงสุด (max) โมเดลเดียวกันที่ความพยายามสูงสุดและที่ความพยายามต่ำ ถือเป็นผลิตภัณฑ์สองแบบที่มีราคาต่องานแตกต่างกัน เพื่อวัตถุประสงค์ในการจัดทำงบประมาณ
การวนซ้ำของ Agent จะส่งพร้อมต์ซ้ำ Agent ที่มีสิบสองขั้นตอนจะส่งพร้อมต์ของระบบ, คำจำกัดความของเครื่องมือ และประวัติสะสมในทุกขั้นตอน ปริมาณอินพุตจะเพิ่มขึ้นเป็นกำลังสองตามจำนวนขั้นตอน เว้นแต่การแคชจะดูดซับมัน ซึ่งเป็นสาเหตุที่ GPT-6 เปิดตัวการแคช พร้อมกับโมเดล: ลดราคา 90% สำหรับการอ่านอินพุตที่แคชไว้ และความพยายามในการให้เหตุผลหรือการเปลี่ยนแปลงเครื่องมือจะไม่ทำให้พรีฟิกซ์ไม่ถูกต้องอีกต่อไป
เมื่อนำสิ่งเหล่านี้มารวมกันในงาน Agent ที่สมจริง: การเรียกโมเดลสิบสองครั้ง, พรีฟิกซ์พร้อมต์ 40k โทเค็น, 2k โทเค็นเอาต์พุตต่อการเรียกแต่ละครั้ง สมมติว่าการเรียกครั้งแรกจ่ายราคาอินพุตเต็ม และอีกสิบเอ็ดครั้งที่เหลืออ่านพรีฟิกซ์จากแคช
| ระดับ | อินพุตที่ไม่ได้แคช | อินพุตที่แคช | เอาต์พุต | ต้นทุนต่องาน |
|---|---|---|---|---|
| Luna | $0.004 | $0.0044 | $0.012 | $0.02 |
| Sol | $0.08 | $0.088 | $0.24 | $0.41 |
| Astra, ไม่สมมติส่วนลดแคช | $0.40 | $4.40 | $1.20 | $6.00 |
| Astra, หากได้รับส่วนลดการอ่าน 90% เท่ากัน | $0.40 | $0.44 | $1.20 | $2.04 |
อัตราส่วนอินพุตตามหัวข้อข่าวคือ 1:20:100 เมื่อมีการแคชเข้ามาเกี่ยวข้อง ส่วนต่างจะขยายเป็นประมาณ 1:20:294 หรือบีบอัดกลับมาเป็น 1:20:100 อีกครั้ง ทั้งนี้ขึ้นอยู่กับอัตราการอ่านแบบแคชของ Astra ที่ตารางเปิดตัวไม่ได้ระบุไว้ ข้อมูลที่ไม่ทราบเพียงอย่างเดียวนั้นทำให้ต้นทุนต่องานของระดับสูงสุดเปลี่ยนไปถึงสามเท่า ค้นหาว่ามันคือเท่าไรสำหรับบัญชีของคุณก่อนที่คุณจะกำหนดงบประมาณสำหรับ Astra
สิ่งที่ตัวเลขต้นทุนต่องานของ OpenAI เองแสดงให้เห็น
โพสต์เปิดตัวเผยแพร่คะแนนและต้นทุนสัมพัทธ์พร้อมกัน ซึ่งเป็นส่วนที่มีประโยชน์ บน AutomationBench 1.0.6:
| โมเดลและความพยายาม | คะแนน | ต้นทุนต่องาน |
|---|---|---|
| GPT-6 Sol, xhigh | 33.2% | $0.27 |
| GPT-6 Astra, low | 30.3% | 3.9 เท่าของ Sol |
| Claude Fable 5.1 พร้อม Opus 5 เป็นตัวสำรอง, max | 31.4% | มากกว่า 8.9 เท่าของ Sol |
| Claude Opus 5, max | 26.9% | 11.1 เท่าของ Sol |
อ่านคู่แรกนั้นช้าๆ ระดับกลางที่ความพยายาม xhigh ได้คะแนนสูงกว่าระดับเรือธงที่ความพยายามต่ำถึง 2.9 จุด และมีค่าใช้จ่ายต่องานประมาณหนึ่งในสี่ เมื่อเทียบกับฐานราคา $0.27 นั่นทำให้ Astra ที่ความพยายามต่ำอยู่ที่ประมาณ $1.05 ซึ่งเป็นการคำนวณจากตัวคูณของ OpenAI มากกว่าจะเป็นตัวเลขที่ OpenAI พิมพ์ออกมา
รูปแบบเดียวกันนี้ซ้ำๆ กันในที่อื่นๆ:
- Agents’ Last Exam V1: Sol ที่ความพยายามสูงสุด (max) ได้คะแนน 56.4% ซึ่งสูงกว่าผลลัพธ์ที่ดีที่สุดของ Claude Opus 5 โดยมีต้นทุนต่องานต่ำกว่า 60%
- DeepSWE 1.1: Sol ที่ความพยายามสูงสุด (max) ทำได้ 68.8% ซึ่งอยู่ภายใน 1.1 จุดจาก Claude Fable 5 ที่ความพยายาม xhigh โดยมีต้นทุนต่องานต่ำกว่าประมาณ 80% Luna ที่ความพยายามสูงสุด (max) ทำได้ 66.6% ซึ่งเทียบเท่ากับ Opus 5 และ Fable 5 ที่ความพยายามปานกลาง (medium) โดยมีต้นทุนต่องานน้อยกว่า Opus 5 ถึง 93% และน้อยกว่า Fable 5 ถึง 96%
- OSWorld 2.0 ออฟไลน์: Sol ที่ความพยายาม xhigh ทำคะแนนได้ 60.5% เทียบกับ Opus 5 ที่ความพยายามปานกลาง (medium) ที่ 60.3% โดยมีต้นทุนต่องานถูกกว่าประมาณ 80% Luna ที่ความพยายามสูงสุด (max) เอาชนะ GPT-5.6 Sol ที่ความพยายามปานกลาง (medium) ได้ด้วยต้นทุนเพียงหนึ่งในสิบ
- ความถูกต้องของข้อเท็จจริง (Factuality): Sol ทำผิดพลาดน้อยกว่ารุ่นก่อนหน้าประมาณครึ่งหนึ่ง Luna ที่ความพยายามสูงกว่าเทียบเท่ากับ GPT-5.6 Sol ด้วยต้นทุนประมาณหนึ่งในร้อย
- การเคลื่อนไหวของต้นทุนภายในระดับเดียวกัน: Luna ที่ความพยายามสูงเอาชนะรุ่นก่อนหน้าของตัวเองได้ 5.4 จุด โดยมีต้นทุนต่องานต่ำกว่า 58%
คำเตือนสองประการที่จริงใจ การเปรียบเทียบแต่ละครั้งเขียนขึ้นโดยอ้างอิงกับ Claude Opus 5 เนื่องจาก Anthropic ได้เปิดตัว Opus 5.5 ในวันเดียวกัน และโพสต์ของ OpenAI มีมาก่อนหน้านั้น และตัวเลขของ Astra ในตารางนั้นเป็นเพียงจุดข้อมูลเดียวที่ความพยายามต่ำ OpenAI ระบุไว้อย่างชัดเจนว่า Astra "ยังคงเป็นโมเดลที่ดีที่สุดของเราในทุกด้าน" ไม่มีอะไรในที่นี้ที่บอกว่า Astra แพ้ มันบอกว่า Astra ที่ความพยายามต่ำเป็นวิธีที่มีค่าใช้จ่ายสูงในการได้ผลลัพธ์ 30.3%
ระดับที่หายไป และระดับที่เปลี่ยนตำแหน่ง
GPT-5.6 คือ Sol, Terra และ Luna ส่วน GPT-6 คือ Astra, Sol และ Luna ไม่มี GPT-6 Terra
นั่นไม่ใช่การเปลี่ยนชื่อของระดับกลางเก่า Astra อยู่เหนือตำแหน่งที่ GPT-5.6 Sol เคยอยู่ และ GPT-6 Sol ได้รับช่วงตำแหน่งกลางด้วยราคาที่ต่ำกว่าอัตราเดิมของชื่อระดับนั้นมาก หากโค้ดของคุณใช้ gpt-5.6-terra ในวันนี้ โมเดล GPT-6 ที่ใกล้เคียงที่สุดตามบทบาทคือ Sol ไม่ใช่รุ่นที่ใช้ชื่อเดียวกัน คำอธิบายชื่อเรียก ของเราตอนนี้กลายเป็นประวัติของรุ่นมากกว่าแผนที่ปัจจุบัน
ลำดับราคาสำหรับสองชื่อที่ยังคงอยู่:
| ชื่อระดับ | รายการราคา GPT-5.6 | GPT-6 |
|---|---|---|
| Sol | $5 / $30 | $2 / $10 |
| Luna | $1 / $6 | $0.10 / $0.50 |
ชื่อเดียวกัน โมเดลต่างกัน เศรษฐกิจต่างกัน อะไรก็ตามในการตั้งค่าของคุณที่ถือว่าชื่อระดับเป็นระดับความสามารถที่คงที่ จำเป็นต้องอ่านซ้ำ
การเลือกระดับ
| ปริมาณงาน | ระดับ | เหตุผล |
|---|---|---|
| การจัดหมวดหมู่, การดึงข้อมูล, การกำหนดเส้นทาง, การติดแท็ก | Luna ที่ความพยายามต่ำหรือปานกลาง | เอาต์พุตคำเดียวทำให้โทเค็นการให้เหตุผลเป็นค่าใช้จ่ายทั้งหมด อัตราเอาต์พุตที่ถูกที่สุดชนะขาดลอย |
| การนำเข้าเอกสารขนาดใหญ่, การถอดเสียงยาวๆ, การอ่าน repo ทั้งหมด | Luna | บริบท 1M, อินพุต $0.10, และส่วนลด 90% สำหรับการอ่านที่แคชไว้สำหรับสิ่งที่คุณส่งซ้ำสองครั้ง |
| Agent สำหรับการเขียนโค้ด, การใช้เครื่องมือหลายขั้นตอน, การทำงานอัตโนมัติของเบราว์เซอร์ | Sol ที่ความพยายามสูงหรือ xhigh | นี่คือช่วงที่ตัวเลขต้นทุนต่องานที่ OpenAI เผยแพร่มีความแข็งแกร่งที่สุดเมื่อเทียบกับทางเลือกอื่นๆ ในตาราง |
| การสร้างการทดสอบ, การตรวจสอบ schema, การทบทวน spec | Luna ก่อน, Sol เมื่อล้มเหลว | กำหนดเส้นทางตามผลลัพธ์ ไม่ใช่จากการเดา ลองซ้ำสิ่งที่ล้มเหลวโดยใช้ระดับที่สูงขึ้น |
| งานบุกเบิกที่การตอบผิดมีค่าใช้จ่ายสูงอย่างแท้จริง | Astra | ผู้ขายระบุว่าเป็นโมเดลที่ดีที่สุดในทุกด้าน ตั้งงบประมาณไว้เป็นทางเลือกสำรอง ไม่ใช่ค่าเริ่มต้น |
รูปแบบการกำหนดเส้นทางในแถวที่สี่เป็นสิ่งที่คุ้มค่า ใช้งานระดับราคาถูก ตรวจสอบความถูกต้องของเอาต์พุตด้วยโปรแกรม และยกระดับเฉพาะสิ่งที่ล้มเหลวเท่านั้น หาก Luna จัดการ 80% ของคิวด้วยต้นทุน $0.02 ต่องาน และ Sol จัดการส่วนที่เหลือด้วย $0.41 ต้นทุนเฉลี่ยของคุณจะอยู่ที่ประมาณ $0.10 ไม่ใช่ $0.41
ข้อควรทราบเพิ่มเติมเกี่ยวกับความหน่วง (latency) ก่อนที่คุณจะคิดว่าระดับราคาถูกนั้นเร็วด้วย Artificial Analysis ซึ่งเป็นบุคคลที่สามที่ไม่ใช่ผู้ขายรายใด ได้วัด ตัวแปรการให้เหตุผลสูงสุด (max reasoning variants) ที่ 115.2 โทเค็นเอาต์พุตต่อวินาที และ 102.15 วินาทีสำหรับโทเค็นแรกของ Sol และ 153.9 โทเค็นต่อวินาที และ 124.23 วินาทีสำหรับโทเค็นแรกของ Luna ตัวเลขเหล่านี้เป็นตัวเลขความพยายามสูงสุดและไม่ได้อธิบายถึงการเรียกใช้ที่มีความพยายามต่ำ เราจะอธิบายว่าโทเค็นแรกที่ใช้เวลาสองนาทีส่งผลต่อสัญญา API อย่างไรใน บทความเรื่องความหน่วง ของเรา
วัดผลจากการใช้งานจริงของคุณเอง
ตัวเลขต้นทุนต่องานของผู้ขายมาจากเครื่องมือทดสอบของผู้ขายเอง ตัวเลขของคุณจะแตกต่างกัน และการเปรียบเทียบเดียวที่ตัดสินใจได้คือการรันด้วยพร้อมต์ของคุณเอง
บล็อกการใช้งานในทุกการตอบกลับมีสิ่งที่คุณต้องการ:
{
  "model": "gpt-6-luna",
  "usage": {
    "input_tokens": 41200,
    "input_tokens_details": { "cached_tokens": 39800 },
    "output_tokens": 2140,
    "total_tokens": 43340
  }
}
ค่าใช้จ่ายสำหรับการเรียกใช้นั้นที่อัตราของ Luna: อินพุตที่ไม่ได้แคช 1,400 โทเค็นที่ $0.10/M, อินพุตที่แคช 39,800 โทเค็นที่ $0.01/M, เอาต์พุต 2,140 โทเค็นที่ $0.50/M ซึ่งก็คือ $0.00014 บวก $0.000398 บวก $0.00107 หรือประมาณ $0.0016 ให้คูณด้วยจำนวนการเรียกที่งานใช้ ไม่ใช่จำนวนงาน
สามกฎที่ทำให้การวัดผลน่าเชื่อถือ:
- นับงานทั้งหมด ไม่ใช่การเรียกใช้แต่ละครั้ง สรุปการใช้งานตลอดทุกขั้นตอนในการทำงาน รวมถึงการลองใหม่และส่วนที่ล้มเหลว
- รักษาระดับความพยายามให้คงที่ต่อแถว ตารางเปรียบเทียบ Luna ที่ความพยายามสูงสุด กับ Sol ที่ความพยายามต่ำ จะไม่บอกอะไรคุณเลย เว้นแต่คุณจะระบุไว้ในหัวตาราง
- บันทึกจำนวนโทเค็นที่แคชแยกต่างหาก การเปรียบเทียบระดับที่รันบนแคชเย็น จะทำให้โมเดลราคาแพงดูดีขึ้น เพราะข้อได้เปรียบของโมเดลราคาถูกจะใหญ่ที่สุดเมื่อใช้พรีฟิกซ์ซ้ำๆ
ในทางปฏิบัติ นี่คือคำขอที่บันทึกไว้หนึ่งครั้ง, ตัวแปรสำหรับ ID โมเดล, และการยืนยันบนฟิลด์การใช้งาน Apidog จัดการรูปแบบนั้นได้ดี: กำหนดการเรียกใช้เพียงครั้งเดียว, สลับโมเดลผ่านตัวแปรสภาพแวดล้อม, และรันชุดข้อมูลเป็นสถานการณ์ (scenario) เพื่อให้ตัวเลขการใช้งานปรากฏในรายงานเดียวแทนที่จะเป็นหน้าต่างเทอร์มินัลสามหน้าต่าง สถานการณ์เดียวกันนี้ยังทำหน้าที่เป็นตัวตรวจสอบการถดถอยเมื่อมีการกำหนดราคาใหม่ ซึ่งในจังหวะการเปิดตัวนี้เป็นเรื่องของเวลาหลายเดือน
เวอร์ชันย่อ
ต่อโทเค็น Luna ถูกกว่า Astra ถึงร้อยเท่าสำหรับอินพุต ต่องาน จากมาตรฐานที่ OpenAI เผยแพร่เอง การจัดอันดับไม่ได้ชัดเจนขนาดนั้น: Sol ที่ความพยายาม xhigh เอาชนะ Astra ที่ความพยายามต่ำบน AutomationBench โดยมีค่าใช้จ่ายประมาณหนึ่งในสี่ และ Luna ที่ความพยายามสูงสุดสามารถทำผลงานได้ใกล้เคียงกับโมเดลที่มีต้นทุนสูงกว่าสิบเท่าต่องาน
เริ่มต้นที่ Luna ยกระดับเมื่อเกิดข้อผิดพลาด สำรอง Astra ไว้สำหรับงานที่การทำผิดพลาดมีค่าใช้จ่ายสูงกว่าความช้า จากนั้นวัดผลด้วยตัวคุณเอง เพราะทุกตัวเลขข้างต้นมาจากปริมาณงานของคนอื่น
สำหรับภาพรวมที่กว้างขึ้นของการเปิดตัวทั้งสองครั้งภายใน 48 ชั่วโมงเดียวกัน โปรดดู สรุปสงครามราคาโมเดล AI เดือนกันยายน 2026 ของเรา