ทุกทีม Backend มีรายการงานที่เห็นได้ชัดว่าจะดีขึ้นเมื่อใช้โมเดลภาษา แต่ก็ไม่มีใครเคยนำไปใช้งานจริง การจำแนกประเภทเหตุการณ์สนับสนุนห้าล้านรายการต่อวัน การเพิ่มข้อมูลแค็ตตาล็อกที่มีสิบสองล้านแถว การให้คะแนนเว็บฮุกขาเข้าทุกรายการก่อนที่จะเข้าสู่คิว เหตุผลก็เหมือนเดิมเสมอ: เมื่อนำต้นทุนต่อคำขอคูณด้วยจำนวนคำขอจริง ตัวเลขที่ได้จะไม่ใช่แค่ความผิดพลาดเล็กน้อยอีกต่อไป
GPT-6 Luna ซึ่งประกาศเมื่อวันที่ 22 กันยายน 2026 มีค่าใช้จ่าย $0.10 ต่อล้านโทเค็นอินพุต และ $0.50 ต่อล้านโทเค็นเอาต์พุต มีหน้าต่างบริบท (context window) ขนาด 1,000,000 โทเค็น และให้ส่วนลด 90% สำหรับการอ่านอินพุตที่แคชไว้ ราคาดังกล่าวถูกพอที่จะทำให้หลายๆ งานที่ถูกพักไว้สามารถนำมาใช้งานได้จริง และถูกพอที่จะทำให้คนเลิกคิดคำนวณ ซึ่งเป็นวิธีที่คุณจะต้องจบลงด้วยการอธิบายใบแจ้งหนี้ที่มีตัวเลขห้าหลัก
นี่คือการคำนวณ: รูปแบบปริมาณงานจริงสามแบบ ต้นทุนต่อล้านคำขอสำหรับแต่ละแบบ และสามตัวแปรที่จะกำหนดค่าใช้จ่ายของคุณนานก่อนที่ราคาจริงจะบอกคุณ
อัตราที่คุณใช้งานอยู่
| โมเดล | API ID | อินพุตต่อ 1M | อ่านที่แคชไว้ต่อ 1M | เอาต์พุตต่อ 1M | บริบท |
|---|---|---|---|---|---|
| GPT-6 Luna | gpt-6-luna |
$0.10 | $0.01 | $0.50 | 1,000,000 |
| GPT-6 Sol | gpt-6-sol |
$2.00 | $0.20 | $10.00 | 872,000 |
| GPT-6 Astra | n/a | $10.00 | n/a | $50.00 | n/a |
| Claude Opus 5.5 | claude-opus-5-5 |
$4.00 | $0.20 (เขียน $5.00) | $20.00 | 1,000,000 |
คอลัมน์การอ่านที่แคชไว้สำหรับ Sol และ Luna คือส่วนลด 90% ที่ประกาศใช้กับอัตราอินพุต ไม่ใช่ตัวเลขที่ประกาศแยกต่างหาก Anthropic เผยแพร่อัตราการอ่านที่แคชไว้โดยตรง และยังคิดค่าใช้จ่าย $5.00 ต่อล้านเพื่อเขียนแคช ซึ่งมีความสำคัญเมื่อมีปริมาณมาก: ปริมาณงานที่มีการเปลี่ยนแปลงของส่วนนำ (prefix churn) สูง จะต้องจ่ายค่าเขียนนั้นซ้ำๆ
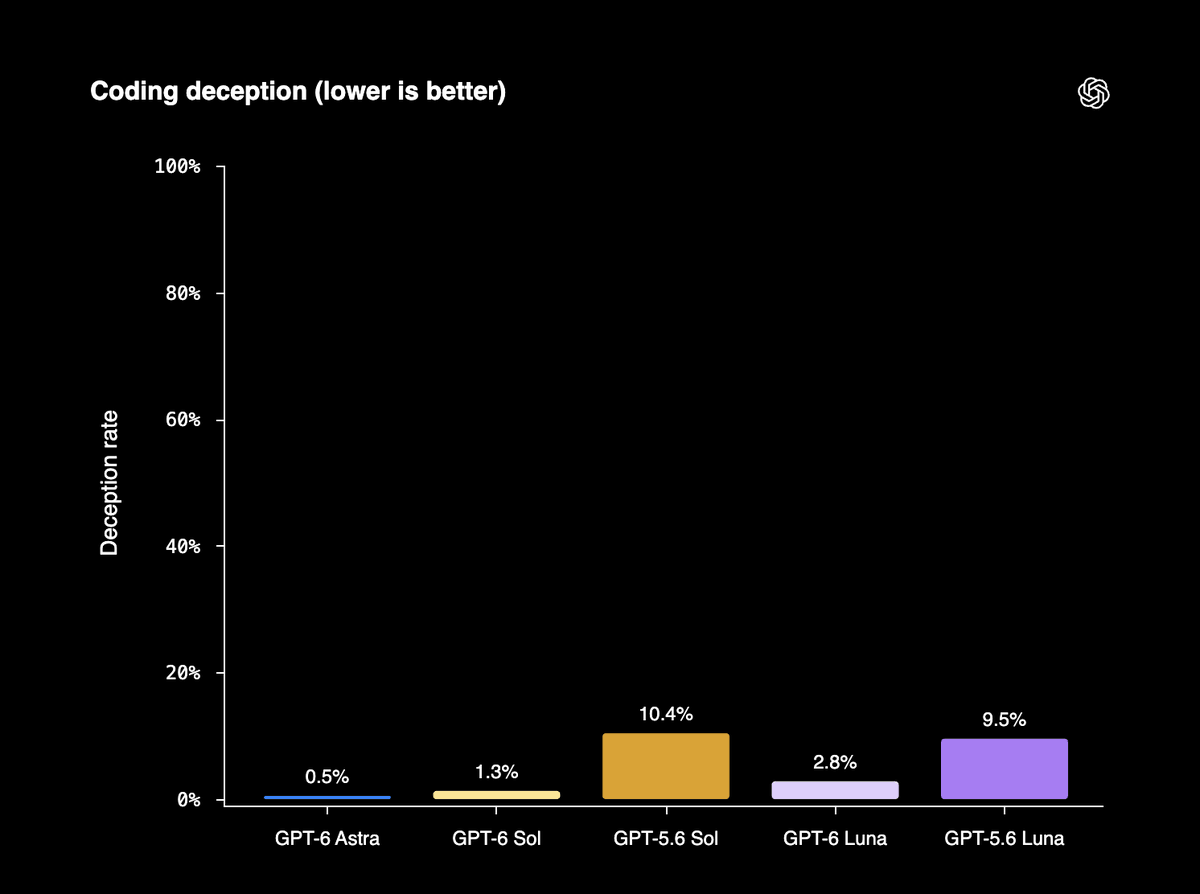
มีการแก้ไขกรอบความคิดหนึ่งครั้งก่อนจะกล่าวถึงตัวเลข OpenAI อธิบายว่า Sol และ Luna มีราคาถูกกว่าราคาโปรโมชันของ GPT-5.6 ถึง 50% คำว่า "โปรโมชัน" เป็นคำของ OpenAI เองและมันมีความหมายอย่างแท้จริง: การเปรียบเทียบนี้เทียบกับอัตราที่มีส่วนลด ไม่ใช่อัตราที่ GPT-5.6 เปิดตัว เมื่อเทียบกับราคาปกติของ GPT-5.6 Luna ที่ $1 สำหรับอินพุตและ $6 สำหรับเอาต์พุต ตามที่เอกสารการเปิดตัวของเราบันทึกไว้ GPT-6 Luna มีราคาลดลง 90% สำหรับอินพุต และ 92% สำหรับเอาต์พุต
ปริมาณงาน A: การจำแนกประเภท QPS สูง
รูปแบบที่ทีมส่วนใหญ่เริ่มใช้ก่อน: พร้อมต์ระบบที่คงที่, สคีมาเครื่องมือและอนุกรมวิธาน (taxonomy), รวมถึงเพย์โหลดตัวแปรขนาดเล็ก, ที่คืนค่าคำตัดสินที่มีโครงสร้างสั้นๆ สมมติว่ามีส่วนนำ (prefix) ที่คงที่ 1,500 โทเค็น, เพย์โหลดตัวแปร 500 โทเค็น, เอาต์พุต 120 โทเค็น และ 5,000,000 คำขอต่อวัน
| โมเดล | ต้นทุนต่อ 1M คำขอ, แบบไม่แคช | ต้นทุนต่อ 1M คำขอ, แบบแคชส่วนนำ |
|---|---|---|
| GPT-6 Luna | $260 | $125 |
| GPT-6 Sol | $5,200 | $2,500 |
| Claude Opus 5.5 | $10,400 | $4,700 |
| GPT-6 Astra | $26,000 | ไม่ได้เผยแพร่ |
| GPT-5.6 Luna, ราคาปกติ | $2,720 | ไม่สามารถใช้ได้ |
ที่ 5,000,000 คำขอต่อวัน ค่าใช้จ่ายสำหรับ Luna ที่มีส่วนนำ (prefix) แบบ warm คือ $625 หรือประมาณ $18,750 ต่อเดือน ปริมาณการใช้งานเดียวกันนี้บน Sol โดยไม่มีการแคชจะอยู่ที่ $26,000 ต่อวัน และบน Astra จะอยู่ที่ $130,000
มีสองสิ่งที่เราได้เรียนรู้จากตารางนั้น ส่วนลดจากการแคชช่วยลดค่าใช้จ่ายนี้ได้ถึง 52% โดยที่ปริมาณงานไม่มีการเปลี่ยนแปลง; ความแตกต่างเพียงอย่างเดียวคือโทเค็น 1,500 ตัวแรกยังคงเหมือนเดิมทุกประการระหว่างการเรียกใช้งานหรือไม่ และช่องว่างของระดับ (tier gap) เมื่อมีปริมาณมากเป็นเรื่องของขนาด (order of magnitude) ไม่ใช่เปอร์เซ็นต์ การเลือกใช้ Luna แทน Sol ในกรณีนี้เป็นการตัดสินใจที่มีผลต่างถึงยี่สิบเท่า ไม่ใช่แค่การลดเล็กน้อย
ปริมาณงาน B: การดึงข้อมูลบริบทขนาดใหญ่
ในที่นี้ หน้าต่างบริบทขนาด 1,000,000 โทเค็นของ Luna ไม่ใช่แค่ตัวเลขบนเอกสารสเปกอีกต่อไป สมมติว่ามีชุดข้อมูลความรู้ขนาด 200,000 โทเค็นที่คงที่ตลอดการเรียกใช้งาน, การสอบถาม 2,000 โทเค็น, เอาต์พุต 600 โทเค็น และ 50,000 คำขอต่อวัน
| ไม่แคช | แคชส่วนนำ | |
|---|---|---|
| GPT-6 Luna, ต่อคำขอ | $0.0205 | $0.0025 |
| GPT-6 Luna, ต่อวัน | $1,025 | $125 |
| GPT-6 Sol, ต่อคำขอ | $0.410 | $0.050 |
| GPT-6 Sol, ต่อวัน | $20,500 | $2,500 |
การแคชช่วยลดค่าใช้จ่ายของ Luna ลง 88% ในกรณีนี้ เทียบกับ 52% ในปริมาณงาน A ความแตกต่างนี้คือจุดสำคัญ: ส่วนลดจะเพิ่มขึ้นตามอัตราส่วนของส่วนนำ (prefix) ที่คงที่ต่อโทเค็นใหม่ ส่วนนำขนาด 200,000 โทเค็นที่ถูกอ่านซ้ำ 50,000 ครั้งต่อวัน เป็นรูปแบบที่การแคชพร้อมต์ให้ประโยชน์สูงสุด
หน้าต่างบริบทของ Luna ยังใหญ่กว่าของ Sol ที่มี 872,000 โทเค็น ดังนั้นเพย์โหลด 900,000 โทเค็นจึงไม่สามารถใส่ในโมเดลที่แพงกว่าได้ แต่สามารถใส่ในโมเดลที่ถูกกว่าได้ ซึ่งตรงกันข้ามกับกฎการกำหนดเส้นทางปกติที่ว่า "เลื่อนไปใช้โมเดลที่ใหญ่ขึ้นเมื่อเพย์โหลดเพิ่มขึ้น" ซึ่งได้กล่าวถึงโดยละเอียดใน GPT-6 Luna คืออะไรกันแน่
ปริมาณงาน C: การเติมข้อมูลย้อนหลังแบบครั้งเดียว
งานแบบ Batch เป็นจุดที่ราคาใหม่เข้ามาเปลี่ยนแปลงความเป็นไปได้ ไม่ใช่แค่เรื่องของราคาที่ถูกลง สมมติว่ามีการประมวลผลเพิ่มข้อมูล 12,000,000 รายการ: คำสั่งคงที่ 900 โทเค็น, 300 โทเค็นต่อรายการ, เอาต์พุต 250 โทเค็น
| GPT-6 Luna | GPT-6 Sol | |
|---|---|---|
| อินพุต, แบบไม่แคช | $1,440 | $28,800 |
| เอาต์พุต | $1,500 | $30,000 |
| รวม, แบบไม่แคช | $2,940 | $58,800 |
| รวม, แบบแคชส่วนนำ | $1,968 | ไม่ได้คำนวณ |
การเติมข้อมูลย้อนหลัง 12 ล้านรายการในราคาต่ำกว่า $3,000 หรือต่ำกว่า $2,000 หากส่วนนำของคำสั่งยังคง "warm" อยู่ นี่คือตัวเลขที่ทีมสามารถขออนุมัติได้ด้วยข้อความเดียว งานเดียวกันนี้บน Sol ต้องมีการพูดคุยเรื่องงบประมาณ
สังเกตอัตราส่วนในที่นี้ เอาต์พุตคิดเป็นครึ่งหนึ่งของค่าใช้จ่าย ซึ่งนำไปสู่สิ่งที่กำหนดต้นทุนของคุณจริงๆ
สามตัวแปรที่กำหนดค่าใช้จ่าย
1. โทเค็นเอาต์พุต เนื่องจากมีค่าใช้จ่ายห้าเท่าของอินพุต
อัตราเอาต์พุตของ Luna เป็น 5 เท่าของอัตราอินพุต ในปริมาณงาน A ที่มีส่วนนำ (prefix) แคชไว้ อินพุตมีค่าใช้จ่าย $65 ต่อล้านคำขอ และเอาต์พุต 120 โทเค็นมีค่าใช้จ่าย $60 หากคลายรูปแบบการตอบกลับเป็น 400 โทเค็น เอาต์พุตจะเพิ่มขึ้นเป็น $200 ทำให้ยอดรวมจาก $125 เป็น $265 ต่อล้านคำขอ สคีมาการตอบกลับที่เลือกในบ่ายวันหนึ่งทำให้ค่าใช้จ่ายเพิ่มขึ้นกว่าสองเท่า
วิธีแก้ไขนั้นน่าเบื่อแต่ได้ผล: จำกัดเอาต์พุต ส่งคืน enum ไม่ใช่ประโยค ส่งคืนคะแนน ไม่ใช่คำอธิบาย และดึงคำอธิบายเฉพาะในกรณีส่วนน้อยที่มนุษย์ตรวจสอบ กำหนดรูปร่างด้วย JSON สคีมา เพื่อให้โมเดลไม่สามารถเพิ่มข้อมูลที่ไม่จำเป็นได้:
{
  "model": "gpt-6-luna",
  "response_format": {
    "type": "json_schema",
    "json_schema": {
      "name": "triage",
      "strict": true,
      "schema": {
        "type": "object",
        "properties": {
          "category": { "enum": ["billing", "outage", "how_to", "abuse"] },
          "severity": { "type": "integer", "minimum": 1, "maximum": 4 }
        },
        "required": ["category", "severity"],
        "additionalProperties": false
      }
    }
  }
}
ยืนยันชื่อพารามิเตอร์กับเอกสารอ้างอิงโมเดลปัจจุบันของ OpenAI ก่อนที่จะสร้างตามรูปแบบนี้ model ID gpt-6-luna เป็นส่วนที่ได้รับการยืนยันจากเอกสารเปิดตัว
2. อัตราการเข้าถึงแคช (Cache hit rate) เพราะเป็นส่วนลด 50% ถึง 88% ฟรีๆ เพียงอย่างเดียวที่คุณจะได้รับ
ทุกสิ่งที่กล่าวมาข้างต้นสมมติว่าส่วนนำ (prefix) ยังคงเหมือนเดิมทุกประการ ในการผลิตจริงมักจะไม่เป็นเช่นนั้น เนื่องจากมีคนแทรก Request ID เข้าไปในพร้อมต์ระบบ หรือสร้างอาร์เรย์เครื่องมือจากพจนานุกรมที่ลำดับคีย์สลับไปมาในกระบวนการต่างๆ ตัวทำลายแคชแบบคลาสสิกสองอย่างได้ถูกตัดออกจากรายการแล้ว: ด้วย GPT-6 การเปลี่ยนความพยายามในการใช้เหตุผลหรือความพร้อมใช้งานของเครื่องมือจะไม่ทำให้แคชไม่ถูกต้องอีกต่อไป และจุดแบ่ง (breakpoints) ที่ชัดเจนช่วยให้คุณตัดสินใจได้ว่าส่วนนำที่แคชไว้จะสิ้นสุดที่ใด แดชบอร์ดการแคชพร้อมต์และเครื่องมือวินิจฉัยทำให้อัตราการเข้าถึงแคช (hit rate) เป็นสิ่งที่คุณวัดได้จริง แทนที่จะสมมติเอาเอง และ GitHub รายงานว่ามีการใช้โทเค็นพร้อมต์ที่ต้องประมวลผลใหม่ลดลงกว่า 50% จากคำขอหลายพันล้านรายการ กลไกต่างๆ ได้อธิบายไว้ใน บทแนะนำการแคชพร้อมต์ GPT-6 ของเรา
เมื่อมีปริมาณมาก ให้ถือว่าอัตราการเข้าถึงแคช (hit rate) เป็น SLI ในการผลิต การปรับปรุงส่วนนำ (prefix refactor) ที่ทำให้ประสิทธิภาพลดลงอย่างเงียบๆ จาก 95% เป็น 40% จะทำให้ปริมาณงาน A มีค่าใช้จ่ายเพิ่มขึ้นประมาณ $400 ต่อวัน และไม่เกิดข้อผิดพลาด, ไม่มีแจ้งเตือน และไม่มีการทดสอบใดๆ ที่ล้มเหลว
3. การลองใหม่ (Retries) เพราะมันทวีคูณ
อัตราการลองใหม่ 5% สำหรับปริมาณงาน A เพิ่มค่าใช้จ่ายประมาณ $31 ต่อวัน พอรับได้ อัตรา 5% เดียวกันนี้สำหรับปริมาณงาน B มีค่าใช้จ่าย $50 ต่อวัน หากการลองใหม่ไม่เจอแคช และ $6 หากเจอแคช และความแตกต่างทั้งหมดอยู่ที่ว่าการลองใหม่ของคุณสร้างพร้อมต์ขึ้นมาใหม่ตั้งแต่ต้นหรือไม่ การลองใหม่ที่สร้างส่วนนำ (prefix) ขึ้นมาใหม่คือความยืดหยุ่นที่แพงที่สุดที่คุณสามารถซื้อได้ ใช้เนื้อหาคำขอเดิมซ้ำ
กับดักของ Latency ที่ QPS สูง
ถูกไม่ได้หมายถึงเร็ว และที่ QPS สูง เรื่องนี้สร้างปัญหาได้ การวัดผลจากบุคคลที่สามจาก Artificial Analysis ระบุว่า GPT-6 Luna มีเอาต์พุต 153.9 โทเค็นต่อวินาที โดยมีเวลาถึงโทเค็นแรก 124.23 วินาที และ GPT-6 Sol อยู่ที่ 102.15 วินาที มีข้อควรระวังสองประการและทั้งสองมีความสำคัญ: ตัวเลขเหล่านี้เป็นของบุคคลที่สามไม่ใช่ผู้ขายเผยแพร่ และถูกวัดจากรุ่นการให้เหตุผลสูงสุด (max reasoning variants) ซึ่งเป็นการกำหนดค่าที่ช้าที่สุดที่มีอยู่
ถึงอย่างนั้น ทิศทางก็ยังสำคัญ สองนาทีสำหรับโทเค็นแรกจะทำให้ HTTP client timeout ตามค่าเริ่มต้น, โหลดบาลานเซอร์ไม่ทำงาน และเกินขีดจำกัดการทำงานของ serverless runtimes ส่วนใหญ่ เส้นทาง synchronous ที่มี QPS สูงควรใช้ความพยายามต่ำและมีการสตรีม; ความพยายามสูงควรอยู่ในงานแบบ batch และ worker ในคิวที่ไม่มีอะไรรอ socket กำหนดเวลา timeout โดยเทียบกับ latency ที่วัดได้ในระดับความพยายามที่คุณใช้งานจริง ไม่ใช่เทียบกับราคา
จุดต่ำสุดของคุณภาพอยู่ที่ใด
Luna ไม่ใช่โมเดลที่ฉลาดที่สุดในตระกูล และ OpenAI ก็ไม่ได้อ้างเช่นนั้น Astra "ยังคงเป็นโมเดลที่ดีที่สุดของเราในทุกด้าน" ตามคำกล่าวของ OpenAI เอง สิ่งที่ OpenAI เผยแพร่: Luna ที่ความพยายามสูงสุดได้คะแนน 66.6% บน DeepSWE 1.1 ซึ่งเทียบเท่ากับ Claude Opus 5 และ Claude Fable 5 ที่ความพยายามปานกลาง โดยมีต้นทุนต่อภารกิจต่ำกว่า Opus 5 ถึง 93% และต่ำกว่า Fable 5 ถึง 96% บน AutomationBench 1.0.6 ที่ความพยายามสูง มันทำคะแนนได้ดีกว่ารุ่นก่อนหน้า 5.4 คะแนน ด้วยต้นทุนต่อภารกิจที่ต่ำกว่า 58% บน OSWorld 2.0 แบบออฟไลน์ที่ความพยายามสูงสุด มันเอาชนะ GPT-5.6 Sol ที่ความพยายามปานกลางด้วยต้นทุนเพียงหนึ่งในสิบ
ตัวเลขเหล่านี้เป็นตัวเลขของผู้จำหน่ายที่วัดเทียบกับ Claude Opus 5 ไม่ใช่ Opus 5.5 ที่เปิดตัวในวันเดียวกัน ดังนั้นจึงควรถือว่าเป็นแนวทางเท่านั้น การตีความในเชิงปฏิบัติคือ Luna เป็นโมเดลที่ถูกที่สุดที่ผ่านเกณฑ์สำหรับงานที่ระบุรายละเอียดชัดเจนและตรวจสอบได้ และคำว่า "ตรวจสอบได้" เป็นคำที่มีความหมายสำคัญ
พิสูจน์โมเดลต้นทุนก่อนที่จะมุ่งมั่นกับมัน
การคำนวณในสเปรดชีตเป็นเพียงสมมติฐาน ทดสอบกับปริมาณการใช้งานจริง: ใช้ตัวอย่างเพย์โหลดในการผลิต 500 คำขอ รันเทียบกับ Luna และ Sol ในฐานะสองสภาพแวดล้อม และบันทึกจำนวนโทเค็น, latency และความสอดคล้องของสคีมา
ใน Apidog นั่นคือ endpoint ที่บันทึกไว้หนึ่งรายการ โดยมี model ID เป็นตัวแปรสภาพแวดล้อม ซึ่งถูกรันเป็นสถานการณ์ทดสอบกับไฟล์ข้อมูลของเพย์โหลดจริง เพิ่มการยืนยันสามอย่าง และชุดการทดสอบจะกลายเป็นรั้วป้องกันค่าใช้จ่าย แทนที่จะเป็นการตรวจสอบความถูกต้อง: ยืนยันว่าการตอบกลับตรงกับ JSON สคีมาของคุณ, ยืนยันว่า usage.completion_tokens อยู่ภายใต้งบประมาณเอาต์พุตต่อคำขอของคุณ, และยืนยันว่า usage.prompt_tokens_details.cached_tokens ไม่เป็นศูนย์ ดังนั้นการปรับปรุงส่วนนำ (prefix refactor) ที่ทำให้อัตราการเข้าถึงแคชของคุณลดลงอย่างมากจะทำให้ CI ล้มเหลวแทนที่จะปรากฏในใบแจ้งหนี้เดือนถัดไป ยืนยันชื่อฟิลด์การใช้งานเหล่านั้นกับเอกสารอ้างอิง API ปัจจุบันก่อนที่คุณจะทำการยืนยัน
การยืนยันสุดท้ายนั้นเป็นสิ่งที่ไม่มีใครเขียน แต่ทุกคนต้องการ โหมดความล้มเหลวของปริมาณงาน LLM ที่มีปริมาณมากแทบจะไม่ใช่การหยุดชะงัก (outage) มันคือใบแจ้งหนี้ที่เพิ่มขึ้น 4 เท่าอยู่เบื้องหลังแดชบอร์ดสีเขียว
สำหรับภาพรวมว่าราคาของ Luna เป็นอย่างไรเมื่อเทียบกับ GPT-6 Sol และ Claude Opus 5.5 ตลอดทั้งสัปดาห์ โปรดดูการวิเคราะห์ของเราเกี่ยวกับ สงครามราคาโมเดล AI เดือนกันยายน 2026
สรุปสั้นๆ
กำหนดเส้นทางงานที่มีปริมาณมาก, ระบุรายละเอียดชัดเจน, และตรวจสอบได้ด้วยโปรแกรมไปยัง Luna และรักษาส่วนที่เสถียรของพร้อมต์ของคุณให้เหมือนกันทุกประการ จำกัดโทเค็นเอาต์พุต เนื่องจากมีค่าใช้จ่ายห้าเท่าของอินพุต วัดอัตราการเข้าถึงแคช (cache hit rate) เป็นเมตริกการผลิต หลีกเลี่ยงความพยายามสูงจากเส้นทาง synchronous จนกว่าคุณจะได้วัดเวลาโทเค็นแรกจากการใช้งานของคุณเอง ทำเช่นนั้น แล้วงานที่ไม่เคยถูกนำไปใช้งานจริงเพราะการคำนวณไม่เป็นไปตามที่คาดไว้ ก็คุ้มค่าที่จะลองประเมินต้นทุนอีกครั้งในสัปดาห์นี้