
GPT-6 Astra ยกระดับคะแนน MATH-500 ของ Qwen3.5-0.8B จาก 7.9% เป็น 48.1% โดยไม่ต้องฝึกโมเดลเลย มันอ่านค่าน้ำหนัก (weights) ของโมเดล ค้นพบหนึ่งทิศทางที่ทำให้โมเดลวนซ้ำในการคิด แล้วลบทิศทางนั้นออกจากชั้น MLP สองชั้น การแก้ไขนั้นแตะค่าน้ำหนัก 131,072 ค่า คิดเป็น 0.016% ของโมเดล ตัวเลขเหล่านี้มาจากโพสต์วันที่ 2 พฤศจิกายนของนักวิจัยสี่คนจาก MIT CSAIL และโมเดลที่แก้ไขแล้วเปิดเผยต่อสาธารณะ คุณจึงตรวจสอบข้อกล่าวอ้างนี้ได้ด้วยตัวเอง
ข้างล่างนี้: weight-space programming คืออะไร Astra เปลี่ยนแปลงอะไรบ้าง วิธีนี้หมดประสิทธิภาพตรงไหน และจะให้ coding agent ของคุณเปรียบเทียบโมเดลทั้งสองด้วย Apidog CLI ได้อย่างไร
weight-space programming คืออะไร?
weight-space programming คือการที่ LLM แบบอเนกประสงค์อ่านและเขียนค่าน้ำหนักของโครงข่ายประสาทเทียมโดยตรง โดยมีเป้าหมายที่เขียนเป็นภาษาธรรมชาติเป็นตัวกำกับ ไม่มีการทำ gradient descent และไม่มีลูปการฝึก โมเดลให้เหตุผลว่าแต่ละส่วนของโครงข่ายคำนวณอะไร แล้วแก้ตัวเลขด้วยมือ เหมือนที่โปรแกรมเมอร์แก้โค้ดต้นฉบับ
คำนี้มาจาก Sparks of Weight-Space Programming โดย Rikiya Takehi, Jayden Teoh, Alex Zhang และ Omar Khattab เผยแพร่เมื่อวันที่ 2 พฤศจิกายน 2026 ผู้เขียนเรียกผลลัพธ์ทุกชิ้นว่า “early มาก” และหลายชิ้นมาจากการรันเพียงครั้งเดียวหรือไม่กี่ครั้ง สำหรับข้อมูลพื้นฐานเกี่ยวกับโมเดลที่ทำการแก้ไข ดูได้ที่ รีวิวทดลองใช้ GPT-6 Astra
GPT-6 Astra แก้ไข Qwen3.5-0.8B ได้อย่างไร
ผลลัพธ์ที่เป็นไฮไลต์คือการทดลองที่ 8 นักวิจัยขอให้ GPT-6 Astra ทำให้ Qwen3.5-0.8B เก่งคณิตศาสตร์ขึ้นโดยการแก้ไขค่าน้ำหนักของมัน นี่คือสิ่งที่เกิดขึ้นทีละขั้น:
- การตั้งต้น Astra ได้เซสชัน Python (เหมือนโน้ตบุ๊ก) ที่โหลดค่าน้ำหนักของโมเดลไว้ ไม่มี GPU และมีโจทย์ฝึกจาก GSM8K 7,469 ข้อ บวกโจทย์ MATH 7,275 ข้อจากชุดฝึกฝน มันไม่เคยเห็นชุดทดสอบเลย
- งบประมาณ แทนที่จะฝึก Astra สามารถใช้ forward pass ได้ 10, 25 หรือ 50 รอบ หนึ่ง forward pass ให้โมเดลตอบได้มากถึง 512 ข้อ หรืออ่านข้อความได้มากถึง 1,024 ชิ้น
- การวินิจฉัย Astra เห็นว่าโมเดลฐานวนซ้ำ: 85 จาก 96 คำตอบฝึกแรกของมันวิ่งไปจนถึงขีดจำกัด 32,768 โทเคนโดยไม่ได้คำตอบ ผู้เขียนตั้งข้อสังเกตว่าโมเดลการ์ดของ Qwen เองก็เตือนว่าโมเดลนี้มีแนวโน้มที่จะคิดวนซ้ำ
- การตามรอย Astra สืบสาวการวนซ้ำไปถึงหนึ่งทิศทางที่เขียนโดย MLP ของชั้นที่ 15 และ 19
- การแก้ไข มันลบทิศทางนั้นออกจาก 64 คอลัมน์เอาต์พุตของ
down_projในแต่ละชั้นจากสองชั้นนั้น คิดเป็น 131,072 ค่าน้ำหนัก จากทั้งหมด 0.8 พันล้านค่า
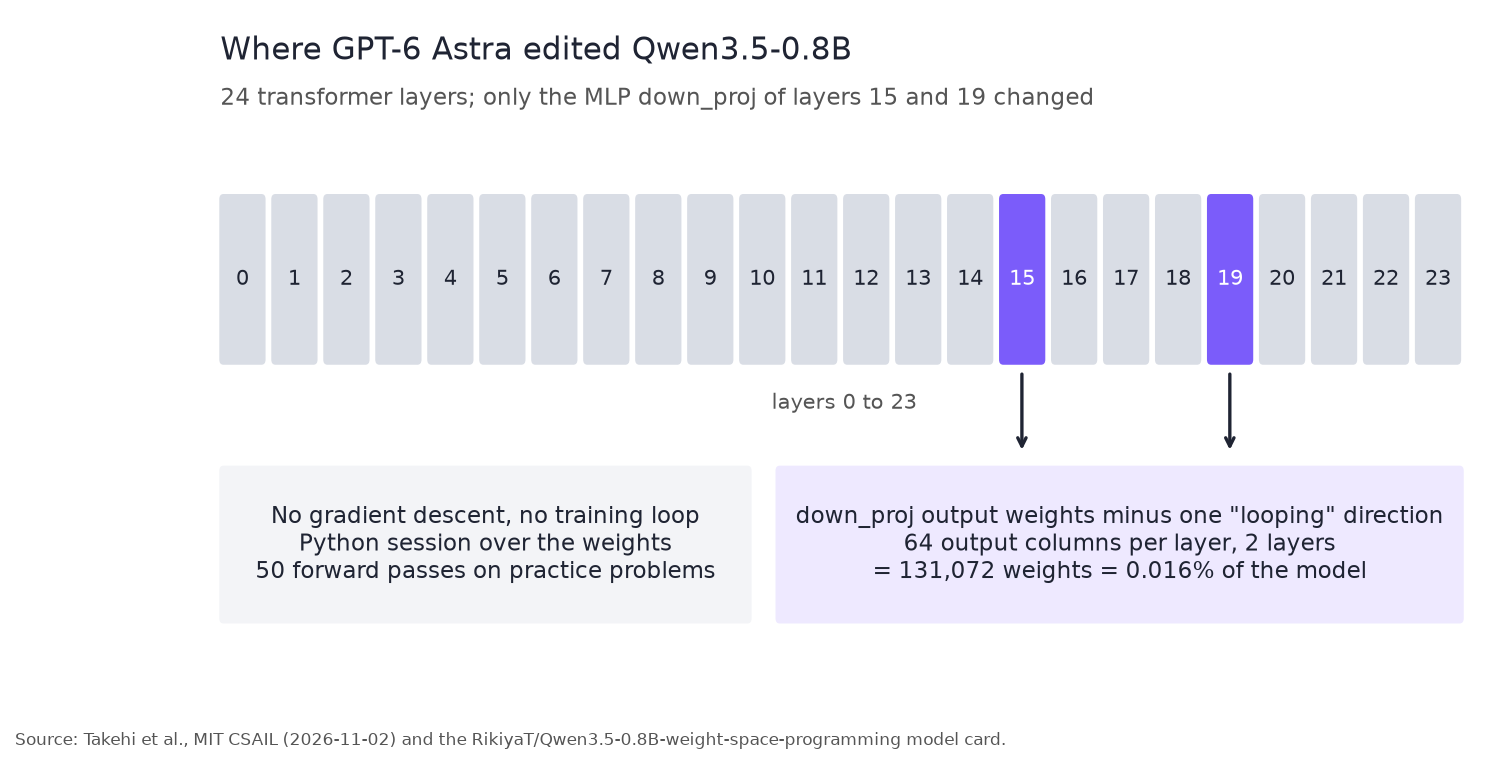
ตามโมเดลการ์ดบน Hugging Face มีเพียงเทนเซอร์ down_proj สองตัวนั้นที่ต่างจากเช็กพอยต์ฐาน Qwen/Qwen3.5-0.8B และเทนเซอร์ที่สร้างขึ้นใหม่แต่ละตัวได้รับการตรวจสอบ sha256 เทียบกับตัวที่ผู้เขียนประเมินไว้ โมเดลที่แก้ไขแล้วเผยแพร่ภายใต้สัญญาอนุญาต Apache 2.0
ผลลัพธ์: Qwen3.5-0.8B ฐาน เทียบกับฉบับแก้ไข
ตัวเลขทุกตัวที่นี่มาจากโพสต์ของผู้เขียน (เปิดโหมดคิด สูงสุด 32,768 โทเคน หลายตัวอย่างต่อโจทย์) “ชนขีดจำกัดโทเคน” คือสัดส่วนของคำตอบ MATH-500 ที่ใช้โทเคนจนหมด
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | ชนขีดจำกัดโทเคน |
|---|---|---|---|---|
| โมเดลฐาน | 7.9% | 13.8% | 21.0% | 93.0% |
| แก้ไขแล้ว, 10 forward pass | 12.3% | 25.7% | 49.0% | 87.2% |
| แก้ไขแล้ว, 25 forward pass | 14.1% | 25.1% | 39.9% | 86.4% |
| แก้ไขแล้ว, 50 forward pass | 48.1% | 67.1% | 62.3% | 33.1% |
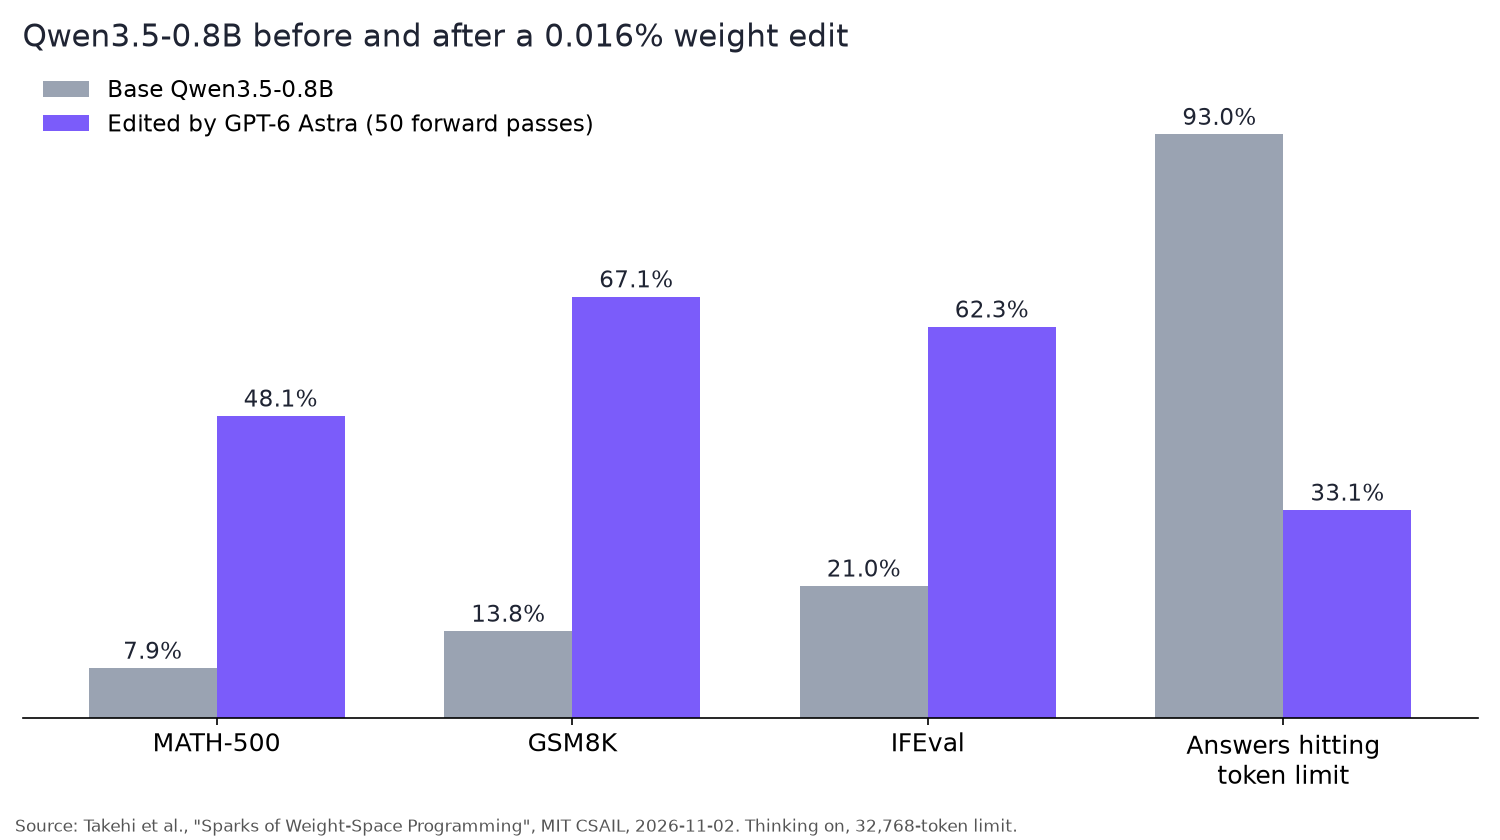
- การแก้ไขได้ผลทั่วไป การวนซ้ำไม่ได้จำเพาะกับคณิตศาสตร์ IFEval จึงเพิ่มขึ้นราวสามเท่าเช่นกัน
- งบประมาณมีผล ที่ 10 หรือ 25 forward pass การวนซ้ำแทบไม่ลดลงเลย
- มีคนอื่นทำซ้ำได้ Ahsen Khaliq จาก Hugging Face สร้างเช็กพอยต์ขึ้นใหม่จากล็อก แล้วรัน MATH-500 ทั้งชุดใหม่ (500 ข้อ ข้อละ 4 ตัวอย่าง) โมเดลที่แก้ไขแล้วได้คะแนน 51.0% โดย 31.6% ของคำตอบชนขีดจำกัด การทดสอบแบบสมอกด้วยโจทย์ 25 ข้อของโมเดลฐานได้ 5.0%
เดโม Space ให้คุณพิมพ์โจทย์แล้วดูโมเดลทั้งสองตอบ
สิ่งที่การแก้ไขค่าน้ำหนักทำไม่ได้
ผู้เขียนรันกลุ่มควบคุมที่สำคัญยิ่งกว่าผลลัพธ์ไฮไลต์ พวกเขาลองใช้วิธีเดียวกันกับ Gemma 3 270M ซึ่งเป็นโมเดลที่แทบไม่วนซ้ำ (8.5% ของคำตอบชนขีดจำกัด เทียบกับ 93% ของ Qwen)
| Gemma 3 270M | MATH-500 |
|---|---|
| โมเดลฐาน | 6.8% |
| การแก้ไขที่ดีที่สุด (25 forward pass) | 7.7% |
ข้อผิดพลาดของ Gemma เป็นแบบธรรมดา เช่น คำนวณเลขผิด โดยไม่มีองค์ประกอบใดองค์ประกอบหนึ่งให้ปิดสวิตช์ได้ ข้อสรุปของผู้เขียน: การแก้ไขลบอุปสรรคที่บดบังความสามารถที่มีอยู่ แต่มันเพิ่มความสามารถที่โมเดลไม่มีไม่ได้ Qwen คิดคำตอบได้หลายข้ออยู่แล้ว มันแค่คิดไม่จบเท่านั้น
ดังนั้นนี่ไม่ใช่ “การฝึกโมเดลจบยุคแล้ว” แต่เป็นการที่โมเดลระดับแนวหน้าค้นพบและกำจัดความล้มเหลวหนึ่งอย่างที่อยู่ในจุดเดียว
ส่วนที่เหลือของงานวิจัย weight-space programming
การทดลองที่ 8 เป็นหนึ่งในแปด ส่วนที่เหลือใช้โครงข่ายที่เล็กกว่ามาก:
- การอ่านค่าน้ำหนัก จากค่าน้ำหนักดิบเพียงอย่างเดียว Astra ระบุชื่อเกมของนโยบายเล่นเกมที่ฝึกด้วย PPO ได้ 4 จาก 4 และระบุภาษาที่ใช้ฝึกของโมเดลภาษาเล็ก ๆ ระดับอักขระได้ 3 จาก 3
- การแก้นโยบาย นโยบายขับรถ Kinetix ที่ล้มเหลว 256 จาก 256 ตอน สำเร็จได้ 1,024 จาก 1,024 ตอน หลังจาก Astra แก้ไข 3.5% ของค่าน้ำหนักในการตอบเพียงครั้งเดียว
- การเขียนค่าน้ำหนักจากศูนย์ Astra เขียนค่าน้ำหนัก MinAtar Breakout ที่ได้คะแนน 517.4 เทียบกับ 25.3 ของ PPO ที่ฝึกไป 500 ล้านสเต็ป แต่แพ้ในเกม Seaquest ที่ 53.1 เทียบกับ 88.9
- หมากโกะ มันเขียนโครงข่ายโกะ 9x9 ขนาด 1.48 ล้านค่าน้ำหนักจากศูนย์ ซึ่งเมื่อใช้ 50 forward pass ชนะโครงข่าย PPO ขนาดเท่ากันได้
- กรณีที่พลาด จากค่าน้ำหนักเพียงอย่างเดียว มันแยกไม่ออกว่า Gemma 3 270M สองชุดใดถูกฝึกให้ประจบสอพลอ แต่เมื่อเข้าถึงรูปแบบ attention ได้ มันเลือกตัวที่ประจบได้ถูกในทั้งสามคู่
ล็อกการทดลองฉบับเต็ม มีพรอมป์ต์ทุกอัน บทสรุปการให้เหตุผลของ Astra และโค้ดทุกชิ้นที่มันรัน
ตรวจสอบการแก้ปัญหาคิดวนซ้ำของ Qwen3.5-0.8B ได้ด้วยตัวเอง
วิธีทดสอบที่สะอาดที่สุดคือเสิร์ฟเช็กพอยต์ทั้งสองไว้หลัง API ที่เข้ากันได้กับ OpenAI แบบเดียวกัน แล้วส่งพรอมป์ต์ที่เหมือนกันให้ทั้งคู่ vLLM ทำแบบนี้ได้ด้วยคำสั่งเดียวต่อโมเดลหนึ่งตัว:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
เซิร์ฟเวอร์ทั้งสองตอบสนองต่อชื่อ qwen ดังนั้นเนื้อคำขอชุดเดียวใช้ได้กับพอร์ตใดก็ได้ --max-model-len 34816 ตรงกับตัวอย่างในโมเดลการ์ด
คำขอแต่ละครั้งสะท้อนค่าการสุ่มตัวอย่างของผู้เขียน และเปิดโหมดคิด:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
ค่า \boxed{} ตัวสุดท้ายคือคำตอบ และ finish_reason บอกว่าโมเดลหยุดเอง (stop) หรือใช้โทเคนจนหมด (length) การจบแบบ length คือการวนซ้ำ
ถ้าไม่อยากใช้ GPU คุณทดสอบ GPT-6 Astra API ด้วยวิธีเดียวกันได้ หรือเปรียบเทียบโมเดล Qwen ขนาดเล็กในเครื่องด้วย การติดตั้ง Qwen3.5 กับ Ollama แบบฟรี
ให้ coding agent ของคุณทดสอบโมเดลทั้งสองด้วย Apidog CLI
การให้คะแนนผลลัพธ์ยาว ๆ ยี่สิบชิ้นด้วยมือเป็นงานของ coding agent ของคุณ Apidog CLI มอบ environment, test scenario, การรันแบบขับเคลื่อนด้วยข้อมูล และรายงานให้กับ agent และมันรันบนเครื่องของคุณเอง ปลายทาง localhost จึงใช้งานได้
ติดตั้งแล้วให้ skill แก่ agent ของคุณ:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นส่งพรอมป์ต์เดียวให้ Claude Code, Codex, Cursor หรือ OpenCode:
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
agent จะอ่านสกีมาของเพย์โหลด ตรวจสอบ JSON ของมัน แล้วรันคำสั่งเหล่านี้:
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d ป้อนข้อมูลแต่ละแถวของ CSV เป็นหนึ่งรอบวน --timeout-request มีหน่วยเป็นมิลลิวินาที และคำตอบที่วนซ้ำอาจใช้เวลาหลายนาทีกว่าจะเผาโทเคนครบ 32,768 -r cli,json พิมพ์สรุปและเขียนรายงาน JSON ที่ agent นำไป diff ได้ โจทย์ 10 ข้อนั้นมาจาก ชุดทดสอบ GSM8K
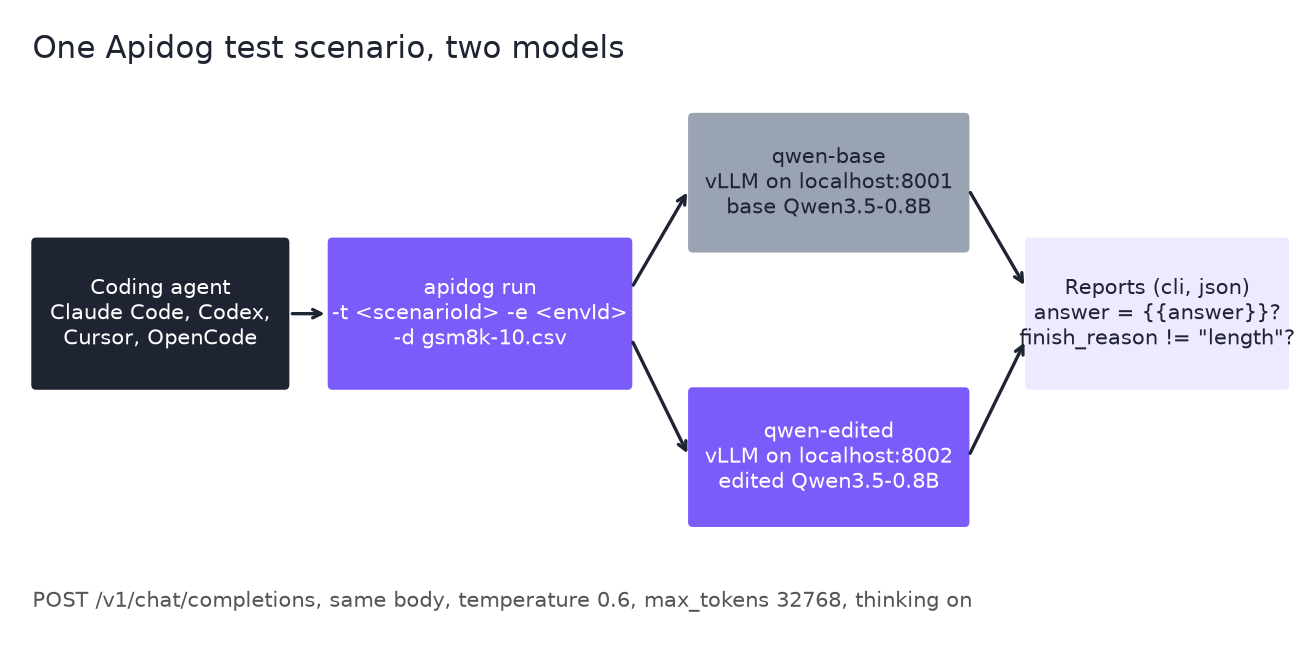
ถ้าการรันของคุณออกมาเหมือนของผู้เขียน คำตอบของโมเดลฐานส่วนใหญ่จะไม่ผ่านการตรวจ finish_reason และคำตอบที่แก้ไขแล้วส่วนใหญ่จะผ่าน โจทย์ 10 ข้อเป็นการทดสอบแบบสมอก ไม่ใช่ benchmark ดังนั้นให้มองช่องว่างเป็นสัญญาณ ไม่ใช่คะแนน เพิ่ม --upload-report เพื่อดูการรันในแอป และดู เอกสารอ้างอิงคำสั่ง apidog run สำหรับแฟล็กทุกตัว
สกีมาเดิมนี้ใช้เป็น regression test ได้กับการสลับโมเดลใดก็ได้ คู่มือ Apidog CLI CI/CD แสดงวิธีตั้งค่า -r junit
สิ่งนี้หมายความว่าอย่างไรถ้าคุณปล่อยโมเดลขนาดเล็ก
- วัดการตัดทอน ไม่ใช่แค่ความแม่นยำ ตัวเลข 7.9% ของ Qwen ปิดบังโมเดลที่ส่วนใหญ่คิดไม่จบ การตรวจ
finish_reasonจับเรื่องนี้ได้ - มองหาความล้มเหลวที่มีสาเหตุเดียว การวนซ้ำและการพูดซ้ำอาจอยู่ในส่วนแคบ ๆ ของโครงข่าย
- อย่าลืมกลุ่มควบคุม ถ้าโมเดลของคุณตอบผิดมากกว่าติดอยู่ การแก้ไขแบบนี้จะไม่ช่วย
กำลังเลือกระดับ GPT-6 สำหรับงาน agent อยู่หรือเปล่า? ดู GPT-6 Luna vs Sol vs Astra
คำถามที่พบบ่อย
GPT-6 Astra ฝึก Qwen3.5-0.8B หรือไม่? ไม่ ผู้เขียนไม่อนุญาตให้ใช้ gradient descent และไม่มีลูปการฝึก Astra แก้ไขค่าน้ำหนักในเซสชัน Python และสังเกตโมเดลผ่านเพียง 10, 25 หรือ 50 forward pass เท่านั้น
การแก้ไขเปลี่ยนค่าน้ำหนักไปกี่ค่า? 131,072 ค่า ซึ่งผู้เขียนระบุว่าเป็น 0.016% ของโมเดล การเปลี่ยนแปลงอยู่ในเมทริกซ์ down_proj ของ MLP ในชั้นที่ 15 และ 19 ชั้นละ 64 คอลัมน์เอาต์พุต
โมเดลที่แก้ไขแล้วมีให้ใช้หรือไม่? มี ในชื่อ RikiyaT/Qwen3.5-0.8B-weight-space-programming บน Hugging Face ภายใต้ Apache 2.0 พร้อมแฮชของเทนเซอร์สองตัวที่เปลี่ยนไป และการรันซ้ำโดยอิสระ (51.0% บน MATH-500)
ทำไมคะแนนคณิตศาสตร์จึงพุ่งขึ้นมาก? เพราะโมเดลฐานวนซ้ำ บน MATH-500 มี 93.0% ของคำตอบที่ชนขีดจำกัด 32,768 โทเคน การแก้ไขลดตัวเลขนั้นเหลือ 33.1% โมเดลจึงคิดคำตอบที่มันคิดได้อยู่แล้วจนจบ มันไม่ได้เรียนคณิตศาสตร์ใหม่
weight-space programming ใช้ได้กับทุกโมเดลหรือไม่? ยังไม่ใช่ ตามที่ผู้เขียนเองกล่าว บน Gemma 3 270M ซึ่งแทบไม่วนซ้ำ การแก้ไขที่ดีที่สุดขยับ MATH-500 จาก 6.8% เป็น 7.7% ผู้เขียนเรียกผลลัพธ์ทั้งหมดของตนว่า early มาก
ทดสอบโมเดลที่แก้ไขแล้วโดยไม่เขียนโค้ดได้ไหม? ได้ เดโม Space บน Hugging Face รันโมเดลทั้งสองกับโจทย์ที่คุณพิมพ์ สำหรับการตรวจสอบที่ทำซ้ำได้ ให้ใช้ vLLM ร่วมกับ Apidog CLI ตามที่แสดงข้างต้น