
การเลือกระหว่าง GPT-6.2 Astra กับ Claude Fable 5.2 สรุปได้ว่า: ทั้งสองมีราคา $8 ต่อ token อินพุตหนึ่งล้านตัว และ $40 ต่อ token เอาต์พุตหนึ่งล้านตัว ทั้งคู่มีคอนเท็กซ์ประมาณหนึ่งล้าน token และเอาต์พุต 128K และทั้งสองตั้งเป้าไปที่งานเขียนโค้ดแบบ agentic ที่ยาวนาน สิ่งที่ต่างกันและเป็นตัวชี้ขาดการเลือกของคุณคือ ราคาแคช (cache pricing), การเรียกเก็บเงินคอนเท็กซ์ยาว, ลักษณะเฉพาะของ API ที่ agent harness ของคุณต้องจัดการ และพฤติกรรมของแต่ละโมเดลเมื่อทำงานกับงานของคุณเอง
OpenAI เปิดตัว GPT-6.2 Astra เมื่อวันที่ 17 พฤศจิกายน 2026 หลังจาก Anthropic ปล่อย Claude Fable 5.2 ไปแล้ว 8 วัน คู่มือนี้ครอบคลุมสเปกต่างๆ ต้นทุนของ agent session จริง, ข้อผิดพลาดของ request ที่ทำให้ harness ที่สร้างมาสำหรับอีกโมเดลพัง และวิธีทดสอบทั้งสองด้วย Apidog CLI
GPT-6.2 Astra vs Claude Fable 5.2: คำตัดสินอย่างรวดเร็ว
เลือก Claude Fable 5.2 ถ้า agent ของคุณส่งพรอมต์ยาวและอ่านคอนเท็กซ์แคชขนาดใหญ่ซ้ำๆ เพราะค่าอ่านแคชถูกกว่าครึ่งหนึ่ง และหน้าต่างเต็ม 1M เรียกเก็บเงินตามอัตรามาตรฐาน เลือก GPT-6.2 Astra ถ้าสแตกของคุณใช้ OpenAI Responses API อยู่แล้ว และคุณต้องการ hosted tools ของมัน เช่น apply_patch, hosted shell และ multi-agent subagents สำหรับกรณีอื่นๆ ให้ทดสอบทั้งสองโมเดลกับงานของคุณเองก่อนตัดสินใจ
รีวิวช่วงแรกๆ มักเอนไปทางฝั่ง Fable ในแง่ความสามารถดิบ Simon Willison เขียนไว้ในวันเปิดตัว ว่า Astra "ไม่ได้คะแนนสูงเท่า Fable 5.2 ใน benchmark หลายตัว" และนักทดสอบบางคนพบว่าสไตล์การสื่อสารของมันสับสน ให้ถือว่านี่เป็นสัญญาณให้ทดสอบ ไม่ใช่คำตัดสินสุดท้าย
GPT-6.2 Astra กับ Claude Fable 5.2 เทียบกันด้านสเปกและราคาอย่างไร?
ทั้งสองโมเดลมีราคาพื้นฐานเหมือนกัน ดังนั้นการเปรียบเทียบจึงอยู่ที่รายละเอียด ตัวเลขทุกตัวด้านล่างมาจากหน้าโมเดล GPT-6.2 Astra และภาพรวม Claude Fable 5.2 ตรวจสอบเมื่อวันที่ 18 พฤศจิกายน 2026
| สเปก | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| API model ID | gpt-6.2-astra |
claude-fable-5-2 |
| วันที่เปิดตัว | 17 พ.ย. 2026 | 9 พ.ย. 2026 |
| อินพุต / เอาต์พุต ต่อ 1M token | $8 / $40 | $8 / $40 |
| อินพุตแบบแคช (อ่านแคช) | $0.40 | $0.20 |
| เขียนแคช | $10 (30 นาที), $20 (12 ชม.) | $10 (5 นาที), $16 (1 ชม.) |
| หน้าต่างคอนเท็กซ์ | 1,050,000 (อินพุตสูงสุด 922,000) | 1M |
| เอาต์พุตสูงสุด | 128,000 | 128K |
| พรอมต์ยาว | เกิน 272K อินพุต: อินพุต 2 เท่า, เอาต์พุต 1.5 เท่า | เต็ม 1M ที่ราคามาตรฐาน |
| Batch | ลด 50% | ลด 50% |
| Knowledge cutoff | 18 พ.ค. 2026 | มิ.ย. 2026 |
| การควบคุม reasoning | reasoning.effort (ค่า none ถูกปฏิเสธ) |
effort, ค่าเริ่มต้น high, เปิด thinking ตลอด |
ราคาทั้งสองลดลง 20% จากรุ่นก่อน GPT-6 Astra และ Claude Fable 5 อยู่ที่ $10 / $50 ทั้งคู่ ตามที่ Willison ระบุ ถ้าคุณยังใช้โมเดลเก่าอยู่ คู่มือ GPT-6 Astra API และการวิเคราะห์ราคา Claude Fable 5.2 อธิบายสิ่งที่เปลี่ยนไป
coding agent session หนึ่งครั้งมีต้นทุนจริงเท่าไร?
coding agent ไม่ค่อยส่งพรอมต์สั้นๆ เพียงอันเดียว มันโหลดคอนเท็กซ์ของ repo, นิยามของเครื่องมือ และประวัติการสนทนาซ้ำในทุกๆ เทิร์น ดังนั้นการอ่านแคชและกฎพรอมต์ยาวจึงสำคัญกว่าราคาที่ติดป้ายไว้
นี่คือสองตัวอย่าง workloads ที่คำนวณราคาจากตารางอัตราอย่างเป็นทางการ ที่การประมวลผลระดับ Standard
| Workload | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Agent session: เขียนแคช 150K token, อ่านแคช 1.35M, เอาต์พุต 150K (ทุก request ต่ำกว่า 272K) | $1.50 + $0.54 + $6.00 = $8.04 | $1.50 + $0.27 + $6.00 = $7.77 |
| Request ยาวหนึ่งครั้ง: อินพุต 400K, เอาต์พุต 8K, ไม่มีแคช | $6.40 + $0.48 = $6.88 | $3.20 + $0.32 = $3.52 |
ต้นทุน session ใกล้เคียงกันเพราะเอาต์พุตเป็นส่วนที่ครอบงำ: เอาต์พุต 150K token มีค่าใช้จ่าย $6.00 ในทั้งสองโมเดล ช่องว่างของการอ่านแคชช่วยประหยัด 27 เซนต์ในที่นี้ และจะเพิ่มขึ้นเมื่อ session ยาวขึ้น
Request ยาวครั้งเดียวคือจุดที่บิลแตกต่างกัน เมื่อ request ของ Astra เกิน 272K input token OpenAI จะเพิ่มอัตราอินพุตเป็นสองเท่าเป็น $16 และเพิ่มเอาต์พุตเป็น $60 สำหรับ request ทั้งหมด ส่วน Fable 5.2 คิดค่าพรอมต์ 400K ที่อัตราเดียวกับพรอมต์ 4K คือ $8
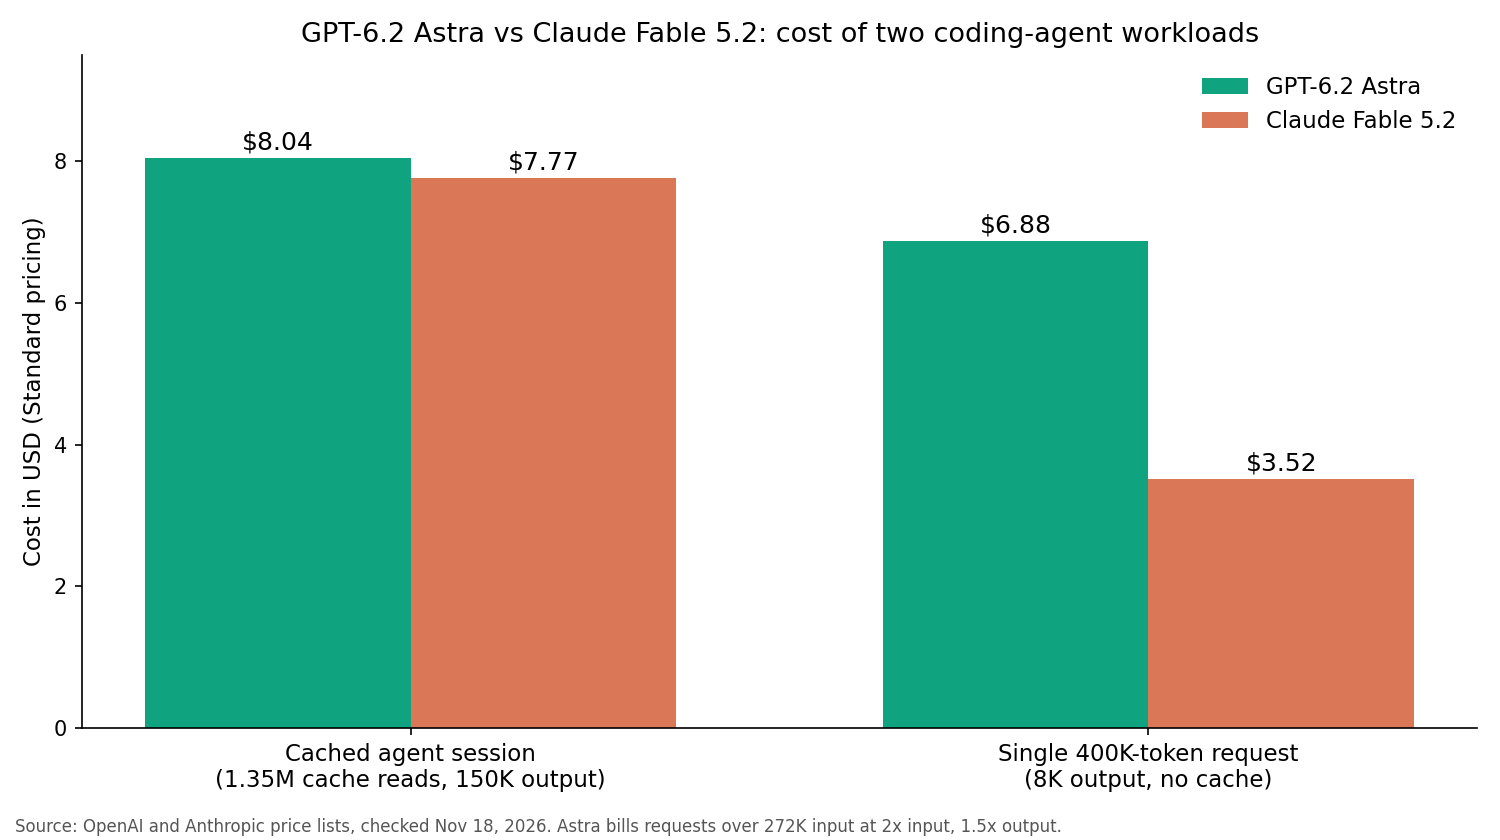
ถ้า agent ของคุณยัด monorepo ขนาดใหญ่หรือ log ยาวๆ ลงใน request เดียว ให้รักษาไว้ต่ำกว่า 272K บน Astra ไม่อย่างนั้นคุณจะจ่ายเกือบสองเท่า
ลักษณะเฉพาะของ API แบบไหนที่ทำให้ harness ที่สร้างมาสำหรับอีกโมเดลพัง?
การสลับโมเดลไม่ใช่แค่การเปลี่ยนชื่อโมเดล API แต่ละตัวปฏิเสธการตั้งค่าที่อีกตัวยอมรับ และความล้มเหลวทั้งสองแบบกลับมาเป็นข้อผิดพลาด HTTP 400
Claude Fable 5.2 ปฏิเสธ:
- การบังคับใช้เครื่องมือ การตั้ง
tool_choiceเป็นanyหรือtoolจะคืน 400 ตามหมายเหตุ Fable 5.2 ของ Anthropic - พารามิเตอร์ sampling ให้ละเว้น
temperature,top_pและtop_k; ค่าที่ Anthropic ระบุไว้จะคืน 400 - การปิด thinking Adaptive thinking เปิดตลอดเวลา ดังนั้นพารามิเตอร์ effort เป็นตัวควบคุมเดียวของคุณสำหรับความลึก, latency และต้นทุน
GPT-6.2 Astra ปฏิเสธ:
reasoning.effortที่ตั้งเป็นnone(Responses API) หรือreasoning_effort: "none"(Chat Completions) ตามคู่มือ reasoning ของ OpenAI- Endpoint Realtime, Assistants และ fine-tuning ซึ่งหน้าโมเดลระบุว่าไม่รองรับ
ถ้า harness ของคุณบังคับ tool call เพื่อให้ได้ structured output มันจะทำงานบน Astra แต่ล้มเหลวบน Fable; ให้ย้ายโครงสร้างไปไว้ในพรอมต์หรือ tool schema แทน ถ้ามันตั้ง temperature: 0 ให้เอาออกเมื่อใช้กับ Fable
การจัดการข้อมูลก็แตกต่างกันด้วย Anthropic ระบุว่า Fable 5.2 ต้องการการเก็บรักษาข้อมูล 30 วัน และไม่สามารถใช้งานภายใต้ zero data retention ได้ เว้นแต่ Anthropic อนุญาตเป็นการเฉพาะ ตรวจสอบเรื่องนี้กับนโยบายความปลอดภัยของคุณก่อนส่งโค้ด production ผ่านโมเดลนี้
GPT-6.2 Astra ชนะตรงไหน?
จุดแข็งของ Astra คือกล่องเครื่องมือที่มากับมัน ใน Responses API OpenAI ระบุเครื่องมือที่รองรับได้แก่ apply_patch, hosted_shell, computer_use, code_interpreter, mcp, skills และ tool_search มีเวอร์ชันเบต้า multi-agent ที่ให้ Astra มอบงานให้ subagents ทำได้
เรื่องนี้สำคัญถ้าคุณไม่อยากสร้าง patch applier และ shell runner ของตัวเอง
ฟีดแบ็กก่อนเปิดตัวของ Theo Browne ซึ่ง Willison อ้างถึง บอกว่า Astra "สามารถดึง subagents จำนวนมากเข้ามาและจัดการมันได้ค่อนข้างดี" ในงานยาวๆ แต่บางครั้งหยุดถามเรื่องรายละเอียดภายในที่ผู้ใช้ตอบไม่ได้ ให้กำหนดเงื่อนไขการหยุดให้ชัดเจน
Astra ยังมีระดับราคาให้เลือกมากกว่า: Batch ลด 50%, Fast mode 2 เท่าของ Standard และหน้าต่าง background ที่ถูกกว่า Standard 30% สำหรับการเสร็จใน 2 ชั่วโมง และถูกกว่า 40% สำหรับการเสร็จใน 8 ชั่วโมง การสร้าง test ตอนกลางคืนสามารถรันบนตัวเลือกเหล่านี้เพื่อประหยัดได้
Claude Fable 5.2 ชนะตรงไหน?
Fable ชนะในคอนเท็กซ์ยาวๆ ที่ใช้แคชหนัก การอ่านแคชของมันราคา $0.20 ต่อล้าน token คิดเป็น 2.5% ของราคาอินพุต และหน้าต่างเต็ม 1M ถูกคิดราคาตามอัตรามาตรฐานโดยไม่มีตัวคูณพรอมต์ยาว
Anthropic วางตำแหน่ง Fable 5.2 สำหรับ agent session ที่รันเป็นชั่วโมง การควบคุม effort ของมันอยู่ระหว่าง low ถึง max; Anthropic แนะนำให้เริ่มที่ high ซึ่งเป็นค่าเริ่มต้น และเพิ่มเป็น xhigh เฉพาะจุดที่คุณวัดผลแล้วได้ประโยชน์จริง
มันยังได้รับการตอบรับเชิงบวกกว่าในงานเขียนโค้ดเชิงสร้างสรรค์ที่ยากในช่วงแรก ในการทดสอบวันเปิดตัวของ Willison พรอมต์ Three.js animation ที่รันบนโมเดล OpenAI ใหม่ทั้งสองที่ระดับ effort สูงสุด Ultra ใน Codex CLI ไม่มีตัวไหนเทียบผลลัพธ์ที่เขาได้จาก Fable 5.2
Fable ยังรันบน Amazon Bedrock, Google Cloud และ Microsoft Foundry และ Fast mode ของมันให้ความเร็วเอาต์พุตสูงขึ้นถึง 2.5 เท่าที่ $16 / $80 ต่อล้าน token สำหรับตัวอย่าง request ดูคู่มือ Claude Fable 5.2 API
จะทดสอบ GPT-6.2 Astra และ Claude Fable 5.2 กับ API workload ของคุณเองอย่างไร?
Benchmark วัดงานของคนอื่น แทนที่จะงั้น ให้รันพรอมต์ชุดเดียวกันผ่านทั้งสอง API:
- เลือกพรอมต์จริง 5-10 อันจากประวัติของ agent คุณ เช่น การแก้บั๊ก, การ refactor และงานเขียน test
- เขียน request หนึ่งอันต่อโมเดลด้วยเนื้อหาเหมือนกัน โดยใช้รูปแบบของแต่ละ API
- Assert สถานะ 200, คำตอบที่ไม่ว่าง และโครงสร้างที่ agent ของคุณ parse
- รันแต่ละ request หลายครั้งและเปรียบเทียบ token, latency และอัตราผ่าน
ทั้งสอง call เป็น HTTP ธรรมดา นี่คือ request ของ Astra บน Responses API:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6.2-astra", "reasoning": {"effort": "high"},
       "input": "Review this diff and list the bugs."}'
Fable 5.2 ผ่าน Anthropic Messages API โดยใช้ claude-fable-5-2 เป็นโมเดลและไม่มีฟิลด์ temperature
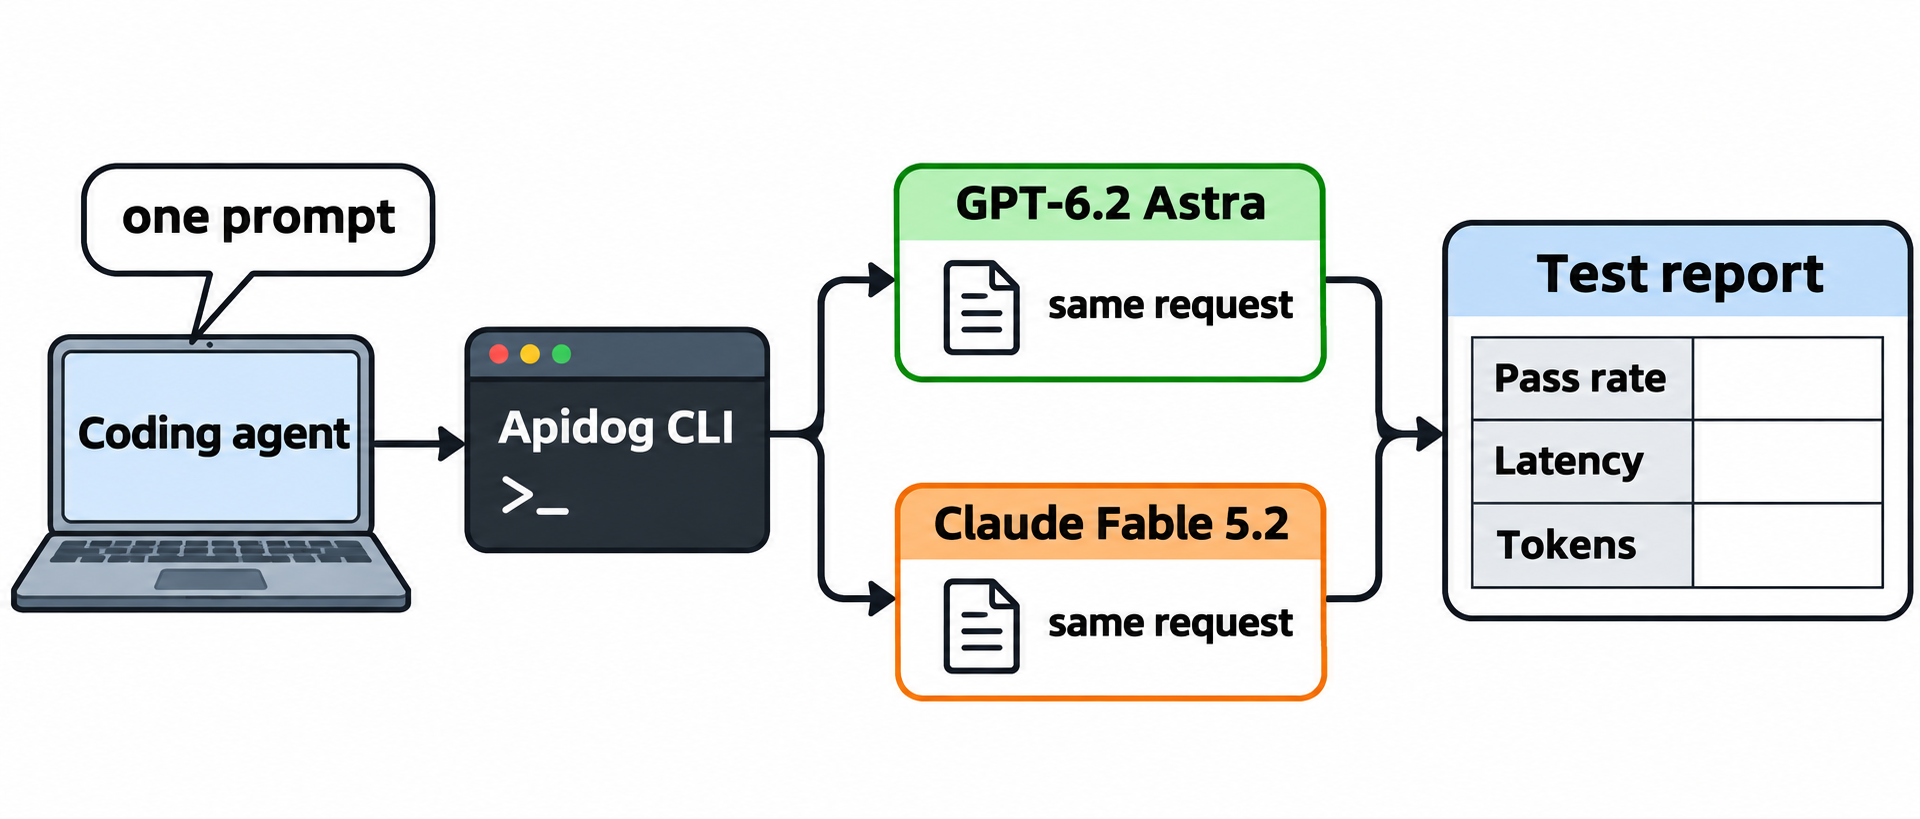
ให้ coding agent ของคุณรันการทดสอบ A/B ด้วย Apidog CLI
การรันคู่ request ด้วยมือเองเบื่อเร็วมาก ให้ Claude Code, Codex หรือ Cursor เป็นผู้ขับเคลื่อน Apidog CLI แทน การตั้งค่าใช้สามคำสั่ง:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง agent ของคุณด้วยพรอมต์เดียว:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gpt-6.2-astra through the OpenAI Responses
API, and one that sends the same prompt to claude-fable-5-2 through
the Claude Messages API with no temperature field. Keep both API keys
in private environment variables. Assert a 200 status and a non-empty
answer, record token usage and response time, run each case 5 times
and summarize cost per run. Validate every payload before you write it.
Agent จะตรวจสอบ schema ของ payload, เขียน test cases และรันมัน ฟลากด้านล่างมาจาก apidog run --help บน CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <ASTRA_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 ทำซ้ำแต่ละเคสห้าครั้ง เพื่อให้ response ที่ช้าครั้งเดียวไม่ตัดสินผล เพิ่ม --upload-report เพื่อดูการรันในแอป Apidog นี่คือ template workflow; เรายังไม่ได้รันมันกับ Astra จากเครื่องนี้
คุณยังสามารถเปลี่ยนส่วนลักษณะเฉพาะของ API ให้เป็น test ได้ด้วย สั่ง agent ให้สร้าง negative case ที่ส่ง tool_choice: any ไปที่ Fable และคาดหวัง 400 และอีกอันที่ส่ง effort: none ไปที่ Astra และคาดหวัง 400 ถ้า provider รายใดเปลี่ยนกฎ suite ของคุณจะแจ้งคุณก่อนที่ agent ของคุณจะพบปัญหา คู่มือ Apidog CLI ใน Claude Code และคู่มือ Apidog CLI ใน Codex อธิบายการตั้งค่า agent
แผน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน ซึ่งเพียงพอสำหรับการเปรียบเทียบนี้
FAQ
GPT-6.2 Astra ถูกกว่า Claude Fable 5.2 หรือไม่? ราคาพื้นฐานเหมือนกันที่ $8 อินพุต และ $40 เอาต์พุตต่อล้าน token Fable ถูกกว่าในการอ่านแคช ($0.20 เทียบกับ $0.40) และใน request ใดๆ ที่เกิน 272K input token ซึ่ง Astra เพิ่มอัตราอินพุตเป็นสองเท่า
โมเดลไหนมีหน้าต่างคอนเท็กซ์ใหญ่กว่า? Astra ระบุคอนเท็กซ์ 1,050,000 token พร้อมเพดานอินพุต 922,000 token Fable 5.2 ระบุ 1M token ทั้งสองจำกัดเอาต์พุตที่ 128K token ต่อ request
ใช้ forced tool calls กับ Claude Fable 5.2 ได้หรือไม่? ไม่ได้ tool_choice แบบ any หรือ tool จะคืนข้อผิดพลาด 400 ปล่อยให้โมเดลเลือกเครื่องมือเอง และอธิบายโครงสร้างที่ต้องการในพรอมต์หรือ tool schema
ปิด reasoning บน GPT-6.2 Astra ได้หรือไม่? ไม่ได้ API จะปฏิเสธ reasoning.effort ที่ตั้งเป็น none ด้วยข้อผิดพลาด 400 ให้เลือกระดับ effort ที่รองรับและต่ำกว่าแทน สำหรับ call ที่เร็วและถูก
ควรรัน coding agent ของฉันบนโมเดลไหน? เริ่มจาก workload ของคุณ พรอมต์ยาวๆ ที่ใช้แคชหนักเหมาะกับ Fable 5.2 ส่วนสแตกที่เป็น OpenAI-native และต้องการเครื่องมือ patch, shell และ subagent แบบ hosted เหมาะกับ Astra รันทั้งสองกับพรอมต์จริง 5-10 อันก่อนสลับ