
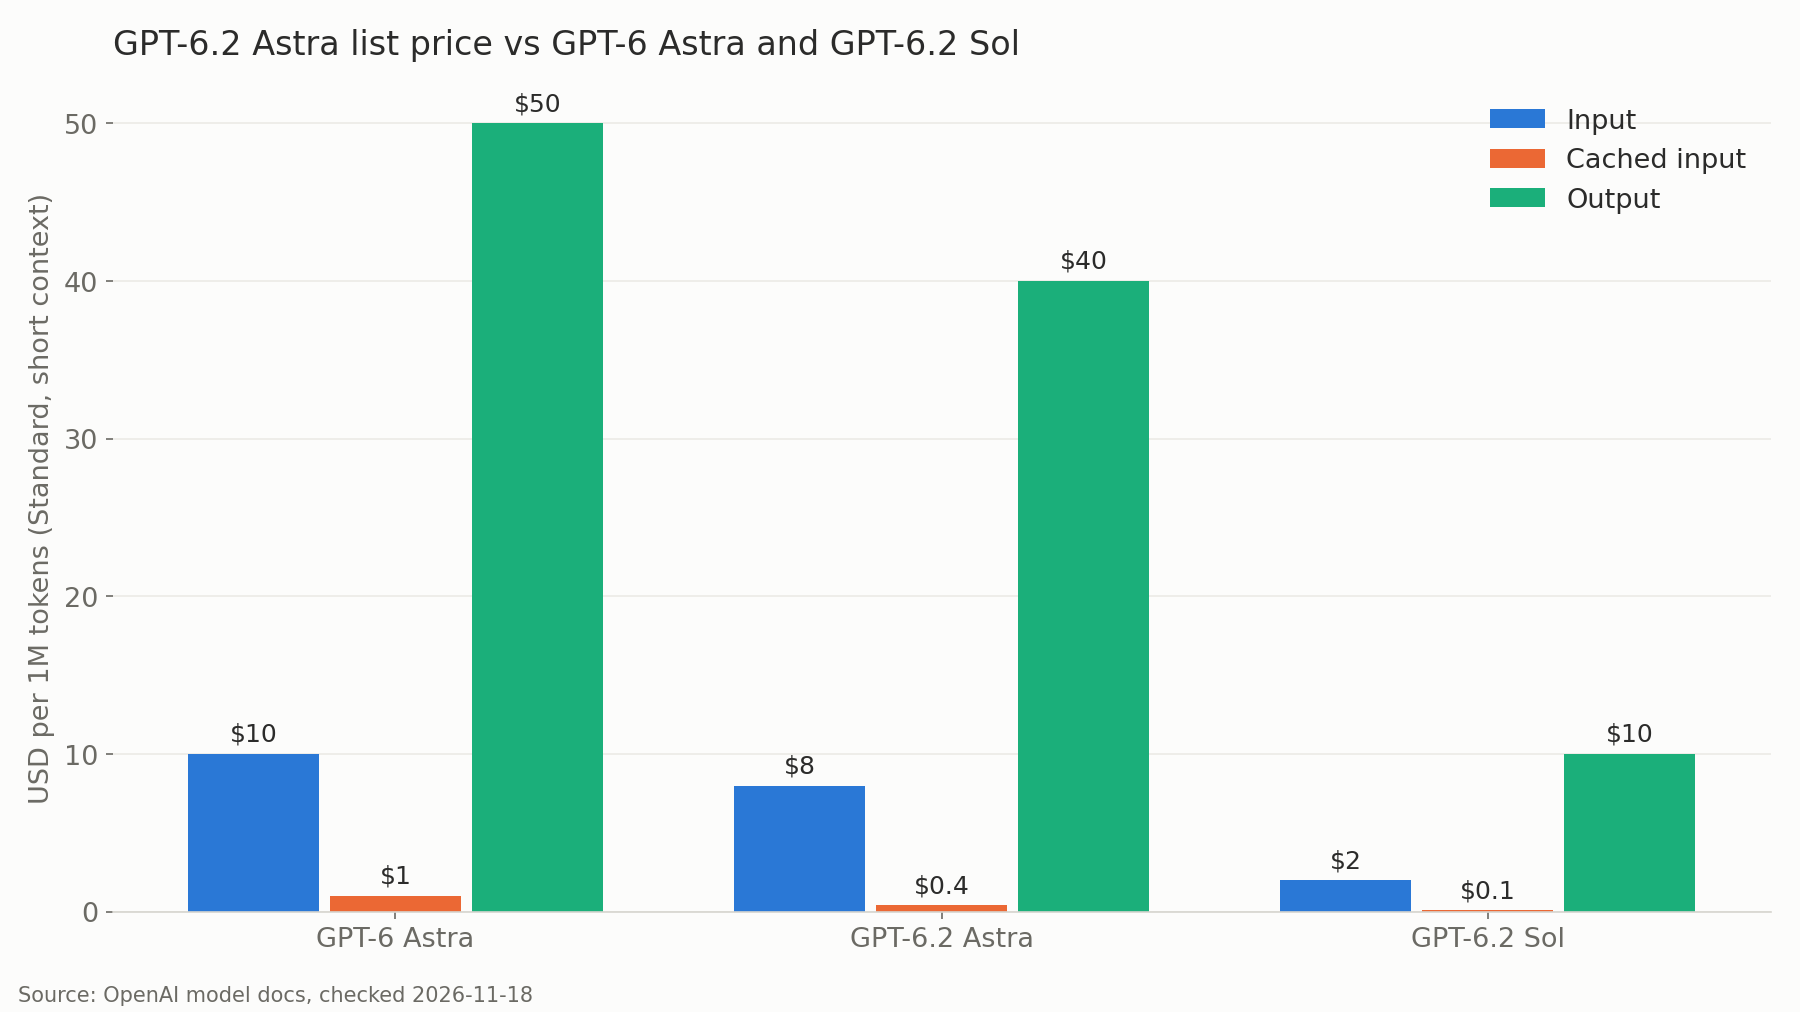
ราคาของ GPT-6.2 Astra อยู่ที่ $8 ต่อ token ฝั่ง input 1 ล้านตัว และ $40 ต่อ token ฝั่ง output 1 ล้านตัวในแพ็กเกจ Standard ของ OpenAI โดย input แบบ cached อยู่ที่ $0.40 ต่อ 1 ล้านตัว ซึ่งถูกกว่า GPT-6 Astra ($10/$50) อยู่ 20% และอัตราการอ่าน cache ลดลงถึง 60% ส่วนรุ่นพี่น้องอย่าง GPT-6.2 Sol มีราคา $2 สำหรับ input และ $10 สำหรับ output ต่อ token 1 ล้านตัว
OpenAI เปิดตัวทั้งสองโมเดลเมื่อวันที่ 17 พฤศจิกายน 2026 ในชื่อ gpt-6.2-astra และ gpt-6.2-sol
ภาพรวมราคา GPT-6.2 Astra
GPT-6.2 Astra คือโมเดลระดับ frontier ของ OpenAI ที่ออกแบบมาสำหรับโปรเจกต์ที่ยาวและซับซ้อน เช่น การเขียนโค้ด การใช้งานคอมพิวเตอร์ และการทำงานกับเอกสาร โดยมี context window ขนาด 1,050,000 token และ output ได้สูงสุด 128,000 token ในแพ็กเกจ Standard จะคิดค่าบริการ $8 ต่อ input token 1 ล้านตัว, $0.40 ต่อ cached input token 1 ล้านตัว และ $40 ต่อ output token 1 ล้านตัว สำหรับพรอมต์ที่มีขนาดไม่เกิน 272K token
| อัตรา (ต่อ 1M token, Standard) | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
| Input | $8.00 | $2.00 | $10.00 |
| Cached input | $0.40 | $0.10 | $1.00 |
| Cache write (30 นาที) | $10.00 | $2.50 | $12.50 |
| Cache write (12 ชั่วโมง) | $20.00 | $5.00 | $25.00 |
| Output | $40.00 | $10.00 | $50.00 |
Reasoning token จะถูกคิดค่าบริการในอัตราเดียวกับ output token ซึ่งเป็นเรื่องสำคัญสำหรับ Astra เพราะโมเดลนี้จะปฏิเสธคำขอที่ตั้งค่า reasoning effort เป็น none ดังนั้นทุกการเรียกใช้งานจึงมีค่าใช้จ่ายด้าน reasoning เพิ่มขึ้นเสมอ นอกเหนือจากคำตอบที่มองเห็นได้
ค่าใช้จ่าย API ของ GPT-6.2 Astra ต่อ token
Input token หนึ่งตัวมีราคา $0.000008 และ output token หนึ่งตัวมีราคา $0.00004 โดย output มีราคาเป็น 5 เท่าของ input ดังนั้นสิ่งที่โมเดลเขียนออกมา รวมถึง reasoning ที่ซ่อนอยู่ จึงเป็นตัวกำหนดค่าใช้จ่ายส่วนใหญ่ของคุณ
คำขอแชททั่วไปที่มี input token 3,000 ตัวและ output token 800 ตัว จะมีค่าใช้จ่ายดังนี้:
- GPT-6.2 Astra: $0.024 input + $0.032 output = $0.056
- GPT-6.2 Sol: $0.006 + $0.008 = $0.014
- GPT-6 Astra: $0.030 + $0.040 = $0.070
หากขยายเป็นแอปที่ให้บริการคำขอลักษณะนี้วันละ 20,000 ครั้ง ภายใน 30 วันจะมีคำขอทั้งหมด 600,000 ครั้ง: คิดเป็นประมาณ $33,600 บน GPT-6.2 Astra, $8,400 บน GPT-6.2 Sol และ $42,000 บน GPT-6 Astra ทั้งนี้ Sol ยังคงราคา $2/$10 เท่าเดิมกับ GPT-6 Sol และ GPT-6.1 Sol ดังนั้นหากคุณวางงบประมาณสำหรับ Sol ไว้แล้ว ก็ไม่มีอะไรเปลี่ยนแปลง
ราคา cache ของ GPT-6.2 Astra: การเปลี่ยนแปลงครั้งใหญ่ที่สุด
ส่วนลดที่ถูกพูดถึงคือ 20% แต่ส่วนลดด้าน cache ใหญ่กว่านั้น การอ่าน cache ของ GPT-6.2 Astra มีราคา $0.40 ต่อ 1 ล้าน token หรือเท่ากับ 0.05 เท่าของอัตรา input ขณะที่ GPT-6 Astra คิดราคา $1.00 หรือ 0.1 เท่า โดย คู่มือ prompt caching ของ OpenAI ยืนยันว่าอัตราการอ่าน 0.05 เท่านี้มีผลกับ GPT-6.2 Astra, GPT-6.2 Sol, GPT-6.1 Sol และ GPT-6.1 Terra
มีกฎสามข้อที่กำหนดค่าใช้จ่ายของคุณ:
- การเขียน cache แทนที่ค่า input ไม่ได้คิดซ้ำสองชั้น Token ที่ถูกเขียนลง cache จะถูกคิดในอัตรา write แทนอัตรา input ไม่ใช่คิดทั้งสองอย่าง โดยการ write แบบ 30 นาทีมีราคา 1.25 เท่าของ input ($10 บน Astra) ส่วนแบบ 12 ชั่วโมงมีราคา 2.5 เท่า ($20)
- prefix ขั้นต่ำคือ 1,024 token พรอมต์ที่สั้นกว่านี้จะไม่ถูกเก็บใน cache
- การอ่านมีราคาเท่ากันทั้งสองอายุการใช้งาน เลือกใช้การ write แบบ 12 ชั่วโมงเฉพาะกับ system prompt ที่คงที่และเอกสารอ้างอิงที่ถูกใช้ซ้ำในช่วงเวลาที่ห่างกัน
ด้วยอัตราเหล่านี้ การใช้ cache คุ้มค่าตั้งแต่การใช้ซ้ำครั้งแรก การ write แบบ 30 นาทีหนึ่งครั้งบวกการอ่านหนึ่งครั้ง มีต้นทุน 1.30 เท่าของราคา prefix แบบไม่ใช้ cache เทียบกับ 2 เท่าเมื่อส่งซ้ำสองครั้ง และในสิบคำขอจะเป็น 1.70 เท่า เทียบกับ 10 เท่า
Simon Willison เรียกราคา cache นี้ว่า "ข่าวดีสำหรับ agentic session ที่รันยาว" ใน บทความวันเปิดตัว ของเขา สำหรับกลยุทธ์เพิ่มเติม ดูได้จากคู่มือ GPT-6 prompt caching ของเรา
session ของ agent 50 เทิร์นมีค่าใช้จ่ายเท่าไร
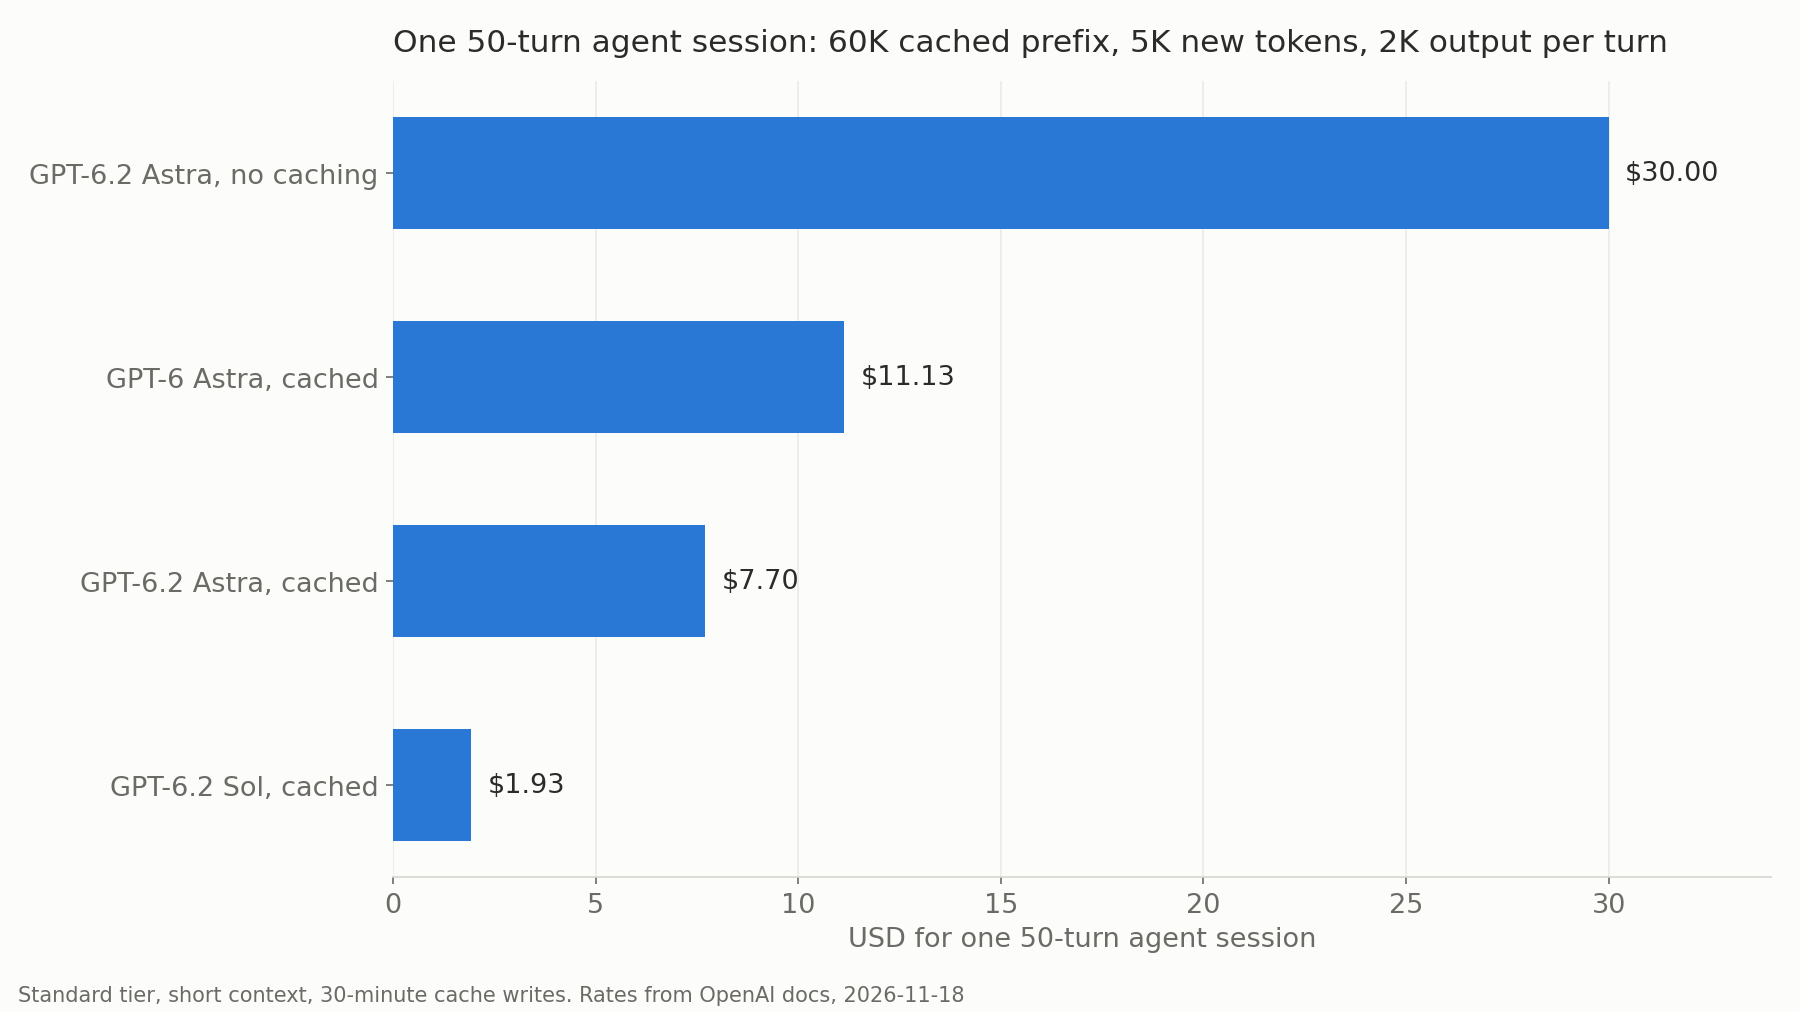
ลองพิจารณา coding agent ที่รัน 50 เทิร์น โดยแต่ละเทิร์นจะอ่าน prefix ขนาด 60K token จาก cache, เขียน token ใหม่ 5K ตัวลง cache แบบ 30 นาที และสร้าง output token 2K ตัว
| โมเดลและการตั้งค่า | ต้นทุนต่อเทิร์น | ต้นทุนต่อ session |
|---|---|---|
| GPT-6.2 Astra, ไม่ใช้ caching | $0.600 | $30.00 |
| GPT-6 Astra, ใช้ cache | $0.223 | $11.13 |
| GPT-6.2 Astra, ใช้ cache | $0.154 | $7.70 |
| GPT-6.2 Sol, ใช้ cache | $0.039 | $1.93 |
การใช้ cache ช่วยลดต้นทุน session ของ GPT-6.2 Astra ลง 74% เมื่อเทียบกับ GPT-6 Astra ที่ใช้ cache แบบเดียวกัน โมเดลใหม่ถูกกว่าต่อ session ถึง 31% ซึ่งมากกว่าส่วนลดราคา 20% เพราะ cached prefix คือสัดส่วนที่ใหญ่ที่สุดของ input
ราคา long-context สำหรับ input เกิน 272K token
GPT-6.2 Astra รองรับ input ได้สูงสุด 922,000 token แต่ราคาจะเปลี่ยนเมื่อเกิน 272K เมื่อ input ของคำขอเกิน 272K token อัตรา input และ cache จะเพิ่มขึ้นเป็นสองเท่า และ output เพิ่มขึ้นเป็น 1.5 เท่า ซึ่งมีผลกับคำขอทั้งหมด ไม่ใช่เฉพาะส่วนที่เกิน
| อัตรา (ต่อ 1M token) | Input ไม่เกิน 272K | Input เกิน 272K |
|---|---|---|
| Input | $8.00 | $16.00 |
| Cached input | $0.40 | $0.80 |
| Cache write (30 นาที) | $10.00 | $20.00 |
| Output | $40.00 | $60.00 |
การรีวิวโค้ดเบสขนาด 400K token หนึ่งครั้ง พร้อม output 4K token มีค่าใช้จ่าย $6.40 + $0.24 = $6.64 หากลดขนาดการรีวิวเดียวกันลงเหลือ 250K token ราคาจะลดเหลือ $2.00 + $0.16 = $2.16 และหากรันการรีวิว 400K ซ้ำๆ โดยมี 380K token มาจาก cache และเขียน token ใหม่ 20K ตัว ต้นทุนจะอยู่ที่ประมาณ $0.94 ต่อรอบ
การใช้ retrieval และการตัดทอนเนื้อหาช่วยประหยัดค่าใช้จ่ายได้ เมื่อพรอมต์มีขนาดอยู่เหนือ 272K เพียงเล็กน้อย
Batch, background windows, Fast และ Ultrafast
หน้าราคา ของ OpenAI ระบุ GPT-6.2 Astra อยู่ภายใต้ processing tier สี่ระดับ พร้อม background window แบบลดราคา โดย GPT-6.2 ไม่ปรากฏในตาราง Flex ดังนั้น background window จึงทำหน้าที่แทนสำหรับงานที่รอได้
| Tier (context สั้น) | Input / output ของ Astra | Input / output ของ Sol |
|---|---|---|
| Standard | $8 / $40 | $2 / $10 |
| Batch (ลด 50%) | $4 / $20 | $1 / $5 |
| Background, หน้าต่าง 8 ชั่วโมง (ลด 40%) | $4.80 / $24 | $1.20 / $6 |
| Background, หน้าต่าง 2 ชั่วโมง (ลด 30%) | $5.60 / $28 | $1.40 / $7 |
| Fast (2 เท่า) | $16 / $80 | $4 / $20 |
| Ultrafast, ถึงวันที่ 28 กุมภาพันธ์ 2027 (3 เท่า) | $24 / $120 | $6 / $30 |
| Ultrafast, ตั้งแต่วันที่ 1 มีนาคม 2027 (6 เท่า) | $48 / $240 | $12 / $60 |
Background window เป็น public beta บน Responses API คุณตั้งค่า background เป็น true และ background_options.completion_window เป็น 2h หรือ 8h พร้อมปิด streaming คู่มือ background mode ระบุข้อควรระวังสองข้อ: คำขอเหล่านี้ใช้ rate limit ร่วมกับ Batch และคำขอ Standard ไม่สามารถใช้ cache entries ที่สร้างโดยคำขอ 2h หรือ 8h ได้
ตัวอย่างเช่น job ประจำคืนที่สรุปเอกสาร 10,000 ฉบับ โดยแต่ละฉบับมี input 4K token และ output 500 token:
| Tier | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Standard | $520 | $130 |
| Background, 2 ชั่วโมง | $364 | $91 |
| Background, 8 ชั่วโมง | $312 | $78 |
| Batch | $260 | $65 |
อัตรา 3 เท่าของ Ultrafast เป็นโปรโมชัน ซึ่งจะเพิ่มเป็น 6 เท่าในวันที่ 1 มีนาคม 2027 ดังนั้นอย่าวางงบประมาณโดยอิงอัตรานี้
GPT-6.2 Astra เทียบกับ GPT-6.2 Sol และโมเดล flagship คู่แข่ง
Astra มีราคาเป็น 4 เท่าของ Sol ในทุกบรรทัด หน้าโมเดล ของ Sol ระบุ context ขนาด 1,050,000 token เท่ากัน, output cap ที่ 128,000 เท่ากัน, เครื่องมือเดียวกัน และ rate limit เดียวกัน ดังนั้นการเลือกใช้จึงขึ้นอยู่กับคุณภาพต่องาน ไม่ใช่ฟีเจอร์
| โมเดล (ต่อ 1M token) | Input | Cached read | Output |
|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
| Claude Fable 5.2 | $8.00 | $0.20 | $40.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
ราคาของ Claude มาจาก หน้าราคาของ Anthropic ตรวจสอบเมื่อวันที่ 18 พฤศจิกายน 2026 GPT-6.2 Astra และ Claude Fable 5.2 มีราคา $8/$40 เท่ากัน แต่ cache hit ของ Fable 5.2 มีราคา $0.20 และอัตราการ write เป็นไปตามอายุการใช้งานแบบ 5 นาทีและ 1 ชั่วโมงของ Anthropic ไม่ใช่แบบ 30 นาทีและ 12 ชั่วโมงของ OpenAI ดังนั้นให้เปรียบเทียบต้นทุนจริงจาก traffic ของคุณเอง
บทวิจารณ์ช่วงแรกมีความเห็นแตกต่างกันด้านคุณภาพ Willison ระบุว่า GPT-6.2 Astra "ได้คะแนนไม่สูงเท่า Fable 5.2 ใน benchmarks หลายตัว" ดังนั้นควรทดสอบด้วยตัวเองก่อนตัดสินใจใช้ หากคุณย้ายมาจากรุ่นก่อนหน้า คู่มือ GPT-6 Astra API ของเราอธิบายรูปแบบคำขอ และ การย้ายจาก GPT-6 Astra ไป Sol อธิบายว่าเมื่อใดที่โมเดลที่ถูกกว่าเพียงพอ
ทั้งสองโมเดลใช้ Standard rate limit เดียวกัน: 5,000 คำขอ และ 1M token ต่อนาทีใน tier Build และสูงสุดถึง 15,000 คำขอ และ 40M token ต่อนาทีใน Grow
ให้ Codex ตรวจสอบค่าใช้จ่าย GPT-6.2 Astra ของคุณด้วย Apidog CLI
ตารางราคาจะมีประโยชน์ก็ต่อเมื่อคำขอของคุณเข้าถึง cache ได้จริงและไม่เกิน 272K coding agent ของคุณสามารถตรวจสอบเรื่องนี้ได้ทุกครั้งที่ build ด้วย Apidog CLI
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง agent ของคุณด้วยพรอมต์เดียว:
Create an Apidog test case in project <id> for POST /v1/responses with model
gpt-6.2-astra. Send the same 2,000-token system prompt twice. Assert both calls
return 200, usage.input_tokens stays under 272000, and the second call reports
usage.input_tokens_details.cached_tokens above 0. Run it against the openai
environment and summarize any failures.
Agent จะอ่าน schema, ตรวจสอบ payload, สร้าง test case และรัน:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
หากการแก้ไขพรอมต์ทำให้การใช้ cache พัง หรือดันคำขอให้เกิน 272K การรันจะ fail ก่อนที่บิลจะมาถึง สามารถใช้ apidog run เดียวกันพร้อม -r junit ใน CI ได้ โดยคู่มือ Apidog CLI CI/CD pipeline ของเรามี setup ที่คัดลอกวางได้ทันที และ Apidog CLI in Codex ครอบคลุมฝั่ง agent ส่วนแพ็กเกจ Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน
คำถามที่พบบ่อย
GPT-6.2 Astra มีราคาเท่าไรต่อ 1M token? $8 ต่อ input token 1 ล้านตัว, $0.40 ต่อ cached input token 1 ล้านตัว และ $40 ต่อ output token 1 ล้านตัวใน tier Standard สำหรับคำขอที่มี input ไม่เกิน 272K token
GPT-6.2 Astra ถูกกว่า GPT-6 Astra หรือไม่? ถูกกว่า Input และ output ถูกลง 20% ($8/$40 เทียบกับ $10/$50) และการอ่าน cache ถูกลง 60% ($0.40 เทียบกับ $1.00) โดย agent session แบบใช้ cache ของเราถูกลงถึง 31%
GPT-6.2 Sol มีราคาเท่าไร? $2 ต่อ input token 1 ล้านตัว, $0.10 สำหรับ cache และ $10 สำหรับ output ซึ่งเป็นราคาเดียวกับ GPT-6.1 Sol และ GPT-6 Sol หรือเพียงหนึ่งในสี่ของราคา Astra ในทุกบรรทัด
GPT-6.2 Astra คิดค่าใช้จ่ายเพิ่มสำหรับพรอมต์ยาวหรือไม่? คิด เมื่อ input เกิน 272K token อัตรา input และ cache จะเพิ่มขึ้นเป็นสองเท่า และ output เพิ่มเป็น 1.5 เท่าสำหรับคำขอทั้งหมด: $16 input, $0.80 cache และ $60 output ต่อ 1M token
ขอส่วนลดสำหรับ GPT-6.2 Astra ได้หรือไม่? Batch มีราคาเพียง 50% ของ Standard คำขอแบบ Background บน Responses API ได้ส่วนลด 30% สำหรับหน้าต่าง 2 ชั่วโมง หรือ 40% สำหรับหน้าต่าง 8 ชั่วโมง (public beta) และการใช้ cache ลดต้นทุน prefix ที่ใช้ซ้ำเหลือเพียง 0.05 เท่าของอัตรา input
Reasoning token นับรวมในบิลของ GPT-6.2 Astra หรือไม่? นับ Reasoning token ถูกคิดในอัตรา output ที่ $40 ต่อ 1M token และโมเดลปฏิเสธ reasoning effort แบบ none ดังนั้นควรวางงบสำหรับ reasoning ในทุกการเรียกใช้งาน