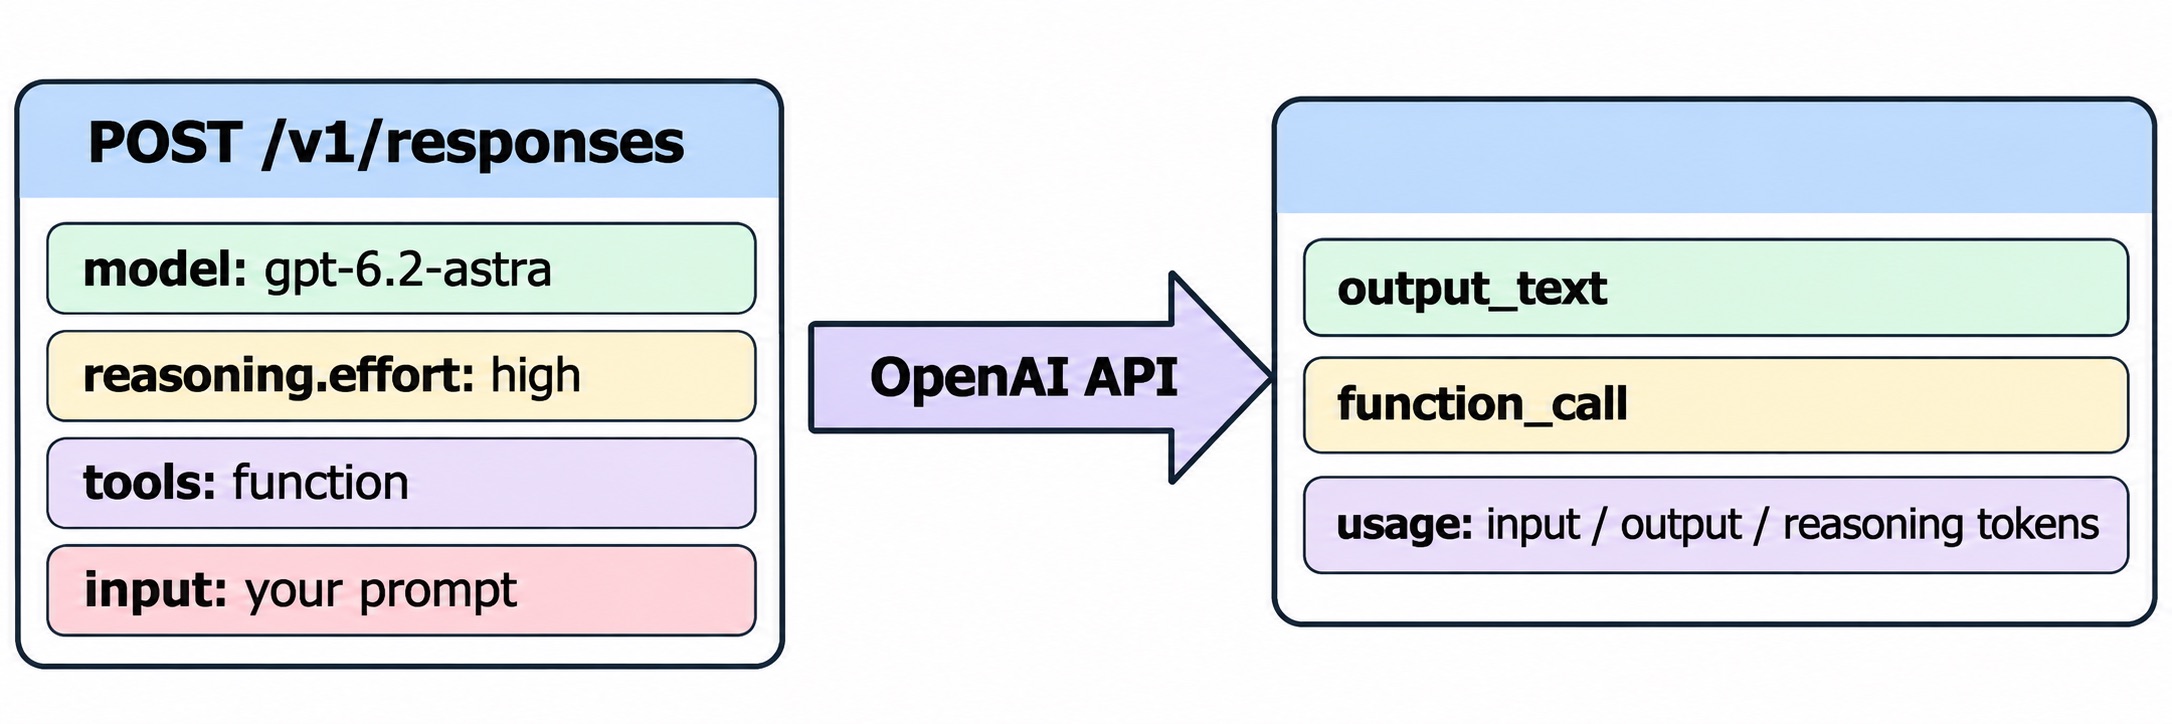
คำตอบโดยย่อ: หากต้องการใช้ GPT-6.2 Astra API ให้ส่ง request ไปยัง Responses endpoint ของ OpenAI (POST /v1/responses) โดยระบุ "model": "gpt-6.2-astra", ระดับ reasoning effort เช่น "high" และ input ของคุณ ราคาคือ $8 ต่อ input token ล้านตัว และ $40 ต่อ output token ล้านตัว รองรับ input ได้สูงสุด 922K tokens และส่งคืนได้สูงสุด 128K tokens อย่าตั้งค่า effort เป็น none เพราะ API จะปฏิเสธค่านี้
OpenAI เปิดตัว GPT-6.2 Astra และรุ่นราคาประหยัดกว่าอย่าง GPT-6.2 Sol เมื่อวันที่ 17 พฤศจิกายน 2026 หากคุณเคยเรียกใช้ GPT-6 Astra มาก่อน โค้ดส่วนใหญ่ของคุณสามารถใช้ต่อได้ทันที คู่มือนี้จะพาคุณไปทีละขั้นตอนตั้งแต่ request แรกกับ GPT-6.2 Astra API ไปจนถึงการเรียกใช้ tool, การปรับ effort, กับดักด้านราคา และการทดสอบแบบทำซ้ำได้ที่ coding agent ของคุณรันให้ได้
สิ่งที่ต้องเตรียมก่อนเรียก GPT-6.2 Astra API ครั้งแรก
คุณต้องมี 4 อย่าง และมี 3 อย่างในนั้นอยู่แล้วในตัว:
- OpenAI API key จาก platform dashboard โดย export เป็น
OPENAI_API_KEY - Usage tier แบบจ่ายเงิน หน้า model ของ OpenAI ระบุ rate limit ของ Astra เริ่มต้นที่ระดับ Build (5,000 requests และ 1M tokens ต่อนาที)
- Model ID คือ
gpt-6.2-astraส่วนรุ่นราคาประหยัดกว่าคือgpt-6.2-sol - Endpoint ที่รองรับ: Responses, Chat Completions หรือ Batch โดย Realtime, Assistants และ fine-tuning ไม่รองรับทั้งสองรุ่น
สเปกเหล่านี้มาจาก หน้า model GPT-6.2 Astra ของ OpenAI ซึ่งตรวจสอบเมื่อวันที่ 18 พฤศจิกายน 2026
| สเปก | GPT-6.2 Astra |
|---|---|
| Model ID | gpt-6.2-astra |
| Context window | 1,050,000 tokens |
| Input สูงสุด | 922,000 tokens |
| Output สูงสุด | 128,000 tokens |
| Knowledge cutoff | 18 พฤษภาคม 2026 |
| Endpoints | Responses, Chat Completions, Batch |
| ฟีเจอร์ | Streaming, function calling, structured outputs, image input, prompt caching |
วิธีส่ง request แรกไปยัง GPT-6.2 Astra API
Responses API คือ endpoint ที่ OpenAI พัฒนาฟีเจอร์ใหม่ให้ จึงควรเริ่มจากตรงนี้ ขั้นตอนมีดังนี้:
- Export key ของคุณ:
export OPENAI_API_KEY=sk-... - ส่ง request พร้อม model ID และระดับ effort
- อ่านคำตอบจาก
output_textและจำนวน token จากusage
ด้วย curl:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.2-astra",
    "reasoning": { "effort": "high" },
    "input": "Review this migration plan and list the three biggest risks."
  }'
ด้วย Python SDK ทางการ (pip install --upgrade openai):
from openai import OpenAI

client = OpenAI()  # reads OPENAI_API_KEY

response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    input="Review this migration plan and list the three biggest risks.",
)

print(response.output_text)
print(response.usage)
ด้วย Node.js (npm install openai):
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.2-astra",
  reasoning: { effort: "high" },
  input: "Review this migration plan and list the three biggest risks.",
});

console.log(response.output_text);
อย่าลืมตรวจสอบบล็อก usage ในทุกครั้งที่เรียกใช้ในช่วงเริ่มต้น Astra จะใช้ reasoning tokens ก่อนที่จะเขียนคำตอบแม้แต่คำเดียว และ token เหล่านี้ถูกคิดค่าใช้จ่ายในส่วนของ output คำตอบสั้น ๆ ก็อาจมีค่าใช้จ่ายสูงกว่าที่คุณคาดได้
การเลือก reasoning effort สำหรับ GPT-6.2 Astra
Reasoning effort เป็นตัวแปรที่ส่งผลต่อทั้งคุณภาพและต้นทุนมากที่สุด ใน reasoning guide ของ OpenAI ระบุค่าที่ใช้ได้คือ none, minimal, low, medium, high, xhigh และ max พร้อมระบุว่าแต่ละรุ่นรองรับเพียงบางค่าเท่านั้น สำหรับ GPT-6.2 Astra และ Sol กฎที่ยืนยันแล้วมีข้อเดียวคือ none ถูกปฏิเสธ จึงหมายความว่าทุกการเรียกใช้จะมีการ reasoning เสมอ
| ระดับ Effort | เหมาะกับงานแบบไหน |
|---|---|
low / medium |
การแก้ไขง่าย ๆ, การสกัดข้อมูล, คำตอบสั้น ๆ |
high |
Code review, การวางแผน, prompt ที่ยากส่วนใหญ่ เป็นค่าเริ่มต้นที่สมเหตุสมผลสำหรับการทดสอบ |
xhigh |
การรัน agent ยาว ๆ และงานแบบ async ใช้เมื่อ eval แสดงผลลัพธ์ที่ดีขึ้นชัดเจนเท่านั้น |
max |
ปัญหาที่ยากที่สุดของคุณ ที่คำตอบที่ดีขึ้นคุ้มค่ากับ token ที่ใช้หลายเท่า |
OpenAI ไม่ได้ระบุค่า effort เริ่มต้นของ Astra จึงควรกำหนดค่านี้อย่างชัดเจนในทุก request เพื่อให้ค่าใช้จ่ายและผลการทดสอบของคุณสามารถทำซ้ำได้
ระดับ effort เปลี่ยนค่าใช้จ่ายมากแค่ไหน? Simon Willison ได้รัน prompt รูปภาพเดียวกันผ่านทุกรุ่นที่ 3 ระดับ effort ในวันเปิดตัว และ เผยแพร่ต้นทุนออกมา Astra มีค่าใช้จ่าย 11.55 เซนต์ที่ high, 17.70 เซนต์ที่ xhigh และ 88.71 เซนต์ที่ max การเพิ่มจาก high เป็น max ทำให้ต้นทุนเพิ่มขึ้นเกือบแปดเท่า
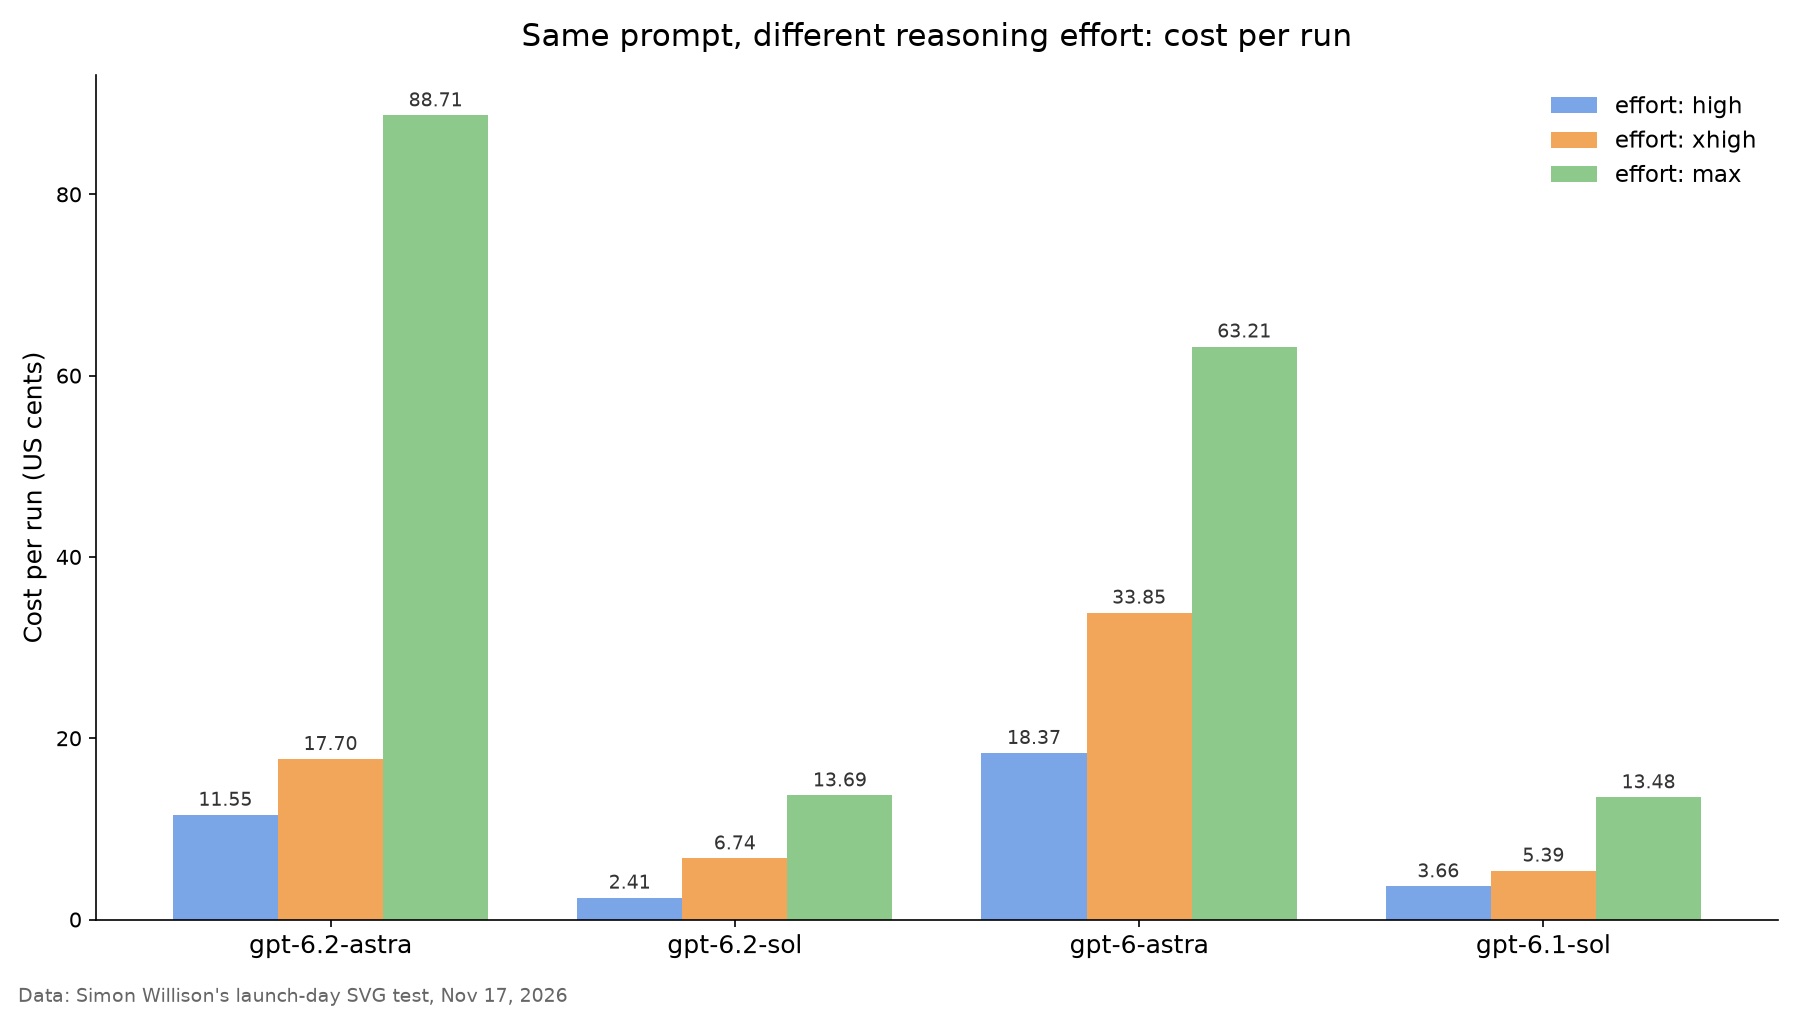
สังเกตว่า GPT-6.2 Astra ถูกกว่า GPT-6 Astra ที่ระดับ high และ xhigh แต่แพงกว่าที่ระดับ max ราคาต่อ token ลดลง 20% แต่ระดับ max ใช้เวลาคิดนานขึ้น ให้วัดต้นทุนต่องานที่เสร็จสมบูรณ์ ไม่ใช่ต้นทุนต่อ token ล้านตัว
การใช้ tools และ structured outputs กับ GPT-6.2 Astra API
Astra รองรับ function calling, structured outputs และ hosted tools จำนวนมากใน Responses API เช่น web search, file search, image generation, code interpreter, hosted shell, apply patch, skills, computer use, MCP และ tool search
Function tool มีรูปแบบเหมือนกับที่ใช้กับ GPT-6 Astra:
response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    tools=[{
        "type": "function",
        "name": "get_order_status",
        "description": "Look up an order by its ID.",
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"],
        },
    }],
    input="Where is order A-1042?",
)

for item in response.output:
    if item.type == "function_call":
        print(item.name, item.arguments)
ให้คุณรันฟังก์ชันดังกล่าวเอง แล้วส่งผลลัพธ์กลับไปเป็น item แบบ function_call_output พร้อม call_id ที่ตรงกัน จากนั้น Astra จะเขียนคำตอบสุดท้ายจากผลลัพธ์นั้น
สำหรับ output ที่เครื่องอ่านได้ ให้ส่ง JSON schema ผ่าน text.format โดยระบุ "type": "json_schema" และ "strict": true โมเดลจะคืนค่า JSON ที่ตรงตาม schema ของคุณ ทำให้ parse ได้โดยไม่ต้องเดา
มีสองนิสัยที่ช่วยได้เมื่อทำงานกับโมเดลที่เก่งระดับนี้ ประการแรก ให้เขียนคำอธิบายของแต่ละ tool ให้กระชับและกำหนด schema ที่เข้มงวด เพราะผู้รีวิวในวันเปิดตัวรายงานว่า Astra อาจเหลื่อมล้ำในงานที่เปิดกว้างและยาว ๆ ประการที่สอง ให้ตั้งค่า max_output_tokens ใน agent loop เพื่อไม่ให้ขั้นตอนที่รันหนีควบคุมกินงบประมาณของคุณ สำหรับพื้นหลังเกี่ยวกับ endpoint นี้ ดูได้ที่ คู่มือ OpenAI Responses API ของเรา
ราคาและ rate limits ของ GPT-6.2 Astra API
Astra คิดราคาต่อ token ล้านตัว โดยมีค่าเพิ่มสำหรับ prompt ที่ยาวมาก อัตราเหล่านี้มาจากหน้า model:
| รายการ | GPT-6.2 Astra | GPT-6 Astra (เพื่อเปรียบเทียบ) |
|---|---|---|
| Input | $8.00 | $10.00 |
| Cached input | $0.40 | $1.00 |
| Cache writes (เก็บไว้ 30 นาที) | $10.00 | n/a |
| Output | $40.00 | $50.00 |
กับดักอยู่ที่กฎ long-context เมื่อ request มี input token เกิน 272K อัตราค่า input และ cache จะเพิ่มเป็นสองเท่า และ output จะคิด 1.5 เท่าสำหรับทั้ง request prompt ขนาด 300K tokens จะถูกคิดค่า input ที่ $16 และ output ที่ $60 ไม่ใช่คิดเฉพาะ token ส่วนที่เกินเส้นนั้น หากคุณป้อน repository ทั้งหมดให้ Astra ควรแบ่งเป็น chunk หรือใช้ cache โดยอยู่ต่ำกว่า 272K เมื่อทำได้
Batch job เหมาะกับงาน eval และ backfill ที่รอได้ VentureBeat รายงานว่า Batch รันในราคาครึ่งหนึ่ง
Rate limits มาตรฐานแยกตาม tier:
| Tier | Requests/นาที | Tokens/นาที |
|---|---|---|
| Build | 5,000 | 1,000,000 |
| Launch | 10,000 | 4,000,000 |
| Grow | 15,000 | 40,000,000 |
จัดการ response 429 ด้วย exponential backoff การรัน agent ที่ยาวในระดับ xhigh สามารถเผางบ token ระดับ Build ได้เร็วมาก
การย้ายจาก GPT-6 Astra มาใช้ GPT-6.2 Astra
โค้ดส่วนใหญ่ต้องแก้เพียงจุดเดียวคือ model string ก่อนเปลี่ยนใช้จริงใน production ให้ตรวจสอบสิ่งเหล่านี้:
- Model ID: เปลี่ยนจาก
gpt-6-astraเป็นgpt-6.2-astra - Effort
none: หากมี code path ใดส่งค่านี้ จะล้มเหลวทันที ให้เปลี่ยนไปใช้ค่าต่ำสุดที่ eval ของคุณยอมรับได้ - Prompt caching: cached input ลดจาก $1.00 เหลือ $0.40 system prompt และรายการ tool ที่คงที่จึงคุ้มค่าที่จะ cache แล้ว
- Prompt ยาว: ตรวจสอบ request ใด ๆ ที่ใกล้ 272K tokens กับกฎ long-context ข้างต้นอีกครั้ง
- Safety: OpenAI ระบุว่าโมเดล GPT-6.2 ทั้งสองตัวเข้าถึงเกณฑ์ "Critical" ด้าน cybersecurity และมาพร้อมมาตรการป้องกันที่เข้มงวดขึ้น prompt สำหรับ security tooling อาจได้รับการปฏิเสธที่ไม่เคยเกิดขึ้นมาก่อน
รีวิวช่วงแรกยังผสมกันไป จึงควรทดสอบก่อนเปลี่ยนใช้ Ethan Mollick บอกว่า Astra "ไม่สม่ำเสมอและแปลก ๆ มาก" ส่วน Dan Shipper ระบุว่ามักหยุดก่อนเวลาอันควรในงานสร้าง end-to-end ตามบทสรุปของ VentureBeat ขณะที่บางคนชื่นชมความสามารถด้าน code review และ computer use ของมัน prompt ของคุณเองเท่านั้นที่เป็น benchmark ที่สำคัญ คู่มือ GPT-6 Astra API ครอบคลุมสิ่งที่ใช้ต่อได้จากรุ่นก่อน และหาก traffic ส่วนใหญ่ของคุณเป็นงานประจำ คู่มือ GPT-6.1 Sol API แสดงรูปแบบ request ของ tier ราคาประหยัดกว่า
ให้ coding agent ของคุณทดสอบ GPT-6.2 Astra ด้วย Apidog CLI
การคัดลอก prompt ไปวางใน terminal บอกได้แค่ว่า Astra ทำงานเป็นอย่างไรในวันนี้ แต่จะไม่บอกคุณว่าเมื่อมีการอัปเดตในเดือนหน้าแล้ว schema ของคุณพังหรือไม่ ให้ coding agent ของคุณสร้างการตรวจสอบนี้และรันด้วย Apidog CLI แทน โดยคุณเขียน prompt เพียงอันเดียว
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้ Claude Code, Codex หรือ Cursor prompt เดียว:
In Apidog project <projectId>, create a test case for POST https://api.openai.com/v1/responses
with model "gpt-6.2-astra", reasoning effort "high" and a get_order_status function tool.
Assert status 200, that the output contains a function_call named get_order_status,
that its arguments parse as JSON with an order_id, and that usage.output_tokens is under 4000.
Read the API key from the OPENAI_API_KEY variable in environment <envId>, then run it.
Agent จะอ่าน payload schema ตรวจสอบไฟล์ของมัน สร้าง test case และรันมัน:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
เก็บ key ไว้ใน Apidog environment ไม่ใช่ใน prompt เพื่อไม่ให้ key ไปอยู่ใน context ของ agent เลย เพิ่ม --upload-report เพื่อดูผลการรันในแอป Apidog หรือใช้ -n 5 เพื่อรันซ้ำและดูว่า tool calls ของ Astra คงเส้นคงวาแค่ไหน ใส่ -r junit ลงใน pipeline แล้วการตรวจสอบนี้จะรันใหม่ทุกครั้งที่ deploy คู่มือ Apidog CLI ใน CI/CD แสดงการตั้งค่า และ Apidog CLI ใน Claude Code ครอบคลุมฝั่ง agent แผน Free ของ Apidog รองรับทีมได้ถึง 4 ผู้ใช้
FAQ
Model ID ของ GPT-6.2 Astra API คืออะไร? gpt-6.2-astra ส่วนรุ่นราคาประหยัดกว่าคือ gpt-6.2-sol ทั้งสองใช้ได้กับ endpoint Responses, Chat Completions และ Batch
GPT-6.2 Astra API ราคาเท่าไร? $8 ต่อ input token ล้านตัว, $0.40 ต่อ cached input token ล้านตัว และ $40 ต่อ output token ล้านตัว Request ที่มี input token เกิน 272K จะถูกคิดค่า input สองเท่าและ output 1.5 เท่าสำหรับทั้ง request
ทำไม request GPT-6.2 Astra ของฉันถึงล้มเหลวเมื่อตั้ง reasoning effort เป็น none? โมเดล GPT-6.2 ทั้งสองตัวปฏิเสธ "effort": "none" ให้ตั้งเป็น high หรือระดับต่ำสุดที่การทดสอบแสดงว่าใช้ได้กับงานของคุณ
Context window ของ GPT-6.2 Astra คือเท่าไร? รวมทั้งหมด 1,050,000 tokens โดยรองรับ input ได้สูงสุด 922,000 tokens และ output สูงสุด 128,000 tokens
ใช้ GPT-6.2 Astra กับ Chat Completions API ได้ไหม? ได้ รองรับอย่างเป็นทางการ แต่ hosted tools เช่น web search, computer use และ apply patch ถูกระบุว่าใช้ได้กับ Responses API จึงควรใช้ Responses สำหรับงานแบบ agent
GPT-6.2 Astra ใช้ฟรีได้ไหม? ไม่ได้ใน API เพราะทุกการเรียกใช้ถูกคิดค่าใช้จ่าย แต่ใน ChatGPT Work และ Codex จะรวมอยู่ในแผน Plus, Pro, Enterprise และ Edu ตาม ประกาศเปิดตัว ของ OpenAI