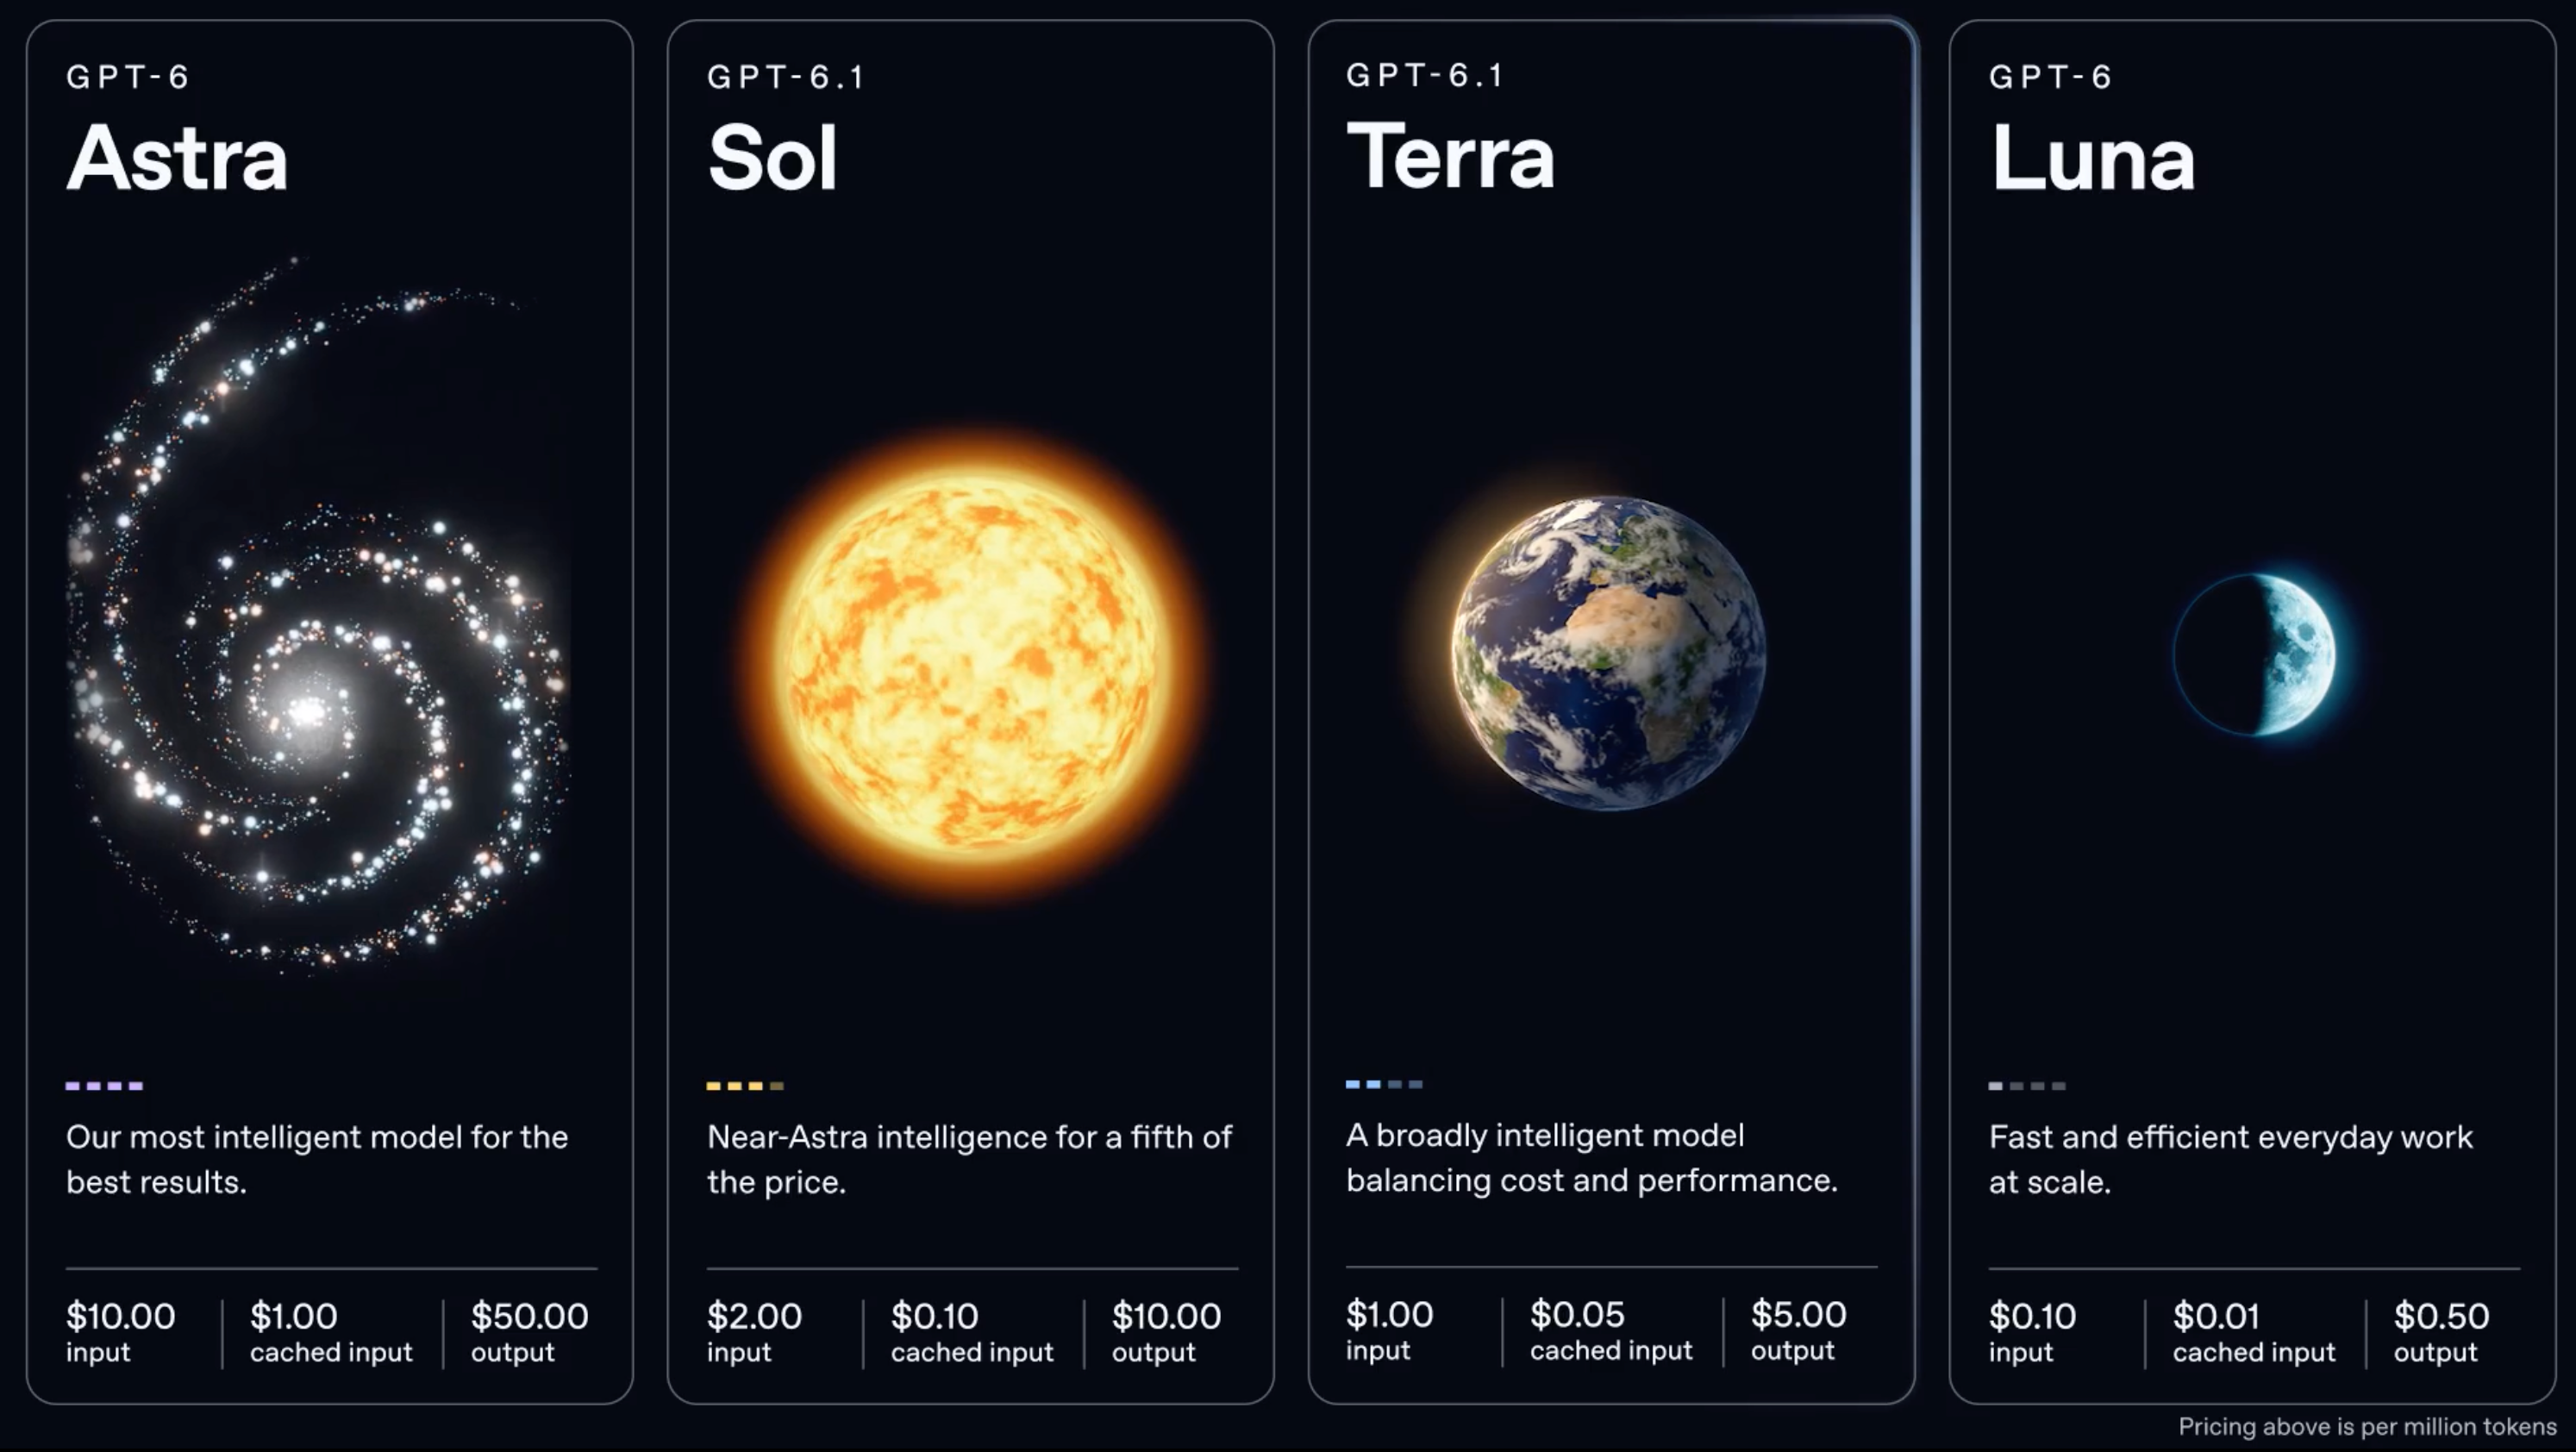
GPT-6.1 Terra พร้อมใช้งานบน OpenAI API ในชื่อ gpt-6.1-terra ตั้งแต่วันที่ 26 ตุลาคม 2026 โดยทำงานบน Responses API, Chat Completions และ Batch มีค่าใช้จ่าย $1 ต่อล้านโทเค็นอินพุต และ $5 ต่อล้านโทเค็นเอาต์พุต และรองรับอินพุตสูงสุด 922,000 โทเค็นและเอาต์พุต 128,000 โทเค็น หากคุณเรียก GPT-5.6 Terra อยู่แล้ว การเปลี่ยนส่วนใหญ่เป็นเพียงการแก้โมเดลหนึ่งบรรทัด โดยมีค่าตั้งบางอย่างที่ควรตรวจสอบก่อน
คู่มือนี้ครอบคลุมการขอคีย์ คำขอแรกของคุณใน curl, Python และ Node ระดับ reasoning effort ทั้งหก ระดับ computer use และเครื่องมืออื่น ๆ การควบคุมค่าใช้จ่าย และสิ่งที่ควรทดสอบเมื่อคุณย้ายจาก gpt-5.6-terra สำหรับภาพรวมของโมเดล ดู GPT-6.1 Terra คืออะไร
API รองรับอะไรบ้าง
| คุณสมบัติ | GPT-6.1 Terra |
|---|---|
| ID โมเดล | gpt-6.1-terra (หนึ่งสแนปช็อต) |
| เอนด์พอยต์ | Responses, Chat Completions, Batch |
| ไม่รองรับ | Realtime, Live, Assistants, fine-tuning, predicted outputs |
| อินพุต | ข้อความและรูปภาพ |
| เอาต์พุต | ข้อความ |
| หน้าต่างบริบท | 1,050,000 โทเค็น (อินพุต 922,000, เอาต์พุต 128,000) |
| ระดับ reasoning effort | none, low, medium (ค่าเริ่มต้น), high, xhigh, max |
| ฟีเจอร์ | สตรีมมิง, เอาต์พุตแบบมีโครงสร้าง, การเรียกฟังก์ชัน, การแคชพรอมป์ต์ |
| เครื่องมือ (เฉพาะ Responses) | web_search, file_search, computer_use, code_interpreter, hosted_shell, apply_patch, skills, mcp, tool_search, image_generation |
ที่มา: หน้าโมเดล GPT-6.1 Terra ของ OpenAI เครื่องมือแบบโฮสต์ต้องใช้ Responses API ดังนั้นใช้มันสำหรับงานใหม่
ขั้นตอนที่ 1: ขอ API key
สร้างคีย์ในแดชบอร์ดแพลตฟอร์ม OpenAI และเพิ่มการเรียกเก็บเงิน ไม่มีแพ็กเกจฟรีสำหรับ Terra: แผน ChatGPT Plus หรือ Pro ให้คุณใช้ Terra ภายใน ChatGPT Work และ Codex แต่ไม่ได้ให้ API key คู่มือของเราเกี่ยวกับ GPT-6.1 Terra ฟรีหรือไม่ อธิบายความแตกต่าง
ส่งออกเป็นตัวแปรสภาพแวดล้อมเพื่อให้ตัวอย่างด้านล่างอ่านได้:
export OPENAI_API_KEY="sk-..."
ขีดจำกัดอัตราขึ้นอยู่กับระดับการใช้งานของคุณ หน้าโมเดลระบุ 5,000 คำขอและ 1 ล้านโทเค็นต่อนาทีในระดับ Build, 10,000 และ 4 ล้านใน Launch และ 15,000 และ 40 ล้านใน Grow
ขั้นตอนที่ 2: ส่งคำขอแรก
ด้วย curl ไปยัง Responses API:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "reasoning": { "effort": "low" },
    "input": "Summarize the difference between PUT and PATCH in two sentences."
  }'
ใน Python ด้วย SDK อย่างเป็นทางการ:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "low"},
    input="Summarize the difference between PUT and PATCH in two sentences.",
)

print(response.output_text)
print(response.usage)
ใน Node:
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.1-terra",
  reasoning: { effort: "low" },
  input: "Summarize the difference between PUT and PATCH in two sentences.",
});

console.log(response.output_text);
console.log(response.usage);
พิมพ์ usage ตั้งแต่แรก มันบอกจำนวนโทเค็นอินพุต, แคช และเอาต์พุต และโทเค็น reasoning จะถูกคิดค่าใช้จ่ายเป็นเอาต์พุต
ขั้นตอนที่ 3: เลือกระดับ reasoning effort
Terra รองรับหกระดับ effort ค่าเริ่มต้นคือ medium
| ระดับ effort | ใช้สำหรับ |
|---|---|
none |
การจำแนกประเภท, การสกัดข้อมูล, การจัดรูปแบบ; เอาต์พุตที่กำหนดได้แน่นอน |
low |
คำตอบสั้น ๆ, การเรียกเครื่องมือง่าย ๆ, งานแนวแชตส่วนใหญ่ |
medium |
ค่าเริ่มต้น; งานเขียนโค้ดทั่วไปและขั้นตอนของเอเจนต์ |
high / xhigh |
การให้เหตุผลหลายขั้นตอนที่ยากขึ้น |
max |
การตั้งค่าสำหรับ benchmark; งานที่ยากที่สุด ช้าและแพงที่สุด |
มีสองจุดที่เด่นชัด
none ได้รับการรองรับ GPT-6.1 Sol ได้นำมันออก ดังนั้นนี่จึงเป็นหนึ่งในความแตกต่างในทางปฏิบัติระหว่างทั้งสอง นักพัฒนาในฟอรัมชุมชนของ OpenAI รายงานว่าด้วย reasoning.effort: "none" Terra ยอมรับ temperature และ top_p อีกครั้ง สำหรับไปป์ไลน์ที่ติดป้ายกำกับหรือสกัดข้อมูลปริมาณมาก none ให้ต้นทุนต่อการเรียกต่ำที่สุดและเอาต์พุตที่ทำซ้ำได้
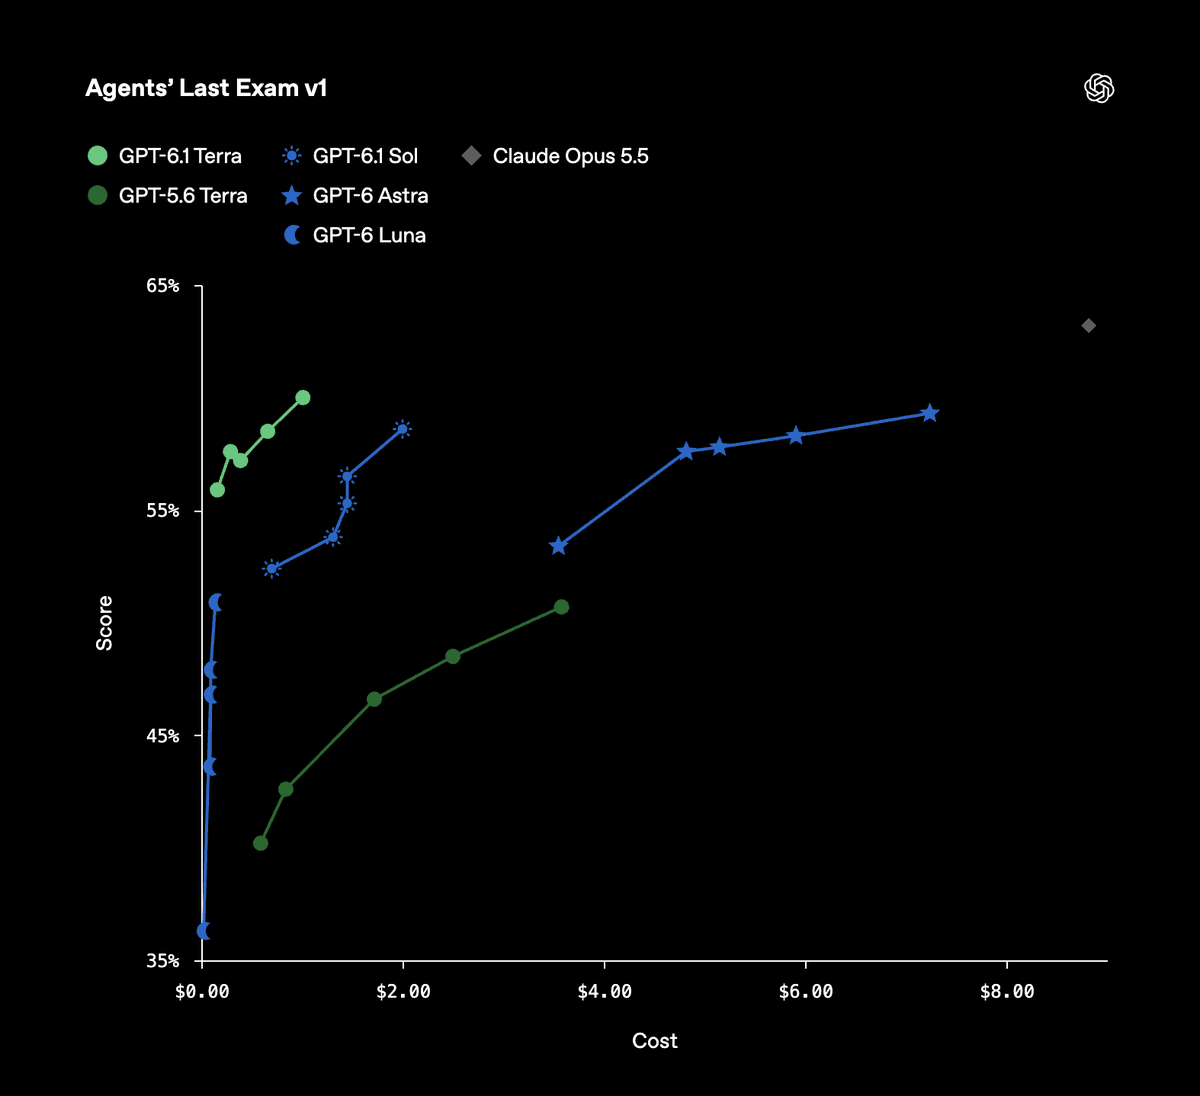
effort ต่ำพัฒนามากที่สุด ในการทดสอบความถูกต้องตามข้อเท็จจริงภายในของ OpenAI อัตราข้อผิดพลาดของ Terra ที่ effort ต่ำลดลงจาก 53.6% บน GPT-5.6 Terra เป็น 16.7% Artificial Analysis ยังวัดการปรับปรุงที่มากกว่าจาก GPT-5.6 Terra ในระดับ effort ที่ต่ำกว่า (7 ถึง 13 คะแนน) เมื่อเทียบกับ max (6 คะแนน) หากคุณรัน GPT-5.6 Terra ที่ high เพื่อให้ได้คุณภาพที่ยอมรับได้ ลอง low หรือ medium บน 6.1 Terra ก่อนจะถือว่าคุณต้องใช้การตั้งค่าเดิม
ขั้นตอนที่ 4: ใช้เครื่องมือ รวมถึง computer use
OpenAI นำเสนอรีลีสนี้โดยเน้น “computer use ที่รวดเร็วและความสามารถสูงในราคาที่ถูกลง” computer use, web search, file search และเครื่องมือแบบโฮสต์อื่น ๆ ใช้ได้บน Responses API การเรียก web search มีลักษณะดังนี้:
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "low"},
    tools=[{"type": "web_search"}],
    input="What changed in the latest OpenAPI Specification release?",
)
print(response.output_text)
การเรียกฟังก์ชันและเอาต์พุตแบบมีโครงสร้างทำงานเหมือนกับในโมเดล GPT-6 อื่น ๆ: กำหนด schema ฟังก์ชันของคุณใน tools หรือส่ง JSON schema ในการตั้งค่ารูปแบบข้อความ และตรวจสอบความถูกต้องของสิ่งที่ส่งกลับมา สำหรับมุมมองที่ลึกขึ้นเกี่ยวกับ computer use กับแอปจริง คู่มือ computer use ของ GPT-6 Astra ของเราก็ใช้ได้กับ Terra เช่นกัน ในราคาต่อโทเค็นหนึ่งในสิบของ Astra
ขั้นตอนที่ 5: ควบคุมค่าใช้จ่าย
อัตราของ Terra ต่ำอยู่แล้ว และการตั้งค่าสี่อย่างช่วยลดลงได้อีก:
- Prompt caching ทำงานอัตโนมัติ อินพุตที่แคชมีค่าใช้จ่าย $0.05 ต่อล้าน เทียบกับ $1 สำหรับอินพุตใหม่ เก็บเนื้อหาที่คงที่ (system prompt, schema ของเครื่องมือ, เอกสารอ้างอิง) ไว้ที่ด้านหน้าของพรอมป์ต์ การเขียนแคชมีค่าใช้จ่าย $1.25 ต่อล้านสำหรับการเก็บ 30 นาที หรือ $2.50 สำหรับ 12 ชั่วโมง ดูคู่มือ prompt caching ของ GPT-6 ของเรา
- Batch ลดอัตราทุกอย่างลงครึ่งหนึ่งสำหรับงานอะซิงโครนัส: อินพุต $0.50, เอาต์พุต $2.50 คู่มือ OpenAI Batch API ของเราแสดงขั้นตอนทั้งหมด
- Flex ให้อัตราครึ่งหนึ่งเช่นกันกับคำขอปกติด้วย
service_tier: "flex"แลกกับการตอบสนองที่ช้าลงและเจอ 429 เป็นครั้งคราว - เส้นแบ่ง 272K พรอมป์ต์ที่เกิน 272K โทเค็นอินพุตจะคิดค่าใช้จ่ายทั้งคำขอที่อัตราอินพุตและแคช 2 เท่า และเอาต์พุต 1.5 เท่า หากคุณใกล้ถึงขีดนั้น ให้ตัดบริบทที่ดึงมาแทนที่จะข้ามมัน
โหมด Fast ไปในทางตรงกันข้าม: 2 เท่าของอัตรา Standard ($2 อินพุต, $10 เอาต์พุต) เพื่อการตอบสนองที่เร็วขึ้น คู่มือราคา GPT-6.1 Terra มีอัตราทุกอย่างในตารางเดียว
การย้ายจาก gpt-5.6-terra
การเปลี่ยน ID โมเดลเป็นเพียงหนึ่งบรรทัด นี่คือสิ่งต่าง ๆ ที่ควรตรวจสอบรอบ ๆ การเปลี่ยนแปลงนั้น:
- ราคา อินพุตลดจาก $2 เป็น $1 อินพุตที่แคชจาก $0.20 เป็น $0.05 เอาต์พุตจาก $12 เป็น $5 อัปเดตแดชบอร์ดค่าใช้จ่ายหรือการแจ้งเตือนงบประมาณใด ๆ ที่กำหนดอัตราแบบตายตัว
- การตั้งค่า effort ทดสอบซ้ำที่ effort ต่ำลง คุณภาพที่
lowเปลี่ยนมากที่สุด - วันตัดข้อมูลความรู้ ของ Terra คือ 1 มิถุนายน 2026 พรอมป์ต์ที่สมมติวันตัดข้อมูลเก่ากว่า หรือการทดสอบที่มีคำตอบที่คาดหวังไวต่อวันที่ อาจเปลี่ยนไป
- ความยาวและรูปแบบเอาต์พุต โมเดลใหม่อาจเขียนคำตอบยาวขึ้นหรือสั้นลง ตรวจสอบ
usage.output_tokensและตัวแยกวิเคราะห์ใด ๆ ที่คาดหวังรูปแบบคงที่ ใช้ structured outputs ในจุดที่รูปร่างสำคัญ - ความเร็ว OpenAI กล่าวว่า Terra ทำงานเสร็จเร็วกว่าโดยเฉลี่ยกว่า 3 เท่าเมื่อเทียบกับ Astra และ GPT-6.1 Sol การตั้งค่า timeout สำหรับโมเดลที่ช้ากว่ายังใช้ได้ แต่ตรรกะการลองใหม่และการ polling ที่สร้างขึ้นสำหรับการรอนานอาจสิ้นเปลืองตอนนี้
- Codex หากทีมของคุณใช้ Codex, Terra ต้องใช้ Codex CLI 0.159.0 หรือใหม่กว่า:
codex -m gpt-6.1-terra
OpenAI ยังไม่ได้ประกาศวันเลิกใช้ GPT-5.6 Terra ดังนั้นคุณสามารถรันทั้งสองเคียงข้างกันขณะเปรียบเทียบ
ให้ coding agent ของคุณพิสูจน์การย้ายด้วย Apidog CLI
ขั้นตอนที่ 1 ถึง 6 เป็นการตรวจสอบแบบที่คุณไม่ควรทำด้วยมือ ชี้ coding agent ของคุณไปที่ Apidog CLI แล้วมันสามารถสร้างการทดสอบ รันบนทั้งสองโมเดล และบอกคุณว่าอะไรเปลี่ยนไป
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
จากนั้นให้พรอมป์ต์หนึ่งอย่างกับ Claude Code, Codex หรือ Cursor:
In Apidog project <id>, add POST https://api.openai.com/v1/responses as an endpoint.
Create a test case that sends my production prompt with model {{MODEL}} and reasoning
effort low, and asserts: status 200, output_text not empty, output matches our JSON
schema, usage.output_tokens under 3000. Run it with MODEL=gpt-5.6-terra and again with
MODEL=gpt-6.1-terra against the <env> environment, then compare tokens and failures.
เอเจนต์อ่าน schema แต่ละอัน ตรวจสอบความถูกต้องของ payload และรันเคสสองครั้ง:
apidog cli-schema get endpoint-create
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gpt-5.6-terra" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gpt-6.1-terra" -r cli,json
เก็บคีย์ OpenAI ของคุณไว้ใน environment ของ Apidog เมื่อการรัน Terra ผ่าน ให้เพิ่มไปยัง CI ด้วย -r junit เพื่อที่การเปลี่ยนแปลงพรอมป์ต์หรือโมเดลในภายหลังจะไม่ทำให้สัญญาเสียหายแบบเงียบ ๆ คู่มือ Apidog CLI CI/CD ของเรามีไฟล์ pipeline และ Apidog CLI ใน Codex ครอบคลุมการตั้งค่า Codex
คำถามที่พบบ่อย
ID โมเดลของ GPT-6.1 Terra คืออะไร? gpt-6.1-terra มีสแนปช็อตหนึ่งรายการ และยังเป็นค่าเริ่มต้นด้วย
GPT-6.1 Terra ใช้กับ Chat Completions ได้หรือไม่? ได้ รองรับ Responses, Chat Completions และ Batch เครื่องมือแบบโฮสต์ เช่น web search และ computer use ต้องใช้ Responses API
ฉันตั้งค่า temperature บน GPT-6.1 Terra ได้หรือไม่? รายงานจากชุมชนกล่าวว่าได้ด้วย reasoning.effort: "none" ในระดับ effort อื่น ๆ ให้ตรวจสอบหน้าโมเดลก่อนส่งการตั้งค่า sampling
GPT-6.1 Terra รองรับ Realtime API หรือไม่? ไม่ รองรับ Realtime, Live, Assistants และ fine-tuning ไม่ได้
ขีดจำกัดอัตราของ GPT-6.1 Terra คือเท่าไร? ขึ้นอยู่กับระดับของคุณ: ตั้งแต่ 5,000 คำขอและ 1 ล้านโทเค็นต่อนาทีใน Build ไปจนถึง 15,000 และ 40 ล้านใน Grow
ขั้นตอนถัดไป
สลับ ID โมเดลบนเอนด์พอยต์หนึ่งจุด ทดสอบซ้ำที่ effort ต่ำลง และให้เอเจนต์ของคุณเปรียบเทียบการรันทั้งสองด้วย Apidog CLI หากตัวเลขคงที่ ให้นำไปใช้งาน ไม่แน่ใจว่า Terra หรือ Sol เหมาะกับเวิร์กโหลดของคุณ? อ่าน GPT-6.1 Terra vs GPT-6.1 Sol