
ในช่วงเวลาห่างกันไม่กี่สัปดาห์ในฤดูร้อนปี 2026 ทั้ง OpenAI และ Google ได้เปิดตัวโมเดลที่เชี่ยวชาญด้านความปลอดภัย ซึ่งนักพัฒนาส่วนใหญ่ไม่สามารถเข้าถึงได้ GPT-5.6-Cyber ของ OpenAI เปิดตัวเมื่อวันที่ 10 สิงหาคม Gemini 3.5 Flash Cyber ของ Google เปิดตัวเมื่อวันที่ 21 กรกฎาคม ทั้งสองโมเดลสามารถค้นหาช่องโหว่ของซอฟต์แวร์ได้ ทั้งสองต้องได้รับการอนุมัติในการเข้าถึง และทั้งสองปฏิเสธที่จะให้คีย์ API ปกติแก่คุณ
อย่างไรก็ตาม ทั้งสองไม่ใช่เครื่องมือประเภทเดียวกัน โมเดลหนึ่งมุ่งเน้นการป้องกัน อีกโมเดลหนึ่งมุ่งเน้นการโจมตี และทั้งสองอยู่บนระดับชั้นของโมเดลที่แตกต่างกันมาก หากคุณพยายามทำความเข้าใจทั้งสอง นี่คือวิธีเปรียบเทียบที่แท้จริง และเหตุผลที่การเปรียบเทียบประสิทธิภาพโดยตรงระหว่างทั้งสองไม่สามารถทำได้
ปุ่ม
เปรียบเทียบ
| GPT-5.6-Cyber | Gemini 3.5 Flash Cyber | |
|---|---|---|
| ผู้ขาย | OpenAI | |
| เปิดตัว | 10 สิงหาคม 2026 | 21 กรกฎาคม 2026 |
| สร้างขึ้นบน | GPT-5.6 Sol (ระดับเรือธง) | Gemini Flash (ระดับที่รวดเร็วและราคาถูก) |
| มุ่งเน้น | เชิงรุก: การสร้างห่วงโซ่การโจมตี, การค้นหาช่องโหว่ Zero-day | เชิงรับ: การค้นหาและแก้ไขช่องโหว่ |
| การเข้าถึง | Daybreak Red (ทีมรักษาความปลอดภัยที่ผ่านการตรวจสอบ) | โครงการนำร่องแบบจำกัด (รัฐบาล, พันธมิตรที่เชื่อถือได้) |
| API สาธารณะ | ไม่มี | ไม่มี |
| ราคาต่อสาธารณะ | ไม่มี | ไม่มี |
| โปรแกรม | OpenAI Daybreak | Google CodeMender |
สรุปโดยย่อ: GPT-5.6-Cyber เป็นโมเดลเชิงรุกระดับแนวหน้าสำหรับการวิจัย และ Gemini 3.5 Flash Cyber เป็นโมเดลเชิงรับระดับที่เบากว่าสำหรับการแก้ไขช่องโหว่ ความแตกต่างในแนวทางนี้อธิบายเกือบทุกอย่าง
ระดับชั้นของโมเดลที่แตกต่างกัน
ความแตกต่างทางเทคนิคที่ชัดเจนที่สุดคือโมเดลพื้นฐาน GPT-5.6-Cyber สร้างขึ้นบน GPT-5.6 Sol ซึ่งเป็นโมเดลการให้เหตุผลที่ทรงประสิทธิภาพที่สุดของ OpenAI การวิจัยช่องโหว่ในโลกแห่งความเป็นจริงต้องการการให้เหตุผลอย่างต่อเนื่องในฐานโค้ดขนาดใหญ่ที่ไม่คุ้นเคย และ OpenAI ได้นำโมเดลระดับสูงสุดมาใช้กับ Cyber เพื่อให้ได้ผลลัพธ์นั้น
Gemini 3.5 Flash Cyber สร้างขึ้นบน Flash tier ซึ่งเป็นโมเดลที่รวดเร็วและราคาไม่แพงของ Google ไม่ใช่โมเดลเรือธง Pro ของมัน นี่คือความเหมาะสมโดยเจตนาสำหรับงานของมัน CodeMender ซึ่งเป็นโปรแกรมของ Google ที่อยู่เบื้องหลัง มีวัตถุประสงค์เพื่อสแกนโค้ดเพื่อค้นหาและแก้ไขข้อบกพร่องในวงกว้าง ซึ่งให้ความสำคัญกับความเร็วและประสิทธิภาพด้านต้นทุนมากกว่าความลึกในการให้เหตุผลสูงสุดในการลองครั้งเดียว ข้อสังเกตเกี่ยวกับความผิดปกติของเวอร์ชันด้วย: โมเดล Flash ทั่วไปย้ายไปที่ 3.6 แต่ Cyber ยังคงอยู่ที่ 3.5 เนื่องจากทั้งสองอยู่ในเส้นทางการเผยแพร่ที่แตกต่างกัน
แนวทางที่แตกต่างกัน: การโจมตีเทียบกับการป้องกัน
นี่คือความแตกต่างที่แท้จริง อ่านกรอบการนำเสนอของแต่ละผู้ขาย แล้วจะเห็นความแตกต่างอย่างชัดเจน
OpenAI ฝึกอบรม GPT-5.6-Cyber เพื่อ ลดการปฏิเสธ ในงานที่มีความเสี่ยงสูงซึ่งมีวัตถุประสงค์สองทาง และเพื่อพัฒนาให้ดีขึ้นในการ ค้นหาช่องโหว่ Zero-day และสร้างห่วงโซ่การโจมตี ตาม ประกาศการขยาย Daybreak ของพวกเขา มันถูกส่งมอบผ่าน Daybreak Red ซึ่งเป็นระดับที่กำหนดไว้อย่างชัดเจนสำหรับ “การวิจัยช่องโหว่ที่ได้รับอนุญาต การตรวจสอบการโจมตี และการทดสอบความปลอดภัย” หลักฐานการเปิดตัวเป็นเชิงรุก: ช่องโหว่ V8 ที่เชื่อมโยงกันสองจุดใน Chrome ซึ่งได้รับมอบหมาย CVE-2026-15903 รวมถึงผลการค้นพบที่รายงานในระบบปฏิบัติการมือถือ ฐานข้อมูล และเคอร์เนลของระบบปฏิบัติการ
Google วางกรอบ Gemini 3.5 Flash Cyber โดยเน้นที่ การค้นหาและแก้ไข ตามที่ประกาศในการ อัปเดตโมเดล Gemini มันเป็นส่วนหนึ่งของ CodeMender ซึ่งเป็นความพยายามที่มุ่งเป้าไปที่การตรวจจับข้อบกพร่องด้านความปลอดภัยในโค้ดและเสนอแพตช์สำหรับข้อบกพร่องเหล่านั้น การเน้นคือการแก้ไข ปิดช่องโหว่ ไม่ใช่การใช้เป็นอาวุธ
นั่นไม่ได้ทำให้โมเดลหนึ่ง “ปลอดภัย” และอีกโมเดลหนึ่ง “อันตราย” เครื่องมือค้นหาช่องโหว่ที่มีประสิทธิภาพเป็นเครื่องมือที่มีวัตถุประสงค์สองทางไม่ว่าจะถูกนำเสนออย่างไร ซึ่งเป็นเหตุผลว่าทำไมทั้งสองจึงถูกจำกัดการเข้าถึง แต่ถ้าคุณกำลังทำแผนที่ของพื้นที่นี้ OpenAI ผลักดันไปสู่การวิจัยเชิงรุกมากขึ้น ในขณะที่ Google ยังคงใกล้ชิดกับการแก้ไขช่องโหว่เชิงป้องกัน
ความโปร่งใสที่แตกต่างกัน
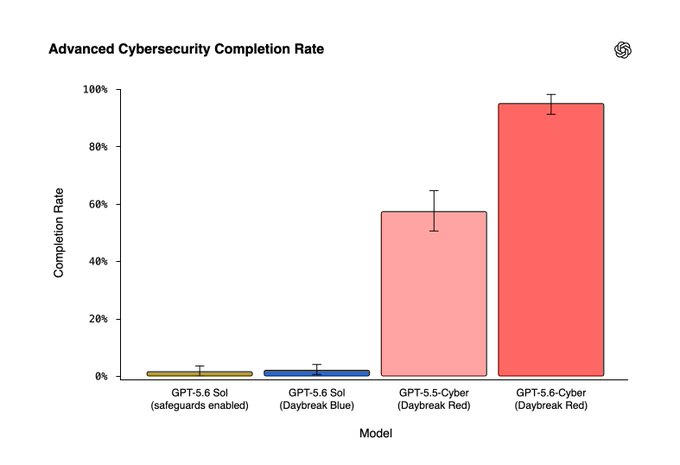
OpenAI เปิดเผยตัวเลขเพิ่มเติม พวกเขาเปิดเผยเมตริกอัตราการดำเนินการภายใน (GPT-5.6-Cyber ตอบสนองคำสั่งทางไซเบอร์ขั้นสูงได้ 95.0% เทียบกับ 1.5% สำหรับ Sol พื้นฐาน) ระบุเกณฑ์มาตรฐานเช่น ExploitGym รายงาน CVE ที่ได้รับมอบหมายจริง และระบุระดับการประเมินภายใต้ Preparedness Framework ว่า “สูง” แต่ต่ำกว่า “วิกฤต” สำหรับรายละเอียดทั้งหมดเกี่ยวกับผู้ที่สามารถเข้าถึงอะไรได้บ้าง โปรดดู Daybreak Blue vs Red
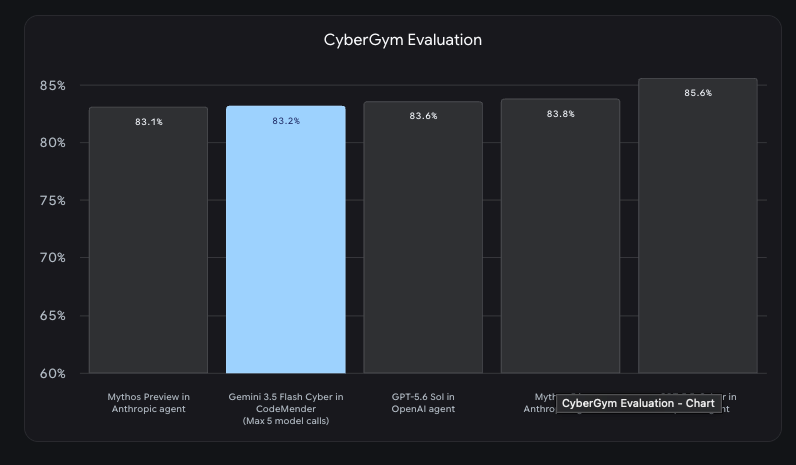
Google ไม่ได้ให้ข้อมูลที่ชัดเจนนักเมื่อเปิดตัว พวกเขายืนยันว่าโมเดลมีอยู่จริง วัตถุประสงค์ในการป้องกัน และสถานะการเข้าถึงที่จำกัด โดยไม่ได้เผยแพร่อัตราการดำเนินการต่อภารกิจที่เปรียบเทียบได้ หรือตารางเกณฑ์มาตรฐาน ดังนั้น แม้ว่าคุณจะสามารถอธิบายโมเดลทั้งสองได้ แต่คุณก็ไม่สามารถนำมาเปรียบเทียบกันในตารางเดียวกันได้ ไม่มีเกณฑ์มาตรฐานร่วมกันที่ผู้ขายทั้งสองได้ดำเนินการเปรียบเทียบกันแบบตัวต่อตัว และงานเป้าหมายของพวกเขา (การพัฒนาการโจมตีเทียบกับการสร้างแพตช์) แทบจะไม่ทับซ้อนกันเลย
สิ่งที่พวกเขามีร่วมกัน
หากตัดความแตกต่างออกไป โมเดลทั้งสองเล่าเรื่องเดียวกันเกี่ยวกับทิศทางของเครื่องมือรักษาความปลอดภัย AI กำลังมุ่งหน้าไปในทิศทางใด:
- การเข้าถึงแบบจำกัด ไม่ใช่ API แบบเปิด ไม่มีโมเดลใดที่เป็นบริการตนเอง ทั้งสองต้องได้รับการอนุมัติ และการเข้าถึงจะจำกัดเฉพาะองค์กรที่ผ่านการตรวจสอบ
- ไม่มีการกำหนดราคาต่อสาธารณะ เนื่องจากไม่มีการเข้าถึงแบบเปิด จึงไม่มีอัตราต่อโทเค็นที่เผยแพร่สำหรับทั้งสอง ตารางราคาใดๆ ที่คุณพบว่ามีการเผยแพร่ไม่ได้รับการยืนยัน
- ตรรกะการใช้งานสองทางแบบเดียวกัน ผู้ขายทั้งสองให้เหตุผลว่าโมเดลที่เก่งในการค้นหาช่องโหว่ก็ย่อมเก่งในการค้นหาช่องโหว่อยู่แล้ว ดังนั้นพวกเขาจึงเริ่มจำกัดการเข้าถึงกับพันธมิตรที่เชื่อถือได้และเฝ้าดูผลก่อนที่จะขยายการเข้าถึง
- เรื่องราวเวอร์ชันที่สับสน โมเดลของ OpenAI อยู่ภายใต้ชื่อ Sol/Terra/Luna; โมเดลของ Google ยังคงอยู่ที่ 3.5 ในขณะที่รุ่นที่คล้ายกันไปที่ 3.6
หากคุณมาหาโมเดลใดโมเดลหนึ่งเพื่อค้นหาคีย์ API คำตอบก็เหมือนกัน: ไม่ใช่ในวันนี้ และอาจไม่ใช่ในรูปแบบที่คุณคาดหวัง
อันไหนสำคัญกับคุณ? อาจจะยังไม่ใช่ทั้งสอง
นี่คือการอ่านในทางปฏิบัติ เว้นแต่คุณจะเป็นผู้จำหน่ายด้านความปลอดภัยที่ได้รับการอนุมัติหรือพันธมิตรของรัฐบาล คุณไม่สามารถใช้โมเดลใดโมเดลหนึ่งได้ในขณะนี้ การเฝ้าดูพวกมันมีประโยชน์สำหรับการทำความเข้าใจทิศทาง แต่ไม่มีโมเดลใดที่จะอยู่ในระบบของคุณในไตรมาสนี้
สิ่งที่ควรอยู่ในระบบของคุณคือการทดสอบความปลอดภัยของ API ที่คุณเป็นเจ้าของจริง โมเดลทั้งสองนี้มีอยู่เพราะช่องโหว่มีค่าใช้จ่ายสูง ช่องโหว่ที่ถูกที่สุดในการป้องกันคือข้อผิดพลาดขอบเขตที่น่าเบื่อในบริการของคุณเอง คุณไม่จำเป็นต้องมีโมเดลไซเบอร์ระดับแนวหน้าเพื่อตรวจจับสิ่งเหล่านั้น
ด้วยไคลเอ็นต์ API เช่น Apidog คุณสามารถเรียกใช้การตรวจสอบที่ตรวจจับได้มากที่สุดโดยใช้ความพยายามน้อยที่สุด:
- ขอบเขตการตรวจสอบสิทธิ์ ส่งคำขอด้วยโทเค็นที่ขาดหายไป หมดอายุ และถูกต้อง และยืนยันว่าแต่ละคำขอส่งคืนสถานะที่ถูกต้อง ระเบียบวินัยเรื่องสิทธิ์ขั้นต่ำเดียวกันนี้ใช้กับเอเจนต์ของคุณด้วย ดูว่า คีย์ API ของเอเจนต์ AI ของคุณสามารถทำอะไรได้จริงบ้าง
- ความปลอดภัยในการขนส่ง ตรวจสอบว่า ใบรับรองไคลเอ็นต์และ mTLS ทำงานถูกต้อง และคำขอแบบธรรมดาถูกปฏิเสธ
นั่นคืองานที่คุณสามารถเริ่มต้นได้ตั้งแต่วันนี้ ด้วยเครื่องมือที่คุณสามารถเข้าถึงได้จริง ดาวน์โหลด Apidog และเริ่มต้นด้วยกรณีการตรวจสอบสิทธิ์
คำถามที่พบบ่อย
อะไรดีกว่ากันระหว่าง GPT-5.6-Cyber หรือ Gemini 3.5 Flash Cyber? โมเดลทั้งสองถูกสร้างขึ้นมาเพื่องานที่แตกต่างกัน ดังนั้น "ดีกว่า" จึงขึ้นอยู่กับงานนั้นๆ GPT-5.6-Cyber เป็นโมเดลระดับแนวหน้าที่ปรับแต่งมาสำหรับการวิจัยเชิงรุก (การพัฒนาการโจมตี, การค้นหาช่องโหว่ Zero-day) Gemini 3.5 Flash Cyber เป็นโมเดลระดับที่เบากว่าที่ปรับแต่งมาสำหรับการแก้ไขช่องโหว่เชิงป้องกัน ผู้ขายทั้งสองยังไม่ได้เผยแพร่เกณฑ์มาตรฐานแบบตัวต่อตัว ดังนั้นจึงไม่มีการเปรียบเทียบคะแนนโดยตรง
ฉันสามารถใช้โมเดลใดโมเดลหนึ่งผ่าน API ได้หรือไม่? ไม่ได้ ทั้งสองโมเดลมีการจำกัดการเข้าถึง GPT-5.6-Cyber ต้องได้รับการอนุมัติจาก Daybreak Red; Gemini 3.5 Flash Cyber เป็นโครงการนำร่องแบบจำกัดสำหรับรัฐบาลและพันธมิตรที่เชื่อถือได้ ไม่มีโมเดลใดที่เสนอ API แบบบริการตนเอง
ทำไมโมเดลทั้งสองจึงถูกจำกัด? การใช้งานสองทาง โมเดลที่เก่งในการค้นหาช่องโหว่ช่วยให้ผู้ป้องกันสามารถแก้ไขได้ และช่วยให้ผู้โจมตีสามารถใช้ประโยชน์ได้ ผู้ขายทั้งสองกำลังจำกัดการเข้าถึงเฉพาะพันธมิตรที่ผ่านการตรวจสอบในขณะที่พวกเขากำลังเฝ้าดูการใช้งานจริง
ความแตกต่างของโมเดลพื้นฐานคืออะไร? GPT-5.6-Cyber สร้างขึ้นบน GPT-5.6 Sol ซึ่งเป็นระดับการให้เหตุผลเรือธงของ OpenAI Gemini 3.5 Flash Cyber สร้างขึ้นบน Flash tier ที่รวดเร็วและราคาถูกกว่าของ Google ซึ่งเหมาะสมกับวัตถุประสงค์ในการสแกนและแก้ไข
ฉันควรใช้อะไรแทน? สำหรับการรักษาความปลอดภัย API ของคุณเอง ให้ทำการทดสอบการตรวจสอบสิทธิ์ การขนส่ง และสัญญาด้วยไคลเอ็นต์เช่น Apidog ไม่จำเป็นต้องใช้โมเดลที่จำกัดการเข้าถึง
ปุ่ม