
Z.ai ตอนนี้ขายโมเดลสองรุ่นที่มีชื่อเกือบเหมือนกัน หน้าต่างบริบท 1M โทเค็นเท่ากัน และมีความแตกต่างด้านราคาถึงเก้าเท่า การตั้งชื่อไม่ได้ช่วยให้คุณเลือกได้เลย คำว่า "Flash" สื่อถึงรุ่นที่เล็กกว่า เร็วกว่า อ่อนแอกว่า และมีเพียงหนึ่งในสามคำนั้นเท่านั้นที่ถูกต้อง
นี่คือฉบับย่อ: GLM-5.3-Flash มีราคาถูกกว่า รองรับรูปภาพได้โดยตรง และให้โควต้าสามเท่าสำหรับผู้ใช้แพลนการเขียนโค้ด ส่วน GLM-5.3 ฉลาดกว่าเล็กน้อยและสร้างผลลัพธ์ได้เร็วกว่าเกือบสองเท่า สำหรับงานส่วนใหญ่ Flash คือค่าเริ่มต้นที่เหมาะสม และภาระในการพิสูจน์คือการเลือกรุ่นที่แพงกว่า
โพสต์นี้จะกล่าวถึงจุดที่กฎดังกล่าวใช้ไม่ได้
ตารางเปรียบเทียบ
| GLM-5.3-Flash | GLM-5.3 | |
|---|---|---|
| ดัชนีความฉลาด (การวิเคราะห์โดย Artificial Analysis) | 57 | 60 |
| ราคาเฉลี่ยต่อ 1M โทเค็น | $0.10 | $0.90 |
| รายการราคาอินพุต / เอาต์พุตต่อ 1M | $0.15 / $0.50 | $1.40 / $4.40 |
| ความเร็วเอาต์พุต | ~49 โทเค็น/วินาที | ~86 โทเค็น/วินาที |
| เวลาถึงโทเค็นแรก | 1.52s | 1.57s |
| หน้าต่างบริบท | 1,048,576 | 1,048,576 |
| การป้อนรูปภาพแบบเนทีฟ | ใช่ | ไม่, ต้องใช้อะแดปเตอร์ |
| พารามิเตอร์ | รวม 320B / ใช้งาน 18B | ใหญ่กว่า, ไม่เปิดเผยทั้งหมด |
| ใบอนุญาต | MIT, open weights | Open weights |
| โควต้าแพลนการเขียนโค้ด | 3x | 1x |
ตัวเลขความเร็วและความฉลาดมาจากการวัดของ Artificial Analysis ราคาเป็นราคาตามรายการของ Z.ai ก่อนส่วนลดเปิดตัวที่กล่าวถึงด้านล่าง
ความแตกต่างด้านราคาถึงเก้าเท่ามาจากไหน
GLM-5.3-Flash เป็นโมเดล Mixture-of-Experts ขนาด 320B ที่เปิดใช้งาน 18B พารามิเตอร์ต่อโทเค็น สร้างขึ้นบนพื้นฐานใหม่ด้วย Hybrid Linear และ Sparse Attention Z.ai รายงานว่าใช้พลังงาน Attention น้อยกว่า GLM-5.3 ประมาณสามเท่า และ KV Cache มีขนาดเล็กกว่าประมาณ 4.4 เท่า
ขนาดของ KV Cache เป็นสิ่งที่ทำให้การให้บริการบริบทที่ยาวมีค่าใช้จ่ายสูง การลดขนาดลง 4.4 เท่าเป็นเหตุผลหลักที่ Z.ai สามารถนำเสนอหน้าต่างบริบท 1M โทเค็นได้ในราคาเพียงหนึ่งในสิบ คุณไม่ได้จ่ายน้อยลงสำหรับบริบทที่สั้นลงหรือโมเดลที่อ่อนแอลง แต่คุณจ่ายน้อยลงเพราะปริมาณการใช้ทรัพยากรในการให้บริการต่อคำขอมีขนาดเล็กลงอย่างแท้จริง
นี่คือผลลัพธ์ทางวิศวกรรมที่แท้จริง ไม่ใช่แค่ส่วนลดโปรโมชั่น ซึ่งสำคัญต่อการคงอยู่ของราคา
ความแตกต่างสามจุดในด้านความฉลาดหมายถึงอะไร
57 เทียบกับ 60 บนดัชนีความฉลาดของ Artificial Analysis ถือเป็นช่องว่างที่แคบในแง่สัมบูรณ์ สำหรับการเทียบเคียง โมเดล Open-weight ขนาดใกล้เคียงกันโดยเฉลี่ยได้คะแนน 27 ดังนั้นทั้งสองโมเดลนี้จึงอยู่เหนือกว่าคู่แข่งอย่างมาก
อย่างไรก็ตาม ความแตกต่างสามจุดไม่ใช่เรื่องเล็กน้อย ช่องว่างดัชนีขนาดนั้นมักจะแสดงให้เห็นในลักษณะดังนี้: ประสิทธิภาพที่แย่ลงเล็กน้อยในห่วงโซ่การให้เหตุผลแบบหลายขั้นตอน, การเบี่ยงเบนเล็กน้อยในงานตัวแทนที่ยาวมาก, และความอ่อนไหวต่อคำแนะนำที่คลุมเครือมากขึ้น สิ่งเหล่านี้ไม่ค่อยปรากฏในการสกัดข้อมูล, การจัดหมวดหมู่, การสรุป, หรือการแก้ไขโค้ดไฟล์เดียวที่ตรงไปตรงมา
การทดสอบภาคปฏิบัติคือการดูว่างานของคุณมีคำตอบที่ตรวจสอบได้หรือไม่ หากคุณสามารถตรวจสอบผลลัพธ์ด้วยโปรแกรมได้ การพลาดเพียงเล็กน้อยของ Flash นั้นง่ายต่อการจับและแก้ไข และด้วยราคาที่ถูกกว่าเก้าเท่า คุณสามารถลองใหม่ได้หลายครั้ง หากงานของคุณสร้างข้อความที่มนุษย์ต้องอ่านและตัดสิน คุณภาพที่แตกต่างกันนั้นยากต่อการกู้คืน และช่องว่างของราคาก็มีความสำคัญน้อยกว่าผลลัพธ์ที่ได้
ความเร็วคือจุดเดียวที่ Flash แพ้
นี่คือส่วนที่ชื่อรุ่นดูจะย้อนแย้ง GLM-5.3 สร้างผลลัพธ์ได้ที่ประมาณ 86 โทเค็นต่อวินาที ส่วน GLM-5.3-Flash ทำได้ประมาณ 49 โมเดลที่ใหญ่กว่าและแพงกว่านั้นเร็วกว่าเกือบสองเท่าในการสร้างผลลัพธ์
เวลาถึงโทเค็นแรกนั้นแทบจะเท่ากัน คือ 1.52 วินาที เทียบกับ 1.57 วินาที ดังนั้นทั้งสองโมเดลจึงให้ความรู้สึกตอบสนองเท่ากันเมื่อเริ่มต้นการตอบสนอง
ผลที่ตามมาขึ้นอยู่กับความยาวของเอาต์พุตทั้งหมด:
- การตอบสนองสั้นๆ ไม่เกี่ยวข้อง ทั้งคู่เริ่มภายในประมาณ 1.5 วินาทีและเสร็จสิ้นก่อนที่ใครจะสังเกตเห็นความแตกต่างของปริมาณงาน
- การสร้างผลลัพธ์ที่ยาว การตอบสนอง 4,000 โทเค็นใช้เวลาประมาณ 82 วินาทีบน Flash และประมาณ 47 วินาทีบน GLM-5.3 ในเครื่องมือแบบอินเทอร์แอคทีฟ นี่คือช่องว่างที่มีนัยสำคัญ
- งานแบบแบตช์ที่มีการทำงานพร้อมกัน ไม่เกี่ยวข้องส่วนใหญ่เช่นกัน เพราะคุณปรับขนาดด้วยคำขอแบบขนานแทนที่จะเป็นความเร็วต่อสตรีม และความแตกต่างด้านราคาก็ทำให้เกิดการทำงานพร้อมกันได้มาก
หากคุณกำลังสตรีมเอาต์พุตขนาดยาวให้กับผู้ที่กำลังรออยู่ GLM-5.3 มอบประสบการณ์ที่ดีกว่า นี่คือกรณีที่ชัดเจนที่สุดในการจ่ายแพงกว่าถึงเก้าเท่า
ความสามารถหลากหลายรูปแบบคือเส้นแบ่งที่แท้จริง
GLM-5.3-Flash รองรับรูปภาพ, วิดีโอ, และไฟล์เป็นบล็อกเนื้อหาในการร้องขอการเติมข้อความแชทเดียวกันกับข้อความของคุณ GLM-5.3 ไม่สามารถทำได้โดยตรง; การมองเห็นต้องผ่านอะแดปเตอร์แยกต่างหาก
หากแอปพลิเคชันของคุณต้องการให้โมเดลดูบางสิ่ง นี่ไม่ใช่การเปรียบเทียบ แต่เป็นข้อกำหนด Flash เป็นหนึ่งเดียวในสองโมเดลที่ทำได้ในการเรียกครั้งเดียว ในหน้าต่างบริบทเดียว และในบรรทัดการเรียกเก็บเงินเดียว
ความสามารถนั้นรวมกับบริบท 1M ในลักษณะที่ใหม่จริงสำหรับตระกูลโมเดลนี้: เอกสารข้อกำหนดขนาดยาวและภาพหน้าจอของผลลัพธ์ที่สร้างขึ้นสามารถอยู่ในพรอมต์เดียวกันได้ Z.ai เองก็กล่าวถึงการสังเกตอินเทอร์เฟซและการแสดงผล ซึ่งเป็นการวางกรอบในลักษณะของ Code Agent มากกว่าการอธิบายรูปภาพ
คู่มือวิชันของเรา ครอบคลุมเพย์โหลดและเวิร์กโฟลว์ โมเดลวิชันเฉพาะทางรุ่นเก่ามีอยู่ใน คู่มือ API ของ GLM-5V-Turbo หากคุณกำลังดูแลบางสิ่งที่สร้างขึ้นบนเส้นทางนั้น
มุมมองสำหรับแพลนการเขียนโค้ด
สำหรับสมาชิก GLM Coding Plan การคำนวณแตกต่างและง่ายกว่า Flash ถูกรวมอยู่ในแพลนและมีรายงานว่ามีโควต้าที่ใช้งานได้มากกว่า GLM-5.3 ถึงสามเท่า Z.ai ยังระบุด้วยว่าการเรียกใช้ในช่วงนอกเวลาทำการจะใช้คะแนนเพียงครึ่งหนึ่งของมาตรฐาน
หากคุณกำลังใช้งาน Claude Code หรือ Cline โดยอิงตามโควต้าแพลนของคุณ การขอสามเท่าสำหรับดัชนีที่ลดลงสามจุดเป็นการแลกเปลี่ยนที่ง่ายสำหรับงานประจำวัน เก็บ GLM-5.3 ไว้สำหรับปัญหาที่ยาก และให้ Flash รองรับปริมาณงาน การตั้งค่าสำหรับทั้งสองระบบอยู่ใน คู่มือ Claude Code และ Cline ของเรา
ตรวจสอบตัวคูณโควต้าบน z.ai ก่อนวางแผน เพราะเงื่อนไขแพลนมักจะเปลี่ยนแปลงบ่อยกว่าข้อกำหนดของโมเดล
กำหนดเวลาด้านราคา
ส่วนลดเปิดตัว 50% สำหรับ GLM-5.3-Flash จะมีผลจนถึงวันที่ 9 กันยายน 2026 จนถึงตอนนั้น อัตราที่มีผลคือ $0.075 สำหรับอินพุตและ $0.25 สำหรับเอาต์พุตต่อล้าน ซึ่งจะขยายช่องว่างกับ GLM-5.3 เป็นประมาณสิบแปดเท่า
หลังจากหมดเขต ส่วนลดจะกลับเป็นราคาปกติที่ $0.15 และ $0.50 และช่องว่างจะกลับมาอยู่ที่ประมาณเก้าเท่า ไม่ว่าจะด้วยวิธีใด Flash ก็ยังถูกกว่ามาก กำหนดเวลานี้สำคัญสำหรับการกำหนดประมาณการค่าใช้จ่าย ไม่ใช่สำหรับการเลือกระหว่างสองโมเดล การวิเคราะห์ราคาของเรา มีตัวเลขที่คำนวณไว้ให้
กฎการตัดสินใจ
ใช้ GLM-5.3-Flash เมื่อ:
- อินพุตของคุณรวมรูปภาพ, วิดีโอ, หรือไฟล์
- ต้นทุนต่อโทเค็นเป็นข้อจำกัดที่คุณกำลังปรับให้เหมาะสมที่สุด
- คุณใช้งานการสกัดข้อมูล, การจัดหมวดหมู่, หรือการจัดเส้นทางที่มีปริมาณมาก
- คุณอยู่ในแพลนการเขียนโค้ดและต้องการใช้โควต้าให้คุ้มค่าที่สุด
- คุณต้องการโมเดลที่ได้รับอนุญาตแบบ MIT และมี Open Weights ที่คุณสามารถโฮสต์เองได้ การรันบนเครื่องของคุณ ครอบคลุมถึงฮาร์ดแวร์ที่ต้องการ
ใช้ GLM-5.3 เมื่อ:
- คุณสตรีมการตอบสนองที่ยาวให้มนุษย์ที่กำลังรออยู่ และปริมาณงานที่ได้คือประสบการณ์ที่สัมผัสได้
- งานของคุณเกี่ยวข้องกับการให้เหตุผลระยะยาวที่ความแตกต่างสามจุดของดัชนีมีผลกระทบสะสมในแต่ละขั้นตอน
- คุณภาพของเอาต์พุตถูกตัดสินโดยบุคคลมากกว่าการตรวจสอบด้วยการทดสอบ
ใช้ทั้งสองเมื่อ: คุณสามารถกำหนดเส้นทางได้ ส่งทราฟฟิกส่วนใหญ่ไปยัง Flash และยกระดับไปใช้ GLM-5.3 เมื่อเกิดข้อผิดพลาด, ความมั่นใจต่ำ, หรือตามประเภทงาน ช่องว่างราคาสิบเท่าทำให้การสร้าง Router คุ้มค่า และเนื่องจากทั้งสองโมเดลอยู่เบื้องหลัง Endpoint ที่เข้ากันได้กับ OpenAI เดียวกัน การกำหนดเส้นทางจึงเป็นการสลับ ID โมเดลมากกว่าการรวมระบบ
การย้ายระหว่างโมเดล
หากคุณกำลังใช้งาน GLM-5.3 อยู่แล้วและกำลังพิจารณาการย้าย ส่วนทางเทคนิคนั้นเล็กน้อย และส่วนการตรวจสอบคือส่วนที่ต้องลงแรง
สิ่งที่ไม่เปลี่ยนแปลง URL พื้นฐาน, รูปแบบการยืนยันตัวตน, รูปแบบคำขอและการตอบสนอง, ความหมายของการสตรีม, และ Schema การเรียกใช้เครื่องมือ ทั้งสองโมเดลอยู่เบื้องหลังพื้นผิวที่เข้ากันได้กับ OpenAI เดียวกัน การสลับคือการเปลี่ยนสตริง ID โมเดล
สิ่งที่เปลี่ยนแปลง ต้นทุนต่อการเรียกใช้ลดลงประมาณเก้าเท่า การสร้างผลลัพธ์ช้าลงประมาณครึ่งหนึ่ง คุณภาพการให้เหตุผลเปลี่ยนไปสามจุดบนดัชนี และคุณได้รับความสามารถในการป้อนรูปภาพที่ไม่เคยมีมาก่อน
สิ่งที่ต้องตรวจสอบก่อนตัดสินใจ เรียกใช้พรอมต์จริงของคุณผ่านทั้งสองโมเดลและเปรียบเทียบในสี่ด้าน: ความถูกต้องของเอาต์พุตในกรณีที่คุณสามารถตรวจสอบได้, Latency แบบ End-to-End รวมถึงเวลาการสร้างผลลัพธ์ ไม่ใช่แค่โทเค็นแรก, จำนวนโทเค็นจากออบเจกต์ usage ในการตอบสนองแต่ละครั้ง, และพฤติกรรมในบริบทที่ยาวที่สุดของคุณที่เหมือนจริง
ด้านที่สี่นี้เป็นสิ่งที่ทำให้เกิดปัญหาได้มากที่สุด โมเดลที่ดูเหมือนจะเทียบเท่ากันในพรอมต์สั้นๆ อาจแตกต่างกันอย่างเห็นได้ชัดเมื่อบริบทเต็ม และตารางการเปรียบเทียบจะไม่บอกคุณสิ่งนั้นเกี่ยวกับข้อมูลของคุณเอง
หากคุณเริ่มต้นด้วยโมเดลพื้นฐาน GLM-5.3 คืออะไร ครอบคลุมในแง่มุมของตัวเอง และ คู่มือ API ของ GLM-5.3 มีการตั้งค่าที่คุณกำลังย้ายมาจาก
ทดสอบเองดีกว่าเชื่อตาราง
ตัวเลขทุกตัวข้างต้นไม่ว่าจะเป็นการอ้างสิทธิ์ของผู้ขายหรือเกณฑ์มาตรฐานของบุคคลที่สามที่รันบนปริมาณงานของคนอื่น ไม่มีสิ่งใดบอกคุณว่าโมเดลสองตัวนี้ทำงานอย่างไรกับพรอมต์ของคุณ
การสลับคือสตริงเดียว ชี้ไคลเอนต์ที่เข้ากันได้กับ OpenAI ไปที่ https://api.z.ai/api/paas/v4/ เรียกใช้พรอมต์จริงของคุณผ่าน glm-5.3-flash และ glm-5.3 แล้วเปรียบเทียบผลลัพธ์, Latency, และจำนวนโทเค็นบนทราฟฟิกที่คุณสนใจ คู่มือ API มีการตั้งค่าให้พร้อม
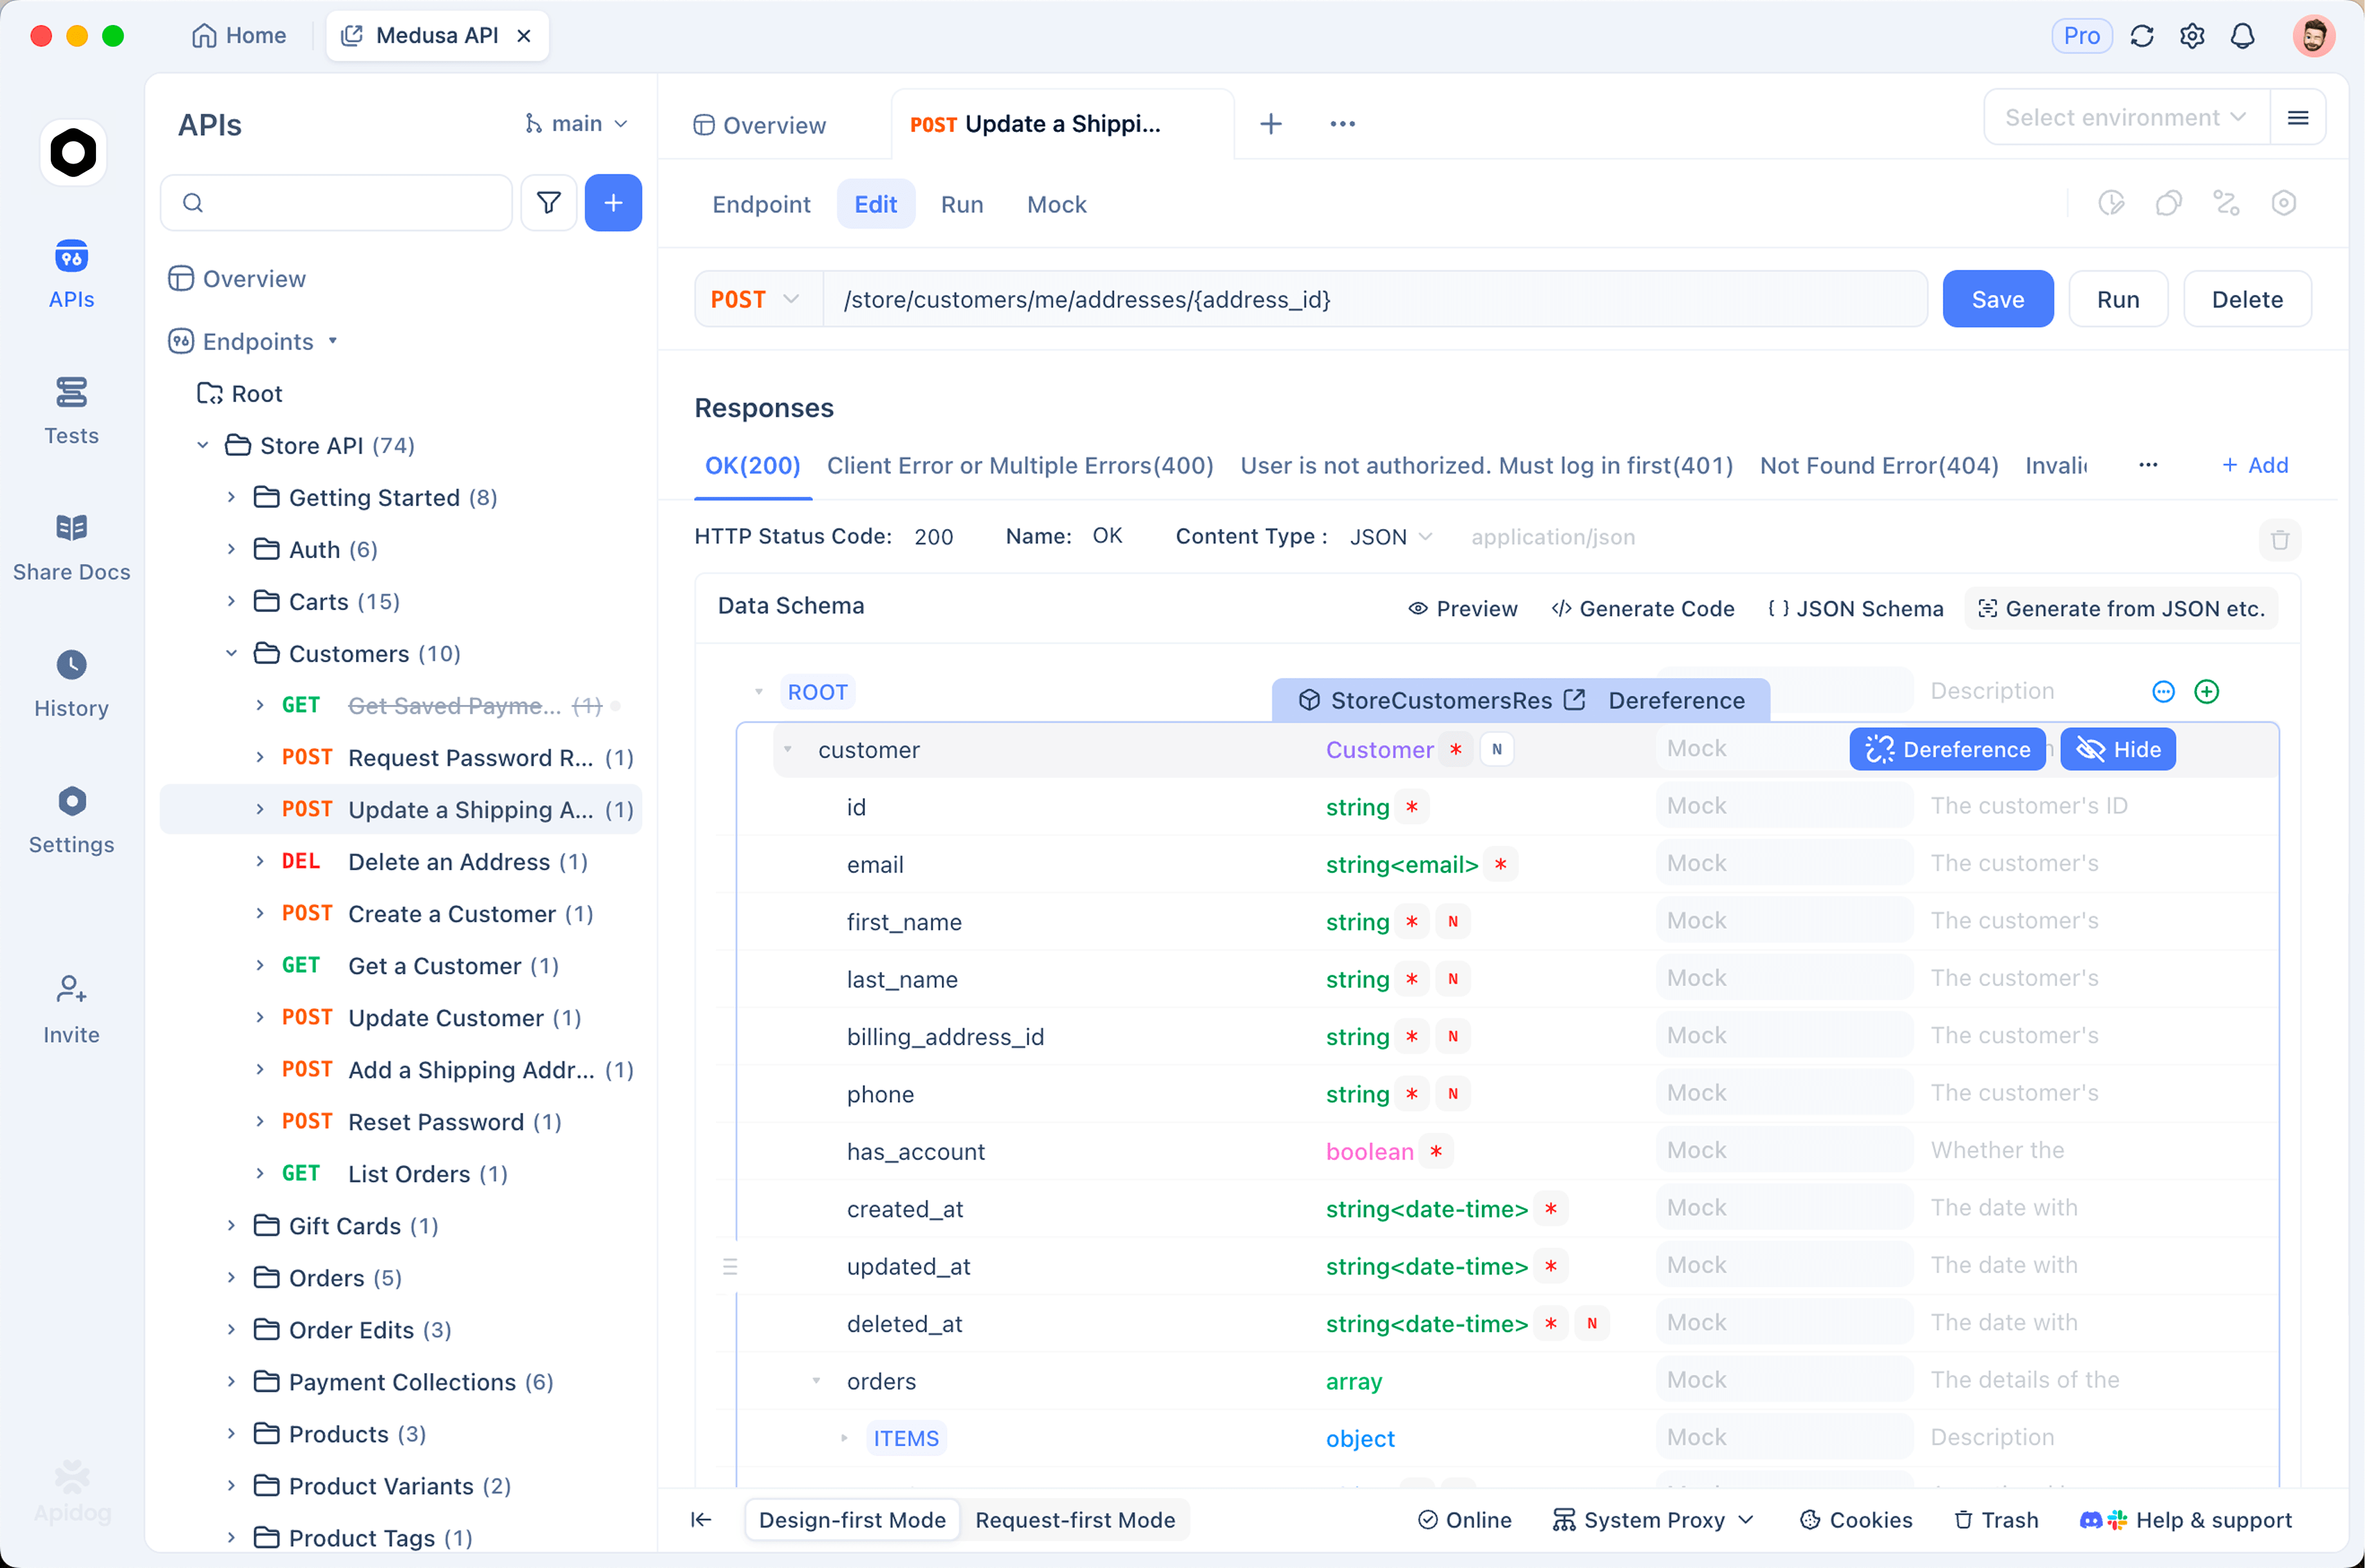
นี่คือจุดที่การบันทึกการเปรียบเทียบเป็นชุดที่สามารถทำซ้ำได้จะให้ผลตอบแทน ใน Apidog คุณสามารถเก็บการเรียกทั้งสองไว้ในคอลเล็กชันเดียวโดยมี ID โมเดลเป็นตัวแปรสภาพแวดล้อม แนบข้อกำหนดไปยังฟิลด์ที่แอปพลิเคชันของคุณอ่าน และรันซ้ำทั้งหมดเมื่อส่วนลดหมดอายุหรือ Z.ai ออกการแก้ไขครั้งถัดไป การเลือกโมเดลที่คุณสามารถทดสอบซ้ำได้ในสามสิบวินาทีคือการตัดสินใจที่คุณสามารถทบทวนได้; การตัดสินใจที่อยู่ในประวัติเชลล์ทำไม่ได้
คำถามที่พบบ่อย
- GLM-5.3-Flash เป็นเพียง GLM-5.3 เวอร์ชันที่เล็กลงหรือไม่ ไม่ใช่ เป็นโมเดลพื้นฐานที่ได้รับการฝึกฝนแยกต่างหากด้วยสถาปัตยกรรม Attention ที่แตกต่างกัน ไม่ใช่การกลั่นกรองหรือรุ่นย่อ
- มีหน้าต่างบริบทเท่ากันหรือไม่ ใช่ ทั้งคู่มี 1,048,576 โทเค็น
- ตัวไหนดีกว่าสำหรับการเขียนโค้ด Flash ได้คะแนน 84.3 ใน Terminal-Bench 2.1 และ 63.4 ใน DeepSWE ตามข้อมูลจาก Z.ai ซึ่งถือว่าแข็งแกร่ง GLM-5.3 แข็งแกร่งกว่าเล็กน้อยในการให้เหตุผลทั่วไป สำหรับผู้ใช้แพลนการเขียนโค้ด โควต้า 3 เท่ามักจะเป็นตัวตัดสิน
- ฉันสามารถสลับไปมาระหว่างกันได้โดยไม่ต้องเปลี่ยนโค้ดหรือไม่ ใช่ ใช้ Endpoint ที่เข้ากันได้กับ OpenAI เดียวกัน แต่ใช้ ID โมเดลที่แตกต่างกัน การป้อนรูปภาพเป็นคุณสมบัติเฉพาะของ Flash เท่านั้น
- โมเดลที่ถูกกว่าจะยังคงถูกอยู่หรือไม่ ราคาที่ถูกลงสะท้อนถึง KV Cache ที่มีขนาดเล็กลงและการใช้พลังงาน Attention ที่ต่ำลง ไม่ใช่โปรโมชั่น ดังนั้นข้อได้เปรียบเชิงโครงสร้างจึงควรคงอยู่ ส่วนลดเปิดตัวเพิ่มเติม 50% จะหมดอายุในวันที่ 9 กันยายน 2026