Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2 สรุปสั้น ๆ ในบรรทัดเดียว: Fable 5.2 ทำคะแนนได้สูงสุด, Neon มีต้นทุนต่อ token ต่ำที่สุด และ Astra ทำงาน benchmark อิสระได้สำเร็จด้วยเงินน้อยที่สุด Neon ตั้งราคาที่ $3 / $15 ต่อ 1M token ขาเข้า/ขาออก ขณะที่ Astra และ Fable ตั้งราคาเท่ากันที่ $8 / $40 ทั้งสามรุ่นมีความจุ context ประมาณ 1M token
โมเดลระดับแนวหน้าสามรุ่นเปิดตัวภายในสิบวัน: Claude Fable 5.2 เมื่อวันที่ 9 พฤศจิกายน 2026, GPT-6.2 Astra เมื่อวันที่ 17 พฤศจิกายน และ Gemini 4 Neon เมื่อวันที่ 18 พฤศจิกายน ด้านล่างนี้คือราคา สเปก คะแนนจากผู้ทดสอบอิสระ ต้นทุนต่อ task และวิธีทดสอบทั้งสามรุ่นด้วย Apidog CLI
Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2: สรุปผลแบบเร็ว
เลือกตามลักษณะงาน ไม่ใช่ตามอันดับบน leaderboard:
- Gemini 4 Neon สำหรับงานเขียนโค้ดและวิเคราะห์ที่ซับซ้อนซึ่งคุณใช้งานตลอดทั้งวัน ราคาต่อ token ถูกกว่าอีกสองรุ่น 62.5% และอยู่ในอันดับสองบน Vals Index
- GPT-6.2 Astra หากระบบของคุณทำงานอยู่บน OpenAI Responses API มันเขียน token ต่อ task น้อยกว่ามาก ทำให้มีต้นทุนต่อ task ต่ำที่สุดในสามรุ่นตามการวัดของ Artificial Analysis แม้ราคาจะอยู่ที่ $8 / $40
- Claude Fable 5.2 สำหรับงานยาวที่ยากที่สุด ซึ่งการรันล้มเหลวหนึ่งครั้งมีต้นทุนสูงกว่าค่า token มันนำทั้งสอง index อิสระ แต่มีต้นทุนต่อ task สูงที่สุด
หากคุณตามมาจากกรณีของเดือนตุลาคม บทความ การเปรียบเทียบ Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5 ของเราครอบคลุมรุ่นก่อนหน้า
ทั้งสามรุ่นเปรียบเทียบกันอย่างไรในด้านราคาและสเปก?
Neon เป็นข้อยกเว้นในเรื่องราคา ตัวเลขมาจากโพสต์เปิดตัว Gemini 4 Neon และหน้าราคาของ Google, หน้าข้อมูลโมเดล GPT-6.2 Astra และภาพรวม Claude Fable 5.2 ของ Anthropic
| สเปก | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| API model ID | gemini-4-neon |
gpt-6.2-astra |
claude-fable-5-2 |
| วันที่เปิดตัว | 18 พ.ย. 2026 | 17 พ.ย. 2026 | 9 พ.ย. 2026 |
| ขาเข้า / ขาออก ต่อ 1M | $3 / $15 | $8 / $40 | $8 / $40 |
| Cached input ต่อ 1M | $0.15 (implicit เท่านั้น) | $0.40 | $0.20 |
| Context window | 1,048,576 (ใช้ร่วมกับ output) | 1,050,000 (input สูงสุด 922,000) | 1M |
| Output สูงสุดต่อ request | 65,536 | 128,000 | 128K |
| Prompt ยาว | ราคาคงที่ตลอด 1M | input เกิน 272K: input 2x, output 1.5x | ราคาคงที่ตลอด 1M |
| ส่วนลดแบบ Batch | 50% (Batch และ Flex) | 50% | 50% |
| การควบคุมการคิด | thinking_level: low ถึง xhigh, ค่าเริ่มต้น high |
reasoning.effort, ปฏิเสธค่า none |
effort, ค่าเริ่มต้น high |
| Free API tier | ไม่มี | ไม่มี | ไม่มี |
มีสองรายละเอียดที่ส่งผลต่อบิลจริง ระบบ caching ของ Neon เป็นแบบ implicit: คุณจะได้ราคา $0.15 ต่อเมื่อ Google จับคู่ prompt prefix ที่ซ้ำได้เท่านั้น และ Neon คืนค่าได้สูงสุด 65,536 token ต่อ request ดังนั้นงานที่ต้อง output ยาวมากอาจต้องใช้ long decode ของ Google หรือทำ continuation loop
สำหรับตารางราคาฉบับเต็ม ดูบทความวิเคราะห์ของเราเรื่อง ราคา Gemini 4 Neon, ราคา GPT-6.2 Astra และ ราคา Claude Fable 5.2
รุ่นไหนชนะบน benchmark อิสระ?
ตาราง benchmark จากผู้พัฒนาโมเดลแทบไม่เคยใช้ชุดทดสอบเดียวกัน แต่มี leaderboard อิสระสองแห่งที่จัดอันดับทั้งสามรุ่นบนชุดทดสอบชุดเดียว — และทั้งสองเห็นต่างกันในอันดับสอง
| ตัวชี้วัด | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 61 (xhigh) | 62 (max) | 65 (max) |
| Vals Index | 70.87%, #2 | 67.66%, #8 | 71.31%, #1 |
| ต้นทุนต่อ index task (AA) | $6.44 | $4.00 | $26.54 |
| เวลาต่อ index task (AA) | 21.5 นาที | 13.9 นาที | 41.8 นาที |
| ความเร็ว output (AA) | 110 tok/s | 49 tok/s | 109 tok/s |
| Output token ตลอดชุด AA index | 283M | 65.8M | 275M |
แหล่งที่มา: หน้าข้อมูลโมเดล Artificial Analysis ของแต่ละรุ่น ตรวจสอบเมื่อวันที่ 19 พฤศจิกายน 2026 และ Vals Index ณ วันที่ 18 พฤศจิกายน 2026
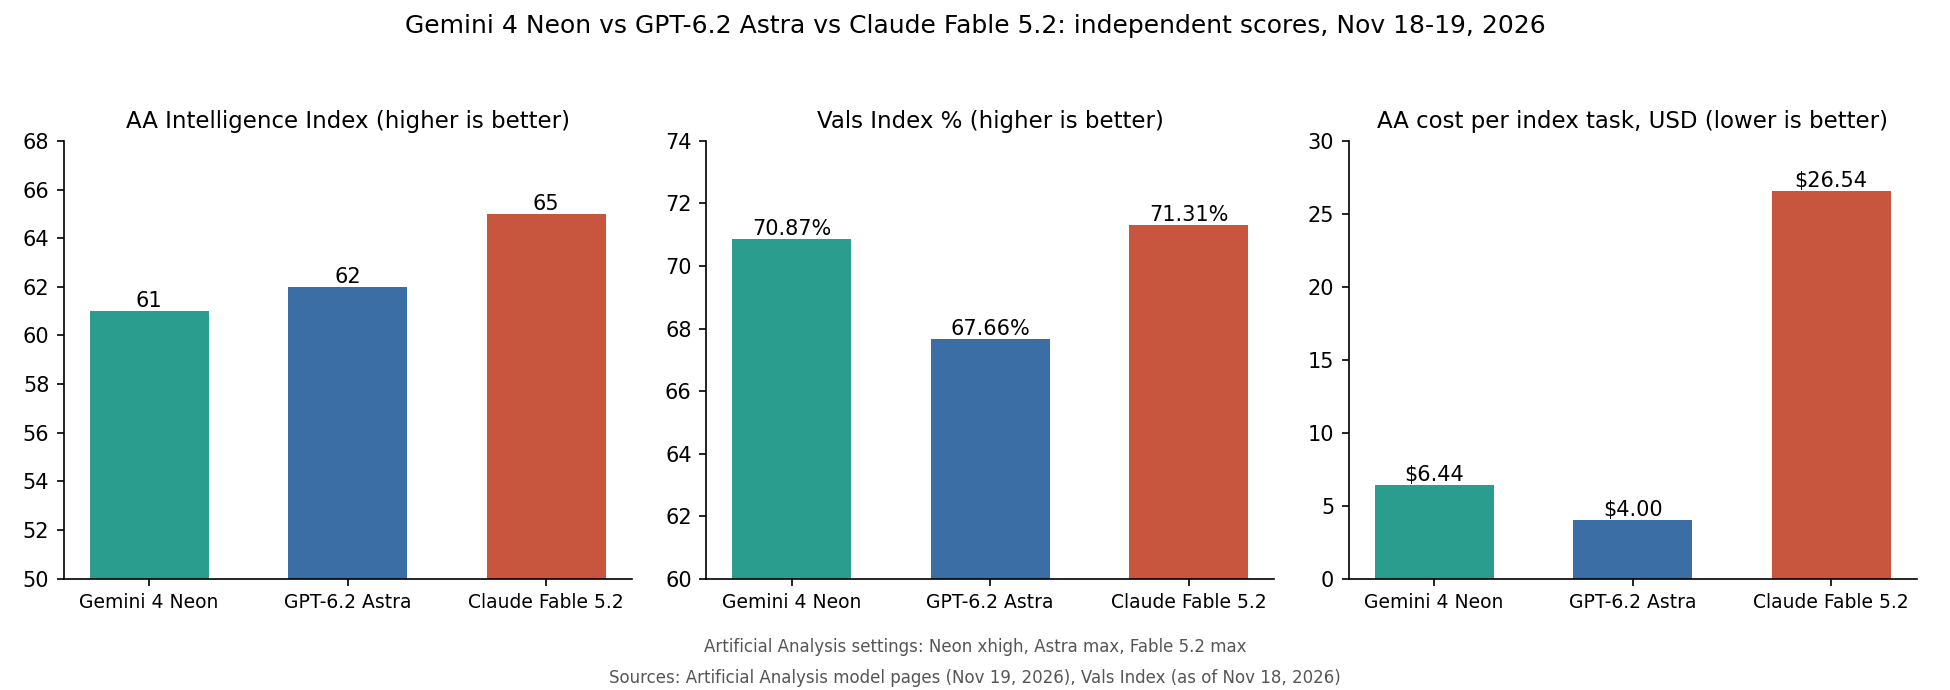
Fable 5.2 นำทั้งสองกระดาน และบน Vals นั้น Neon ตามหลังอยู่เพียง 0.44 ポイント Artificial Analysis จัดให้ Astra นำหน้า Neon อยู่หนึ่ง điểm ส่วน Vals จัดให้ Neon นำหน้า Astra มากกว่า 3 จุด
โพสต์เปิดตัวของ Google จัดอันดับ Neon ไว้ที่ #3 บน Artificial Analysis แต่ในวันที่ 19 พฤศจิกายน หน้าเดียวกันกลับจัดให้อยู่ที่ #6 จาก 96 อันดับ อันดับในวันเปิดตัวเปลี่ยนแปลงได้เร็ว และช่องว่างหนึ่งจุดนั้นเป็นเพียง noise แถวข้อมูลต้นทุนและความเร็วบอกอะไรได้มากกว่าว่าแต่ละรุ่นจะให้ความรู้สึกอย่างไรใน agent ของคุณ
ทำไมรุ่นที่แพงที่สุดต่อ token ถึงมีต้นทุนต่อ task ต่ำที่สุด?
ราคาต่อ token เป็นเพียงครึ่งหนึ่งของบิล ส่วนอีกครึ่งคือจำนวน token ที่โมเดลเขียนก่อนจะได้คำตอบ ในชุดทดสอบของ Artificial Analysis นั้น Astra สร้าง output 65.8M token ขณะที่ Neon สร้าง 283M และ Fable 275M ซึ่งมากกว่ากันกว่าสี่เท่า อัตรา output $40 ของ Astra จึงไปคูณกับปริมาณที่น้อยกว่ามาก ทำให้ต้นทุนต่อ task อยู่ที่ $4.00 ต่ำกว่า Neon ที่ $6.44 แม้อัตรา output ของ Neon จะต่ำกว่า 62.5%
การตั้งค่ามีผล Artificial Analysis รัน Neon ที่ xhigh; ที่ high นั้นได้คะแนน 60 ด้วย output 123M token แทนที่จะเป็น 283M — เสียไปหนึ่งคะแนนแต่ใช้ token น้อยกว่าครึ่ง คู่มือ Gemini 4 Neon thinking levels ของเราแสดงเส้นโค้งทั้งหมด
ตัวเลข $26.54 ของ Fable มาจากการรวมอัตรา output ที่สูงกับความละเอียดยืดยาวของโมเดล — นั่นคือราคาของคะแนนสูงสุด
งาน agent จริงมีต้นทุนเท่าไรในแต่ละรุ่น?
ลองคำนวณสองงานด้วยราคาตามตาราง โดยสมมติว่าใช้จำนวน token เท่ากันในแต่ละรุ่น (ซึ่งในความจริงจะไม่เท่ากัน ดังนั้นให้อ่านเป็นการเปรียบเทียบราคา ไม่ใช่การพยากรณ์)
| ลักษณะงาน | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Agent session: input ใหม่ 150K, อ่านจาก cache 1.35M, output 150K | $0.45 + $0.20 + $2.25 = $2.90 | $1.50 + $0.54 + $6.00 = $8.04 | $1.50 + $0.27 + $6.00 = $7.77 |
| คำขอเดียวยาว: input 400K, output 8K, ไม่มี cache | $1.20 + $0.12 = $1.32 | $6.40 + $0.48 = $6.88 | $3.20 + $0.32 = $3.52 |
Astra และ Fable คิดค่าธรรมเนียม cache write $10 ต่อ 1M สำหรับ 150K แรก ส่วน Neon ไม่มีค่าธรรมเนียมการเขียน cache กรณีคำขอยาวแสดงให้เห็นถึงกฎ 272K ของ Astra: เมื่อเกินเส้นนั้น OpenAI จะคิด $16 สำหรับ input และ $60 สำหรับ output ต่อ 1M ตลอดทั้งคำขอ
หาก Neon เขียน token มากกว่า Astra ถึง 3 เท่าใน prompt ของคุณ session ราคา $2.90 ของ Neon ก็อาจแพงกว่า Astra ได้ วัดจำนวน output token ก่อนตัดสินใจเลือกจากราคา
ความแตกต่างของ API ส่วนไหนจะทำให้ agent harness ของคุณพัง?
API ของแต่ละเจ้ามีการตั้งค่าที่อีกเจ้าปฏิเสธ:
- Gemini 4 Neon: พารามิเตอร์
thinking_budgetแบบเก่าจะคืนค่า HTTP 400 เช่นเดียวกับfrequency_penaltyและpresence_penaltyค่าtemperature,top_kและtop_pที่กำหนดเองจะถูกละเว้น ตามที่ระบุในคู่มือนักพัฒนาของ Google Cloud - GPT-6.2 Astra:
reasoning.effortที่ตั้งเป็นnoneจะคืนค่า 400 และหน้าข้อมูลโมเดลระบุว่าไม่รองรับ Realtime, Assistants และ fine-tuning - Claude Fable 5.2: การบังคับใช้ tool (
tool_choiceเป็นanyหรือtool) และพารามิเตอร์ sampling อย่างtemperatureจะคืนค่า 400 และไม่สามารถปิดการคิด (thinking) ได้
คู่มือ GPT-6.2 Astra vs Claude Fable 5.2 ของเราครอบคลุมความแปลกเฉพาะตัวของ Astra และ Fable ไว้อย่างละเอียด และคู่มือ Gemini 4 Neon API ครอบคลุมรูปแบบ request ของ Neon
แต่ละรุ่นเหมาะกับงานแบบไหนที่สุด?
Gemini 4 Neon ถูกออกแบบมาสำหรับงานที่ทำบ่อยและซับซ้อน Google กล่าวว่ามันลดการอ่านไฟล์ซ้ำซ้อนและสามารถวางแผนระหว่างที่ subagent Gemini 4 Hydrogen ที่ถูกกว่าทำงานแต่ละขั้นให้ ใน Google Antigravity คำสั่ง /swarm จะรัน agent แบบขนาน
GPT-6.2 Astra มาพร้อมกล่องเครื่องมือของ OpenAI: apply_patch, hosted shell, computer use, MCP และ multi-agent beta ใน Responses API มันเป็นรุ่นที่เร็วที่สุดในบรรดาสามรุ่นตามการวัดของ Artificial Analysis ที่ 13.9 นาทีต่อ task Simon Willison บันทึกไว้ในวันเปิดตัว ว่ามันได้คะแนนต่ำกว่า Fable 5.2 เล็กน้อยใน benchmark หลายชุด
Claude Fable 5.2 เป็นตัวเลือกเมื่อคุณภาพสำคัญกว่าต้นทุน: agent session ยาว, refactor งานยาก, งานวิจัย ค่า cache read ที่ $0.20 และราคาคงที่ตลอด 1M ช่วยบรรเทาผลกระทบจากอัตรา output $40 ได้
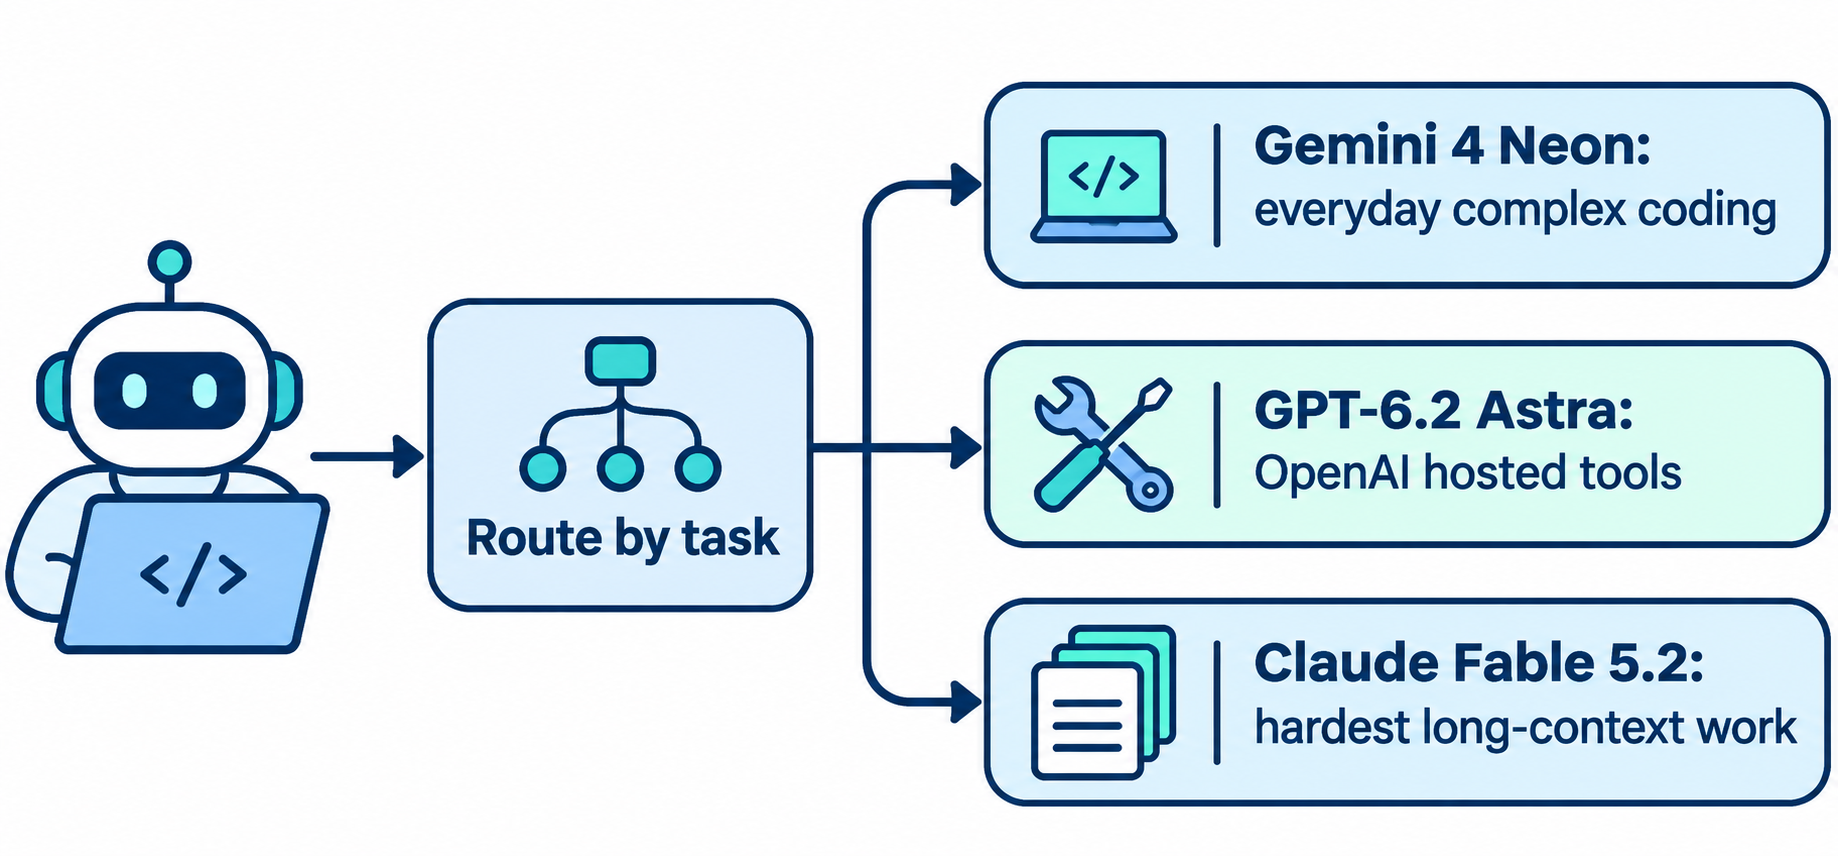
คุณไม่จำเป็นต้องเลือกเพียงรุ่นเดียว ส่งขั้นตอนส่วนใหญ่ของ agent ไปที่ Neon และส่งงานส่วนน้อยที่ล้มเหลวไปให้ Fable หรือ Astra ต้นทุนเฉลี่ยของคุณก็จะอยู่ใกล้เคียงกับ Neon
จะทดสอบทั้งสามรุ่นกับงานของคุณเองได้อย่างไร?
Leaderboard วัดงานของคนอื่น ส่ง prompt จริง 5 ถึง 10 รายการจากประวัติของ agent คุณไปยังทั้งสาม API แล้วเปรียบเทียบอัตราการผ่าน จำนวน token และ latency การยิงคำขอพวกนี้ด้วยมือมันน่าเบื่อเร็ว จึงปล่อยให้ Claude Code, Codex หรือ Cursor ขับเคลื่อน Apidog CLI การตั้งค่าใช้เวลาสามคำสั่ง:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้ prompt กับ agent ของคุณหนึ่งรายการ:
In Apidog project <PROJECT_ID>, create three test cases that send the
same code-review prompt to gemini-4-neon (Gemini Interactions API,
thinking_level high), gpt-6.2-astra (OpenAI Responses API, effort high)
and claude-fable-5-2 (Claude Messages API, no temperature field).
Keep each API key in a private environment variable. Assert a 200
status and a non-empty answer, record token usage and response time,
run each case 5 times and summarize cost per run at list prices.
Validate every payload against its schema before you write it.
agent จะตรวจสอบ schema ของแต่ละ payload เขียนชุดทดสอบและรันให้ flag ต่างๆ เหล่านี้มาจาก apidog run --help บน CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <NEON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir abc-results
ทำซ้ำคำสั่งสุดท้ายด้วย case ID ของ Astra และ Fable -n 5 จะรันแต่ละ case ห้าครั้ง และ --upload-report จะแสดงการรันในแอป Apidog นี่เป็นแม่แบบของ workflow เท่านั้น เราไม่ได้รันกับทั้งสาม API จากเครื่องนี้
เพิ่ม negative case สำหรับข้อผิดพลาด 400 ที่กล่าวถึงข้างต้น เพื่อให้การเปลี่ยนแปลงกฎของผู้ให้บริการปรากฏในชุดทดสอบของคุณก่อน คู่มือ Apidog CLI ใน Claude Code ครอบคลุมการตั้งค่า agent และแพ็กเกจ Free ของ Apidog รองรับผู้ใช้สูงสุด 4 คน
คำถามที่พบบ่อย
Gemini 4 Neon ดีกว่า GPT-6.2 Astra หรือไม่? ขึ้นอยู่กับ leaderboard: Neon นำบน Vals Index (70.87% เทียบกับ 67.66%) ส่วน Astra นำอยู่หนึ่งจุดบน Artificial Analysis Intelligence Index (62 เทียบกับ 61) Neon ราคา $3 / $15 ต่อ 1M token เทียบกับ Astra ที่ $8 / $40
ในสามรุ่น ตัวไหนถูกที่สุด? ต่อ token คือ Gemini 4 Neon ที่ $3 ขาเข้า และ $15 ขาออกต่อ 1M ส่วนต่อ task ตามการวัดของ Artificial Analysis คือ GPT-6.2 Astra ที่ $4.00 เพราะมันเขียน token น้อยกว่า Neon ($6.44) หรือ Fable 5.2 ($26.54) มาก
รุ่นไหนทำคะแนนได้สูงสุด? Claude Fable 5.2 นำทั้ง Artificial Analysis Intelligence Index (65) และ Vals Index (71.31%) ณ วันที่ 18-19 พฤศจิกายน 2026
มีรุ่นไหนมี free API tier หรือไม่? ไม่มี Google ไม่มี free tier สำหรับ Neon ส่วน Astra และ Fable 5.2 เป็นโมเดล API แบบเสียเงิน ผู้สมัครสมาชิก Google AI Pro และ Ultra ใช้ Neon ได้ในแอป Gemini และ Antigravity ดูคู่มือ Gemini 4 Neon ฟรีของเราสำหรับตัวเลือกที่ไม่มีค่าใช้จ่าย
ใช้มากกว่าหนึ่งรุ่นใน agent เดียวกันได้ไหม? ได้ ส่งขั้นตอนปกติไปที่ Neon และส่งงานที่มันล้มเหลวไปให้ Fable 5.2 หรือ Astra ทดสอบแต่ละเส้นทางก่อน: จำนวน token ต่อ task ต่างกันเกิน 4 เท่าระหว่างรุ่น