
ระดับการคิดของ Gemini 4 Neon มีสี่ระดับให้คุณเลือกกำหนดว่าต้องการให้โมเดลใช้เหตุผลหนักแค่ไหนก่อนจะตอบ: low, medium, high และ xhigh โดย Neon ตั้งค่าเริ่มต้นเป็น high Google แนะนำให้คงไว้ที่ high สำหรับงานซับซ้อนส่วนใหญ่ และเปลี่ยนไปใช้ xhigh เฉพาะเมื่อ high ให้ผลไม่ดีพอบนปัญหาที่ยากและมีหลายขั้นตอน เพราะ xhigh ใช้โทเค็นมากกว่าและใช้เวลานานกว่า
ระดับการคิดของ Gemini 4 Neon คืออะไร?
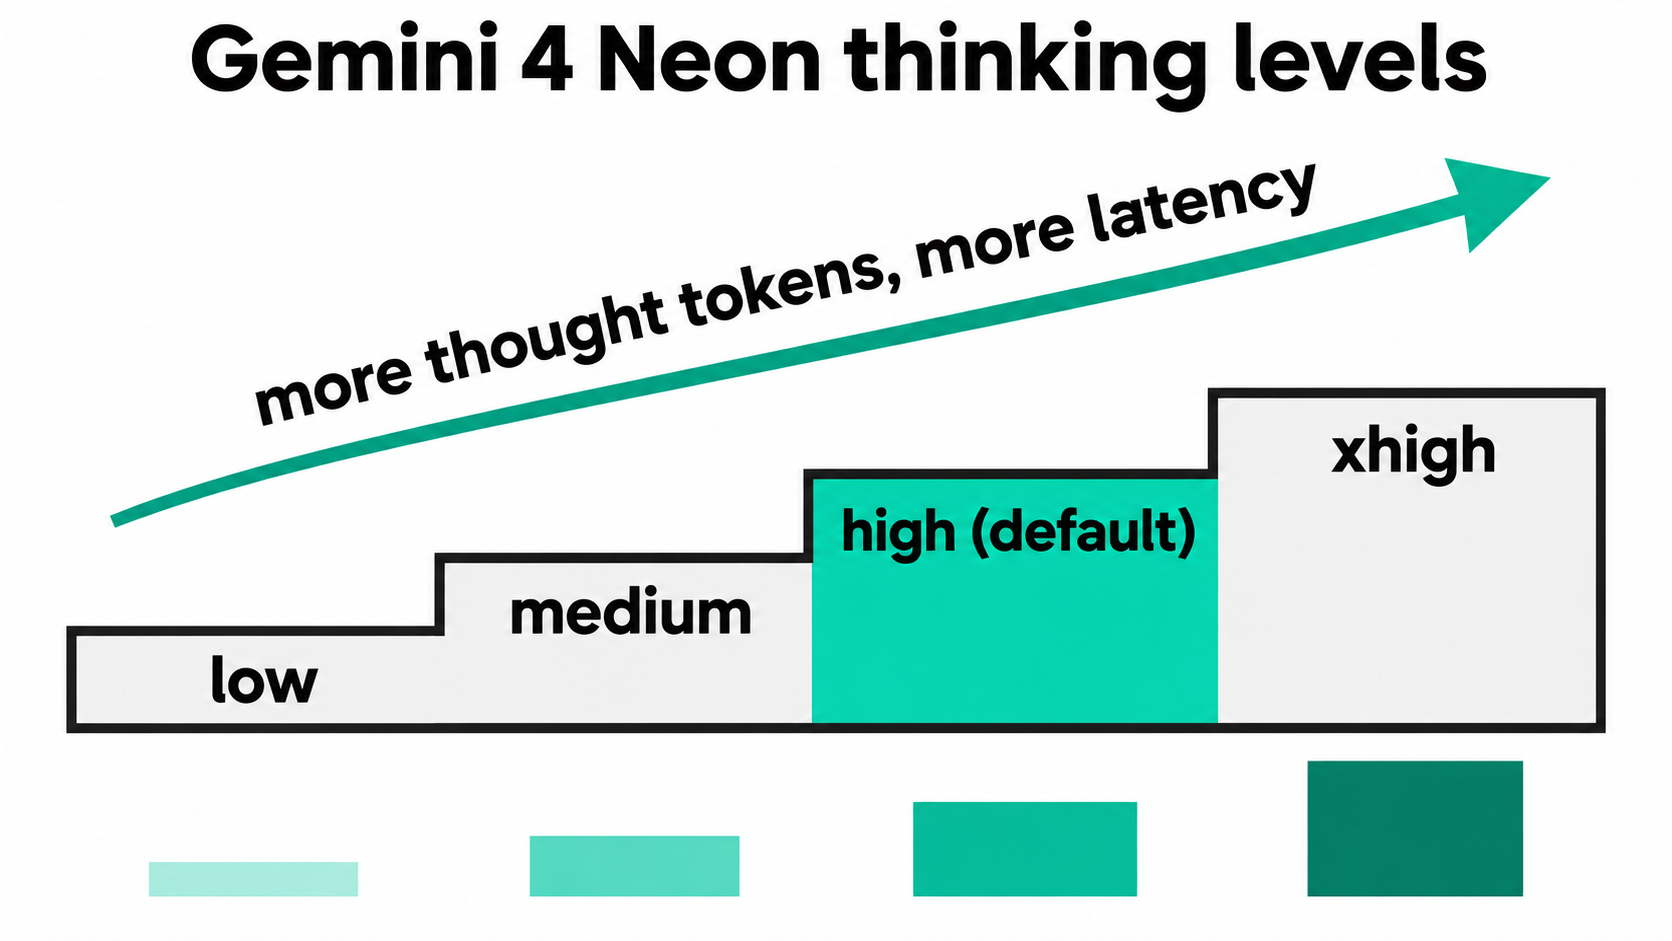
ระดับการคิดคือค่าของพารามิเตอร์ thinking_level ที่กำหนดว่า gemini-4-neon จะใช้การให้เหตุผลภายในมากแค่ไหนก่อนเขียนคำตอบ Neon รองรับสี่ระดับ: low, medium, high (ค่าเริ่มต้น) และ xhigh ระดับที่สูงขึ้นจะใช้ thought token มากขึ้นและเพิ่มเวลาตอบสนอง ระดับที่ต่ำลงจะตอบเร็วกว่าและมีค่าใช้จ่ายน้อยกว่า
นี่คือคำอธิบายของแต่ละระดับสำหรับ Neon จาก คู่มือการคิดของ Google:
thinking_level |
การใช้โทเค็น | การใช้งานที่ Google แนะนำ |
|---|---|---|
low |
ใช้โทเค็นน้อยที่สุด เวลาตอบสนองต่ำที่สุด | แชทเร็ว ประมวลผลปริมาณมาก ยังทำงานแบบ agentic ได้ |
medium |
ใช้โทเค็นน้อยลง ตอบสนองเร็วขึ้น | เขียนโค้ดแบบอินเทอร์แอกทีฟ, prototyping UI แบบสด, การเรียกเครื่องมือที่ไวต่อเวลา |
high (ค่าเริ่มต้น) |
ความฉลาดและความเร็วสมดุลกัน | เขียนโค้ดซับซ้อน, การทำงานแบบ agentic, การเรียกเครื่องมือ, งานความรู้แบบมัลติโมดัล |
xhigh |
ใช้โทเค็นมากที่สุด ให้เหตุผลลึกที่สุด | งานวิศวกรรมหลายขั้นตอนที่ยาก, ปัญหาเชิงวิเคราะห์และวิทยาศาสตร์ที่ high ให้ผลไม่พอ |
มีสองค่าที่คุณอาจคาดว่าจะมีแต่กลับไม่มี Neon ปฏิเสธ minimal ด้วยข้อผิดพลาด ดังนั้นโค้ดที่คัดลอกมาจากแอป Gemini 3 Flash จะพังถ้าส่งค่านั้น และค่า thinkingBudget แบบนับโทเค็นแบบเก่าถูกเลิกใช้บน Gemini 4: ถ้าส่งมาเดี่ยวๆ จะถูกแมปไปยังระดับที่ใกล้ที่สุดพร้อมคำเตือน แต่ถ้าส่งพร้อมกับ thinkingLevel จะได้ผลลัพธ์เป็น 400
ค่าเริ่มต้นของ Neon เทียบกับโมเดล Gemini 4 อื่นๆ เป็นอย่างไร?
Neon เริ่มต้นที่ระดับสูงกว่าโมเดลพี่น้องที่ใหญ่กว่า ตามบันทึกการเปิดตัว Gemini 4 Neon ทั้ง Neon และ Hydrogen ตั้งค่าเริ่มต้นเป็น high และรองรับ xhigh ขณะที่ Carbon และ Argon ตั้งค่าเริ่มต้นเป็น medium และรองรับสูงสุดแค่ high
| โมเดล | ระดับเริ่มต้น | ระดับที่รองรับ |
|---|---|---|
gemini-4-neon |
high |
low, medium, high, xhigh |
gemini-4-hydrogen |
high |
low, medium, high, xhigh |
gemini-4-carbon |
medium |
low, medium, high |
gemini-4-argon |
medium |
low, medium, high |
เรื่องนี้สำคัญเมื่อคุณสลับโมเดล ถ้าย้ายงานจาก Carbon ไปยัง Neon โดยไม่ตั้งค่า thinking_level ทุกคำขอจะเปลี่ยนจากการให้เหตุผลแบบ medium เป็น high ซึ่งจะเปลี่ยนจำนวนโทเค็นของคุณ ถ้าคุณกำลังพิจารณาโมเดลที่ใหญ่กว่า บทความเปรียบเทียบ Gemini 4 Carbon vs Argonของเราครอบคลุมความแตกต่างนั้นไว้แล้ว
จะตั้งค่า thinking_level ใน Gemini API ได้อย่างไร?
Neon ทำงานบนแพ็กเกจแบบชำระเงินของทั้ง Interactions API และ generateContent ชื่อฟิลด์แตกต่างกันระหว่างสองตัว
Interactions API: ใส่ thinking_level ไว้ใน generation_config
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent: ใช้ thinkingLevel ภายใน generationConfig.thinkingConfig
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
ใน Python SDK การเรียกผ่าน Interactions ใช้ generation_config={"thinking_level": "high"} และการเรียกผ่าน generateContent ใช้ thinking_config=types.ThinkingConfig(thinking_level="low") อย่าใส่ temperature, top_p และ top_k: Google ระบุว่า Neon จะไม่สนใจค่าที่อยู่ในช่วงที่กำหนดและปฏิเสธค่าที่นอกช่วงด้วย 400 สำหรับคำแนะนำการส่งคำขอครั้งแรกแบบครบถ้วนบนการออกแบบ API เดียวกัน ดูคู่มือ Gemini 4 Hydrogen APIของเรา
เมื่อไหร่ควรใช้ high vs xhigh?
ใช้ high เป็นค่าเริ่มต้น และเลื่อนงานไปเป็น xhigh เฉพาะหลังจากที่ high ไม่ผ่านเกณฑ์คุณภาพของคุณบนงานนั้น โพสต์เปิดตัวของ Google อธิบาย xhigh ว่าเป็น "การให้เหตุผลที่ลึกขึ้นและหลายขั้นตอนสำหรับงานวิศวกรรม งานวิเคราะห์ และงานวิทยาศาสตร์ที่ยากที่สุด"
เลือก xhigh เมื่อ:
- งานมีหลายขั้นตอนที่ขึ้นต่อกัน และความผิดพลาดตั้งแต่เนิ่นๆ จะทำให้ผลลัพธ์เสียหาย เช่น การ refactor หลายไฟล์หรือการตรวจสอบ concurrency
highให้คำตอบที่มั่นใจแต่ผิด บนชุดทดสอบของคุณ ไม่ใช่แค่ช้ากว่า- เวลาในการตอบสนองไม่สำคัญมากนัก เช่น งานเบื้องหลัง การรีวิวข้ามคืน หรือการวิเคราะห์แบบแบตช์
- คำตอบที่ผิดมีต้นทุนสูงกว่าโทเค็น เช่น แพตช์ด้านความปลอดภัยหรือการคำนวณทางการเงิน
คงไว้ที่ high (หรือลดต่ำลง) เมื่อ:
- พรอมต์เป็นการดึงข้อมูลหรือจัดรูปแบบ Google เตือนว่า
xhigh"อาจทำให้คิดมากเกินไปหรือใช้max_output_tokensหมดบนพรอมต์ที่ง่ายกว่า เช่น การดึงข้อความหรือ JSON" - มีผู้ใช้กำลังรออยู่ แชท autocomplete และการเรียกเครื่องมือแบบสดเหมาะกับ
mediumหรือlow - คุณต้องรันปริมาณมาก ทุก thought token ที่เพิ่มขึ้นจะถูกคิดเงิน และความแตกต่างจะทวีคูณตามจำนวนคำขอ
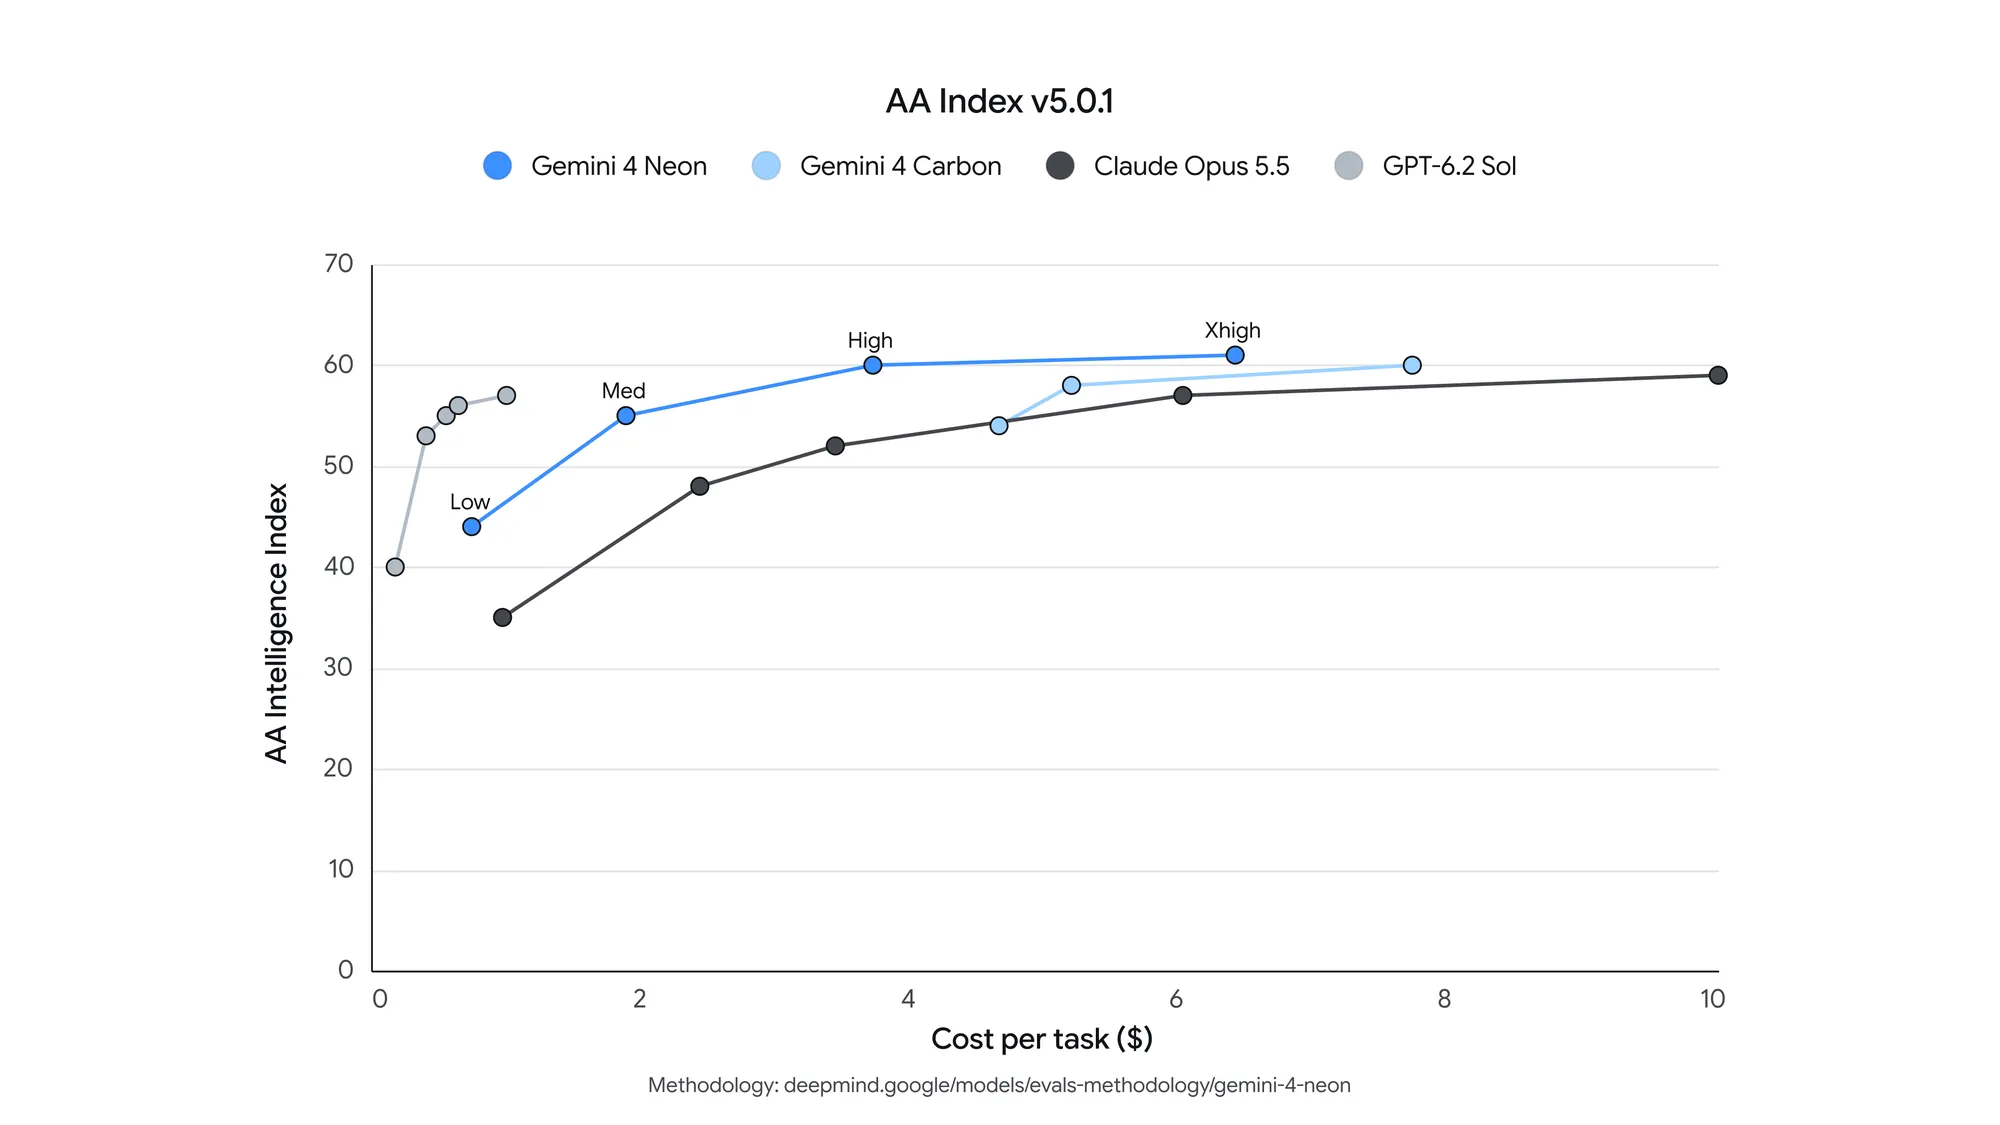
ตัวเลข benchmark ของ Google สนับสนุนการแบ่งแบบนี้ ในประกาศเปิดตัว Neon ที่ xhigh ได้คะแนน 61 บน Artificial Analysis Intelligence Index จัดเป็นอันดับสาม ที่ค่าเริ่มต้น high Google รายงานว่าต้นทุนต่อ task ต่ำกว่า Carbon 32% นี่คือตัวเลขของ Google ไม่ใช่การทดสอบของเรา แต่แสดงให้เห็นการแลกเปลี่ยน: xhigh ให้คะแนนสูงสุดของ Neon ส่วน high ให้ประสิทธิภาพด้านต้นทุน
แต่ละระดับการคิดมีค่าใช้จ่ายเท่าไหร่?
ทุกระดับมีราคาต่อโทเค็นเท่ากัน สิ่งที่เปลี่ยนคือจำนวนโทเค็นที่คุณจ่าย Neon มีราคา $3.00 ต่อ 1M input token และ $15.00 ต่อ 1M output token และหน้าราคาของ Google ระบุว่าอัตราค่า output รวม thinking token ไว้ด้วย Input ที่แคชแล้วลดเหลือ $0.15 ต่อ 1M ผ่าน implicit caching (Neon ไม่รองรับ explicit caching) โมเดลนี้ไม่มี free tier
ดังนั้นต้นทุนของแต่ละระดับคือ thought token ที่เพิ่มขึ้น คูณด้วย $15 ต่อล้าน นี่คือการคำนวณสำหรับหนึ่งคำขอที่มี input 2,000 token และคำตอบที่มองเห็นได้ 800 token จำนวน thought token เป็นค่าสมมติที่เลือกมาเพื่อแสดงการคำนวณ ไม่ใช่ค่าที่วัดได้จริง:
| Thought token (สมมติ) | ต้นทุน input | ต้นทุน output + thinking | รวมต่อคำขอ | ต่อ 10,000 คำขอ |
|---|---|---|---|---|
| 500 | $0.006 | $0.0195 | $0.0255 | $255 |
| 2,000 | $0.006 | $0.042 | $0.048 | $480 |
| 8,000 | $0.006 | $0.132 | $0.138 | $1,380 |
ค่า thinking กลายเป็นส่วนใหญ่ของบิลอย่างรวดเร็ว ที่ 8,000 thought token การให้เหตุผลคิดเป็น 87% ของต้นทุนคำขอนั้น นี่คือเหตุผลที่คำแนะนำของ Google เองคือให้รันการประเมินในทุกระดับทั้งสี่และ "เลือกระดับ thinking_level ต่ำสุดที่ผ่านเกณฑ์คุณภาพของคุณ" คู่มือระดับการคิดของ Gemini 3.8 Flashของเราครอบคลุมการแลกเปลี่ยนแบบเดียวกันบนโมเดลที่ถูกกว่า หากคุณต้องการเปรียบเทียบ
จะวัดโทเค็นและเวลาในการตอบสนองของแต่ละระดับได้อย่างไร?
รันพรอมต์เดียวกันในแต่ละระดับแล้วอ่านค่า usage block ใน Interactions API อ็อบเจกต์ usage ของการตอบสนองรายงาน total_input_tokens, total_output_tokens และ total_thought_tokens แยกกัน ใน generateContent thought token จะปรากฏเป็น usageMetadata.thoughtsTokenCount
ลูปนี้จะส่งพรอมต์เดียวในทุกระดับทั้งสี่และพิมพ์ thought token พร้อมเวลาที่ใช้จริง:
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
รันบน 10 ถึง 20 พรอมต์จากงานจริงของคุณ พรอมต์เดียวบอกอะไรได้น้อย แต่ชุดพรอมต์จะแสดงให้เห็นว่า high และ xhigh เริ่มเห็นต่างกันในเรื่องคุณภาพตรงไหน
ตั้ง timeout ของ HTTP client ให้สูงไว้ระหว่างทดสอบ บันทึกการย้ายระบบของ Google ระบุว่าพรอมต์ยากอาจใช้เวลาหลายนาทีและแนะนำให้ตั้ง timeout อย่างน้อย 15 นาที หรือใช้การทำงานแบบเบื้องหลัง
ทำไม xhigh บางครั้งส่งคำตอบว่างกลับมา?
max_output_tokens จำกัดทั้งการคิดและ output ที่มองเห็นได้รวมกัน ถ้า Neon ใช้ Reasoning งบประมาณทั้งหมด การโต้ตอบจะหยุดด้วยสถานะ incomplete และส่งคำตอบที่ถูกตัดทอนหรือว่างเปล่ากลับมา และคุณยังต้องจ่ายค่า thought token ที่มันสร้างขึ้น
กฎสามข้อจากเอกสารของ Google เพื่อหลีกเลี่ยงปัญหานี้:
- ลบขีดจำกัดต่ำแบบเก่าออก ถ้าแอปของคุณฮาร์ดโค้ดค่าเช่น 8,192 ให้เพิ่มเป็น 65,536 ซึ่งเป็นเพดานเริ่มต้นแบบซิงโครนัส
- ลดระดับ ไม่ใช่ลดเพดาน หากต้องการลดต้นทุนหรือเวลาในการตอบสนอง ให้ลดไปที่
mediumหรือlowแทนที่จะลดmax_output_tokens - ใช้โหมดเบื้องหลังสำหรับงานยาว สำหรับคำตอบที่เกิน 65,536 token ให้ตั้ง
backgroundเป็นtrueและmax_output_tokensสูงสุดถึง 1,048,576 ลบด้วย input ของคุณ Input, thinking และ output ใช้หน้าต่าง 1M token ร่วมกัน คู่มือ output ยาวของ Gemini 4 Argonของเราอธิบายรูปแบบการ polling ไว้
ให้ coding agent ของคุณ benchmark ทั้งสี่ระดับด้วย Apidog CLI
การรันลูปนั้นด้วยมือซ้ำๆ น่าเบื่อ แทนที่จะทำเอง ให้ coding agent ของคุณ (Claude Code, Codex, Cursor) สร้างการทดสอบที่ใช้ซ้ำได้หนึ่งชุดด้วย Apidog CLI แล้วรันใหม่ในแต่ละระดับเมื่อใดก็ตามที่คุณต้องการตัวเลขใหม่
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้พรอมต์กับ agent หนึ่งครั้ง:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
Agent จะอ่าน schema ของแต่ละ payload ตรวจสอบ JSON เขียนทรัพยากร และวนรัน:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
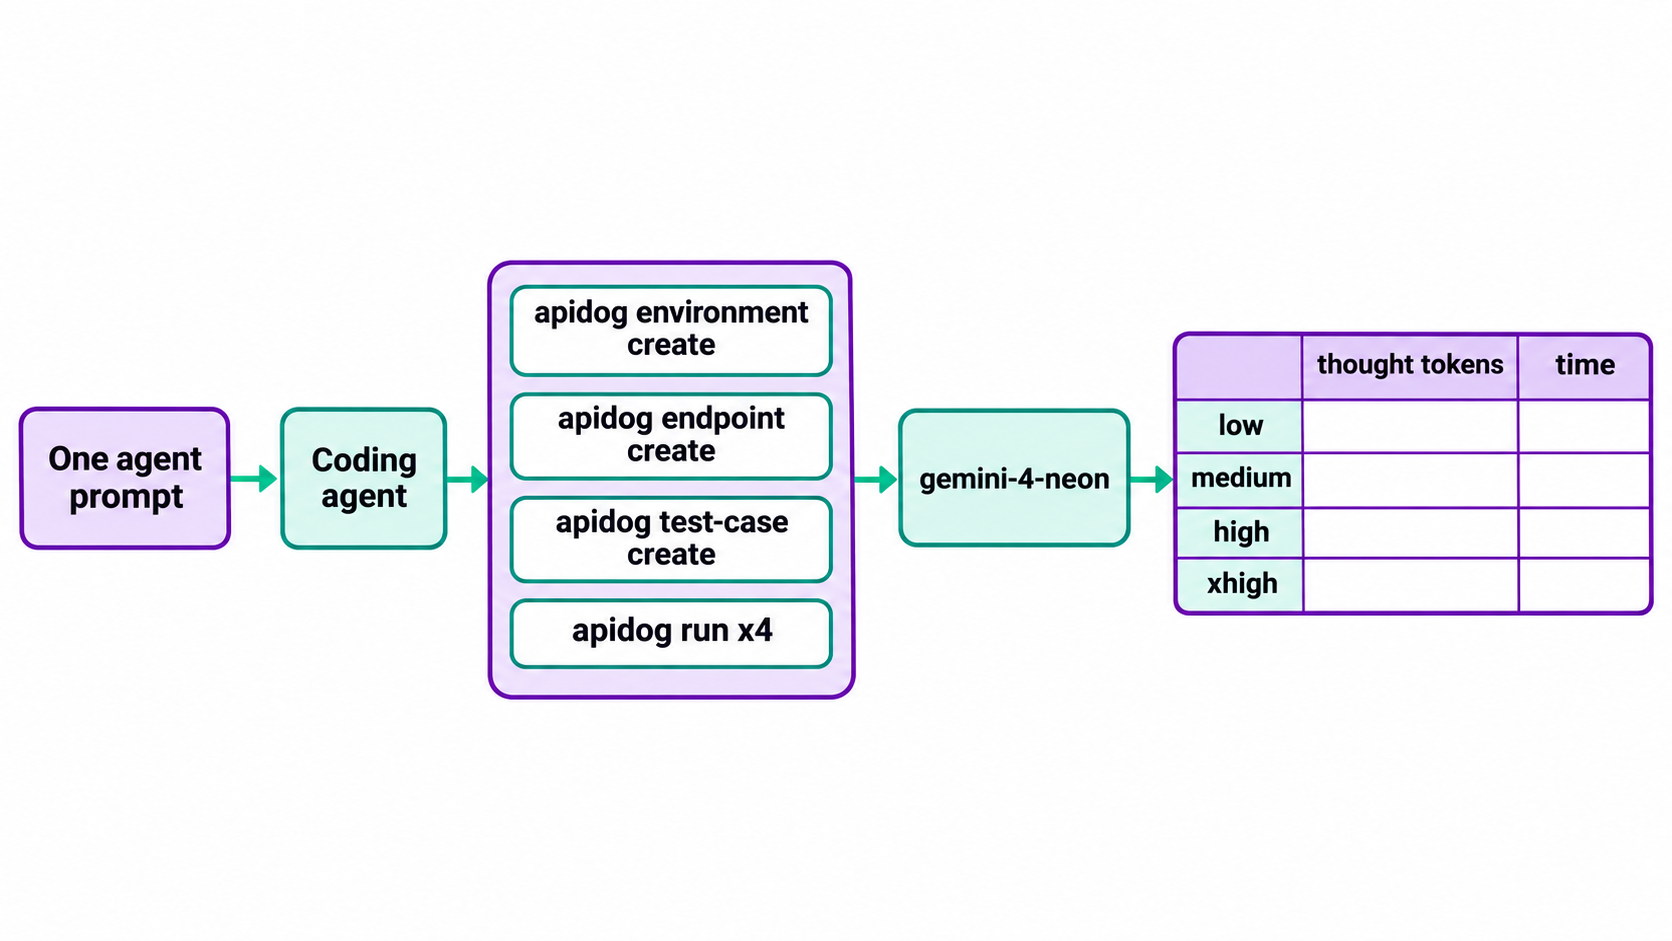
การยืนยัน status is "completed" จะจับกับดัก incomplete จากหัวข้อก่อนหน้า ดังนั้นระดับที่ใช้งบประมาณหมดจะล้มเหลวอย่างชัดเจนแทนที่จะส่งสตริงว่างกลับมา เปลี่ยน -r cli,json เป็น -r junit และการรันเดียวกันจะเข้าไปใน CI ได้ คู่มือ CI/CD ของ Apidog CLIแสดง pipeline และ Apidog CLI ใน Claude Codeครอบคลุมการตั้งค่า agent แพ็กเกจ Free ของ Apidog รองรับสูงสุด 4 ผู้ใช้
คำถามที่พบบ่อย
ระดับการคิดเริ่มต้นของ Gemini 4 Neon คืออะไร? high คุณไม่จำเป็นต้องส่ง thinking_level เพื่อให้ได้ค่านี้ Carbon และ Argon ตั้งค่าเริ่มต้นเป็น medium ดังนั้นให้ตั้งระดับอย่างชัดเจนเมื่อคุณย้ายจากโมเดลเหล่านั้น
Gemini 4 Neon รองรับ minimal thinking หรือไม่? ไม่ Neon รองรับ low, medium, high และ xhigh และปฏิเสธ minimal ด้วยข้อผิดพลาด ใช้ low สำหรับคำตอบที่เร็วและถูกที่สุด
thinking token ถูกคิดเงินบน Gemini 4 Neon หรือไม่? ใช่ Thought token คิดในอัตรา output $15.00 ต่อ 1M Google นับทุกโทเค็นที่โมเดลประมวลผล รวมถึง thinking token
ยังใช้ thinkingBudget กับ Gemini 4 Neon ได้หรือไม่? ถูกเลิกใช้บนโมเดล Gemini 4 แล้ว ถ้าส่งมาเดี่ยวๆ จะถูกแมปไปยัง thinkingLevel ที่ใกล้ที่สุดและส่งคำเตือนกลับมา ถ้าส่งพร้อมกับ thinkingLevel คำขอจะล้มเหลวด้วย 400
xhigh แม่นยำกว่า high เสมอหรือไม่? ไม่เสมอ Google ระบุว่า xhigh อาจคิดมากเกินไปบนพรอมต์ง่ายๆ เช่น การดึงข้อความหรือ JSON และอาจใช้ max_output_tokens หมด ทดสอบทั้งสองบนพรอมต์ของคุณเองและเก็บระดับต่ำสุดที่ผ่าน
ใช้ระดับการคิดของ Gemini 4 Neon ฟรีได้หรือไม่? ไม่ได้ Gemini 4 Neon ไม่มีให้ใช้บน free tier ของ Gemini API ใน Google AI Studio และ Google Antigravity มันผูกกับแพ็กเกจ Google AI Pro และ Ultra แบบชำระเงิน