
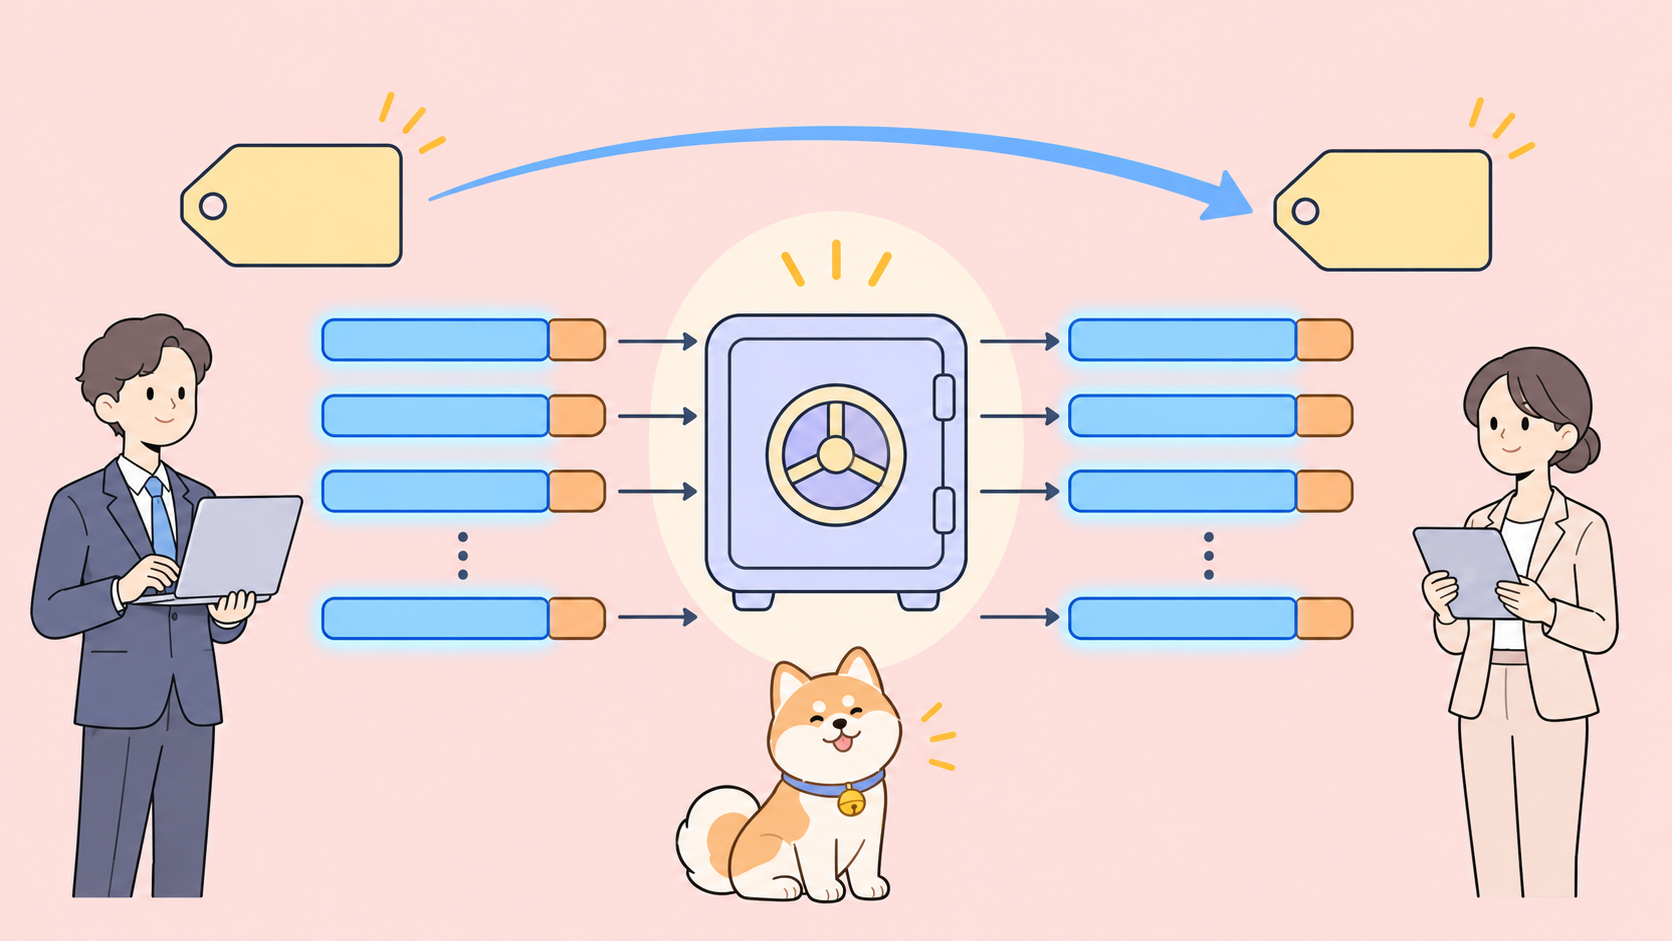
Gemini 4 Neon ใช้การแคช context แบบ implicit เท่านั้น คุณไม่ต้องสร้างแคชเอง Google จะแคช prompt prefix ที่ซ้ำกันซึ่งมีความยาวอย่างน้อย 4,096 tokens โดยอัตโนมัติ และคิดค่าบริการ input tokens ที่แคชแล้วที่ $0.15 ต่อ 1M แทนที่จะเป็น $3 ซึ่งเท่ากับส่วนลด 95% วิธีได้ส่วนลดนี้คือการวางส่วนที่คงที่ของทุก request ไว้ด้านหน้าและให้เหมือนกันแบบ byte-for-byte จากนั้นยืนยันผลแคชผ่าน usage.total_cached_tokens
เนื้อหาด้านล่างนี้ประกอบด้วย: การจัดวาง prompt เพื่อให้ติดแคช กฎสำหรับ agent loop วิธีอ่านค่าจำนวน cached tokens และการทดสอบที่ coding agent ของคุณรันให้
การแคช context ของ Gemini 4 Neon ทำงานอย่างไร?
การแคช context ของ Gemini 4 Neon เป็นการแคช prefix แบบอัตโนมัติ เมื่อ request ใหม่เริ่มต้นด้วย tokens ชุดเดียวกันกับ request ก่อนหน้า และ prefix ที่ซ้ำกันนั้นมีความยาวอย่างน้อย 4,096 tokens Google จะให้บริการส่วนที่ซ้ำจากแคช และคิดค่าบริการตามอัตรา cached ไม่มีอะไรต้องเปิดใช้งาน ไม่มี cache object, TTL หรือค่าธรรมเนียมการจัดเก็บให้ต้องจัดการ
Google เปิดตัว Neon เมื่อวันที่ 18 พฤศจิกายน 2026 (model ID gemini-4-neon ดูโพสต์เปิดตัว) ข้อมูลเกี่ยวกับการแคชของมันสรุปได้ในตารางเดียว:
| รายการ | Gemini 4 Neon |
|---|---|
| โหมดการแคช | Implicit เท่านั้น เปิดใช้โดยค่าเริ่มต้น |
Explicit caching (cachedContents, caches.create) |
ไม่รองรับ |
| Prefix ขั้นต่ำสำหรับ cache hit | 4,096 tokens |
| Input มาตรฐาน | $3.00 ต่อ 1M tokens |
| Cached input (Standard) | $0.15 ต่อ 1M tokens |
| Cached input (Batch และ Flex) | $0.075 ต่อ 1M tokens |
| Cached input (Priority) | $0.27 ต่อ 1M tokens |
| ดูผลแคชได้ที่ | usage.total_cached_tokens |
| Free tier | ไม่มี มีเฉพาะ paid tier |
ส่วนลดอยู่ที่ 95% ในทุก tier: $0.15 คือ 5% ของ $3, $0.075 คือ 5% ของ $1.50 และ $0.27 คือ 5% ของ $5.40 Output tokens รวมถึง thinking tokens ยังคงอยู่ที่ $15 ต่อ 1M ใน Standard การแคชมีผลกับ input เท่านั้น
Implicit caching กับ explicit caching ของ Gemini 4 Neon
หากคุณเคยใช้ explicit caching บน Gemini 2.5 หรือ 3 นี่คือการเปลี่ยนแปลงที่จะทำให้โค้ดพัง บันทึกการย้ายมาใช้ Neon ของ Google ระบุชัดเจนว่า Gemini 4 Neon “ไม่รองรับ explicit caching (cachedContents และ caches.create)” และคุณควร “ลบฟิลด์ cached_content ออกจาก requests”
เอกสารเกี่ยวกับการแคชเพิ่มเติมว่า Interactions API รองรับเฉพาะ implicit caching และ explicit caching ไม่พร้อมใช้งานสำหรับโมเดล Gemini 4 ทุกรุ่น ส่วน explicit cache ยังคงทำงานได้บนโมเดล Gemini 3 และ 2.5 ที่รองรับผ่าน generateContent
สิ่งที่หมายถึงสำหรับการย้ายระบบ:
- ลบโค้ดที่เรียก
caches.createและเก็บชื่อแคช - ลบ
cached_contentออกจาก request body ทุกตัว - หยุดจ่ายค่าจัดเก็บแคชที่คุณไม่ได้ใช้แล้ว
- จัดโครงสร้าง prompt ใหม่เพื่อให้เนื้อหาที่คุณเคยแคชแบบ explicit อยู่ตอนต้นสุดของแต่ละ request
คุณไม่สามารถ pin เอกสารหรือเลือก TTL ได้ และการติดแคชก็ไม่ได้รับประกัน แต่คุณสามารถเพิ่มโอกาสได้อย่างมาก
วิธีจัดโครงสร้าง prompt ให้ติดแคชของ Gemini 4 Neon
การติดแคชต้องมี prefix ที่ยาว เหมือนกัน และถูกส่งซ้ำในช่วงเวลาใกล้กัน เอกสารของ Google ให้คำแนะนำสองข้อ: วางเนื้อหาที่มีขนาดใหญ่และใช้ร่วมกันไว้ตอนต้นของ prompt และส่ง request ที่มี prefix คล้ายกันภายในระยะเวลาอันสั้น
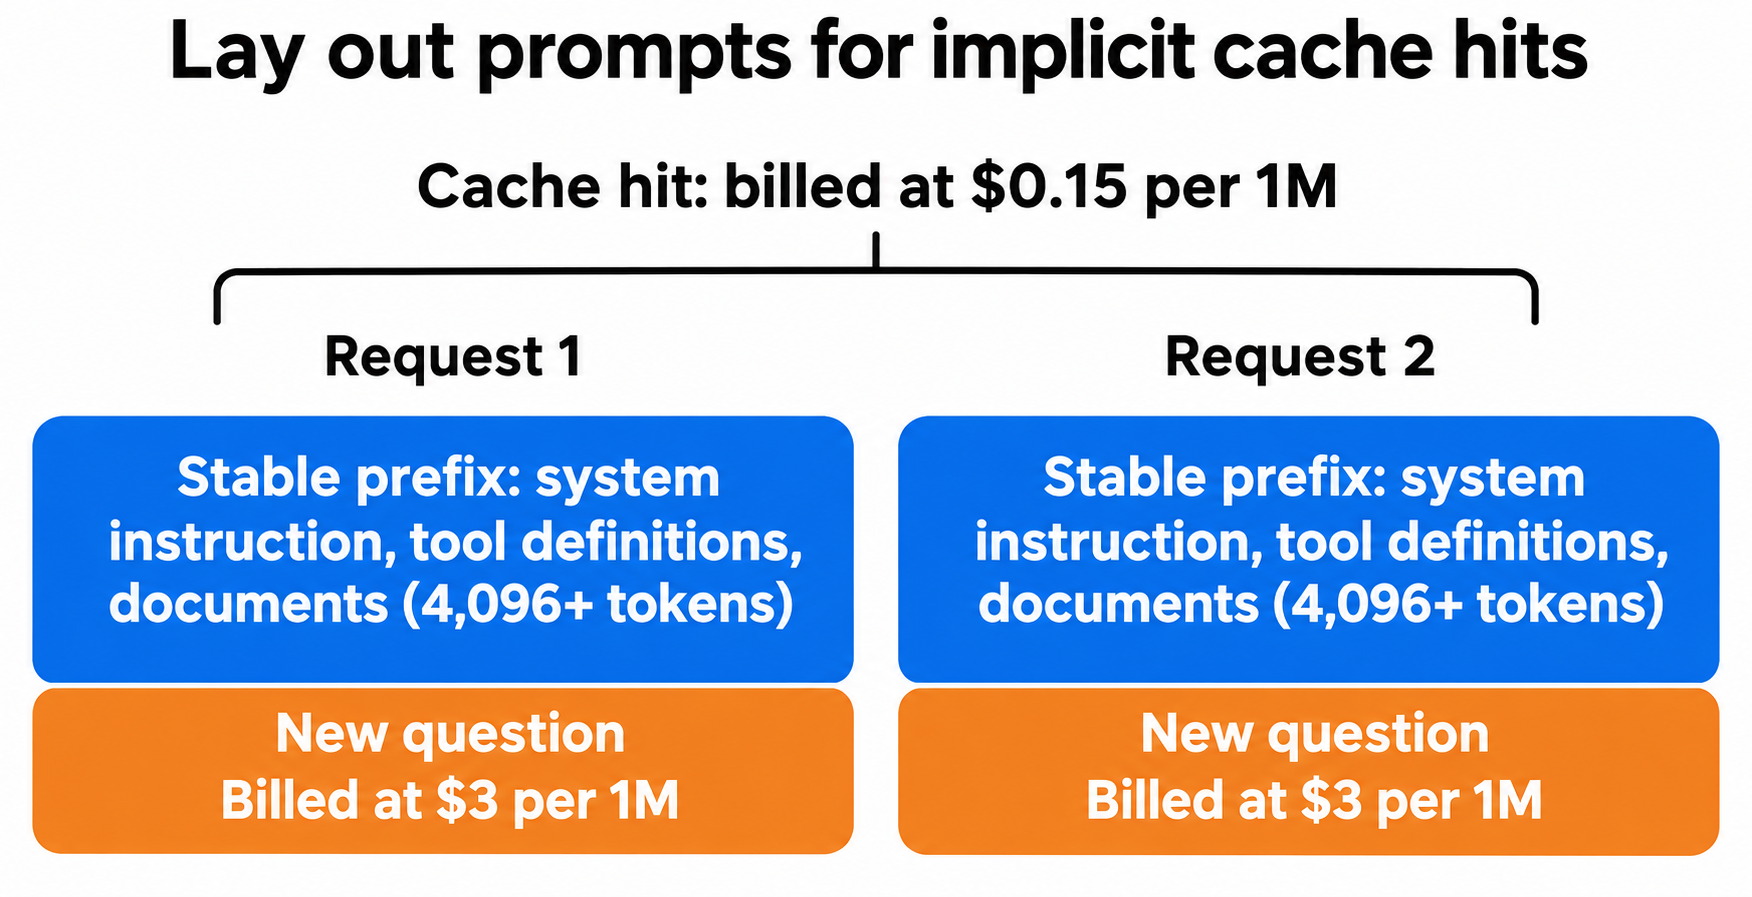
จัดเรียงทุก request ตามลำดับนี้:
- System instruction. ข้อความคงที่ ไม่มี timestamps, ชื่อผู้ใช้ หรือ request IDs
- การประกาศ tools และ functions. รายการเดิม ลำดับเดิม คำอธิบายเดิมทุกครั้ง
- เอกสารที่ใช้ร่วมกัน. Codebase, สัญญา, API spec, ไฟล์นโยบายที่ยาว
- ส่วนที่เปลี่ยนแปลง. คำถามของผู้ใช้, ผลลัพธ์ tool ล่าสุด, วันที่ปัจจุบัน
สาเหตุที่พบบ่อยที่สุดที่ทำให้พลาดแคชคือค่า dynamic เล็ก ๆ ที่อยู่ใกล้ตอนต้น บรรทัดอย่าง Current time: 2026-11-19T09:14:02Z ใน system instruction จะเปลี่ยน prefix ในทุกการเรียก ทำให้ทุกอย่างหลังจากนั้นไม่สามารถจับคู่ได้ ย้ายมันไปไว้ตอนท้าย หลังเอกสาร
ตัวทำลาย prefix อื่น ๆ: รายการ tools ที่สร้างตามลำดับสุ่ม, เอกสารที่ serialize ใหม่ด้วยช่องว่างที่ต่างกัน และ chunks ที่ดึงมาแล้วส่งกลับตามลำดับที่ต่างกัน
รักษา prefix ให้เกิน 4,096 tokens โดย system prompt ที่ยาว 2,000 tokens เพียงอย่างเดียวจะไม่ผ่านเกณฑ์ แต่ถ้าคุณส่งเอกสารยาวที่ใช้ร่วมกันพร้อมกันไป prefix รวมก็จะผ่าน
เมื่อใช้ Interactions API ให้ส่ง instruction ที่คงที่ผ่าน system_instruction และวางเอกสารไว้ต้นสุดของ input:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

SYSTEM = open("review_rules.md").read()      # fixed text
CODEBASE = open("repo_snapshot.txt").read()  # ~200K tokens, unchanged

def ask(question: str):
    interaction = client.interactions.create(
        model="gemini-4-neon",
        system_instruction=SYSTEM,
        input=CODEBASE + "\n\nQuestion: " + question,
    )
    print("cached tokens:", interaction.usage.total_cached_tokens)
    return interaction

ask("Where do we validate JWT expiry?")
ask("Which handlers skip input validation?")
การเรียกครั้งแรกจะเติมแคช หากการเรียกครั้งที่สองแสดงค่า cached tokens เป็น 0 แปลว่ามีบางอย่างใน prefix เปลี่ยนไป
Implicit caching ทำงานได้ในทั้งสองโหมดการสนทนา การเรียกแบบ stateless เช่นตัวอย่างด้านบนมีสิทธิ์ใช้งาน และ session แบบ stateful ที่ต่อกันด้วย previous_interaction_id ก็เช่นกัน สำหรับรูปแบบ request แบบเต็ม ดูคู่มือ Gemini 4 Neon API ของเรา
การทำงานของแคชใน agent loops: กฎ 2,050 tokens
Agent loops คือจุดที่การแคชให้ผลตอบแทนสูงสุด เพราะแต่ละ turn ต้องส่งประวัติทั้งหมดซ้ำ โมเดล Gemini 4 มีกฎเพิ่มเติมหนึ่งข้อที่คุณต้องรู้ จากเอกสารการแคชของ Google: “Gemini จะแคช request ก่อนหน้าทั้งหมดก็ต่อเมื่อ request ใหม่เพิ่ม tokens อย่างน้อย 2,050 tokens” ซึ่ง output ของโมเดล, thoughts และ function results ทั้งหมดนับรวมในยอดนี้
หาก turn หนึ่งเพิ่ม tokens น้อยกว่า 2,050 tokens Gemini จะประมวลผล 2,050 tokens สุดท้ายของ request ก่อนหน้าซ้ำตามอัตรา input มาตรฐาน ส่วนต้นของ prefix ยังอาจติดแคชได้ แต่ส่วนท้ายนั้นจะถูกคิดค่าที่ $3 ต่อ 1M
Google ระบุว่า turn ของ agent ส่วนใหญ่เกินเกณฑ์นี้ ปัญหาจะเกิดใน loops ที่มีการสื่อสารถี่แต่ทำงานเล็ก ๆ เช่น status check ที่คืนค่า {"ok": true} ค่าใช้จ่ายต่อ turn นั้นน้อย (2,050 tokens ที่ $3 ต่อ 1M คือประมาณ $0.006) แต่จะสะสมเพิ่มขึ้นในหลายพัน turn สั้น ๆ หาก loop ของคุณเรียกเล็ก ๆ หลายครั้ง ให้รวมผลลัพธ์ของ tools เล็ก ๆ เป็น turn เดียวหาก logic ของคุณอนุญาต
การแคช context ของ Gemini 4 Neon ช่วยประหยัดได้เท่าไร?
สมมติว่ามีผู้ช่วยตรวจสอบโค้ดที่ตอบคำถาม 20 ข้อเกี่ยวกับ codebase ขนาด 200,000 tokens แต่ละคำถามเพิ่ม 3,000 tokens และได้คำตอบ 1,000 tokens บน tier Standard
กรณีไม่ติดแคช แต่ละครั้งมีค่าใช้จ่าย:
- Input: 203,000 × $3 / 1M = $0.609
- Output: 1,000 × $15 / 1M = $0.015
- ต่อการเรียก: $0.624 รวม $12.48 สำหรับ 20 ครั้ง
กรณีติดแคชหลังจากการเรียกครั้งแรก การเรียกครั้งที่ 2 ถึง 20 มีค่าใช้จ่าย:
- Cached prefix: 200,000 × $0.15 / 1M = $0.030
- Input ใหม่: 3,000 × $3 / 1M = $0.009
- Output: $0.015
- ต่อการเรียก: $0.054
รวมการเรียกครั้งแรกที่ไม่ติดแคช $0.624 session ทั้งหมดมีค่าใช้จ่าย $1.65 ประหยัดได้ประมาณ 87%
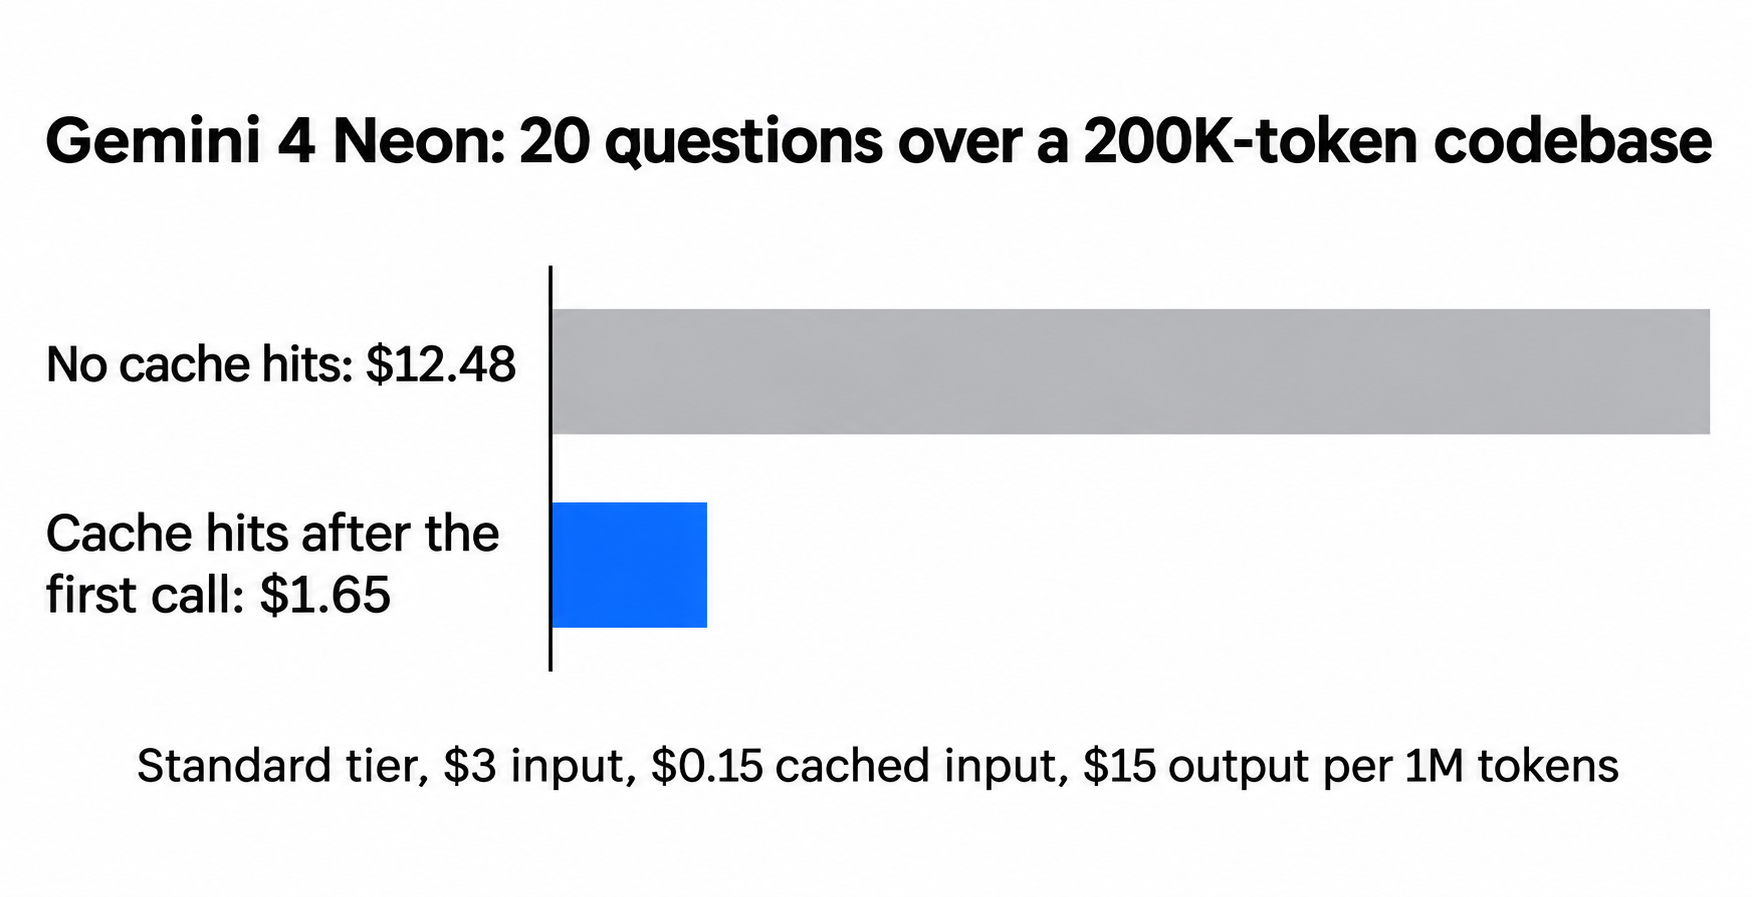
การประหยัดต่ำกว่า 95% เพราะ output และ input ใหม่ไม่ได้รับส่วนลด ยิ่ง shared prefix ใหญ่เมื่อเทียบกับส่วนอื่น ยิ่งเข้าใกล้ 95% ของ input มากขึ้น หากรันงานเดียวกันผ่าน Batch อัตรา cached จะลดลงอีกครึ่งหนึ่งเหลือ $0.075 สำหรับตารางราคาเต็มและค่าใช้จ่ายระดับ thinking ดูราคา Gemini 4 Neon
วิธีตรวจสอบ cached tokens ของ Gemini 4 Neon ใน response
อ่านค่า usage.total_cached_tokens จากทุก response Google ระบุว่าเป็นฟิลด์ที่แสดงจำนวน tokens ที่ติดแคช ทั้งใน Python และ JavaScript SDKs
ด้วย curl และ jq:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d @request.json | jq '.usage'
ในการคำนวณราคาของการเรียก ให้คิดค่า cached tokens ที่ $0.15 ต่อ 1M, input ที่เหลือที่ $3 และ output รวมถึง thinking ที่ $15 บันทึกจำนวน cached tokens ไว้ข้าง request ID ของคุณ หากค่าดรอปเหลือ 0 อย่างฉับพลันในทุก traffic มักหมายถึงการ deploy ได้เปลี่ยน prefix: เพิ่ม tool ใหม่, แก้ไขข้อความกฎ หรือ timestamp หลุดเข้ามาใน system instruction
ให้ coding agent ของคุณทดสอบ cache hits ด้วย Apidog CLI
Prefix มักพังระหว่างการ refactor ปกติ และไม่มีใครสังเกตเห็นจนกว่าใบแจ้งยอดจะมาถึง เปลี่ยนการตรวจสอบแคชให้เป็น API test ที่ coding agent ของคุณดูแลและ CI รันให้
Apidog CLI ช่วยให้ Claude Code, Codex, Cursor หรือ OpenCode สร้างและรัน API tests จาก terminal ได้ ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง agent ของคุณด้วย prompt เดียว:
In Apidog project <id>, create an environment for the Gemini API with a
GEMINI_API_KEY variable. Build a test scenario called "Neon cache hit" with two
steps that POST to /v1beta/interactions with model gemini-4-neon, using our
production system_instruction and the docs/context.md file as the start of
input, then two different questions. Assert HTTP 200 on both, and assert that
usage.total_cached_tokens on step 2 is greater than 4096. Run it and tell me
the cached token count.
Agent จะสร้าง environment และ scenario, ตรวจสอบ payload กับ schema ของ CLI และรัน:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog test-scenario create --project <id> --name "Neon cache hit"
apidog cli-schema get test-scenario-update
apidog cli-schema validate test-scenario-update --file scenario.json
apidog test-scenario update <scenarioId> --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
หากเดือนหน้ามีคนเพิ่ม timestamp ลงใน system prompt assertion ของ step 2 จะ fail ก่อนที่การเปลี่ยนแปลงจะถูกส่งขึ้น ใส่ apidog run -t <scenarioId> --project <id> -e <envId> -r junit ลงใน pipeline ของคุณพร้อมคู่มือ Apidog CLI CI/CD หรือเริ่มจากApidog CLI ใน Claude Code แต่ละการรันจะเรียก Neon จริงสองครั้ง จึงมีค่าใช้จ่ายไม่กี่เซ็นต์ต่อการรันตามอัตราข้างต้น แผน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน
สำหรับวิธีทำงานของ prefix caching ในผู้ให้บริการต่าง ๆ ดูprompt caching คืออะไร
คำถามที่พบบ่อย
Gemini 4 Neon รองรับ explicit context caching หรือไม่? ไม่ คู่มือ Neon ของ Google ระบุว่าไม่รองรับ cachedContents หรือ caches.create และคุณควรลบ cached_content ออกจาก requests Neon ใช้ implicit caching เท่านั้น ซึ่งเปิดใช้โดยค่าเริ่มต้น
ขนาด prompt ขั้นต่ำสำหรับ cache hit ของ Gemini 4 Neon คือเท่าไร? 4,096 tokens ของ shared prefix ซึ่งเท่ากับขั้นต่ำของ Gemini 4 Hydrogen, Argon และ Carbon ส่วน Gemini 2.5 Flash และ Pro ต้องการ 2,048
ส่วนลดการแคชของ Gemini 4 Neon มีขนาดเท่าไร? 95% สำหรับ cached input Standard ลดจาก $3 เหลือ $0.15 ต่อ 1M tokens, Batch และ Flex จาก $1.50 เหลือ $0.075 และ Priority จาก $5.40 เหลือ $0.27 Output และ thinking tokens ไม่ได้รับส่วนลด
ฉันสามารถบังคับให้ Gemini 4 Neon แคช prompt ได้หรือไม่? ไม่ได้ Implicit caching ไม่มีการตั้งค่าให้เปิด, ไม่มี TTL ให้เลือก และไม่รับประกันว่าจะติดแคช คุณสามารถเพิ่มโอกาสได้โดยรักษา prefix ที่ยาวและเหมือนกันไว้ตอนต้นของแต่ละ request และส่ง request ที่คล้ายกันในช่วงเวลาใกล้กัน
ฉันจะรู้ได้อย่างไรว่า request ของฉันติดแคช? ตรวจสอบ usage.total_cached_tokens ใน response ค่าที่มากกว่าศูนย์หมายความว่า input tokens จำนวนเท่านั้นถูกคิดค่าตามอัตรา cached
การแคชทำงานกับ previous_interaction_id หรือไม่? ทำงาน Google ระบุในเอกสารว่า implicit caching ทำงานได้ทั้งในการสนทนาแบบ stateful ที่ต่อกันด้วย previous_interaction_id และแบบ stateless ที่คุณส่งประวัติทั้งหมดเอง