
ผลทดสอบ Benchmark ของ Gemini 4 Neon ทำให้มันขึ้นเป็นอันดับ 1 บน Artificial Analysis Coding Agent Index (58.6) ทำได้ 65.2% บน Terminal-Bench 4.1 และเป็นอันดับ 2 บน Vals Index (70.9%) Google ยังระบุว่ามันมีต้นทุนต่อ task ต่ำกว่า Gemini 4 Carbon อยู่ 32% ที่ระดับ thinking high ซึ่งเป็นค่าเริ่มต้น แต่แถวผลลัพธ์ส่วนใหญ่รันที่ xhigh และบางส่วนรันบน harness ของ Google เอง
รายละเอียดหลังสุดนี่แหละคือประเด็นของโพสต์นี้ ภาพรวม Gemini 4 Neon ของเราครอบคลุมสเปกและราคาไปแล้ว ที่นี่คุณจะได้คะแนนที่เผยแพร่ทั้งหมด ใครเป็นคนวัด วัดที่ระดับ thinking ไหน และวิธีแปลง "ต้นทุนต่อ task" ให้เป็นตัวเลขที่เอาไปเทียบกับบิลจริงของคุณได้
ผลทดสอบ Benchmark ของ Gemini 4 Neon แบบสรุป
Gemini 4 Neon คือโมเดลระดับกลางในตระกูล Gemini 4 ของ Google เปิดตัวเมื่อวันที่ 18 พฤศจิกายน 2026 ราคา $3 ต่อล้าน input token และ $15 ต่อล้าน output token ผลลัพธ์ที่เผยแพร่แล้วแข็งแกร่งที่สุดอยู่ในงาน agentic coding และงาน knowledge work ซึ่งมันติดอันดับ 1 หรือ 2 บน leaderboard อิสระถึง 4 แห่ง
นี่คือแถวพาดหัวจาก โพสต์เปิดตัวของ Google:
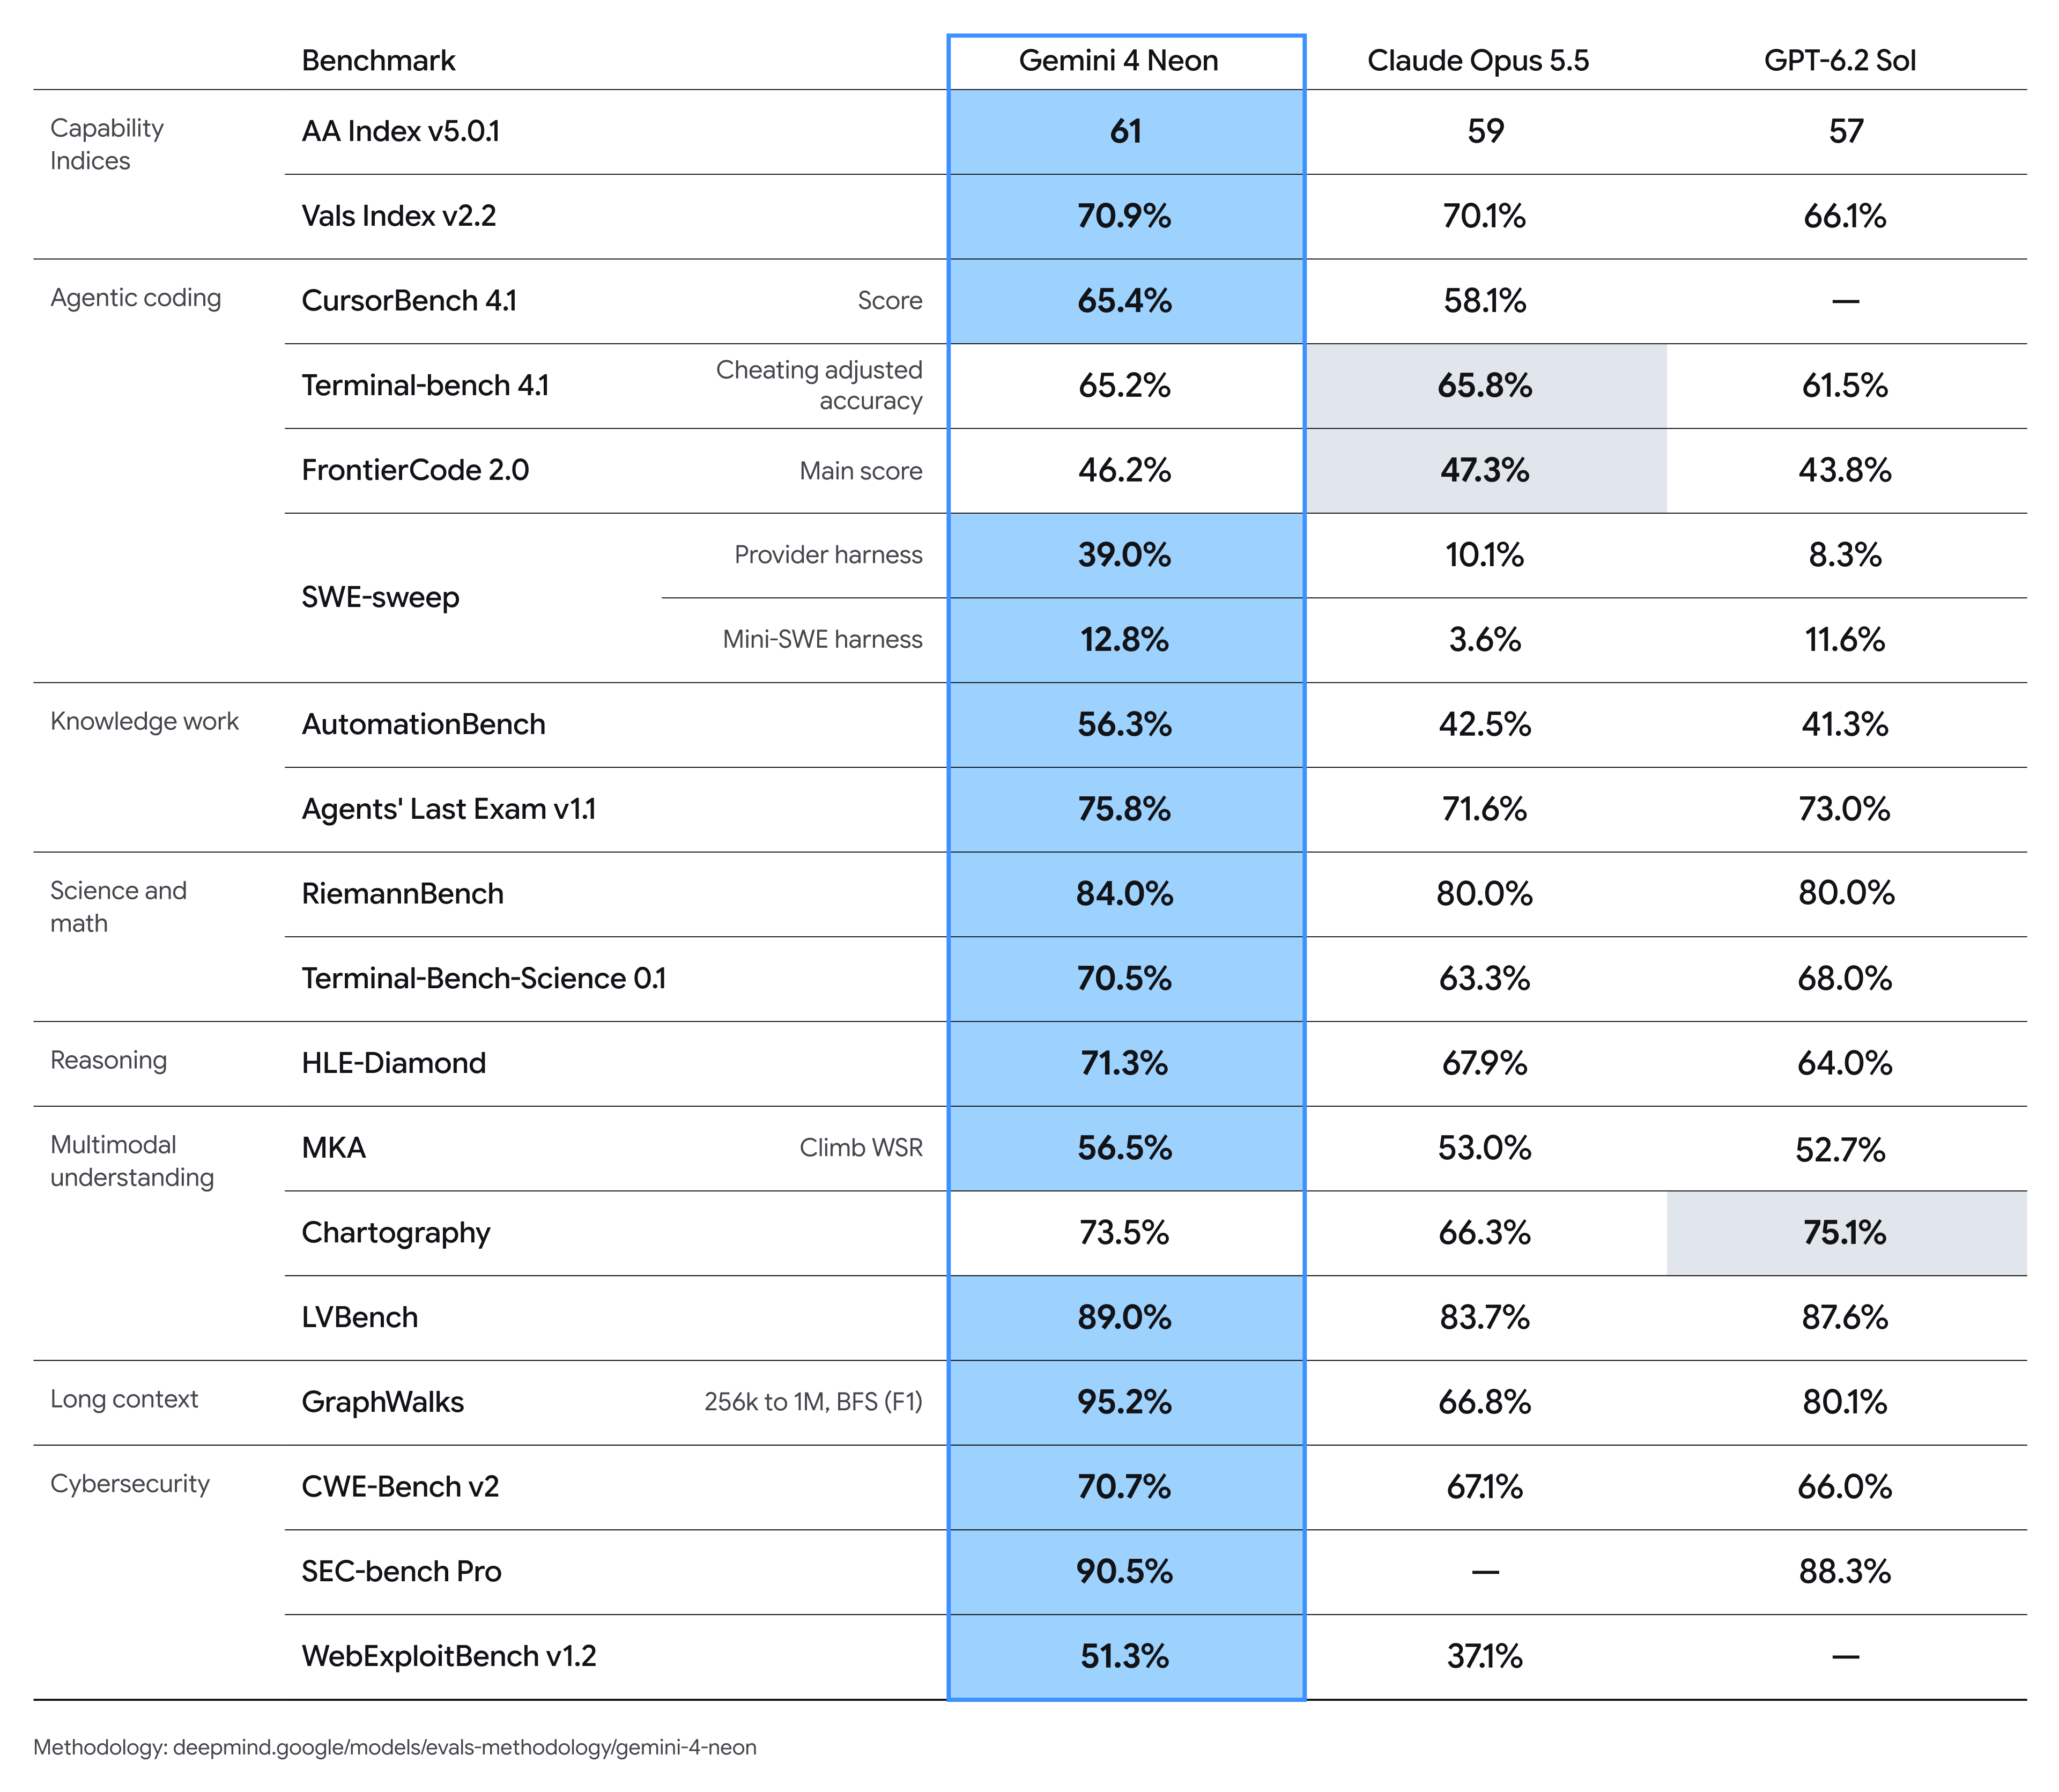
Google ยังรายงานว่าติดอันดับ 1 บน Legal Research Bench และ Tax Agent Bench ของ Vals AI อีกด้วย
Benchmark ด้าน coding ของ Gemini 4 Neon
Coding คือจุดที่จุดยืนของ Neon แข็งแรงที่สุด และก็เป็นจุดที่ harness มีผลมากที่สุดเช่นกัน PDF ระเบียบวิธีประเมินของ Google อธิบายว่าแต่ละแถวของ coding ผลิตขึ้นมาอย่างไร
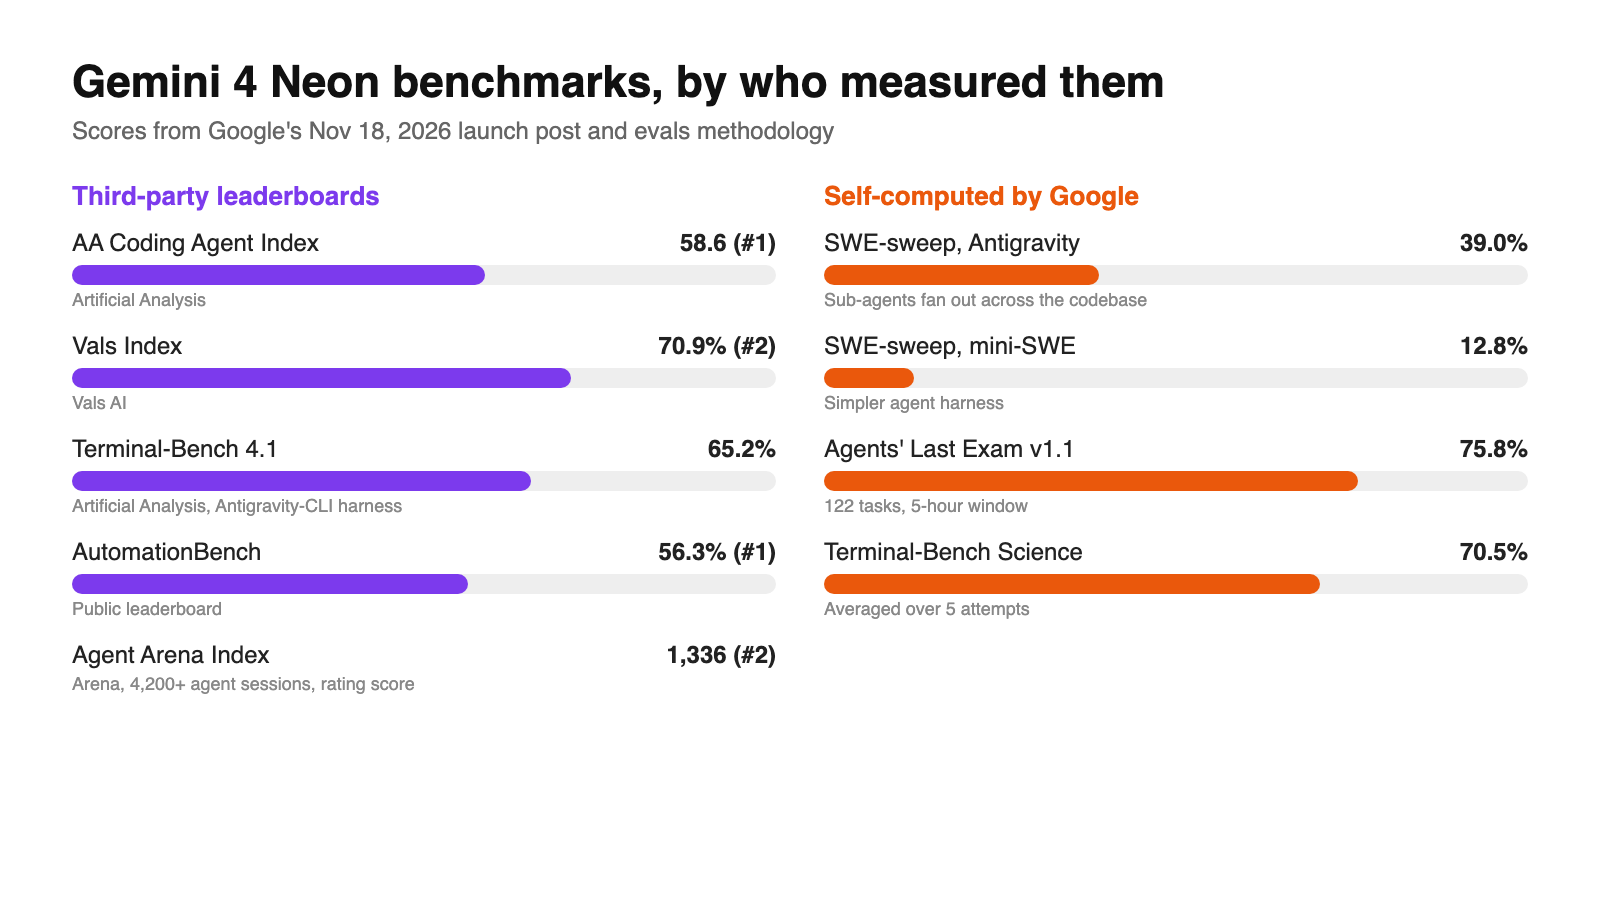
Artificial Analysis Coding Agent Index: 58.6 อันดับ 1 นี่คือดัชนีผสมจากบุคคลที่สาม จึงเป็นแถวที่ถูกกำหนดโดยการตั้งค่าของ Google น้อยที่สุด คุณดูอันดับปัจจุบันได้ที่ Artificial Analysis
Terminal-Bench 4.1: 65.2% Artificial Analysis รัน Neon ด้วย harness สาธารณะ Antigravity-CLI เวอร์ชัน 1.5.9 คะแนนของโมเดลอื่นมาจาก leaderboard ทางการ และทุกผลลัพธ์ใช้ความแม่นยำที่ปรับ cheating แล้ว ยุติธรรมดี แต่ Neon ก็รันอยู่ภายในเครื่องมือ agent ของ Google เอง
FrontierCode 2.0: 46.2% อันนี้มาจาก leaderboard สาธารณะ รันที่ high ซึ่งเป็นค่าเริ่มต้นที่คุณได้ในการใช้งานจริง ถ้าคุณจะเชื่อตัวเลข coding แค่ตัวเดียวสำหรับทราฟฟิกประจำวัน ให้เชื่อตัวนี้
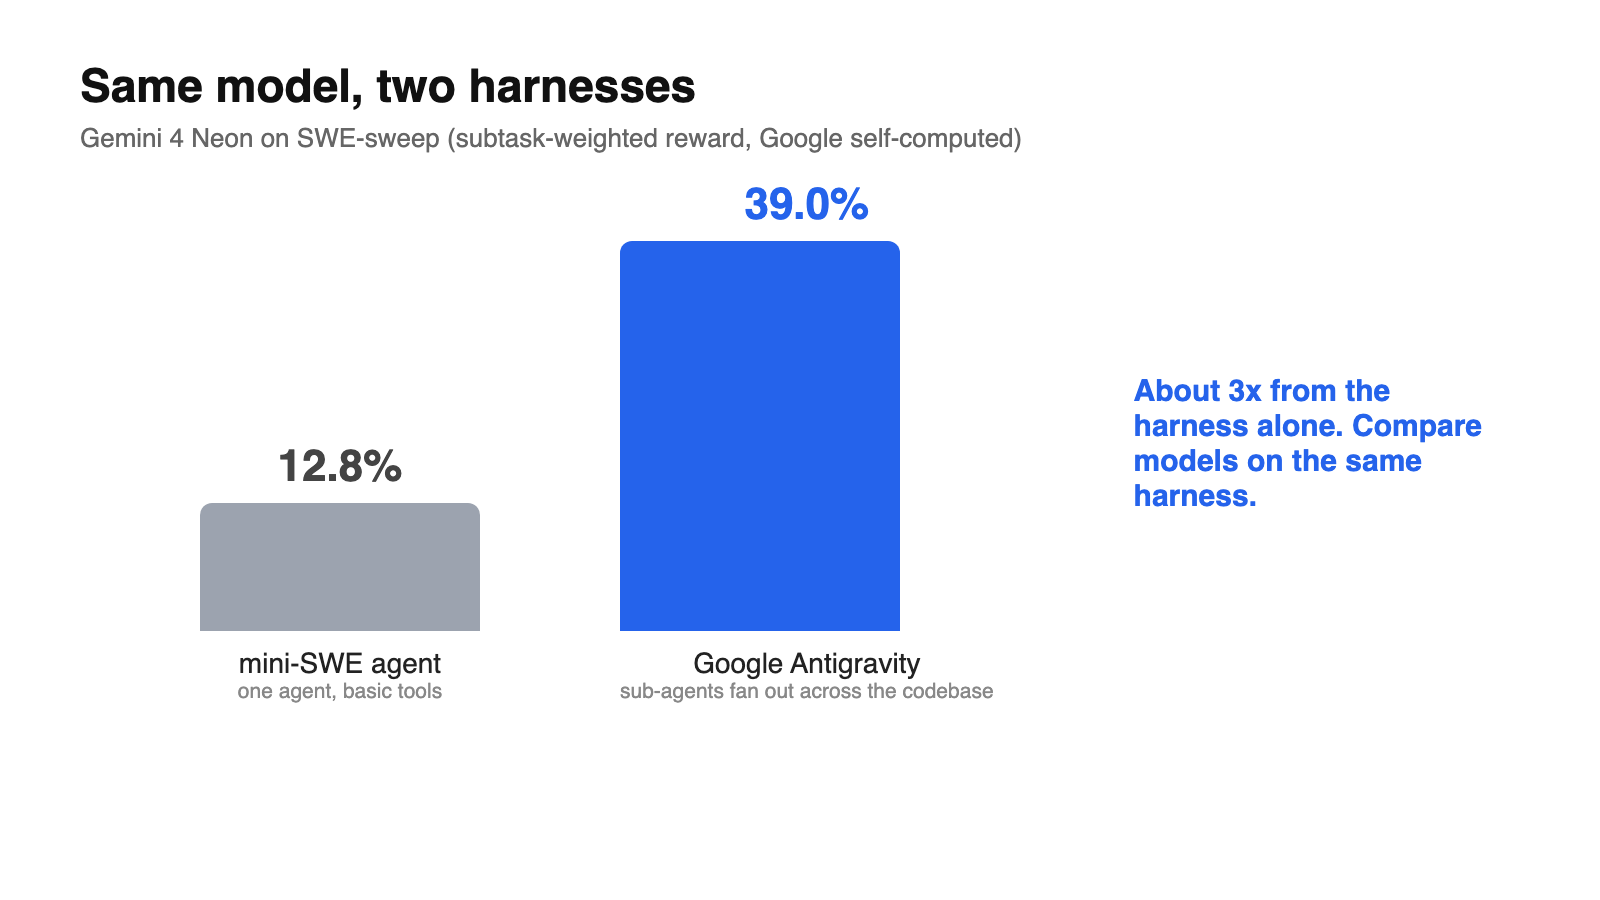
SWE-sweep: 39.0% ใน Antigravity, 12.8% บน mini-SWE ทั้งคู่คำนวณเองโดย Google การกระโดดขึ้น 3 เท่ามาจาก harness โดย Google ระบุว่า Antigravity-CLI มีเครื่องมือเริ่มต้นที่กระจาย sub-agent ไปทั่วโค้ดเบส ซึ่งเหมาะกับงานหาบั๊ก Opus 5.5 รันใน Claude Code และ GPT-6.2 Sol รันใน Codex สำหรับการเปรียบเทียบเดียวกันนี้ ให้อ่าน 12.8% เป็นตัวโมเดล และ 39.0% เป็นโมเดลบวกเครื่องมือที่ดีที่สุดของมัน
Benchmark ด้าน agent และ knowledge work
แถวพวกนี้สำคัญถ้าคุณวางแผนจะรัน Neon แบบไม่มีคนคุมตลอดหลายขั้นตอน
- Agent Arena Index: 1,336 อันดับ 2 สร้างจากเซสชัน agent ในโลกจริงกว่า 4,200 ครั้ง Google ยังระบุว่า Neon ติดอันดับ 2 ในหมวด steerability ด้วย หมายความว่ามันปรับตัวได้ดีเมื่อผู้ใช้แก้ไขกลางงาน
- AutomationBench: 56.3% อันดับ 1 Benchmark ของ Zapier สำหรับ business automation จาก leaderboard สาธารณะ
- Vending-Bench 2: $16,843 อันดับ 1 การจำลองระยะยาวของ Andon Labs ในการดำเนินธุรกิจ คะแนนคือจำนวนเงินที่ทำได้ ไม่ใช่เปอร์เซ็นต์
- Agents' Last Exam v1.1: 75.8% คำนวณเองบนชุดคำถาม 122 ข้อภายใน Antigravity-CLI 1.4.8 โดยมีหน้าต่างเวลา 5 ชั่วโมงต่อการรันหนึ่งครั้ง คะแนนของ Opus 5.5 มาจาก leaderboard สาธารณะ และของ GPT-6.2 Sol มาจาก system card ของมัน การตั้งค่าจึงแตกต่างกัน
- Chartography: 73.5% การอ่านกราฟวิชาชีพที่ซับซ้อน คำนวณเองโดยไม่ใช้เครื่องมือ
สำหรับวิทยาศาสตร์และคณิตศาสตร์ Neon ทำได้ 70.5% บน Terminal-Bench Science (คำนวณเอง เฉลี่ยจากการลอง 5 ครั้ง), 84.0% บน RiemannBench และ 71.3% บน HLE-Diamond (จาก leaderboard ของ Artificial Analysis)
Google รันตัวเลขเหล่านี้อย่างไร
กฎสี่ข้อจากระเบียบวิธีเปลี่ยนวิธีที่คุณควรอ่านตาราง:
- ใช้ระดับ thinking สูงสุดเป็นค่าเริ่มต้น "ผลลัพธ์ทั้งหมดรันด้วย Gemini API ที่การตั้งค่า thinking สูงสุด เว้นแต่ระบุไว้เป็นอย่างอื่น" นั่นคือ
xhighมีเพียง FrontierCode 2.0 เท่านั้นที่ระบุชัดว่าใช้highการเรียกใช้งานจริงใช้ค่าเริ่มต้นhighดังนั้นคาดได้ว่าจะมี thinking token น้อยลง และอาจได้คะแนนต่ำกว่าที่ตารางแสดง - Pass@1 ลองครั้งเดียว ไม่มีการโหวตแบบ majority หรือ parallel test-time compute ยกเว้นที่ระบุไว้ (Terminal-Bench Science เฉลี่ยจากการลอง 5 ครั้ง)
- ตัวเลขคู่แข่งเป็น self-report คะแนนที่ไม่ใช่ Gemini มาจากผู้ให้บริการแต่ละราย เว้นแต่ระบุไว้ Opus 5.5 และ GPT-6.2 Sol ใช้การตั้งค่า reasoning สูงสุดเมื่อมีให้ใช้
- เปิดตัวกรองความปลอดภัย ยกเว้นหมวด cyber แถวด้านความปลอดภัยไซเบอร์รันโดยปิดตัวกรอง
คู่มือเรื่องระดับ thinking ของเราครอบคลุมว่าเมื่อไหร่ที่ xhigh คุ้มค่ากับ token ที่เพิ่มขึ้น
ต้นทุนต่อ task: ตัวเลข 32% หมายถึงอะไร
ต้นทุนต่อ task คือค่าใช้จ่ายรวมในการทำ benchmark task หนึ่งงานให้เสร็จ ไม่ใช่ราคาต่อ token โมเดลที่มีราคาต่อ token สูงกว่าก็ยังมีต้นทุนต่อ task ต่ำกว่าได้ หากมันได้คำตอบในจำนวนขั้นตอนที่น้อยกว่าและใช้ thinking token น้อยกว่า
Google อ้างเรื่องต้นทุนไว้สามข้อ:
| ข้ออ้าง | ระดับ thinking | เปรียบเทียบกับ |
|---|---|---|
| ต้นทุนต่อ task ต่ำกว่า 32% พร้อมคะแนน AA Intelligence Index สูง | high |
Gemini 4 Carbon |
| ต้นทุนต่อ task ต่ำกว่าประมาณ 50% ถึง 80% บน Vals Index และ Agent Arena | high |
โมเดล frontier คู่แข่งชั้นนำ |
| ต้นทุนต่อ task ต่ำกว่า 36% ขึ้นไป | xhigh |
โมเดลคู่แข่งที่การตั้งค่าสูงสุด |
สังเกตความไม่สอดคล้อง: แถวความแม่นยำส่วนใหญ่ใช้ xhigh ขณะที่ตัวเลขประหยัด 32% ที่พาดหัวใช้ high ทั้งสองเป็นความจริง แต่ไม่ใช่ในเวลาเดียวกัน คุณจะได้การประหยัดต้นทุน หรือคะแนนสูงสุด และช่องว่างระหว่างสองอย่างนี้ก็ขึ้นอยู่กับคุณที่จะวัดเอง
นี่คือวิธีประเมินต้นทุนต่อ task ของคุณเอง thinking token คิดเงินเป็น output
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
งาน coding ที่มี input 20,000 token และ output 4,000 token มีต้นทุน $0.06 + $0.06 = $0.12 ถ้าในจำนวน input เหล่านั้นมี 15,000 token ที่ hit cache จะลดลงเหลือ $0.015 + $0.00225 + $0.06 = ประมาณ $0.077 รันงานเดิมที่ xhigh แล้วจำนวน output คือสิ่งที่เปลี่ยน ดังนั้นให้บันทึก token ต่อระดับ thinking ไม่ใช่แค่ผ่านหรือไม่ผ่าน รายละเอียดราคา Gemini 4 Neon ของเราครอบคลุมอัตรา Batch, Flex และ Priority
แถวด้าน cyber และความปลอดภัย
คะแนนด้าน cyber มาจาก "Gemini 4 Neon for cyber" ซึ่งส่งมอบให้ผู้ défense ที่เชื่อถือได้ผ่าน Fairwind Program แทนที่จะเป็น API สาธารณะ
| Benchmark | คะแนน | หมายเหตุ |
|---|---|---|
| SEC-bench Pro | 90.5% | State of the art ต้นทุนต่อโจทย์ประมาณครึ่งเดียว |
| WebExploitBench v1.2 | 51.26% | State of the art ต้นทุนครึ่งเดียวของโมเดลขนาดใหญ่ |
| AutoBaxBench (hard tier) | 76% | State of the art โค้ดปลอดภัยกว่า Carbon ในทุกระดับ |
| CWE-bench v2 | 70.7% | ดีกว่า Carbon 3.4% |
| ExploitGym | ไม่ระบุ | ระดับ frontier โดยใช้ token ครึ่งเดียวของ Carbon |
ตัวเลขด้านความปลอดภัยจากโพสต์เดียวกัน: Neon ปฏิเสธ 1.98% ของงาน Terminal-Bench 4.0 ทำคะแนน cheating 0.0% บน Terminal-Bench 4.0 ใช้ทางลัดใน 2.45% ของการประเมิน cheating ด้าน coding ของ Google และผ่าน 99.2% ของการประเมินความซื่อสัตย์ของ agent ด้วยระบบป้องกันแบบเรียลไทม์ที่ระดับ thinking สูงสุดของมัน มันต้านทานทุกการโจมตีใน benchmark การโจมตีผ่าน indirect prompt injection ของ Gray Swan
จุดที่ Neon ไม่ได้นำ
Neon ไม่ได้เป็นที่หนึ่งในทุกที่ และ Google ก็บอกไว้:
- Artificial Analysis Intelligence Index: อันดับ 3 โดยรวม "ตามหลังโมเดลที่ใหญ่และช้ากว่าเพียงเล็กน้อย"
- Vals Index: อันดับ 2 ไม่ใช่อันดับ 1
- Agent Arena Index: อันดับ 2
Google ยังชี้ให้คุณใช้ Carbon สำหรับโปรเจกต์ระยะยาวที่ยากที่สุดของมันอยู่ ถ้าคุณกำลังเลือกระหว่างโมเดล Gemini 4 ทั้งสามรุ่น การเปรียบเทียบ Neon vs Carbon vs Hydrogen ของเราอธิบายข้อแลกเปลี่ยนไว้ และโพสต์ benchmark ของ Gemini 4 Argon แสดงให้เห็นว่าตารางของโมเดลรุ่นก่อนอ่านอย่างไร
ทดสอบ benchmark Gemini 4 Neon ด้วยตัวคุณเองผ่าน Apidog CLI
Leaderboard บอกถึง harness ของ Google ไม่ใช่ผลิตภัณฑ์ของคุณ วิธีที่เร็วที่สุดในการรู้ว่า Neon คุ้มกับราคาหรือไม่คือปล่อยให้ coding agent ของคุณรันพรอมป์เดียวกันที่ high และ xhigh แล้วบันทึก token และ latency ของแต่ละระดับ
Neon ไม่มี API tier ฟรี คุณจึงต้องใช้ Gemini API key แบบเสียเงิน คำขอนี้ใช้รูปแบบ Interactions API ที่ Google เอกสารไว้ เราไม่ได้รันจริงสำหรับโพสต์นี้:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
Apidog CLI ช่วยให้ Claude Code, Codex, Cursor หรือ OpenCode สร้างและรัน API test จาก terminal ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้พรอมป์ต์เดียวกับ agent ของคุณ:
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
agent จะสร้าง environment ตรวจสอบ payload ของ test case เทียบกับ schema แล้วรันหนึ่งครั้งต่อระดับ thinking:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
เพิ่ม --timeout-request 900000 ถ้าพรอมป์ต์ของคุณยาว เพราะการรัน xhigh ที่ยากอาจใช้เวลาหลายนาที ถ้าต้องการรันการเปรียบเทียบซ้ำทุกครั้งที่พรอมป์ต์เปลี่ยน ให้ใส่ apidog run ... -r junit แบบเดียวกันนี้ใน CI ตามคู่มือ Apidog CLI สำหรับ CI/CD หรือเริ่มจาก Apidog CLI ใน Claude Code แผน Free ของ Apidog รองรับผู้ใช้สูงสุด 4 คน
คำถามที่พบบ่อย
ผล benchmark ที่ดีที่สุดของ Gemini 4 Neon คืออะไร? อันดับ 1 บน Artificial Analysis Coding Agent Index ที่ 58.6 พร้อมอันดับ 1 บน AutomationBench (56.3%) และ Vending-Bench 2 ($16,843)
ผลทดสอบ benchmark รันที่ระดับ thinking ไหน? ส่วนใหญ่ xhigh ซึ่งเป็นระดับสูงสุด ระเบียบวิธีของ Google ระบุว่าผลลัพธ์ใช้การตั้งค่า thinking สูงสุดเว้นแต่ระบุไว้ FrontierCode 2.0 (46.2%) ถูกระบุว่าใช้ high ซึ่งเป็นค่าเริ่มต้น
Gemini 4 Neon ถูกกว่า Carbon ต่อ task จริงหรือ? Google ระบุว่าต้นทุนต่อ task ต่ำกว่า 32% ที่ high นั่นเป็นตัวเลขต่อ task จากการรัน benchmark ดังนั้นควรยืนยันบนพรอมป์ต์ของคุณเองก่อนย้ายทราฟฟิก
ทำไม Neon ได้ 39.0% และ 12.8% บน SWE-sweep? เพราะใช้ harness ต่างกัน 39.0% อยู่ใน Google Antigravity ซึ่งกระจาย sub-agent ไปทั่วโค้ดเบส ส่วน 12.8% คือ agent mini-SWE ที่เรียบง่ายกว่า
Benchmark ของ Gemini 4 Neon เป็นอิสระหรือไม่? บางส่วน แถวของ Artificial Analysis, Vals, Arena, AutomationBench และ FrontierCode มาจากบุคคลที่สาม ส่วน SWE-sweep, Agents' Last Exam และ Terminal-Bench Science คำนวณเองโดย Google