API ของ Gemini 4 Neon ใช้ model ID คือ gemini-4-neon คุณเรียกใช้ผ่าน POST ไปที่ https://generativelanguage.googleapis.com/v1beta/interactions โดยใส่คีย์ของคุณใน header x-goog-api-key และส่ง model พร้อม input ใน JSON body โมเดลนี้ใช้งานได้เฉพาะ paid tier เท่านั้น ในราคา $3 ต่อ input tokens 1 ล้านตัว และ $15 ต่อ output tokens 1 ล้านตัว โดยตั้งค่าเริ่มต้นเป็นระดับ thinking แบบ high
คู่มือนี้ครอบคลุมสิ่งที่แตกต่างของ Neon: การตั้งค่า paid tier, การเปลี่ยนจากโมเดล Gemini 4 ตัวอื่น, ผลลัพธ์ที่ยาวเกิน 64K tokens, การจับคู่ Neon กับ Hydrogen และการควบคุมค่าใช้จ่ายให้อยู่ในขอบเขต ชื่อฟิลด์ทุกตัวมาจากเอกสารของ Google
คุณต้องเตรียมอะไรบ้างก่อนเรียก Gemini 4 Neon API ครั้งแรก?
คุณต้องมี Gemini API key ในโปรเจกต์ที่เปิดใช้ billing, model ID gemini-4-neon และ Interactions endpoint Google เปิดตัว Neon เมื่อวันที่ 18 พฤศจิกายน 2026 ในฐานะโมเดลระดับกลางของตระกูล Gemini 4 ที่อยู่ระหว่าง Hydrogen และ Carbon
| รายการ | ค่า |
|---|---|
| Model ID | gemini-4-neon |
| Endpoint | POST /v1beta/interactions บน generativelanguage.googleapis.com |
| Auth header | x-goog-api-key: $GEMINI_API_KEY |
| API | Interactions API และ generateContent |
| ระดับ thinking | low, medium, high (ค่าเริ่มต้น), xhigh |
| Context window | 1,048,576 tokens ใช้ร่วมกันระหว่าง input, thinking และ output |
| Output ต่อการเรียกแบบ synchronous 1 ครั้ง | 65,536 tokens |
| Long decode | สูงสุด 1,048,576 tokens หักลบด้วย input ของคุณ |
| Free tier | ไม่มี |
| ราคาแบบ Paid | $3.00 / 1M input, $15.00 / 1M output (รวม thinking) |
| Cached input | $0.15 / 1M ผ่าน implicit caching |
สำหรับ PDF, function calling และ streaming รูปแบบ request จะตรงกับ คู่มือ Gemini 4 Hydrogen API ของเรา เพียงเปลี่ยน model ID
จะได้ Gemini API key ที่ใช้กับ Neon ได้อย่างไร?
Neon ไม่อยู่ใน free tier ดังนั้นมีแค่คีย์ไม่พอ โปรเจกต์ที่ผูกกับคีย์นั้นต้องเปิดใช้ billing
- เปิดหน้า API keys ใน Google AI Studio แล้วสร้างคีย์ หรือใช้คีย์ที่มีอยู่แล้ว
- ตรวจสอบว่าโปรเจกต์ของคีย์อยู่ใน paid tier คู่มือของ Google ระบุชัดเจนว่า "Neon ใช้ได้เฉพาะ paid tier เท่านั้น (ไม่รองรับ free tier)"
- Export คีย์:
export GEMINI_API_KEY="YOUR_API_KEY"SDK ของ Google GenAI จะอ่านค่านี้ให้อัตโนมัติ - ตรวจสอบ rate limits ของ paid tier ของคุณในหน้า rate limits ก่อนวางแผนรันงานขนาดใหญ่ [VERIFY: ตัวเลข RPM และ TPM ของ Neon ในแต่ละ tier]
จะส่ง request แรกไปยัง Gemini 4 Neon API อย่างไร?
ส่ง model และ input ไปที่ Interactions endpoint นี่คือรูปแบบ quickstart ของ Google:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Review this Go handler for missing error checks and suggest fixes."
  }'
การเรียกแบบเดียวกันด้วย Python SDK (pip install -U google-genai):
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Review this Go handler for missing error checks and suggest fixes.",
)

print(interaction.output_text)
print(interaction.usage)
อ่านค่า usage ในทุก response ขณะทดสอบ: thinking tokens ถูกเรียกเก็บในอัตรา output ที่ $15 ดังนั้นจำนวน thinking คือจุดที่ต้นทุนของคุณไป
โค้ดตัวอย่างเหล่านี้อ้างอิงจากคู่มือของ Google เราไม่ได้รันทดสอบเองสำหรับบทความนี้ จึงควรตรวจสอบรูปแบบ response กับการเรียกครั้งแรกของคุณเอง
อะไรบ้างที่เปลี่ยนไปเมื่อเปลี่ยนจาก Hydrogen หรือ Carbon?
ถ้าคุณใช้โมเดล Gemini 4 ตัวอื่นอยู่แล้ว การเปลี่ยนมาใช้ Neon ไม่ต้องแก้ request schema เลย เพียงเปลี่ยน string model และตรวจสอบ 3 ข้อนี้:
| รายการตรวจสอบ | Neon | Hydrogen | Carbon และ Argon |
|---|---|---|---|
| ระดับ thinking เริ่มต้น | high |
high |
medium |
| ระดับสูงสุด | xhigh |
xhigh |
high |
| Input / output ต่อ 1M | $3 / $15 | $1.50 / $7.50 | ดู ราคา Carbon |
ถ้าเปลี่ยนมาจาก Carbon หรือ Argon การที่ค่าเริ่มต้นข้ามจาก medium เป็น high หมายความว่าจะมี thinking tokens มากขึ้นใน prompt เดิม กำหนด thinking_level อย่างชัดเจนถ้าต้องการพฤติกรรมแบบเดิม:
interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions.",
    generation_config={"thinking_level": "medium"},
)
ถ้าเปลี่ยนมาจาก Gemini 3.8 Flash หรือรุ่นเก่ากว่า รายการจะยาวขึ้น ตาม migration checklist ของ Google:
- เพิ่มขีดจำกัด output ที่ตั้งไว้ต่ำ
max_output_tokensครอบคลุมทั้ง thinking และคำตอบรวมกัน ลบขีดจำกัดที่ hardcode ไว้เช่น 8,192 หรือเพิ่มเป็น 65,536 และลดระดับ thinking ลงถ้าต้องการใช้จ่ายน้อยลง - เลิกใช้
minimalNeon จะปฏิเสธด้วย error - ลบ sampling parameters เซิร์ฟเวอร์จะเมิน
temperature,top_pและtop_kที่อยู่ในช่วงที่กำหนด ส่วนค่าที่เกินช่วงจะคืน400 - ย้ายออกจาก explicit caching Neon ไม่รองรับ
cachedContentsหรือcaches.createจึงต้องลบฟิลด์cached_contentออก - ประกาศ tools แบบ native การใช้ prompt ให้เรียก tool ด้วย raw JSON โดยไม่ประกาศ tools อาจคืน
MALFORMED_FUNCTION_CALLให้ใช้ function calling หรือ structured outputs แทน
จะได้ output เกิน 64K tokens จาก Neon อย่างไร?
Request แบบ synchronous จะหยุดที่ 65,536 tokens ไม่ว่าจะ streaming หรือไม่ สำหรับ output ที่ยาวกว่านั้น เช่น spec การย้ายระบบฉบับเต็มพร้อม test suite ให้ตั้ง background เป็น true และเพิ่ม max_output_tokens ให้เกิน 65,536 เซิร์ฟเวอร์ของ Google จะสร้างต่อเนื่องเป็นช่วง ๆ ละ 64K tokens จนถึงขีดจำกัดที่คุณตั้ง
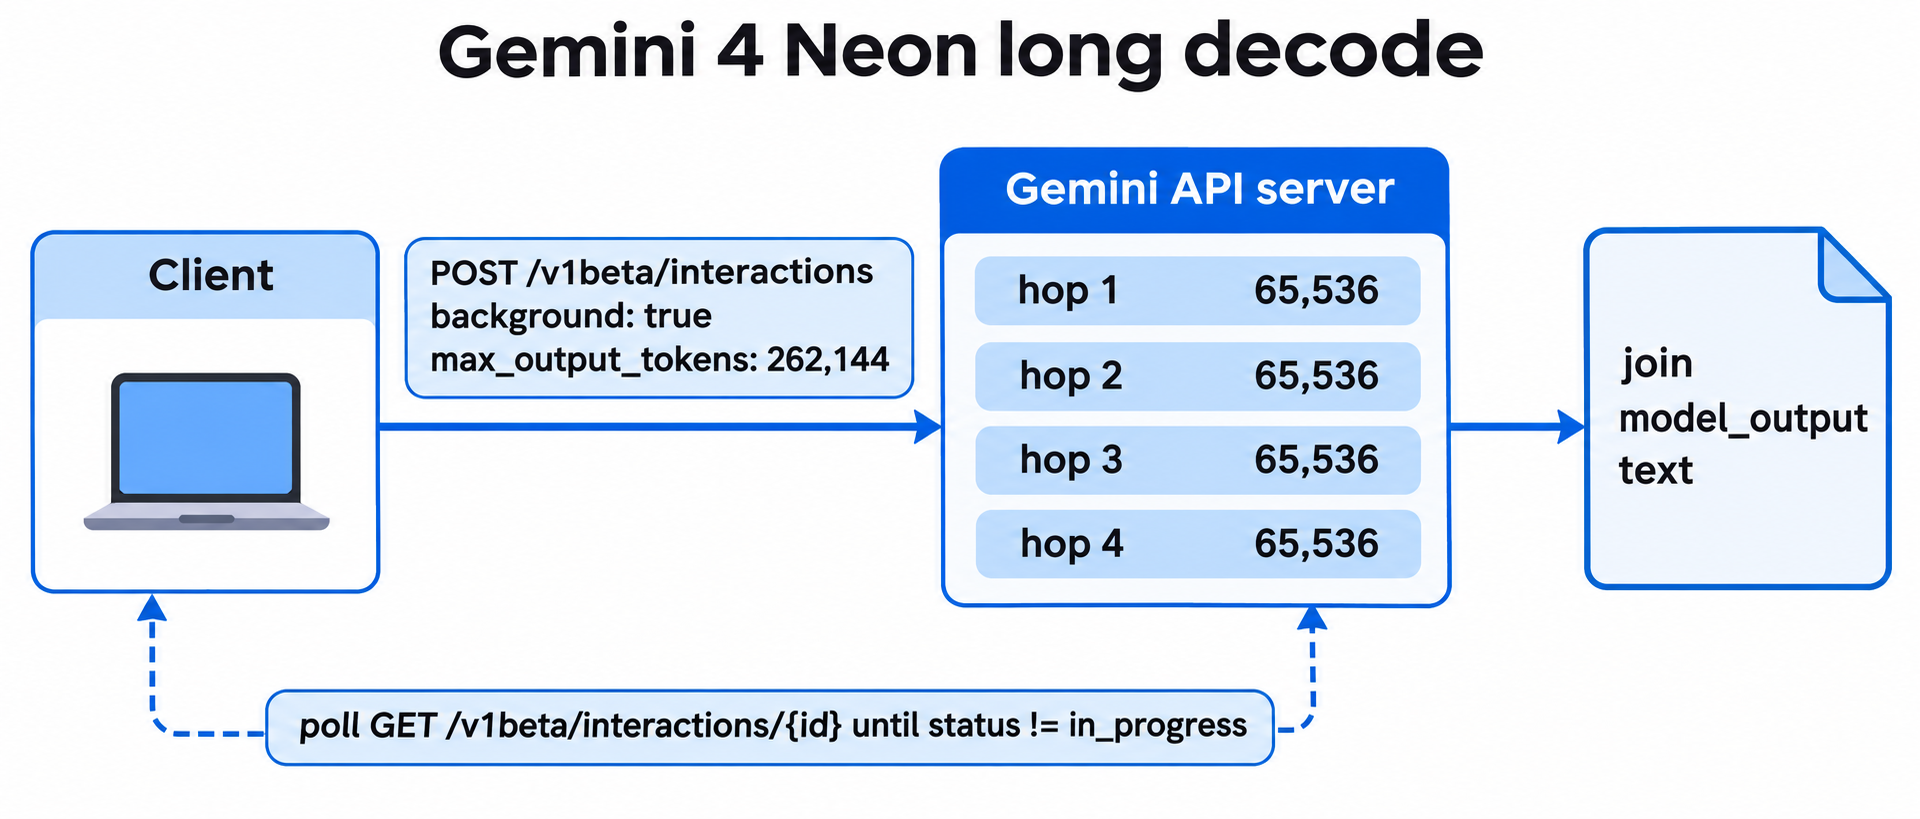
เริ่มงานและเก็บค่า id ไว้:
export ID=$(curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-neon",
    "input": "Generate a complete multi-module migration specification and test suite for this service.",
    "background": true,
    "generation_config": {
      "max_output_tokens": 262144,
      "thinking_level": "high"
    }
  }' | jq -r '.id')
จากนั้น poll จนกว่าจะเสร็จ แล้วรวมข้อความจากทุกช่วง (Python, โดยใช้ ID ที่ export ไว้):
import os, time

interaction = client.interactions.get(id=os.environ["ID"])
while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

text = "".join(
    c.text
    for step in interaction.steps if step.type == "model_output"
    for c in step.content if c.type == "text"
)
สามกฎจากคู่มือของ Google ช่วยให้กระบวนการนี้ไม่พลาด:
- ถ้าตั้ง
backgroundโดยไม่ตั้งmax_output_tokensเซิร์ฟเวอร์จะหยุดที่ 65,536 tokens - ขีดจำกัดสูงสุดคือ 1,048,576 หักลบด้วย input tokens ของคุณ Google แนะนำ 131,072 หรือ 262,144 สำหรับงานหลายขั้นตอนที่ยาว
- Prompt ที่ซับซ้อนอาจใช้เวลาหลายนาที ให้ใช้โหมด background หรือตั้ง timeout ของ HTTP client ไว้อย่างน้อย 15 นาที
ถ้าคุณไม่ต้องการให้เก็บ interactions ไว้ฝั่งของ Google คู่มือ long decode ยังอธิบายวิธี continuation ฝั่ง client ใน SDK ล่าสุดด้วย
จะจับคู่ Neon กับ Hydrogen อย่างไร?
ใช้ Neon สำหรับงานที่ต้องใช้วิจารณญาณ และ Hydrogen สำหรับงานปริมาณมาก Neon วางแผนหรือรีวิว workflow แล้วคุณส่ง interaction id ของมันเป็น previous_interaction_id ไปยังการเรียก gemini-4-hydrogen ที่ทำงานเพียงขั้นตอนเดียว คู่มือนักพัฒนา Cloud ของ Google แสดงรูปแบบนี้:
plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
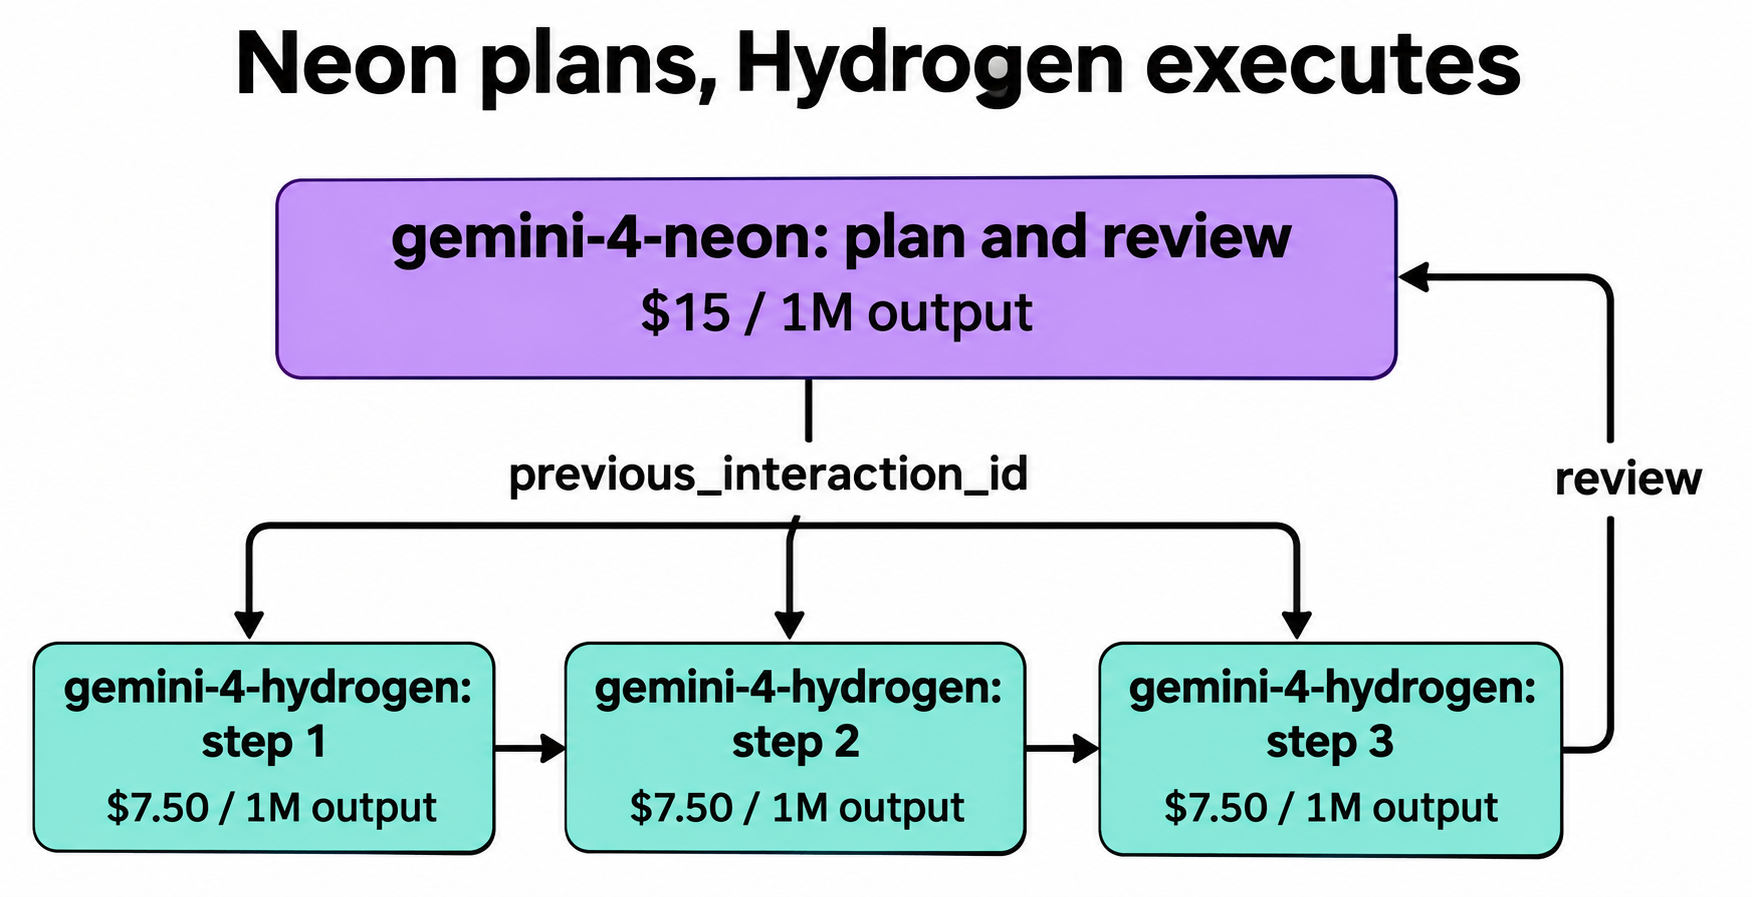
Output token ทุกตัวที่ Hydrogen เขียนแทน Neon มีต้นทุนเพียงครึ่งหนึ่ง คู่มือ Gemini 4 Hydrogen orchestrator ของเราอธิบายลูปแบบเดียวกันโดยใช้ Carbon เป็นตัววางแผน
จะลดต้นทุน Gemini 4 Neon API อย่างไร?
สี่วิธี เรียงตามผลตอบแทนที่มักได้:
- เลือกระดับ thinking ต่ำที่สุดที่ผ่านเกณฑ์ คำแนะนำของ Google คือรัน evaluation ของคุณทั้งสี่ระดับด้วย
max_output_tokensที่สูง แล้วเลือกthinking_levelต่ำที่สุดที่ตอบโจทย์คุณภาพของคุณ - ใช้ prompt ยาวซ้ำ Implicit caching ทำงานอัตโนมัติกับ prompt ที่มีอย่างน้อย 4,096 tokens และลดค่า cached input ลง 95% จาก $3.00 เหลือ $0.15 ต่อล้านตัว เก็บส่วนที่ยาวและคงที่ของ prompt (system text, docs, schemas) ไว้ด้านหน้า
- ส่งงาน execute ให้ Hydrogen ดูรูปแบบการจับคู่ด้านบน
- นับทุกอย่าง Google เรียกเก็บทุก token ที่โมเดลประมวลผล รวมถึง thinking tokens และ instruction ภายในที่เพิ่มเข้ามาเมื่อคุณใช้ grounding การใช้ Grounding with Google Search ก็ถูกเรียกเก็บต่อ query เช่นกัน
การคำนวณอย่างรวดเร็วเพื่อตรวจสอบ: การเรียกที่มี 20,000 input tokens และ 8,000 output tokens (รวม thinking) จะเสีย $0.06 สำหรับ input และ $0.12 สำหรับ output รวม $0.18 ตามราคา list
ให้ coding agent ของคุณเปรียบเทียบ Neon กับ Hydrogen ด้วย Apidog CLI
Neon คุ้มราคาเป็นสองเท่าของ Hydrogen ใน prompt ของคุณหรือไม่? ให้ coding agent ของคุณ (Claude Code, Codex, Cursor) สร้าง test case หนึ่งตัวแล้วรันกับทั้งสองโมเดลด้วย Apidog CLI
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
แล้วให้ prompt เดียวกับ agent ของคุณ:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY,
MODEL (default "gemini-4-hydrogen") and THINKING (default "high"). Add an
endpoint for POST /v1beta/interactions with the x-goog-api-key header from
GEMINI_API_KEY. Create a test case that sends model {{MODEL}}, our code-review
prompt and generation_config.thinking_level {{THINKING}}, and asserts: HTTP 200,
status is "completed", a non-empty model_output step, and usage.total_tokens
exists. Run it for gemini-4-hydrogen and gemini-4-neon, then compare
usage.total_thought_tokens and usage.total_output_tokens.
Agent จะอ่าน schema ของ payload แต่ละตัวและตรวจสอบ JSON ก่อนเขียนอะไรออกมา:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
คูณ tokens ของแต่ละรันด้วยราคาของโมเดล คุณก็จะได้ต้นทุนจริงต่องานสำหรับ prompt ของคุณ ไม่ใช่ค่าเฉลี่ยจากโพสต์เปิดตัว เพิ่ม --upload-report เพื่อดูการรันในแอป Apidog หรือเปลี่ยน -r cli,json เป็น -r junit เพื่อใส่การตรวจสอบเดียวกันใน CI คู่มือ CI/CD ของ Apidog CLI แสดง pipeline และ Apidog CLI in Claude Code อธิบายการตั้งค่า agent แผน Free ของ Apidog รองรับผู้ใช้สูงสุด 4 คน
คำถามที่พบบ่อย
Model ID ของ Gemini 4 Neon คืออะไร? gemini-4-neon ใช้ได้ทั้งกับ Interactions API และ generateContent
Gemini 4 Neon API ฟรีหรือไม่? ไม่ Neon อยู่ใน paid tier ของ Gemini API เท่านั้น ในราคา $3 ต่อ input tokens 1 ล้านตัว และ $15 ต่อ output tokens 1 ล้านตัว สมาชิก Google AI Pro และ Ultra สามารถลองใช้ในแชทของ AI Studio ได้
โค้ด Hydrogen ของฉันใช้กับ Neon ได้ไหม? ได้ Google ระบุว่าการสลับระหว่างโมเดล Gemini 4 ไม่ต้องแก้ request schema เพียงอัปเดต string model แล้วตัดสินใจว่าจะใช้ระดับ thinking เริ่มต้นแบบ high หรือไม่
ผลลัพธ์สูงสุดของ Gemini 4 Neon API คือเท่าไร? 65,536 tokens ต่อ request แบบ synchronous ถ้าตั้ง background เป็น true และเพิ่ม max_output_tokens Neon สามารถสร้างได้ถึง window 1,048,576 tokens หักลบด้วย input ของคุณ
Gemini 4 Neon รองรับ temperature หรือไม่? ไม่ เซิร์ฟเวอร์จะเมินค่า temperature, top_p และ top_k ที่อยู่ในช่วง และคืน 400 สำหรับค่าที่เกินช่วง ใช้ thinking_level เพื่อแลกคุณภาพกับความเร็วและต้นทุนแทน
Neon รองรับ explicit context caching หรือไม่? ไม่ ให้ลบ cached_content ออกจาก request ของคุณ Implicit caching ยังใช้งานอัตโนมัติกับ prompt ที่มี 4,096 tokens ขึ้นไป ด้วยส่วนลด 95% สำหรับ cached input