
ราคา Gemini 4 Hydrogen อยู่ที่ $1.50 ต่อ token ฝั่ง input 1 ล้านตัว และ $7.50 ต่อ token ฝั่ง output 1 ล้านตัว บนแพ็กเกจ Standard แบบเสียเงินของ Gemini API โดยราคาคงที่ตลอดทั้งหน้าต่างบริบท 1 ล้าน token Thinking token ถูกคิดค่าบริการตามอัตราฝั่ง output, cached input มีค่าใช้จ่าย $0.075 ต่อ 1 ล้าน และโหมด Batch หรือ Flex ลดราคาทุกอัตราลงครึ่งหนึ่ง
Hydrogen เปิดตัวเมื่อวันที่ 12 พฤศจิกายน 2026 เป็นรุ่นที่เน้นความเร็วของตระกูล Gemini 4 ต่างจาก Carbon และ Argon ตรงที่ไม่มีราคาช่วงเปิดตัวที่จะเพิ่มเป็นเท่าตัวภายหลัง และยังมีให้ใช้ใน Free tier อีกด้วย ในบทความนี้จะมีทั้งตารางราคา ตัวอย่างการคำนวณต้นทุน วิธีที่ระดับ thinking ส่งผลต่อบิลของคุณ และวิธีวัดต้นทุนจริงของคุณเอง หากยังไม่คุ้นเคยกับโมเดลนี้ เริ่มต้นได้ที่ Gemini 4 Hydrogen คืออะไร
Gemini 4 Hydrogen ราคาเท่าไรต่อ token 1 ล้านตัว?
Gemini 4 Hydrogen (model ID gemini-4-hydrogen) มี 4 แพ็กเกจแบบเสียเงินบนหน้าราคาของ Google ราคาทั้งหมดอ้างอิงต่อ token 1 ล้านตัว:
| แพ็กเกจ | Input | Output รวม thinking | Cached input | Free tier |
|---|---|---|---|---|
| Standard | $1.50 | $7.50 | $0.075 | ไม่มีค่าใช้จ่าย |
| Batch | $0.75 | $3.75 | $0.0375 | ไม่มีให้ใช้ |
| Flex | $0.75 | $3.75 | $0.0375 | ไม่มีให้ใช้ |
| Priority | $2.70 | $13.50 | $0.135 | ดูหน้าราคา |
รายละเอียด 3 ข้อในหน้าเดียวกันที่ส่งผลต่องบประมาณของคุณ:
- Thinking มีค่าบริการ “Token ทุกตัวที่โมเดลประมวลผลจะถูกนับและคิดค่าบริการ รวมถึง thinking token ด้วย”
- มีแค่ implicit caching เท่านั้น ไม่รองรับ explicit caching คุณจะได้รับอัตรา cached เมื่อ implicit cache ของ Google จับคู่กับ prompt prefix ที่ซ้ำกัน
- Grounding คิดค่าใช้จ่ายเพิ่ม Google Search grounding รวม 5,000 คำขอฟรีต่อเดือน หลังจากนั้น $14 ต่อ 1,000 คำขอ
การใช้งานใน Free tier ถูกระบุว่า “Used to improve our products: Yes” บนหน้าเว็บ คู่มือ การใช้ Gemini 4 Hydrogen ฟรี ของเราพาไปดูทุกเส้นทางที่ต้นทุน $0
“ราคาคงที่ถึง 1M token” หมายความว่าอย่างไร?
หมายความว่าราคาเดียวสำหรับ prompt ทุกขนาด โพสต์เปิดตัวของ Google ระบุว่า Hydrogen “มีราคาคงที่ตลอดทั้งหน้าต่างบริบท 1 ล้าน token ที่ $1.50 ต่อ input หนึ่งล้าน token และ $7.50 ต่อ output หนึ่งล้าน token” Prompt ขนาด 5K token และ prompt ขนาด 900K token ถูกคิดค่าบริการที่อัตราต่อ token เท่ากัน
ไม่ใช่ทุกโมเดล Gemini ที่ทำงานแบบนี้: Gemini 3.1 Pro Preview คิดราคา $2.00/$12.00 ต่อ 1M สำหรับ token ไม่เกิน 200K และ $4.00/$18.00 สำหรับส่วนที่เกิน
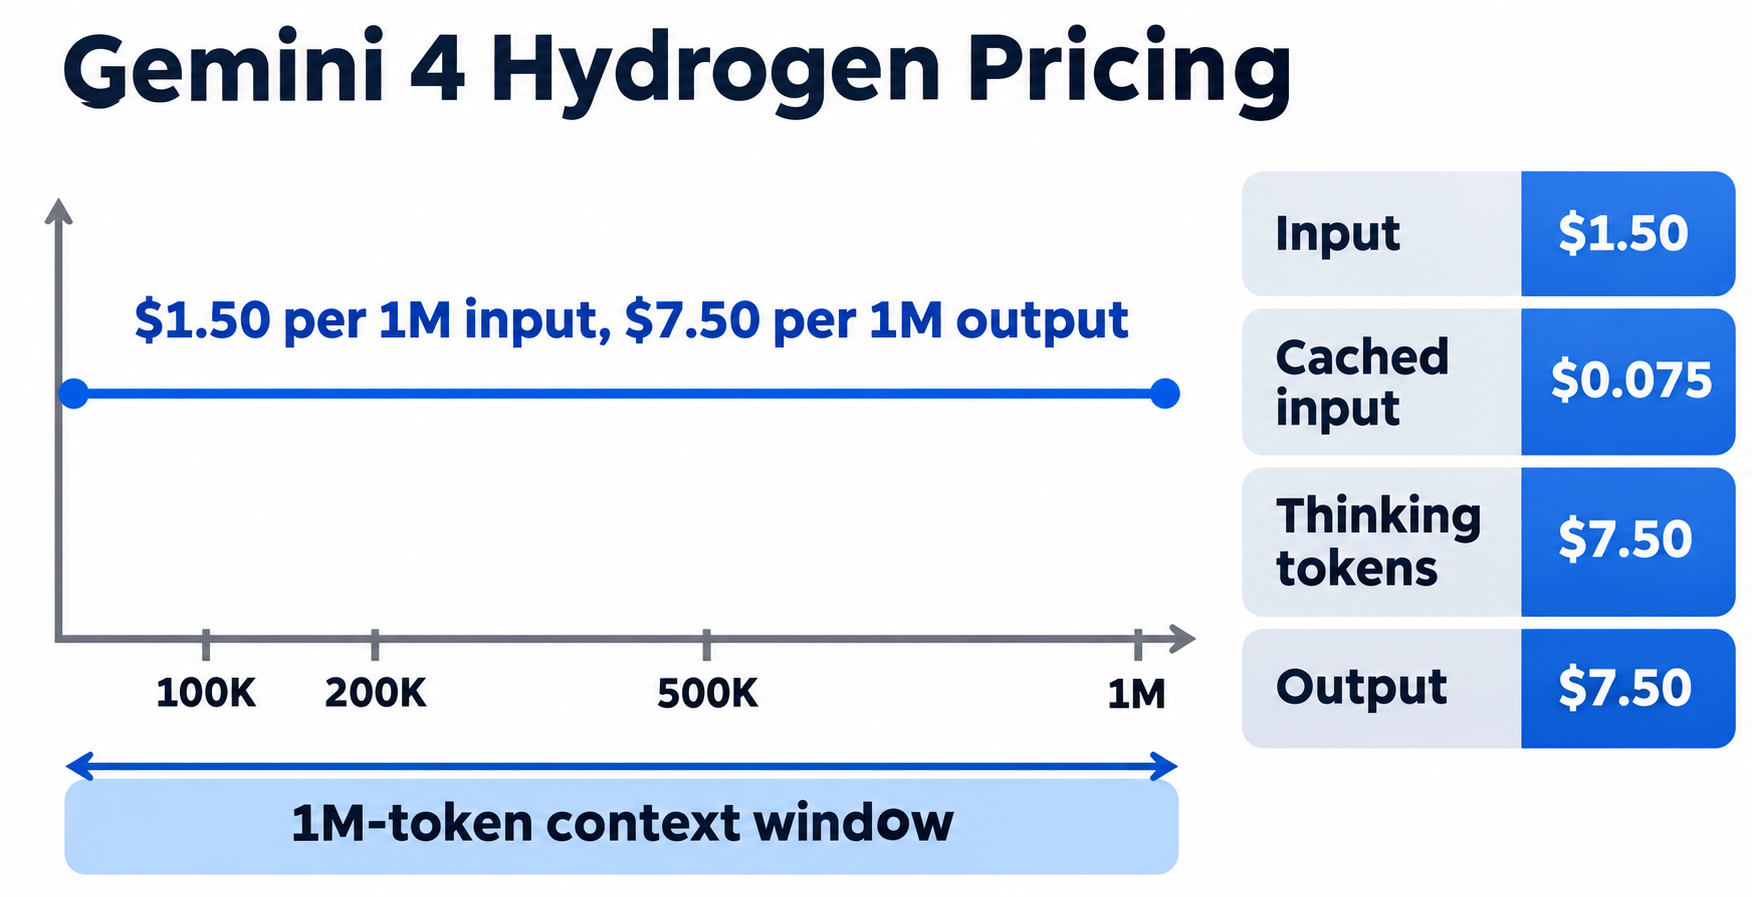
ตัวเลขสองค่าที่ทำให้เห็นภาพชัด:
- Prompt ขนาด 900K token (โค้ดเบสขนาดใหญ่หรือกองไฟล์ PDF) มีค่า input $1.35 บน Standard หรือ $0.0675 เมื่อ implicit cache ตรง
- หน้าต่างบริบทเป็นแบบรวมเดียว: input, thinking และ output แบ่งใช้ token รวม 1,048,576 ตัว Prompt 900K เหลือพื้นที่ประมาณ 148K token สำหรับ thinking และคำตอบรวมกัน
คำตอบแบบ synchronous จำกัดที่ 65,536 token Output ที่ยาวกว่านั้นทำงานผ่าน long decode ในราคาเดิม $7.50 ต่อ 1M
ระดับ thinking เปลี่ยนบิล Gemini 4 Hydrogen ของคุณอย่างไร?
Hydrogen รองรับ 4 ระดับ thinking: low, medium, high (ค่าเริ่มต้น) และ xhigh ที่เพิ่มเข้ามาใหม่ ตั้งค่าได้ผ่าน generation_config.thinking_level ราคาต่อ token ไม่เปลี่ยนแปลง แต่จำนวน thinking token เปลี่ยน และ token เหล่านั้นถูกคิดตามอัตราฝั่ง output
Artificial Analysis ทดสอบ Intelligence Index ที่ทุกระดับ นี่คือผลที่เขารายงาน:
| ระดับ thinking | คะแนน Index | Token ที่สร้างบน index | ต้นทุนต่องาน index |
|---|---|---|---|
| low | 27 | 20.3M | $0.29 |
| medium | 41 | 54.4M | $0.80 |
| high (ค่าเริ่มต้น) | 51 | 110M | $1.87 |
| xhigh | 54 | 304M | $3.16 |
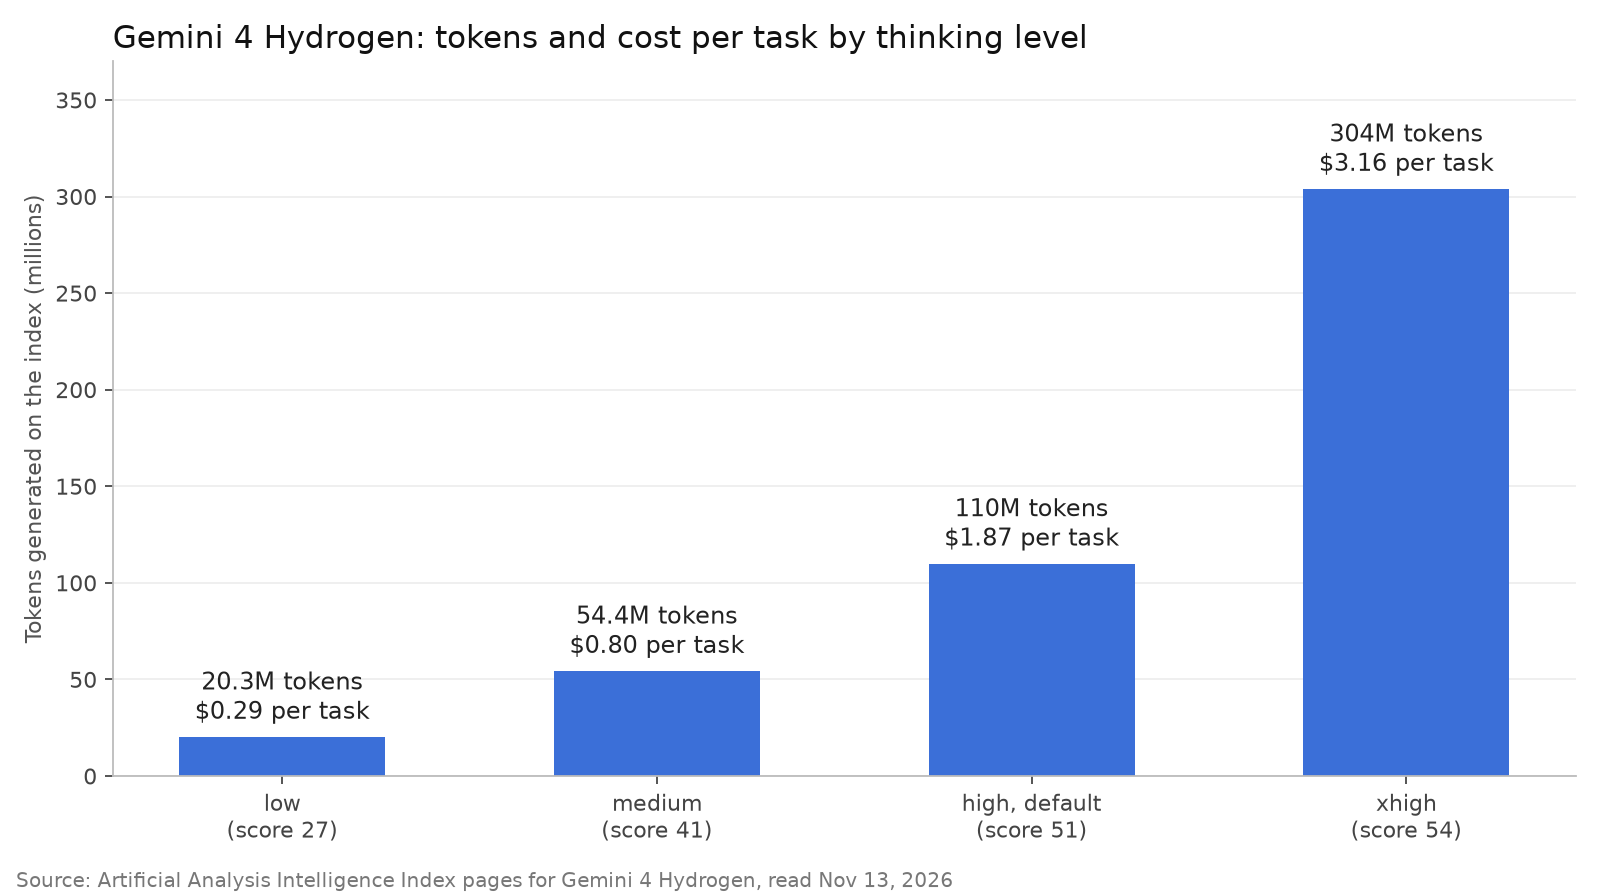
อ่านตารางนี้ในเชิงสัดส่วน การเลื่อนจาก high ไป xhigh สร้าง token มากขึ้นประมาณ 2.8 เท่าและเพิ่มต้นทุนต่องานประมาณ 1.7 เท่า แลกกับคะแนน index ที่สูงขึ้น 3 คะแนน การลดจาก high ไป low ตัด token เหลือไม่ถึงหนึ่งในห้า
หน้า What’s new in Gemini 4 Hydrogen ของ Google เตือนว่า xhigh “อาจทำให้เกิด overthinking ใน prompt ที่ง่าย” และแนะนำให้เลือก “thinking_level ที่ต่ำที่สุดที่ตอบโจทย์คุณภาพที่คุณต้องการ” โปรดทราบว่า max_output_tokens จำกัด thinking และ output รวมกัน
การเรียก Gemini 4 Hydrogen หนึ่งครั้งมีค่าใช้จ่ายเท่าไร?
ทุกคำขอคำนวณจากสูตรเดียวกัน ดึงจำนวน token จากออบเจ็กต์ usage ใน response (total_input_tokens, total_cached_tokens, total_thought_tokens, total_output_tokens):
cost = (uncached_input x $1.50 / 1M)
     + (cached_input   x $0.075 / 1M)
     + ((thought + output) x $7.50 / 1M)
สองตัวอย่างด้านล่างใช้จำนวน token สมมติขึ้น ไม่ใช่ค่าที่วัดจริง ให้แทนด้วยค่าของคุณเอง
ตัวอย่างที่ 1: การเรียกแบบแชทที่ระดับ high Input 2,000 token, thinking 1,500 token, output 600 token
| รายการ | Standard | Batch หรือ Flex |
|---|---|---|
| Input (2,000) | $0.0030 | $0.0015 |
| Thinking + output (2,100) | $0.0158 | $0.0079 |
| รวมต่อการเรียกหนึ่งครั้ง | $0.0188 | $0.0094 |
| 10,000 ครั้งต่อเดือน | $187.50 | $93.75 |
ตัวอย่างที่ 2: agent loop Coding agent ทำงาน 40 รอบ เนื่องจากส่งบทสนทนาซ้ำทุกรอบ จึงอ่าน input รวม 1.2M token โดย 900K ในนั้นตรงกับ implicit cache และใช้ thinking 200K token พร้อมเขียนโค้ดและ tool call 60K token
| รายการ | Standard | Batch หรือ Flex | Priority |
|---|---|---|---|
| Uncached input (300K) | $0.45 | $0.23 | $0.81 |
| Cached input (900K) | $0.07 | $0.03 | $0.12 |
| Thinking + output (260K) | $1.95 | $0.98 | $3.51 |
| รวมต่อการรันหนึ่งครั้ง | $2.47 | $1.23 | $4.44 |
ประมาณ 79% ของบิล Standard มาจาก thinking และ output ดังนั้นระดับ thinking สำคัญกว่าการย่อ prompt โค้ดคำขอสำหรับทั้งสองตัวอย่างอยู่ใน คู่มือ Gemini 4 Hydrogen API ของเรา
ราคา Hydrogen เทียบกับ Carbon, Argon และ Gemini 3.8 Flash อย่างไร?
อัตราแพ็กเกจ Standard ต่อ token 1 ล้านตัวจากหน้าราคาของ Google อ่านเมื่อวันที่ 13 พฤศจิกายน 2026:
| โมเดล | Input | Output | Cached input | Free tier |
|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.075 | มี |
| Gemini 4 Carbon (ถึง 30 พ.ย.) | $2.00 | $10.00 | $0.10 | ไม่มี |
| Gemini 4 Carbon (ตั้งแต่ 1 ธ.ค.) | $4.00 | $20.00 | $0.20 | ไม่มี |
| Gemini 4 Argon (ถึง 30 พ.ย.) | $2.00 | $10.00 | $0.10 | ไม่มี |
| Gemini 4 Argon (ตั้งแต่ 1 ธ.ค.) | $4.00 | $20.00 | $0.20 | ไม่มี |
| Gemini 3.8 Flash (ถึง 31 ธ.ค.) | $0.75 | $3.75 | $0.075 | มี |
| Gemini 3.8 Flash (ตั้งแต่ 1 ม.ค. 2027) | $1.50 | $7.50 | $0.15 | มี |
ลองคำนวณจำนวน token จาก agent loop ในตัวอย่างที่ 2 ด้วยราคาแต่ละตัว จะได้ $2.47 บน Hydrogen, $3.29 บน Carbon หรือ Argon เดือนนี้และ $6.58 ตั้งแต่วันที่ 1 ธันวาคม และ $1.27 บน Gemini 3.8 Flash จนถึงวันที่ 31 ธันวาคม เมื่อราคา Flash ปรับขึ้นในวันที่ 1 มกราคม 2027 token ชุดเดิมจะมีค่าใช้จ่าย $2.54 บน Flash ซึ่งแพงกว่า Hydrogen เล็กน้อยเพราะอัตรา cached ของ Flash เพิ่มเป็นสองเท่าที่ $0.15 ดูรายละเอียดการเปลี่ยนราคาของโมเดลระดับ frontier ได้ที่คู่มือ ราคา Gemini 4 Carbon และ ราคา Gemini 4 Argon ของเรา
แต่การเทียบแบบ token เท่ากันไม่ใช่การเปรียบเทียบที่แท้จริง เพราะแต่ละโมเดลใช้จำนวน token ต่องานไม่เท่ากัน หน้า Intelligence Index ของ Artificial Analysis ให้มุมมองหนึ่ง:
| โมเดล (ระดับ thinking) | คะแนน Index | Token ที่สร้าง | ต้นทุนต่องาน index |
|---|---|---|---|
| Gemini 4 Hydrogen (high) | 51 | 110M | $1.87 |
| Gemini 4 Hydrogen (xhigh) | 54 | 304M | $3.16 |
| Gemini 4 Argon (high) | 50 | 113M | $4.97 |
| Gemini 4 Carbon (high) | 60 | 205M | $5.48 |
| Gemini 3.8 Flash (high) | 31 | 126M | ไม่ได้เปรียบเทียบที่นี่ |
บน benchmark นี้ Hydrogen ที่ค่าเริ่มต้นทำคะแนนเท่า Argon ที่ต้นทุนต่องานประมาณ 38% ของ Argon ส่วน Carbon ได้คะแนนสูงสุด ให้ถือว่านี่คือมุมมองของ benchmark หนึ่งเท่านั้น Google ยังระบุว่า Hydrogen ทำงานเสร็จเร็วกว่า Gemini 3.8 Flash 2.5 เท่าที่ระดับ high
การเลือกใช้จริง: Hydrogen สำหรับงานเขียนโค้ดและ agent ในชีวิตประจำวัน Carbon สำหรับงานสถาปัตยกรรมที่ยาก การดีบัก และการตรวจสอบความปลอดภัย ใน Antigravity ตัวเลือก Orchestrator จะสลับระหว่าง Carbon กับ Hydrogen ภายในการรันเดียว ส่วนการเปรียบเทียบฝั่ง frontier อยู่ใน การเปรียบเทียบ Gemini 4 Carbon vs Argon ของเรา
วิธีลดบิล Gemini 4 Hydrogen ของคุณ
- ใช้ Batch หรือ Flex กับงานที่รอได้ ทั้งสองแพ็กเกจราคาครึ่งหนึ่ง
- เลือกระดับ thinking ที่ต่ำที่สุดที่ผ่าน eval ของคุณ
mediumใช้ token ประมาณครึ่งหนึ่งของhigh - เก็บ
xhighไว้ใช้กับงานที่ยากจริง ๆ - คง prompt prefix ให้คงที่ เพื่อให้ implicit caching คิดค่า input ที่ซ้ำที่ $0.075 ต่อ 1M ซึ่งถูกลง 95%
- ทำ prototype บน Free tier
วัดต้นทุนจริงของ Gemini 4 Hydrogen ด้วย Apidog CLI
บิลของคุณมาจาก prompt ของคุณเอง วิธีที่เร็วที่สุดเพื่อให้ได้ตัวเลขจริงคือให้ coding agent ของคุณ (Claude Code, Codex, Cursor) รัน prompt ของคุณทุกระดับ thinking ผ่าน Apidog CLI และบันทึกออบเจ็กต์ usage ของแต่ละรอบ
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ใส่ prompt จริงของคุณ 5–10 อันใน levels.csv หนึ่งแถวต่อหนึ่ง prompt และหนึ่งระดับ thinking โดยมีคอลัมน์ prompt และ thinking_level (low, medium, high, xhigh) จากนั้นสั่ง agent ด้วย prompt เดียว:
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model "gemini-4-hydrogen", input {{prompt}} and
generation_config.thinking_level {{thinking_level}}. Assert status 200,
status "completed", non-empty output, and a usage object that includes
total_input_tokens and total_output_tokens. In a post-processor, read
total_input_tokens, total_cached_tokens, total_thought_tokens and
total_output_tokens, compute cost at $1.50 input, $0.075 cached and
$7.50 output per 1M, and log it. Run every row of levels.csv and give me
a table of tokens and cost per prompt and thinking level.
Agent จะตรวจรูปแบบ payload ก่อนเขียนอะไรก็ตาม แล้วรันทุกแถว:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d levels.csv -r cli,json --out-file hydrogen-cost-{GENERATE_TIME}
รายงาน JSON จะแสดงว่าแต่ละระดับ thinking มีต้นทุนเท่าไรกับ workload ของคุณ เพิ่ม -r junit แล้วคำสั่งเดียวกันจะรันใน CI ได้ โดย assertion วงเงิน token สามารถทำให้ build ล้มเหลวได้ คู่มือ Apidog CLI CI/CD แสดง pipeline และ Apidog CLI ใน Claude Code ครอบคลุมการตั้งค่า agent แผน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน
ทางลัด: บอก agent ของคุณว่า “อ่าน https://apidog.com/apidog-cli-installation-guide.md แล้วตั้งค่า Apidog CLI ให้หน่อย”
คำถามที่พบบ่อย
Gemini 4 Hydrogen ฟรีหรือไม่? บน API ฟรีครับ ภายใต้ข้อจำกัดอัตราการใช้งานของ Free tier: Google ระบุ input และ output ของ Standard ว่า “Free of charge” บน Free tier ส่วน Batch, Flex และ Search grounding ต้องใช้ key แบบเสียเงิน ดู คู่มือการใช้ Gemini 4 Hydrogen ฟรี ของเรา
ราคา Gemini 4 Hydrogen จะขึ้นแบบ Carbon ไหม? หน้าราคาของ Google ระบุอัตราเดียว $1.50/$7.50 สำหรับ Hydrogen โดยไม่มีช่วงราคาเปิดตัวหรือวันสิ้นสุด Carbon และ Argon มีราคาเปิดตัวพร้อมกำหนดวันที่ แต่ Hydrogen ไม่มี
Thinking token ของ Gemini 4 Hydrogen มีค่าบริการไหม? มีครับ ที่อัตรา output $7.50 ต่อ 1M บน Standard ออบเจ็กต์ usage ใน response จะรายงานแยกต่างหากเป็น total_thought_tokens
Gemini 4 Hydrogen ถูกกว่า Gemini 3.8 Flash หรือไม่? ปีนี้ยังไม่: Flash มีค่าใช้จ่าย $0.75/$3.75 จนถึงวันที่ 31 ธันวาคม 2026 ตั้งแต่วันที่ 1 มกราคม 2027 Flash จะขึ้นเป็น $1.50/$7.50 เท่ากับอัตราต่อ token ของ Hydrogen และบน index ของ Artificial Analysis Hydrogen ได้ 51 คะแนน ส่วน Flash ได้ 31