
API ของ Gemini 4 Hydrogen ใช้ model ID ว่า gemini-4-hydrogen โดยเรียกใช้งานผ่าน POST ไปที่ https://generativelanguage.googleapis.com/v1beta/interactions โดยใส่ API key ของคุณใน header x-goog-api-key และส่ง model พร้อมกับ input ใน JSON body โมเดลนี้ใช้งานได้ทั้งแพ็กเกจฟรีและแพ็กเกจเสียเงิน ($1.50 สำหรับ input, $7.50 สำหรับ output ต่อ 1M tokens) โดยค่าเริ่มต้นจะตั้งระดับความคิด (thinking level) เป็น high
คู่มือนี้จะพาคุณไปทุกขั้นตอน: การขอ key, คำขอแรก, ระดับความคิด, การส่ง PDF, function calling, streaming และการจัดการข้อผิดพลาด ชื่อฟิลด์ทุกตัวมาจากเอกสารประกอบของ Google
คุณต้องเตรียมอะไรบ้างก่อนเรียกใช้ Gemini 4 Hydrogen API เป็นครั้งแรก?
คุณต้องมี Gemini API key, model ID gemini-4-hydrogen และ Interactions endpoint Google เปิดตัว Hydrogen เมื่อวันที่ 12 พฤศจิกายน 2026 ในฐานะโมเดล Gemini 4 ที่เร็ว ซึ่งวางขายคู่กับ Carbon และ Argon (Gemini 4 Hydrogen คืออะไร)
| รายการ | ค่า |
|---|---|
| Model ID | gemini-4-hydrogen |
| Endpoint | POST /v1beta/interactions บน generativelanguage.googleapis.com |
| Header สำหรับยืนยันตัวตน | x-goog-api-key: $GEMINI_API_KEY |
| API | Interactions API และ generateContent |
| ระดับความคิด | low, medium, high (ค่าเริ่มต้น), xhigh |
| Context window | 1,048,576 tokens ใช้ร่วมกันระหว่าง input, ความคิด และ output |
| Output ต่อการเรียกแบบ synchronous หนึ่งครั้ง | 65,536 tokens ไม่ว่าจะ streaming หรือไม่ก็ตาม |
| แพ็กเกจฟรี | มี แต่จำกัดอัตราการเรียกใช้ |
| ราคาแพ็กเกจเสียเงิน | $1.50 / 1M input, $7.50 / 1M output (รวมส่วนของความคิดแล้ว) |
| Cached input | $0.075 / 1M ผ่านการแคชแบบ implicit |
เอกสารประกอบของ Google ระบุว่า generateContent เป็นแบบ legacy ดังนั้นตัวอย่างเหล่านี้จึงใช้ Interactions
จะขอ Gemini API key สำหรับ Hydrogen ได้อย่างไร?
Hydrogen อยู่ในแพ็กเกจฟรี คุณจึงเริ่มต้นได้โดยไม่ต้องผูกบัญชีเรียกเก็บเงิน:
- เปิดหน้า API keys ใน Google AI Studio
- คลิก Create API key key ใหม่ที่สร้างใน AI Studio จะเป็น authorization key ที่ผูกกับ service account
- ส่งออก key:
export GEMINI_API_KEY="YOUR_API_KEY"SDK จะอ่านค่าจากGEMINI_API_KEYหรือGOOGLE_API_KEYถ้าตั้งค่าไว้ทั้งคู่GOOGLE_API_KEYจะมีผลเหนือกว่า - Cloud project ที่สร้างนอก AI Studio อาจต้องทำการยืนยัน project ก่อนจึงจะใช้แพ็กเกจฟรีได้
Google เผยแพร่ตัวเลขของแพ็กเกจฟรีไว้ในหน้า rate limits ไม่ได้อยู่ในคู่มือเปิดตัว คู่มือGemini 4 Hydrogen ฟรีของเราอธิบายสิ่งที่คุณได้รับในราคา $0
จะส่งคำขอ Gemini 4 Hydrogen API แรกได้อย่างไร?
ส่ง model และ input ไปยัง Interactions endpoint เก็บชื่อโมเดลไว้ในตัวแปรเพื่อให้เปลี่ยนโมเดลได้ง่ายเพียงแก้บรรทัดเดียว
export GEMINI_MODEL="gemini-4-hydrogen"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Write a Python function that retries an HTTP call with exponential backoff."
  }'
การเรียกแบบเดียวกันด้วย Python SDK (pip install -U google-genai):
import os
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model=os.environ.get("GEMINI_MODEL", "gemini-4-hydrogen"),
    input="Write a Python function that retries an HTTP call with exponential backoff.",
)

print(interaction.output_text)
print(interaction.usage)
คำตอบจะประกอบด้วย id, status และอาร์เรย์ steps ข้อความอยู่ในขั้นตอน model_output ส่วนเหตุผลการคิดอยู่ในขั้นตอน thought และ output_text ของ SDK จะรวมข้อความให้คุณอัตโนมัติ ออบเจ็กต์ usage เก็บค่า total_input_tokens, total_thought_tokens, total_output_tokens และ total_tokens
โค้ดตัวอย่างเหล่านี้อ้างอิงจาก quickstart ของ Google เราไม่ได้รันมันจริงสำหรับบทความนี้ (ไม่มี Gemini key บนเครื่องทดสอบของเรา) ดังนั้นให้ตรวจสอบโครงสร้างกับคำตอบแรกของคุณเองด้วย
จะตั้งระดับความคิดของ Gemini 4 Hydrogen อย่างไร?
ตั้งค่า thinking_level ภายใน generation_config Hydrogen ค่าเริ่มต้นเป็น high เพิ่มระดับใหม่ xhigh และจะปฏิเสธ minimal พร้อมแจ้งข้อผิดพลาด
thinking_level |
การใช้ tokens | กรณีที่ Google แนะนำ |
|---|---|---|
low |
ใช้ tokens น้อยที่สุด latency ต่ำสุด | แชทที่ต้องเร็ว, การประมวลผลปริมาณสูง |
medium |
ใช้ tokens น้อยลง เร็วขึ้น | เขียนโค้ดแบบโต้ตอบ, ต้นแบบ UI แบบสด, เรียกใช้เครื่องมืออย่างรวดเร็ว |
high (ค่าเริ่มต้น) |
สมดุล | เขียนโค้ดที่ซับซ้อน, งาน agentic, งานเอกสารแบบ multimodal |
xhigh |
ใช้ tokens มากที่สุด คิดลึกที่สุด | ปัญหาหลายขั้นตอนที่ยากซึ่ง high ไม่พอ |
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "medium",
      "max_output_tokens": 65536
    }
  }'
มีสองกฎที่สำคัญ max_output_tokens จำกัดส่วนความคิดและ output รวมกัน ดังนั้นการตั้งค่าต่ำแบบเดิม (เช่น 8,192) อาจตัดคำตอบให้สั้นลง Google แนะนำให้เพิ่มเป็น 65,536 แล้วลดระดับความคิดแทน และ tokens ส่วนความคิดถูกคิดค่าใช้จ่ายที่อัตรา output $7.50 ดังนั้น xhigh จึงแพงกว่าแม้คำตอบที่มองเห็นจะยาวเท่าเดิม การแจกแจงราคาของ Gemini 4 Hydrogen คำนวณตัวเลขให้ดูทีละระดับ
Google ยังระบุด้วยว่าเซิร์ฟเวอร์จะละเว้น temperature, top_p และ top_k บน Hydrogen จึงควรตัดออกจากคำขอของคุณ
จะส่ง PDF ไปยัง Gemini 4 Hydrogen ได้อย่างไร?
เพิ่มรายการ document เข้าไปในอาร์เรย์ input คู่กับรายการ text ที่ใส่คำสั่งของคุณ สำหรับไฟล์ขนาดเล็ก ส่ง PDF แบบ inline เป็น base64 ได้เลย:
PDF_PATH="invoice.pdf"
B64=$(base64 < "$PDF_PATH" | tr -d '\n')

curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": [
      {"type": "document", "data": "'"$B64"'", "mime_type": "application/pdf"},
      {"type": "text", "text": "Extract the line items as a table."}
    ]
  }'
สำหรับไฟล์ขนาดใหญ่หรือใช้ซ้ำหลายเทิร์น อัปโหลดครั้งเดียวด้วย Files API (ฟรี เก็บไว้ 48 ชั่วโมง) แล้วส่ง {"type": "document", "uri": "<file uri>", "mime_type": "application/pdf"} แทน ตามคู่มือการประมวลผลเอกสาร PDF มีขนาดได้ถึง 50 MB หรือ 1,000 หน้า และโมเดลสามารถอ่านแผนภูมิ ตาราง และรูปภาพในไฟล์ได้ ไม่ใช่แค่ข้อความ
Function calling ทำงานกับ Gemini 4 Hydrogen อย่างไร?
ประกาศฟังก์ชันของคุณใน tools โมเดลไม่ได้รันอะไรเอง แต่จะส่งคืนขั้นตอน function_call โค้ดของคุณเป็นผู้รันฟังก์ชัน แล้วคุณส่งผลลัพธ์กลับเป็น function_result นี่คือขั้นตอนแรก จากคู่มือ function calling ของ Google:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "What'\''s the temperature in London?",
    "tools": [{
      "type": "function",
      "name": "get_current_temperature",
      "description": "Gets the current temperature for a given location.",
      "parameters": {
        "type": "object",
        "properties": {
          "location": {"type": "string", "description": "The city name"}
        },
        "required": ["location"]
      }
    }]
  }'
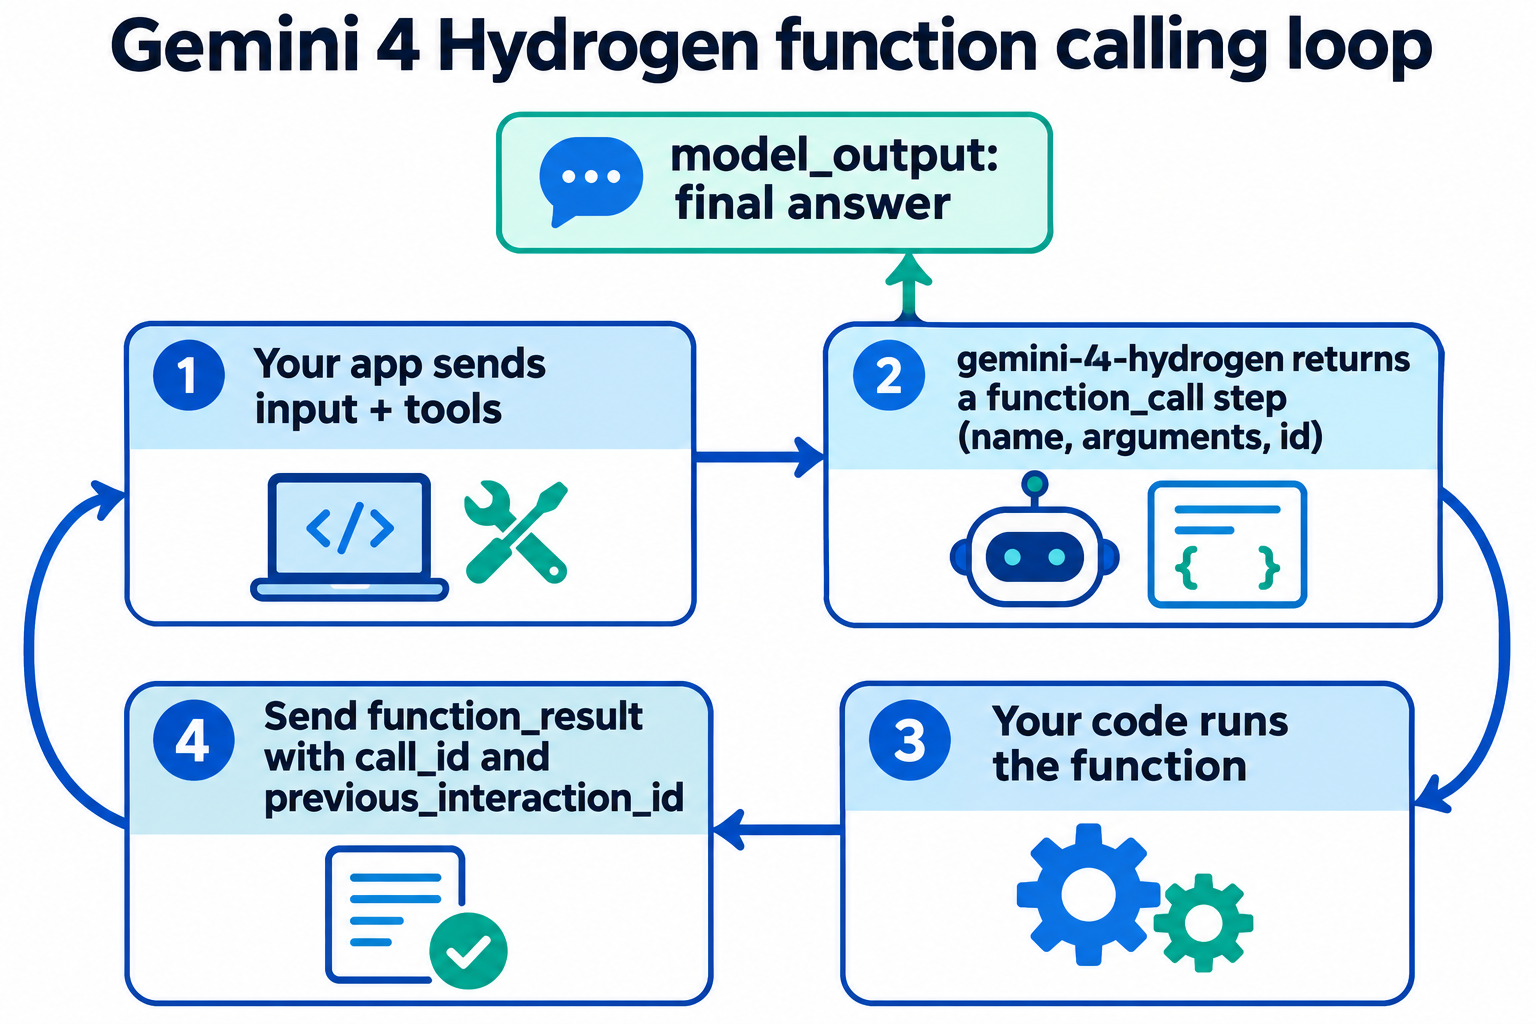
ค้นหาขั้นตอนที่ type เป็น function_call แล้วอ่านค่า name, arguments และ id ของมัน รันฟังก์ชันของคุณ จากนั้นส่งผลลัพธ์กลับในเซสชันเดิม:
fc = next(s for s in interaction.steps if s.type == "function_call")
result = get_current_temperature(**fc.arguments)

final = client.interactions.create(
    model="gemini-4-hydrogen",
    input=[{
        "type": "function_result",
        "name": fc.name,
        "call_id": fc.id,
        "result": [{"type": "text", "text": json.dumps(result)}],
    }],
    tools=[weather_function],
    previous_interaction_id=interaction.id,
)
print(final.output_text)
previous_interaction_id เก็บสถานะของบทสนทนาและส่วนความคิดไว้ฝั่ง Google คุณจึงไม่ต้องส่งประวัติซ้ำ มีข้อควรระวังจาก migration notes ของ Google: การสั่งให้โมเดลพิมพ์ "tool calls" เป็น JSON ดิบโดยไม่ประกาศ tools อาจคืนค่า MALFORMED_FUNCTION_CALL ให้ประกาศ tools แบบ native หรือใช้ structured outputs แทน
จะรับคำตอบแบบ streaming จาก Gemini 4 Hydrogen ได้อย่างไร?
เพิ่ม "stream": true ใน body API จะตอบกลับด้วย Server-Sent Events:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  --no-buffer \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Explain idempotency keys in three short paragraphs.",
    "stream": true
  }'
ตามคู่มือ streaming ของ Google คุณจะได้รับ interaction.created ตามด้วย step.start, step.delta และ step.stop สำหรับแต่ละขั้นตอน (thought ก่อน แล้วจึง model_output) และจบด้วย interaction.completed พร้อม usage สุดท้าย ให้นำ delta.text จากขั้นตอน model_output มาต่อกันเพื่อสร้างคำตอบ Streaming ไม่ได้เพิ่มเพดาน output: แต่ละ hop ยังหยุดที่ 65,536 tokens เหมือนเดิม สำหรับ output ที่ยาวกว่านั้น ให้ตั้ง "background": true พร้อม max_output_tokens มากกว่า 65,536 แล้ว poll GET /v1beta/interactions/{id} จนกว่า status ออกจากสถานะ in_progress หรือ queued
จะจัดการข้อผิดพลาดของ Gemini 4 Hydrogen API อย่างไร?
ข้อผิดพลาดแบบไม่ streaming จะกลับมาเป็น HTTP status พร้อมออบเจ็กต์ error ที่มี code และ message ส่วนใน stream คุณจะได้รับ event error ที่มีฟิลด์เดียวกัน โค้ดที่คุณจะเจอบ่อยที่สุด จากหน้า API errors ของ Google:
| HTTP | code |
สิ่งที่ควรทำ |
|---|---|---|
| 400 | invalid_request |
แก้ไข payload; ตรวจสอบชื่อฟิลด์กับเอกสารประกอบ |
| 403 | permission_denied |
ตรวจสอบสิทธิ์ของ key, การยืนยัน หรือการเรียกเก็บเงิน |
| 404 | model_not_found |
ตรวจสอบว่าชื่อโมเดลเป็น gemini-4-hydrogen |
| 429 | rate_limit_exceeded |
ถอยเวลาแล้วลองใหม่ |
| 429 | quota_exceeded |
ใช้โควตารายวันหมด; รอรีเซ็ต |
| 503 | service_unavailable |
ถอยเวลาแล้วลองใหม่ |
คู่มือแก้ปัญหาของ Google แนะนำให้ retry เฉพาะ 429, 408 และ 5xx โดยใช้ exponential backoff ร่วมกับ jitter และจำกัดจำนวนครั้ง retry และไม่ควร retry 400, 402 หรือ 403 เลย Python SDK ทำการ retry ข้อผิดพลาดชั่วคราวให้อัตโนมัติถึงสี่ครั้งแล้ว
ให้ coding agent ของคุณทดสอบ Hydrogen API ด้วย Apidog CLI
แทนที่จะอ่าน JSON ทุกครั้งหลังเปลี่ยน prompt หรือระดับความคิด ให้ coding agent ของคุณ (Claude Code, Codex, Cursor) สร้างชุดทดสอบที่ใช้ซ้ำได้ แล้วรันด้วย Apidog CLI
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง agent ของคุณด้วย prompt เดียว:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING (default "low"). Add an endpoint for POST /v1beta/interactions with the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-hydrogen", a short prompt and generation_config.thinking_level
{{THINKING}}, and asserts: HTTP 200, status is "completed", steps contains a
non-empty model_output, and usage.total_tokens exists. Run it at low and at high,
then compare usage.total_thought_tokens.
Agent จะตรวจสอบ payload แต่ละอันกับ schema ของ CLI ก่อนเขียนอะไรลงไป:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=low" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=high" -r cli,json
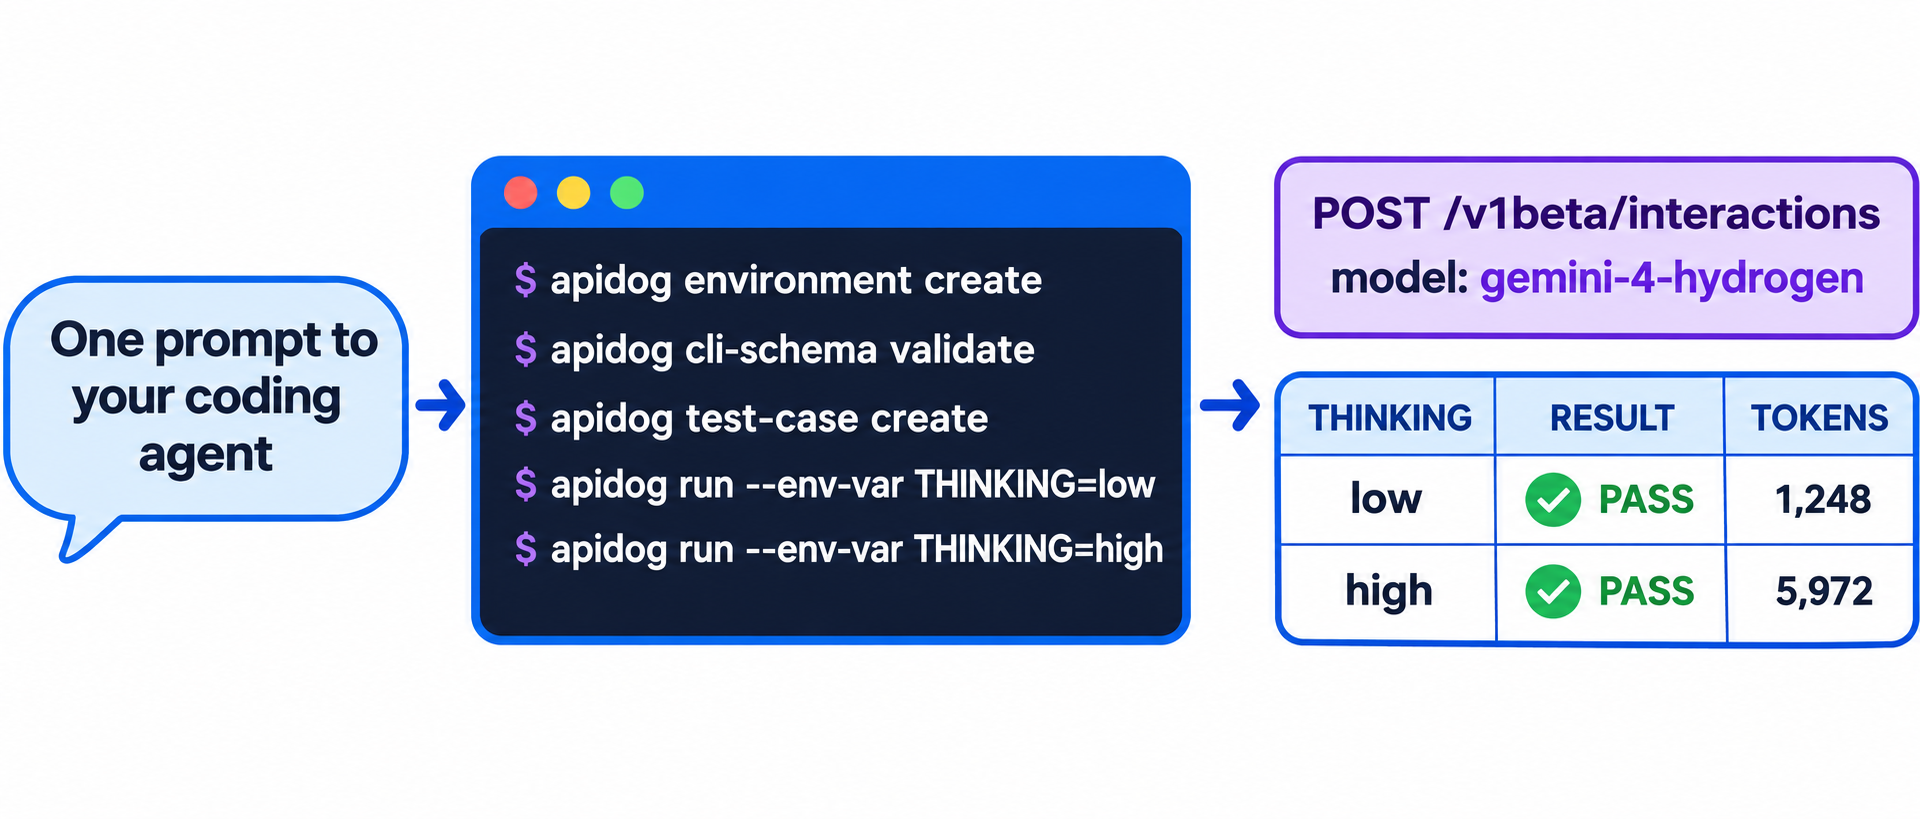
สองการรันนี้เปรียบเทียบ thought tokens สำหรับ prompt เดียวกัน ซึ่งเป็นตัวเลขที่กระทบค่าใช้จ่ายของคุณ เปลี่ยน -r cli,json เป็น -r junit แล้วการรันเดิมจะใส่ลง CI ได้เลย คู่มือ CI/CD ของ Apidog CLI แสดง pipeline และ Apidog CLI ใน Claude Code อธิบายการตั้งค่า agent แผน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน
คำถามที่พบบ่อย
Model ID ของ Gemini 4 Hydrogen คืออะไร? gemini-4-hydrogen ใช้ได้กับทั้ง Interactions API และ generateContent
Gemini 4 Hydrogen API ฟรีหรือไม่? ฟรี ภายใต้ข้อจำกัดบางประการ Google ระบุ Hydrogen ไว้ในแพ็กเกจฟรีของ Gemini API และ AI Studio โดยมีการจำกัดอัตราการเรียกใช้ การใช้แบบเสียเงินมีค่าใช้จ่าย $1.50 ต่อ 1M input tokens และ $7.50 ต่อ 1M output tokens
จะย้ายจาก Gemini 3.8 Flash มาอย่างไร? เปลี่ยนชื่อโมเดล เพิ่มค่า max_output_tokens ที่ตั้งไว้ต่ำ ตัด temperature, top_p, top_k และการแคชแบบ explicit (cachedContents) ออก และเปลี่ยน minimal เป็น low หรือ medium
Hydrogen รองรับ context caching หรือไม่? รองรับเฉพาะแบบ implicit ซึ่งทำงานอัตโนมัติกับ prompt ที่มีอย่างน้อย 4,096 tokens และลดราคา cache hit ลง 95% ไม่รองรับการแคชแบบ explicit
Hydrogen ต่างจาก Gemini 4 Argon ใน API อย่างไร? โครงสร้างคำขอเหมือนกัน Hydrogen ค่าเริ่มต้นเป็น high และเพิ่ม xhigh ขณะที่ Argon ค่าเริ่มต้นเป็น medium ดูเพิ่มเติมที่คู่มือ Gemini 4 Argon API, คู่มือ Gemini 4 Carbon API และ Gemini 4 Hydrogen Orchestrator สำหรับการใช้โมเดลคู่กัน