
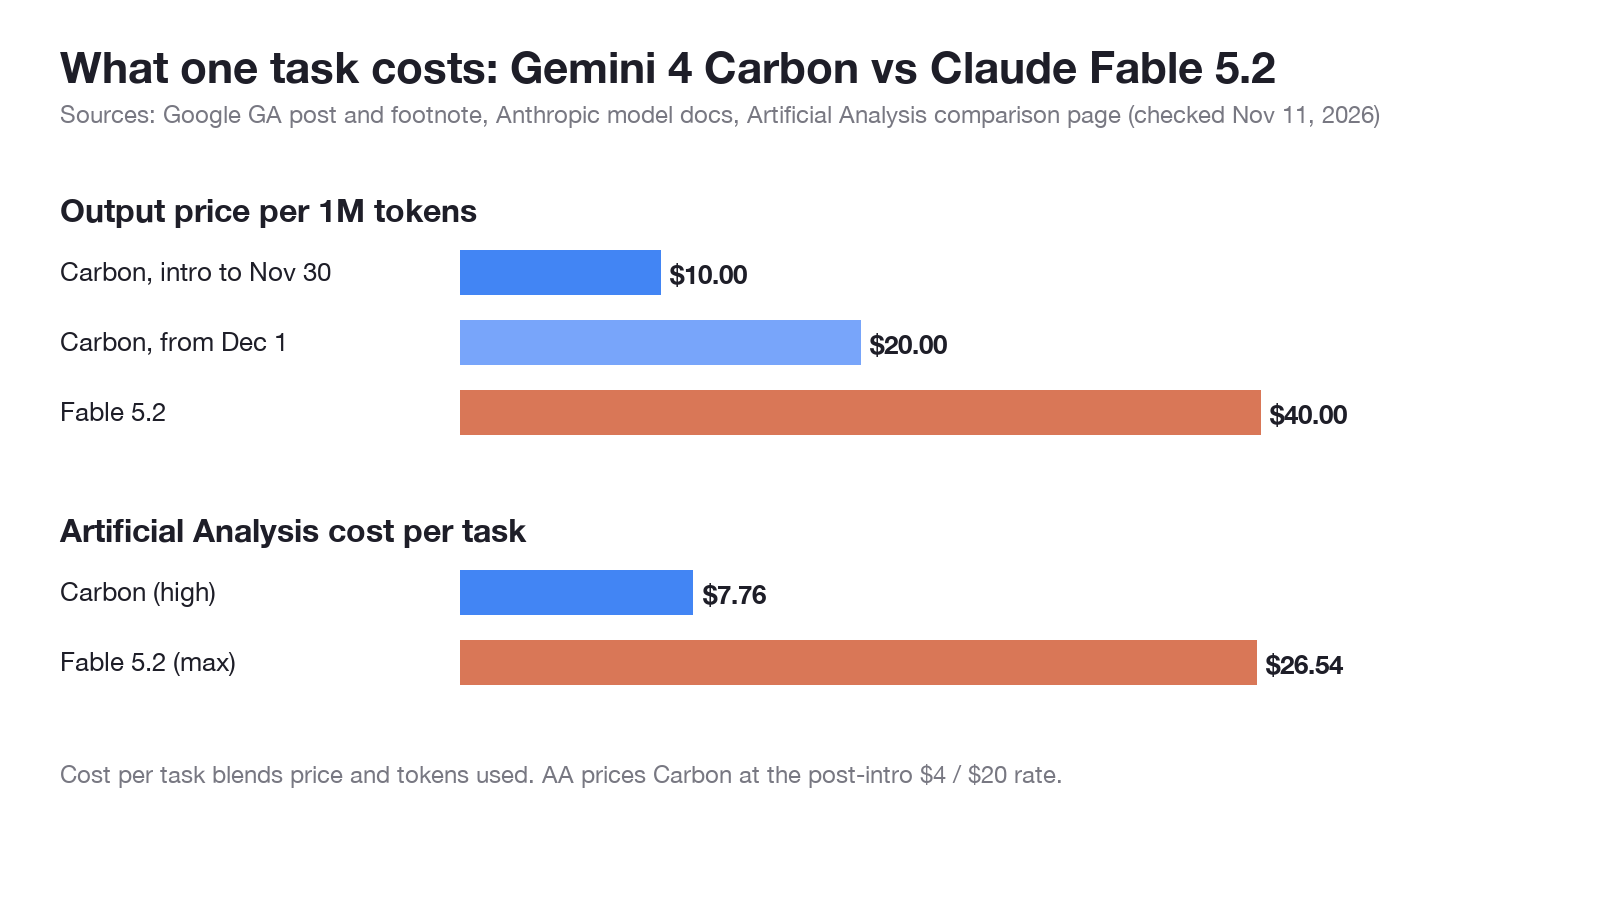
ข้อมูล ณ วันที่ 11 พฤศจิกายน 2026 Gemini 4 Carbon ของ Google เป็นโมเดลที่ราคาถูกกว่า และ Claude Fable 5.2 เป็นโมเดลที่แข็งแกร่งกว่าตามเกณฑ์มาตรฐาน (benchmark) ด้าน coding และ agent ที่เผยแพร่สู่สาธารณะส่วนใหญ่ Carbon มีราคา $2 / $10 ต่อ token 1 ล้านตัว (input/output) จนถึงวันที่ 30 พฤศจิกายน (จากนั้น $4 / $20) ส่วน Fable 5.2 มีราคา $8 / $40 โดย Artificial Analysis ระบุต้นทุนต่อหนึ่งงานที่ $7.76 เทียบกับ $26.54
ทั้งสองเปิดตัวห่างกันเพียงหนึ่งวัน (Fable 5.2 วันที่ 9 พฤศจิกายน, Carbon GA วันที่ 10 พฤศจิกายน) และตารางของผู้ให้บริการแต่ละรายก็มักเอนเอียงไปทางโมเดลของตัวเอง คู่มือนี้จะแยกตัวเลขทุกตัวตามผู้วัดผล แล้วจึงแสดงวิธีทดสอบ A/B ทั้งสองโมเดลด้วยคำสั่ง (request) ของคุณเอง
Gemini 4 Carbon vs Claude Fable 5.2: สรุปผลอย่างรวดเร็ว
เลือก Gemini 4 Carbon เมื่อต้นทุนต่องานสำคัญที่สุด สำหรับ workflow ระบบอัตโนมัติด้านธุรกิจ หรืองานด้านความปลอดภัย เลือก Claude Fable 5.2 เมื่อคุณต้องการคะแนนสูงสุดในงาน coding ที่ยาก งาน terminal และ computer-use และพร้อมจ่ายราว 3.4 เท่าต่องาน สำหรับงานวิศวกรรมประจำวัน ทั้งสองผู้ให้บริการต่างแนะนำให้เริ่มจาก default ที่ราคาถูกกว่าก่อน
โพสต์ GA ของ Google ระบุว่า “Argon ยังคงเป็นตัวเลือกที่เหมาะสมที่สุดสำหรับงาน software engineering และงานด้านความรู้ส่วนใหญ่” และวางตำแหน่ง Carbon ไว้สำหรับงานที่ยากกว่าซึ่งโมเดลจะใช้ token มากขึ้นในการสำรวจและตรวจสอบ เอกสารโมเดลของ Anthropic ก็บอกสิ่งเดียวกันในรูปแบบของตัวเอง: เริ่มจาก Claude Opus 5.5 สำหรับ workload ส่วนใหญ่ แล้วจึงเปลี่ยนไป Fable 5.2 สำหรับงาน reasoning ที่ต้องการความแม่นยำสูงและงาน agentic ระยะยาว
ดังนั้นคุณจึงควรใช้ทั้งสองตัวนี้เมื่อโมเดล default ของคุณให้ผลไม่เป็นที่น่าพอใจ ยังตัดสินใจไม่ได้ว่าจะใช้อะไรเป็น default? อ่าน Gemini 4 Carbon vs Argon ก่อน
Gemini 4 Carbon และ Claude Fable 5.2 เทียบกันด้านราคาและสเปกอย่างไร?
นี่คือข้อมูลที่ผู้ให้บริการแต่ละรายเผยแพร่ พร้อมแหล่งที่มาของทุกแถว
| สเปก | Gemini 4 Carbon | Claude Fable 5.2 | แหล่งที่มา |
|---|---|---|---|
| Model ID | gemini-4-carbon |
claude-fable-5-2 |
Google, Anthropic |
| วันเปิดตัว | GA 10 พ.ย. 2026 | 9 พ.ย. 2026 | Google, Anthropic |
| ราคา input ต่อ 1 ล้าน token | $2 จนถึง 30 พ.ย. จากนั้น $4 | $8 ($16 ในโหมด fast) | Google footnote, Anthropic |
| ราคา output ต่อ 1 ล้าน token | $10 จนถึง 30 พ.ย. จากนั้น $20 | $40 ($80 ในโหมด fast) | Google footnote, Anthropic |
| Context window | 1 ล้าน token | 1 ล้าน token | AI Studio model card, เอกสาร Anthropic |
| Max output | 65K / 1M ตามที่ระบุ [VERIFY] | 128K token | AI Studio model card, เอกสาร Anthropic |
| Thinking | ปรับระดับ thinking ได้ | แบบ adaptive เปิดตลอด effort เริ่มต้น high |
Google quickstart, เอกสาร Anthropic |
| ใช้งานได้จากที่ใด | Gemini API paid tier, AI Studio, Android Studio, Gemini for business, Antigravity, CodeMender, Google AI Ultra | Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure | Google, Anthropic |
| Free API tier | ไม่ระบุ | ไม่ระบุ | Google, Anthropic |
โพสต์ GA ของ Google ไม่ได้กล่าวถึง Vertex AI, Gemini CLI หรือ GitHub Copilot ดังนั้นอย่าวางแผนบนเหล่านี้ก่อน ราคาเปิดตัวของ Carbon เท่ากับของ Argon ซึ่งทำให้เดือนพฤศจิกายนเป็นเดือนที่ถูกที่สุดสำหรับการประเมินผลของคุณ
ดูตารางราคาเต็มได้ที่ ราคา Claude Fable 5.2 และประกาศ Gemini 4 Carbon ของ Google
โมเดลใดชนะในด้าน benchmark?
ขึ้นอยู่กับว่าคุณอ่านตารางของใคร ดังนั้นนี่คือสามตารางที่แยกออกจากกันชัดเจน
ตารางของ Anthropic (เผยแพร่พร้อม Fable 5.2)
โพสต์เปิดตัว Fable 5.2 ของ Anthropic มีคอลัมน์ของ Gemini 4 Carbon รวมอยู่ด้วย หน้าดังกล่าวไม่ได้ระบุว่าใครเป็นผู้วัดผลของ Carbon จึงควรถือว่าเป็นตัวเลขที่ผู้ให้บริการรายงานเอง
| Benchmark (ตารางของ Anthropic) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69.9% | 61.2% |
| FrontierCode 2.0 | 49.1% (effort ระดับ xhigh) | 41.1% (effort ระดับ medium) |
| Terminal-Bench-Science 0.1 | 74.6% | 64.8% |
| OSWorld 2.1 (offline set, partial) | 89.3% | 81.5% |
| AA-Briefcase v1.1 (rubric) | 66.1% | 61.8% |
| Chartography (ไม่ใช้เครื่องมือ) | 73.4% | 72.5% |
| AutomationBench | 51.4% | 53.9% |
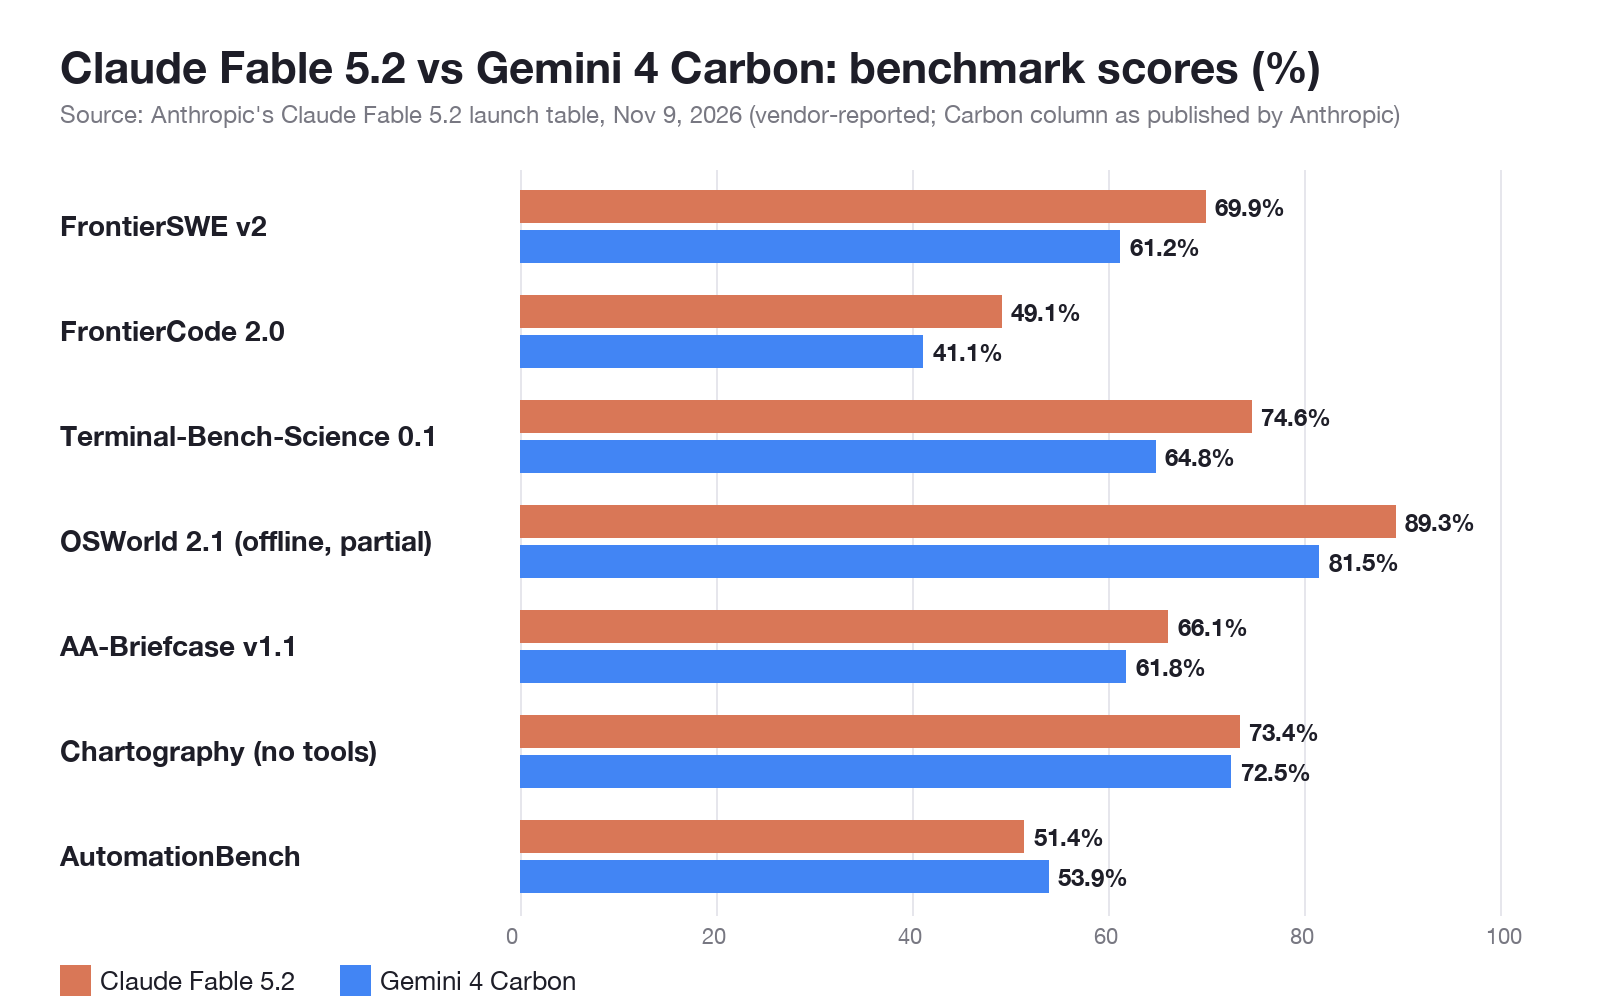
สังเกตแถว FrontierCode: Fable รันที่ effort ระดับ xhigh ส่วน Carbon รันที่ medium ความต่างของการตั้งค่าแบบนี้สำคัญพอ ๆ กับความต่างของคะแนน
ตารางของ Google (เผยแพร่พร้อม Carbon GA)
Google ไม่ได้เผยแพร่การเทียบตัวต่อตัวกับ Fable 5.2 แต่รายงาน leaderboard จากพาร์ทเนอร์แทน: Carbon อยู่อันดับหนึ่งบน CursorBench 4.0, WANDR ของ Perplexity และ AutomationBench ของ Zapier “ที่ต้นทุนต่องานต่ำกว่ากว่า 2 เท่าเมื่อเทียบกับโมเดลภายนอกที่ดีที่สุดอันดับถัดไป” และอยู่อันดับสองบน benchmark Multimodal Knowledge Agent ที่ต้นทุนเฉลี่ยต่องานต่ำกว่าโมเดลอันดับหนึ่งกว่า 6 เท่า Google ไม่ได้ระบุชื่อโมเดลคู่แข่งในข้อกล่าวอ้างเหล่านี้
Artificial Analysis (อิสระ)
หน้าเปรียบเทียบของ Artificial Analysis รันทั้งสองโมเดลผ่าน Intelligence Index v5.0.1 เดียวกัน:
| ตัวชี้วัด (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| Intelligence Index | 65 | 60 |
| ต้นทุนต่องาน | $26.54 | $7.76 |
| ต้นทุนรัน index เต็มรูปแบบ | $22,191 | $8,240 |
| ความเร็ว output | 103 token/s | 82 token/s |
Fable 5.2 (max) ครองตำแหน่งอันดับหนึ่งบน index นี้ในปัจจุบัน Carbon ได้คะแนนต่ำกว่า 5 คะแนนที่ต้นทุนต่องานราว 29% ของ Fable Artificial Analysis คิดราคา Carbon ที่ $4 / $20 ซึ่งเป็นราคาหลังเดือนพฤศจิกายน ตัวเลขต้นทุนจึงสะท้อนราคาเดือนธันวาคมแล้ว
Claude Fable 5.2 ชนะตรงไหน?
Fable 5.2 ชนะในงาน coding และ computer-use ที่ยากที่สุด ตามตัวเลขของ Anthropic:
- Coding ระดับ repository: 69.9% เทียบกับ 61.2% บน FrontierSWE v2
- งาน terminal และงานวิจัย: 74.6% เทียบกับ 64.8% บน Terminal-Bench-Science 0.1
- Computer use: 89.3% เทียบกับ 81.5% บน OSWorld 2.1
- Index อิสระ: 65 เทียบกับ 60 บน Artificial Analysis ซึ่งเป็นคะแนนเดียวที่ไม่มีผู้ให้บริการรายใดรันเอง
- ความยาว output: มีเอกสารระบุ max output 128K token ต่อคำสั่ง
ถ้างานที่ล้มเหลวหนึ่งงานทำให้วิศวกรเสียเวลาทั้งบ่าย การเพิ่มขึ้น 8 คะแนนบน FrontierSWE อาจคุ้มค่ากว่าค่า token สำหรับการตั้งค่า ดูคู่มือ Claude Fable 5.2 API
Gemini 4 Carbon ชนะตรงไหน?
Carbon ชนะด้านต้นทุนต่องาน และใน workload ที่ Google สร้างมันขึ้นมาเพื่อ:
- ต้นทุนต่องาน: $7.76 เทียบกับ $26.54 บน Artificial Analysis ถูกกว่าราว 3.4 เท่า
- ระบบอัตโนมัติด้านธุรกิจ: 53.9% เทียบกับ 51.4% บน AutomationBench ตามตารางของ Anthropic เอง
- ความปลอดภัย: เป็นผู้นำบน SEC-bench Pro, ExploitGym และ CWE-bench v1 ตามข้อมูลของ Google พร้อมโมเดล Carbon for cyber แบบ gated สำหรับผู้ดูแลความปลอดภัยผ่าน Fairwind Program
- ราคาในเดือนพฤศจิกายน: $2 / $10 จนถึงวันที่ 30 พฤศจิกายน ซึ่งเป็นหนึ่งในสี่ของอัตรา Fable ทั้งฝั่ง input และ output
- ทีม agent: preview /swarm ใน Google Antigravity เปลี่ยน prompt เดียวให้เป็นทีมที่ทำงานประสานกัน โดย Carbon ทำหน้าที่วางแผนและตรวจสอบ ในขณะที่โมเดลที่เบากว่าทำงานขนานกันไป
ยังไม่คุ้นเคยกับโมเดลนี้? เริ่มจากGemini 4 Carbon คืออะไร
หนึ่งงานจริง ๆ แล้วมีต้นทุนเท่าไร?
ราคาหน้าเว็บบอกอัตรา ไม่ได้บอกยอดบิล ต้นทุนของหนึ่งงานคือราคาคูณกับจำนวน token ที่โมเดลเลือกใช้ และ Google ระบุว่า Carbon ใช้ token มากขึ้นในการสำรวจและตรวจสอบ
ลองดูคำสั่งหนึ่งคำสั่งที่มี input 50,000 token และ output 10,000 token:
- Carbon, อัตราเปิดตัว: (0.05 x $2) + (0.01 x $10) = $0.20
- Carbon, ตั้งแต่ 1 ธันวาคม: (0.05 x $4) + (0.01 x $20) = $0.40
- Fable 5.2: (0.05 x $8) + (0.01 x $40) = $0.80
สมมติว่าทั้งสองปล่อย output 10,000 token แต่ความจริงไม่ใช่แบบนั้น ถ้า Carbon เขียน reasoning ยาว 30,000 token ในขณะที่ Fable เขียน 10,000 token ต้นทุนของ Carbon ในเดือนธันวาคมจะพุ่งไปที่ $0.80 และช่องว่างก็หายไป Artificial Analysis วัดผลจริงทั้งชุดการทดสอบและยังพบว่า Carbon ถูกกว่าต่องานราว 3.4 เท่า ซึ่งเป็นสัญญาณที่เชื่อถือได้ที่สุดเท่าที่คุณมี จนกว่าคุณจะวัดผลด้วยข้อมูลของตัวเอง
จะทดสอบ A/B Gemini 4 Carbon และ Claude Fable 5.2 ด้วยคำสั่งของคุณเองได้อย่างไร?
Benchmark คืองานของคนอื่น การทดสอบที่ยุติธรรมคือการส่ง prompt เดียวกันไปยังทั้งสอง API แล้วบันทึกจำนวน token และ latency เทียบกันไว้ข้างเคียง
ทั้งสอง call เป็น HTTP ธรรมดา นี่คือ request ของ Carbon สร้างจาก quickstart ของ Google สำหรับ Interactions API โดยวางชื่อโมเดลไว้ในตัวแปร:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2 ใช้ผ่าน Messages API ของ Anthropic โดยระบุ claude-fable-5-2 เป็นโมเดล
ให้ coding agent ของคุณรัน A/B ด้วย Apidog CLI
การรันคู่ request ด้วยมือเองเบื่อได้เร็วมาก ลองให้ Claude Code, Codex หรือ Cursor ควบคุม Apidog CLI แทน การตั้งค่าใช้เพียงสามคำสั่ง:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง agent ของคุณด้วย prompt เดียว:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
Agent จะตรวจสอบ schema เขียน test case และรันให้ พารามิเตอร์ด้านล่างมาจาก apidog run --help บน CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 ทำซ้ำแต่ละ case ห้าครั้ง เพื่อไม่ให้ response ที่ช้าเพียงครั้งเดียวตัดสินผลลัพธ์ เพิ่ม --upload-report เพื่อดูผลการรันในแอป Apidog นี่คือ template ของ workflow เรายังไม่ได้รันกับ Carbon จากเครื่องนี้ คู่มือ Apidog CLI ใน Claude Code อธิบายการตั้งค่า agent และคู่มือ Gemini 4 Argon API อธิบายฝั่ง request ของ Gemini
แผน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน ซึ่งเพียงพอสำหรับการเปรียบเทียบนี้
FAQ
Gemini 4 Carbon ดีกว่า Claude Fable 5.2 หรือไม่?
ไม่ใช่ในทุกด้าน Fable 5.2 ได้คะแนนสูงกว่าบน benchmark ของ Anthropic ส่วนใหญ่และบน index ของ Artificial Analysis (65 เทียบกับ 60) Carbon ชนะด้านต้นทุนต่องาน ($7.76 เทียบกับ $26.54) และบน AutomationBench
Gemini 4 Carbon ถูกกว่า Claude Fable 5.2 กี่เท่า?
ที่ราคาหน้าเว็บ Carbon ถูกกว่า 4 เท่าจนถึงวันที่ 30 พฤศจิกายน 2026 ($2 / $10 เทียบกับ $8 / $40 ต่อ 1 ล้าน token) และถูกกว่า 2 เท่าตั้งแต่วันที่ 1 ธันวาคม ($4 / $20) เมื่อวัดต่องานโดย Artificial Analysis ถูกกว่าราว 3.4 เท่า
ทั้งสองโมเดลมี context window 1 ล้าน token หรือไม่?
มี AI Studio model card ของ Google ระบุ 1 ล้าน token สำหรับ Carbon และเอกสารของ Anthropic ระบุ 1 ล้าน token สำหรับ Fable 5.2 max output ของ Fable คือ 128K token ส่วนลิมิต output ที่แน่นอนของ Carbon ให้ตรวจสอบจาก developer guide ของ Google
มี free tier สำหรับ Gemini 4 Carbon หรือ Claude Fable 5.2 บน API หรือไม่?
ไม่มีผู้ให้บริการรายใดระบุไว้ Carbon อยู่บน paid tier ของ Gemini API และในแอป Google AI Ultra ส่วน Fable 5.2 คิดค่าบริการตาม token
ควรเปลี่ยนโมเดล default เป็นตัวใดตัวหนึ่งเหล่านี้หรือไม่?
อาจไม่จำเป็น Google ระบุว่า Argon ยังคงเป็นตัวเลือกที่เหมาะสมสำหรับงาน software engineering และงานด้านความรู้ส่วนใหญ่ และ Anthropic แนะนำ Opus 5.5 สำหรับ workload ส่วนใหญ่ ให้ส่งเฉพาะงานที่โมเดล default ของคุณทำไม่ได้ไปยัง Carbon หรือ Fable แล้วเทียบผลลัพธ์ด้วยคำสั่งของคุณเอง