
ณ วันที่ 11 พฤศจิกายน 2026 Gemini 4 Carbon ของ Google มีราคา $2 ต่อ 1M input tokens และ $10 ต่อ 1M output tokens บน Gemini API ซึ่งเป็นราคาเปิดตัวที่จะสิ้นสุดในวันที่ 30 พฤศจิกายน 2026 ตั้งแต่วันที่ 1 ธันวาคมเป็นต้นไป ราคา Gemini 4 Carbon จะเพิ่มขึ้นเป็นสองเท่าเป็น $4 สำหรับ input และ $20 สำหรับ output ต่อ 1M tokens โดย thinking tokens จะถูกคิดค่าบริการตามอัตราของ output
ยอดบิลจริงของคุณขึ้นอยู่กับจำนวน tokens ที่ Carbon ใช้ในการ "คิด" ซึ่ง Carbon ใช้เยอะมาก ด้านล่างนี้คือตารางราคาฉบับเต็ม ตัวอย่างการคำนวณที่ทั้งสองราคา ช่องว่างค่าใช้จ่ายเทียบกับ Argon และคู่แข่ง รวมถึงวิธีบันทึกต้นทุนจริงต่อ request หากคุณยังไม่คุ้นเคยกับโมเดลนี้ เริ่มจากบทความ Gemini 4 Carbon คืออะไร
Gemini 4 Carbon ราคาเท่าไหร่ต่อ 1M tokens?
Gemini 4 Carbon (model ID gemini-4-carbon) เป็นโมเดลสำหรับ paid tier หน้าราคาของ Google ระบุ tier ไว้ 4 แบบ โดยแต่ละ tier มีราคาเปิดตัวถึงวันที่ 30 พฤศจิกายน 2026 และราคาใหม่ตั้งแต่วันที่ 1 ธันวาคม 2026:
| Tier | Input (ถึง 30 พ.ย.) | Input (ตั้งแต่ 1 ธ.ค.) | Output รวม thinking (ถึง 30 พ.ย.) | Output รวม thinking (ตั้งแต่ 1 ธ.ค.) | Cached input (ถึง 30 พ.ย. / ตั้งแต่ 1 ธ.ค.) | แหล่งข้อมูล |
|---|---|---|---|---|---|---|
| Standard | $2.00 | $4.00 | $10.00 | $20.00 | $0.10 / $0.20 | |
| Batch | $1.00 | $2.00 | $5.00 | $10.00 | $0.05 / $0.10 | |
| Flex | $1.00 | $2.00 | $5.00 | $10.00 | $0.05 / $0.10 | |
| Priority | $3.60 | $7.20 | $18.00 | $36.00 | $0.18 / $0.36 |
ราคาทั้งหมดคิดต่อ 1M tokens มีรายละเอียดในหน้าเดียวกันอีกไม่กี่ข้อที่ส่งผลต่องบประมาณของคุณ:
- ไม่มี Free tier. หน้าเว็บของ Google ระบุว่า "Gemini 4 Carbon ไม่สามารถใช้งานได้บน Free tier"
- Thinking มีค่าบริการ. "Token ทุกตัวที่โมเดลประมวลผลจะถูกนับและคิดค่าบริการ รวมถึง thinking tokens ด้วย"
- มีเฉพาะ implicit caching. ไม่รองรับ explicit caching ดังนั้นคุณจะได้ราคา cached เมื่อ implicit cache ของ Google จับคู่กับ prompt prefix ที่ซ้ำกัน
โพสต์เปิดตัวของ Google ระบุการเปลี่ยนแปลงนี้ไว้ในเชิงอรรถว่า: "หลังจากช่วงราคาเปิดตัวสิ้นสุดในวันที่ 30 พฤศจิกายน 2026 ราคา $4 ต่อ 1M input tokens และ $20 ต่อ 1M output tokens จะมีผลใช้บังคับ ใช้กับโมเดล Carbon ที่เปิดให้สาธารณะเข้าถึงเท่านั้น"
อะไรจะเปลี่ยนแปลงในวันที่ 1 ธันวาคม 2026?
อัตราค่าบริการทุกตัวเพิ่มขึ้นเป็นสองเท่า Input แบบ Standard เพิ่มจาก $2 เป็น $4 output จาก $10 เป็น $20 และอัตรา cached จาก $0.10 เป็น $0.20 Batch และ Flex ก็เพิ่มเป็นสองเท่าเช่นกัน ส่วนลด Batch 50% จึงยังคงอยู่
เชิงอรรถไม่มีข้อยกเว้นสำหรับผู้ใช้ระยะแรก และไม่มีอะไรในหน้าราคาบอกว่าโปรเจกต์ที่มีอยู่จะยังได้ราคาเปิดตัว วางแผนงบประมาณโดยคิดว่าทุก token ที่ส่งตั้งแต่วันที่ 1 ธันวาคมเป็นต้นไปอยู่ที่ $4/$20
Gemini 4 Argon ใช้ตารางเวลาเดียวกัน ดูรายละเอียดได้ที่ คู่มือราคา Gemini 4 Argon ของเรา
Thinking tokens ของ Gemini 4 Carbon ถูกคิดค่าบริการอย่างไร?
Thinking tokens ถูกคิดค่าบริการตามอัตราของ output: $10 ต่อ 1M ถึงวันที่ 30 พฤศจิกายน จากนั้น $20 Interactions API รายงานค่าเหล่านี้ในฟิลด์แยกต่างหาก ดังนั้นออบเจกต์ usage ของ response จึงมีลักษณะดังตัวอย่างนี้จากเอกสารของ Google:
"usage": {
  "total_tokens": 530,
  "total_input_tokens": 62,
  "total_output_tokens": 171,
  "total_thought_tokens": 297
}
โมเดลใช้เวลาคิด 297 tokens เพื่อเขียน 171 tokens และคุณต้องจ่ายค่าใช้บริการในอัตรา output สำหรับข้อความที่คุณไม่เคยเห็นเลย Carbon ตั้งค่าเริ่มต้น thinking_level เป็น "medium" และยังรองรับ "low" และ "high" ตามคู่มือ thinking ของ Google
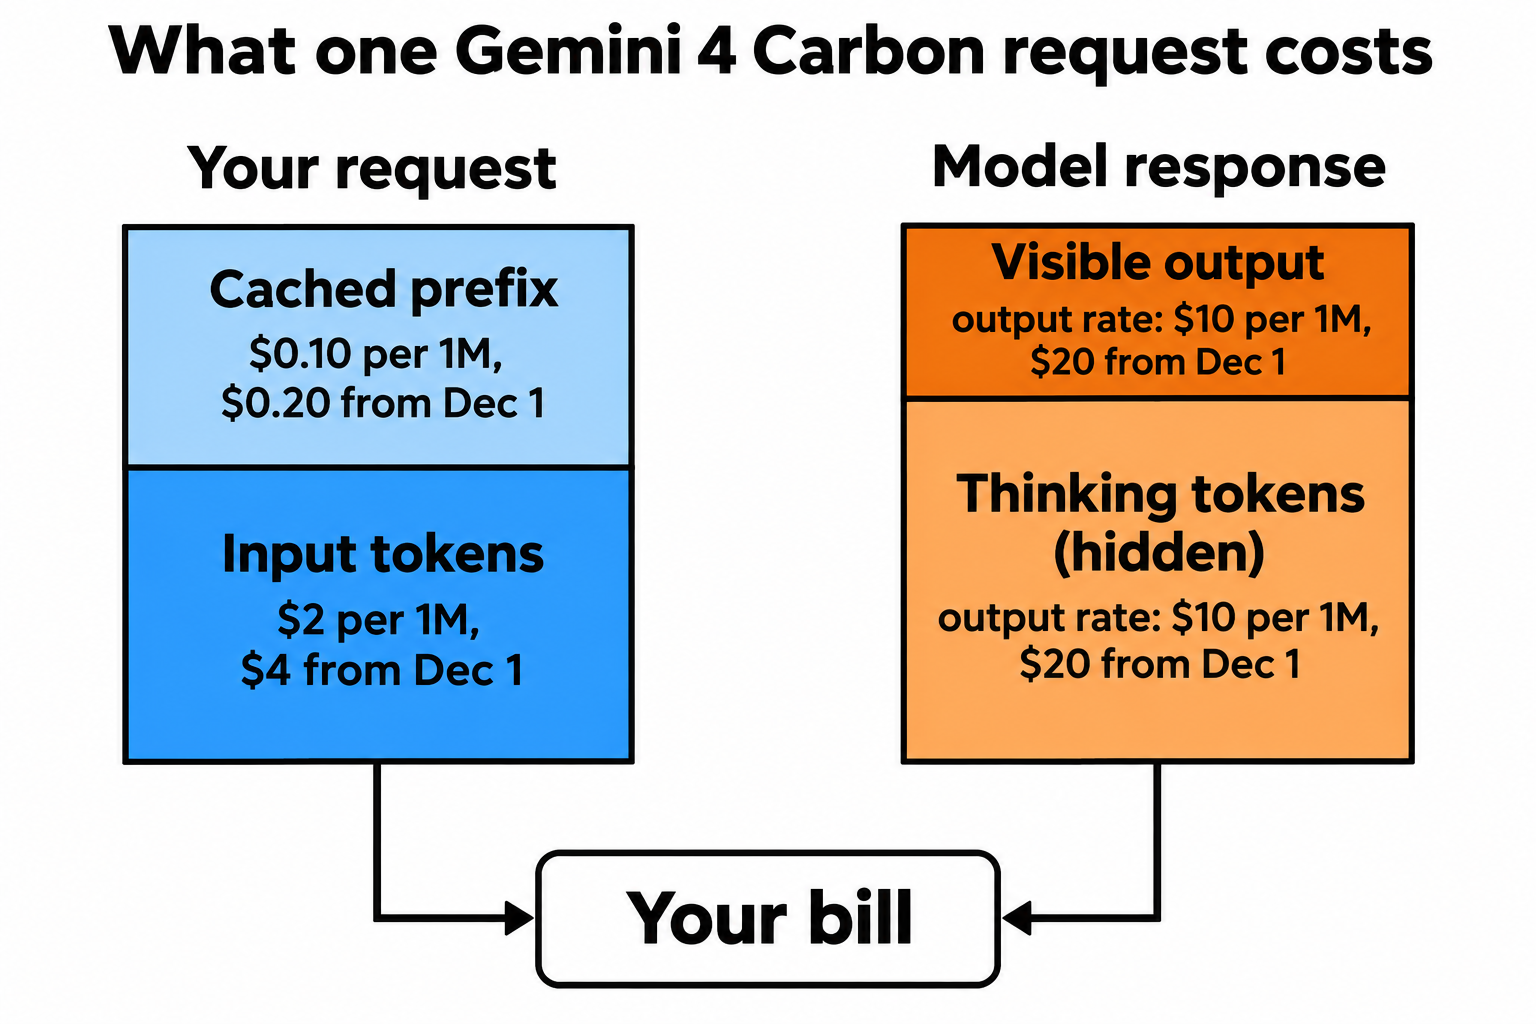
สูตรสำหรับหนึ่ง request คือ:
cost = (uncached_input x input_rate)
     + (cached_input x cached_rate)
     + ((thought + output) x output_rate)
การเรียก Gemini 4 Carbon หนึ่งครั้งมีค่าใช้จ่ายเท่าไหร่?
สองตัวอย่างด้านล่างนี้เป็นจำนวน tokens สมมติ ไม่ใช่ค่าที่วัดจริง ให้แทนที่ด้วยตัวเลขจากออบเจกต์ usage ของคุณเอง
ตัวอย่างที่ 1: การเรียกแชทครั้งเดียว. Input 1,500 tokens, thinking 2,500 tokens, output 800 tokens
| รายการ | ถึง 30 พ.ย. | ตั้งแต่ 1 ธ.ค. |
|---|---|---|
| Input (1,500) | $0.0030 | $0.0060 |
| Thinking + output (3,300) | $0.0330 | $0.0660 |
| รวมต่อการเรียก 1 ครั้ง | $0.036 | $0.072 |
| 10,000 ครั้งต่อเดือน | $360 | $720 |
ตัวอย่างที่ 2: agent run ยาวที่คิดหนัก. Agent loop ใช้ 40 รอบ เนื่องจากส่งบทสนทนาซ้ำทุกรอบ จึงอ่าน input รวม 1.2M tokens โดย 900K จากนั้นตรงกับ implicit cache โมเดลคิด 300K tokens และเขียนโค้ดและ tool calls รวม 60K tokens
| รายการ | ถึง 30 พ.ย. | ตั้งแต่ 1 ธ.ค. |
|---|---|---|
| Uncached input (300K) | $0.60 | $1.20 |
| Cached input (900K) | $0.09 | $0.18 |
| Thinking + output (360K) | $3.60 | $7.20 |
| รวมต่อการรัน 1 ครั้ง | $4.29 | $8.58 |
| Tokens เดียวกันที่อัตรา Batch หรือ Flex | $2.15 | $4.29 |
ใน agent run นี้ 84% ของบิลมาจาก thinking และ output ดังนั้นการลดระดับ thinking จึงประหยัดกว่าการตัด prompt โค้ดสำหรับ request อยู่ใน คู่มือ Gemini 4 Carbon API ของเรา
Gemini 4 Carbon แพงกว่า Gemini 4 Argon หรือไม่?
เทียบต่อ token แล้วไม่แพงกว่า: ทั้งสองตัวราคา $2/$10 ตอนนี้ และ $4/$20 ตั้งแต่วันที่ 1 ธันวาคม แต่เทียบต่องานแล้ว มักแพงกว่า Google ระบุว่า Carbon จัดการงานที่ยากขึ้นโดย "ใช้ tokens มากกว่า Argon เพื่อสำรวจอย่างละเอียด ใช้เหตุผลอย่างลึกซึ้ง และรันกระบวนการตรวจสอบที่ยาวนาน" และว่า "Argon ยังคงเป็นตัวเลือกที่เหมาะสมที่สุดสำหรับงาน software engineering และงานด้านความรู้ส่วนใหญ่"
Artificial Analysis ให้ตัวเลขที่ชัดเจน ในการรัน Intelligence Index Gemini 4 Carbon (high) ผลิต output tokens 205M เทียบกับ 113M ของ Gemini 4 Argon นั่นคือ output tokens ประมาณ 1.8 เท่าสำหรับชุดงานเดียวกัน และแลกมาด้วยคะแนนที่สูงกว่า: Carbon ได้ 60 เทียบกับ Argon 50
นำสัดส่วนนี้มาใช้กับงานที่ Argon ใช้ output tokens 200K:
| โมเดล | Output tokens | ค่าใช้จ่ายถึง 30 พ.ย. | ค่าใช้จ่ายตั้งแต่ 1 ธ.ค. |
|---|---|---|---|
| Gemini 4 Argon | 200,000 | $2.00 | $4.00 |
| Gemini 4 Carbon (ประมาณ 1.8 เท่า) | 360,000 | $3.60 | $7.20 |
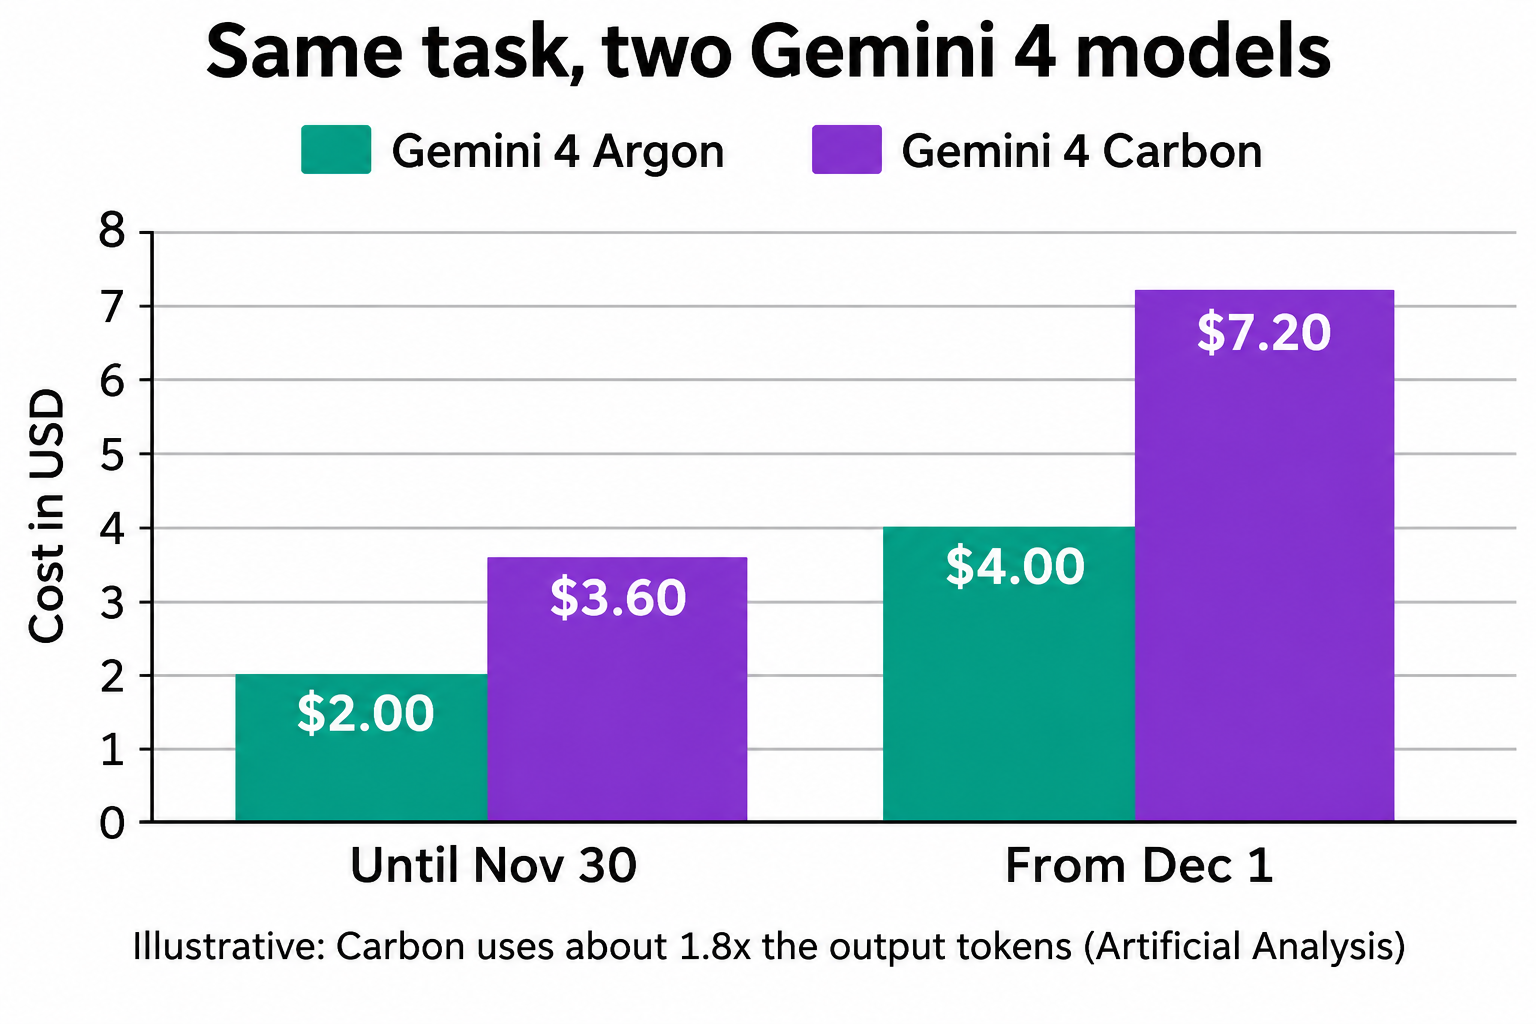
ดังนั้นให้เลือกใช้ตามความยากของงาน: งาน debug ที่ยาก การออกแบบสถาปัตยกรรม และการ audit ด้านความปลอดภัย ให้ใช้ Carbon ส่วนงานเขียนโค้ดประจำวันให้ใช้ Argon บทความ เปรียบเทียบ Gemini 4 Carbon vs Argon ของเราครอบคลุมว่างานแบบไหนคุ้มค่ากับ tokens ที่เพิ่มขึ้น
ราคา Gemini 4 Carbon เทียบกับ Claude Fable 5.2, Opus 5.5 และ GPT-6.1 Sol อย่างไร?
นี่คืออัตรา API แบบ standard ต่อ 1M tokens โดยอ่านจากหน้าราคาของผู้ให้บริการแต่ละรายในวันที่ 11 พฤศจิกายน 2026:
| โมเดล | Input | Output | Cached input | แหล่งข้อมูล |
|---|---|---|---|---|
| Gemini 4 Carbon (ถึง 30 พ.ย.) | $2.00 | $10.00 | $0.10 | |
| Gemini 4 Carbon (ตั้งแต่ 1 ธ.ค.) | $4.00 | $20.00 | $0.20 | |
| Gemini 4 Argon (ถึง 30 พ.ย.) | $2.00 | $10.00 | $0.10 | |
| Claude Fable 5.2 | $8.00 | $40.00 | $0.20 (cache hit) | Anthropic |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 (cache hit) | Anthropic |
| GPT-6.1 Sol | $2.00 | $10.00 | $0.10 | OpenAI |
| GPT-6 Astra | $10.00 | $50.00 | $1.00 | OpenAI |
ตั้งแต่วันที่ 1 ธันวาคม ราคาต่อ token ของ Carbon เท่ากับ Claude Opus 5.5 และยังเป็นครึ่งหนึ่งของ Claude Fable 5.2 Anthropic คิดค่าบริการเพิ่มสำหรับ cache writes ส่วน Google ไม่ระบุค่า write สำหรับ implicit caching ราคา Sol ของ OpenAI ครอบคลุม prompt สูงสุด 272K input tokens
ราคาหน้าฉลากไม่ใช่ตัวตัดสิน เพราะแต่ละโมเดลคิดในปริมาณที่ต่างกัน Artificial Analysis เผยแพร่ตัวเลขต้นทุนของแต่ละโมเดลใน Intelligence Index: $7.76 สำหรับ Gemini 4 Carbon (high) ด้วยคะแนน 60 และ $26.54 สำหรับ Claude Fable 5.2 (max) ด้วยคะแนน 65 Fable 5.2 ยังผลิต output tokens มากกว่าใน index (275M เทียบกับ 205M ของ Carbon) ให้ถือว่าตัวเลขเหล่านี้เป็นมุมมองจาก benchmark ชุดเดียว ภาระงานของคุณจะแตกต่างออกไป สำหรับการเปรียบเทียบเต็มรูปแบบ ดู Gemini 4 Carbon vs Claude Fable 5.2 และ คู่มือ Claude Fable 5.2 API สำหรับมุมมองฝั่ง Anthropic
จะลดบิล Gemini 4 Carbon ของคุณได้อย่างไร?
- ใช้ Batch หรือ Flex กับงานที่รอได้. ทั้งสองราคาเป็นครึ่งหนึ่งของราคา standard
- ลดระดับ thinking. ใช้ "low" ในรอบงานประจำ และใช้ "high" เฉพาะจุดที่ความแม่นยำคุ้มค่า
- ส่งงานง่ายให้ Argon. ราคาต่อ token เท่ากัน แต่ใช้ output tokens น้อยกว่ามาก
- รักษา prompt prefix ให้คงที่ เพื่อให้ implicit caching คิดค่า input ที่ซ้ำที่ $0.10 ต่อ 1M (แล้วเป็น $0.20)
- รันงานใหญ่ให้เสร็จก่อนวันที่ 1 ธันวาคม ซึ่งงานเดียวกันจะแพงขึ้นสองเท่า
บันทึกต้นทุนจริงของ Gemini 4 Carbon ต่อ request ด้วย Apidog CLI
บิลของคุณมาจากจำนวน tokens ซึ่งเปลี่ยนทุกครั้งที่คุณแก้ prompt หรือระดับ thinking วิธีที่เร็วที่สุดในการเห็นตัวเลขจริงคือให้ coding agent ของคุณ (Claude Code, Codex, Cursor) รัน prompt จริงของคุณผ่าน Apidog CLI และบันทึกออบเจกต์ usage ของแต่ละครั้ง
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ใส่ prompt จริงของคุณ 10–20 รายการลงใน prompts.csv โดยมีคอลัมน์ prompt และ thinking_level จากนั้นสั่ง agent ของคุณด้วย prompt เดียว:
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model {{model}} (default "gemini-4-carbon"), input {{prompt}}
and generation_config.thinking_level {{thinking_level}}. In a post-processor,
read usage.total_input_tokens, total_thought_tokens and total_output_tokens,
compute cost at $2/$10 and at $4/$20 per 1M, and log both. Assert status is
"completed". Run it once per row of prompts.csv and give me a table of
tokens and cost per prompt, plus the totals.
Agent จะตรวจสอบรูปแบบ payload ก่อนเขียนอะไร แล้วจึงรันทุกแถว:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case category --project <projectId>
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d prompts.csv -r cli,json --out-file carbon-cost-{GENERATE_TIME}
รายงาน JSON เก็บบันทึกที่มีวันที่กำกับของ tokens ต่อ prompt หากรันซ้ำด้วย --env-var "model=gemini-4-argon" คุณจะได้ตัวเลขของ Argon สำหรับ prompt ชุดเดียวกัน ซึ่งเป็นวิธีที่ชัดเจนที่สุดในการตัดสินว่าแต่ละงานควรใช้โมเดลไหน เพิ่ม -r junit แล้วคำสั่งเดียวกันจะรันใน CI ได้ โดย assertion ด้านต้นทุนสามารถทำให้ build fail ได้ คู่มือ Apidog CLI CI/CD แสดง pipeline และ Apidog CLI ใน Claude Code ครอบคลุมการตั้งค่า agent แผน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน
ทางลัด: บอก agent ของคุณว่า "อ่าน https://apidog.com/apidog-cli-installation-guide.md และตั้งค่า Apidog CLI"
คำถามที่พบบ่อย
Gemini 4 Carbon ฟรีหรือไม่? ไม่ฟรีบน API: Carbon ไม่อยู่ใน Free tier คุณจึงต้องมี API key แบบ paid นักวิทยาศาสตร์สามารถยื่นขอ Google เพื่อรับสิทธิ์ใช้งานฟรี 6 เดือนบน Antigravity คู่มือ Gemini 4 Carbon ฟรี ของเราครอบคลุมทุกช่องทาง
Google AI Ultra รวม Gemini 4 Carbon หรือไม่? Google ระบุว่า Carbon กำลังเปิดให้ผู้ติดตาม AI Ultra ใช้งานในแอป Gemini, AI Mode ใน Search และ Antigravity การเรียกผ่าน API จะคิดค่าบริการแยกต่างหากตาม token บน paid tier
ราคาจะเพิ่มสำหรับผู้ใช้เดิมในวันที่ 1 ธันวาคมหรือไม่? เชิงอรรถของ Google ไม่ระบุข้อยกเว้นสำหรับผู้ใช้เดิม วางแผนงบประมาณที่ $4 สำหรับ input และ $20 สำหรับ output ต่อ 1M tokens สำหรับการใช้งาน Carbon ทั้งหมดตั้งแต่วันที่ 1 ธันวาคม 2026
Gemini 4 Carbon ถูกกว่า Claude Fable 5.2 หรือไม่? เทียบต่อ token แล้วถูกกว่า: $4/$20 ตั้งแต่วันที่ 1 ธันวาคม เทียบกับ $8/$40 ของ Fable 5.2 บน Intelligence Index ของ Artificial Analysis ตัวเลขต้นทุนของ Carbon อยู่ที่ $7.76 เทียบกับ $26.54 ของ Fable 5.2 (max) แต่ Fable ได้คะแนนสูงกว่าที่ 65 เทียบกับ 60