นับตั้งแต่วันที่ 11 พฤศจิกายน 2026 API ของ Gemini 4 Carbon ของ Google ใช้ model ID gemini-4-carbon โดยมีราคา $2 ต่อ token ที่ป้อนเข้า 1 ล้านตัว และ $10 ต่อ token ที่ส่งออก 1 ล้านตัว จนถึงวันที่ 30 พฤศจิกายน 2026 จากนั้นราคาจะเป็น $4 และ $20 ตามลำดับ Google เปิดใช้งานอย่างเป็นทางการ (generally available) เมื่อวันที่ 10 พฤศจิกายน 2026 บน Gemini API ระดับ paid tier เท่านั้น
คู่มือนี้จะพาคุณจาก API key ที่เพิ่งสร้างใหม่ไปจนถึง request แรกของคุณ แสดงให้เห็นว่าตัวเลขการใช้งานตัวไหนบ้างที่กำหนดค่าบิลของคุณ และมอบงานทดสอบให้กับ coding agent ของคุณ
Model ID ของ Gemini 4 Carbon คืออะไร?
Model ID ของ Gemini 4 Carbon คือ gemini-4-carbon คุณจะส่งค่านี้ในฟิลด์ model เมื่อเรียกใช้ endpoint Interactions ของ Gemini API ผ่าน Python หรือ JavaScript SDK หรือใน prompt ของ Google AI Studio Google เรียก Carbon ว่าเป็นโมเดลที่มีความสามารถด้านการ reasoning ที่แข็งแกร่งที่สุด และแนะนำให้ใช้กับงานที่ยากลำบาก ส่วน Gemini 4 Argon ยังคงเป็นโมเดลเริ่มต้นสำหรับงานทั่วไปในแต่ละวัน
สำหรับข้อมูลพื้นฐานเกี่ยวกับตัวโมเดลเอง เริ่มต้นได้ที่บทความ Gemini 4 Carbon คืออะไร
| รายการ | ค่า | แหล่งที่มา |
|---|---|---|
| Model ID | gemini-4-carbon |
เอกสาร Google AI Studio |
| ใช้งานได้ตั้งแต่ | 10 พฤศจิกายน 2026 | โพสต์เปิดตัวของ Google |
| ใช้ได้ที่ใด | Gemini API paid tier, Google AI Studio, Android Studio | โพสต์เปิดตัวของ Google |
| Free tier | ไม่มีให้ใช้งาน | เอกสาร Google AI Studio |
| Context window | 1,048,576 tokens ใช้ร่วมกันระหว่าง input, thinking และ output | เอกสาร Google AI Studio |
| Output สูงสุดต่อการตอบกลับแบบ synchronous | 65,536 tokens | เอกสาร Google AI Studio |
| Long decode | สูงสุด 1M tokens หักลบ input ของคุณ โดยใช้ background: true |
เอกสาร Google AI Studio |
| ระดับ thinking | low, medium (ค่าเริ่มต้น), high |
เอกสาร Google AI Studio |
| ราคาจนถึง 30 พ.ย. 2026 | input $2, output $10 ต่อ 1M tokens | โพสต์เปิดตัวของ Google |
| ราคาตั้งแต่ 1 ธ.ค. 2026 | input $4, output $20 ต่อ 1M tokens | โพสต์เปิดตัวของ Google |
| Cached input (implicit caching) | $0.10 ต่อ 1M และเป็น $0.20 ตั้งแต่วันที่ 1 ธ.ค. | เอกสาร Google AI Studio |
จะขอ Gemini API key สำหรับ Gemini 4 Carbon ได้อย่างไร?
Carbon ทำงานได้บน paid tier เท่านั้น ดังนั้นมีแค่ key อย่างเดียวไม่พอ คุณต้องมี key ในโปรเจกต์ที่ผูกกับ Cloud Billing อยู่ด้วย:
- เปิดหน้า API keys ใน Google AI Studio ผู้ใช้ใหม่จะได้รับการสร้างโปรเจกต์และ key ให้อัตโนมัติ หากไม่มีอยู่แล้วให้คลิก Create API key
- คลิก Set up billing บนหน้า API keys หรือหน้า Projects
- สร้างหรือเชื่อมโยงบัญชี Cloud Billing เพิ่มวิธีการชำระเงิน และเติมเครดิตล่วงหน้าอย่างน้อย $5 ตามที่ quickstart ของ Google ระบุ
- ส่งออก key ไปยัง shell ของคุณ:
export GEMINI_API_KEY="YOUR_API_KEY"
บทความตัวเลือกฟรีของ Gemini 4 Carbon ครอบคลุมวิธีที่ไม่ต้องใช้ API key เลย
จะส่ง API request แรกไปยัง Gemini 4 Carbon อย่างไร?
Quickstart ของ Google สำหรับ Carbon ใช้ Interactions API คือการส่ง POST ไปที่ /v1beta/interactions พร้อม model และ input ใน body ให้เก็บชื่อโมเดลไว้ในตัวแปร เพื่อให้การสลับระหว่าง Carbon กับ Argon ในภายหลังแก้เพียงบรรทัดเดียว
ด้วย curl:
export GEMINI_MODEL="gemini-4-carbon"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Find the race condition in this retry loop and rewrite the lock safely.",
    "generation_config": {
      "thinking_level": "medium"
    }
  }'
ด้วย Python SDK (pip install -U google-genai):
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-4-carbon")

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model=MODEL,
    input="Find the race condition in this retry loop and rewrite the lock safely.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
print(interaction.usage)
ตัวอย่างโค้ดทั้งสองอ้างอิงจากตัวอย่างในเอกสารของ Google เราไม่ได้รันโค้ดเหล่านี้เพื่อเขียนบทความนี้ เนื่องจากเครื่องนี้ไม่มี paid Carbon key จึงควรตรวจสอบรูปแบบ response กับการเรียกใช้ครั้งแรกของคุณเองด้วย
รายละเอียดสามข้อจาก migration notes ของ Google ช่วยประหยัดเวลา debugging ของคุณได้:
- ตัด sampling parameters ออก Carbon จะไม่สนใจ
temperature,top_pและtop_kจึงควรลบออก - เพิ่ม timeout Prompt ที่ยากอาจใช้เวลาหลายนาที Google แนะนำการรันแบบ background หรือตั้ง HTTP timeout อย่างน้อย 15 นาที
- เก็บ state ไว้บนเซิร์ฟเวอร์ ส่ง
previous_interaction_idสำหรับแชทแบบ multi-turn และ function calling แทนการส่งประวัติซ้ำ
ใช้ Argon อยู่แล้ว? คู่มือ Gemini 4 Argon API ของเราใช้โครงสร้าง request แบบเดียวกัน
จะอ่านค่า usage และ thinking tokens จาก response อย่างไร?
ทุก interaction จะคืนค่า object usage มาให้ ซึ่งฟิลด์เหล่านี้คือสิ่งที่มีผลต่อค่าใช้จ่าย:
total_input_tokens: สิ่งที่คุณส่งเข้าไป รวมถึง system instructions และ tool declarationstotal_thought_tokens: token ที่โมเดลใช้คิดก่อนตอบtotal_output_tokens: คำตอบที่มองเห็นได้total_tokens: ผลรวมทั้งหมด
ฟิลด์ที่ต้องจับตามองคือ total_thought_tokens คู่มือ thinking ของ Google ระบุว่าการคิดราคาของ response คือผลรวมของ output tokens และ thinking tokens ดังนั้นการคิด (thinking) จะถูกคิดค่าใช้จ่ายในอัตรา output ที่ $10 และ Google ยังระบุด้วยว่า Carbon "ใช้ thinking tokens มากกว่า" ต่อหนึ่งรอบเมื่อเทียบกับ Argon เพื่อสำรวจและตรวจสอบผลงานของมัน สำหรับ prompt ที่ยาก ค่าคิดอาจเป็นสัดส่วนใหญ่ของบิลได้
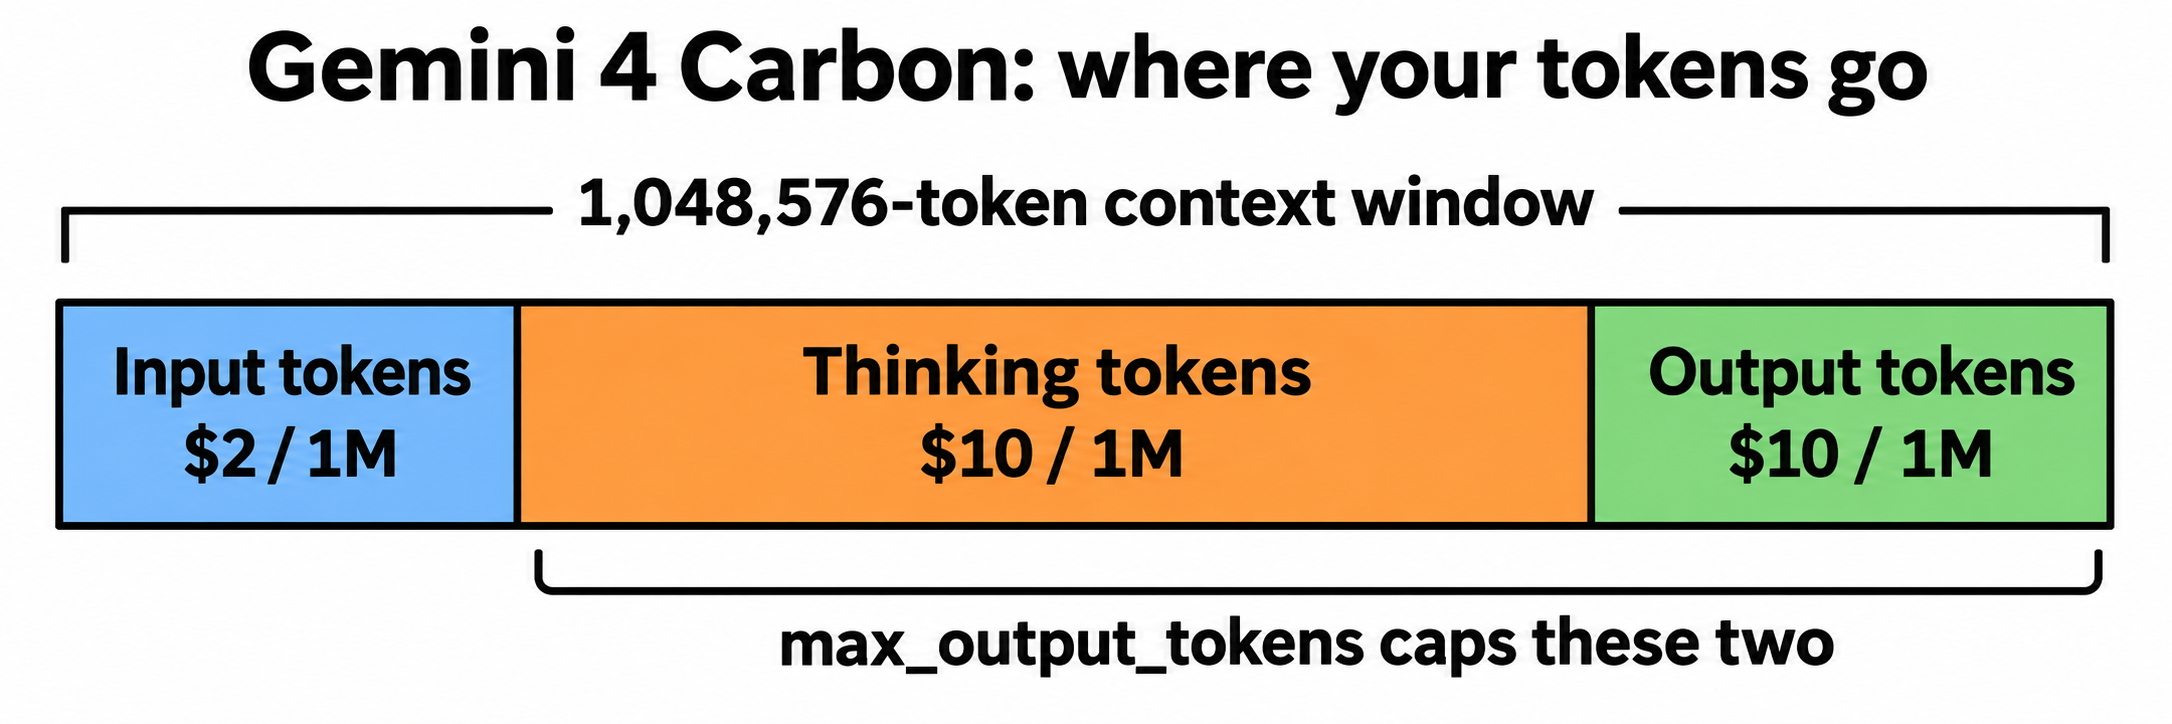
max_output_tokens จำกัด thinking และ output รวมกัน ถ้าคุณตั้งค่าต่ำเกินไป Carbon อาจใช้งบไปกับการคิดจนคำตอบถูกตัดสั้น จุดเริ่มต้นที่ Google แนะนำ:
- งานทั่วไป: คงค่าเริ่มต้นที่ 65,536
- แอปที่มีขีดจำกัดต่ำกว่า 32K: เพิ่มเป็นอย่างน้อย 32,768
- งาน reasoning และ coding ที่ซับซ้อน: ตั้ง
background: trueและ 131,072 หรือ 262,144 tokens
เมื่อใช้ background: true เซิร์ฟเวอร์ของ Google จะดำเนินการตอบกลับต่อเป็นช่วง ๆ ละ 64K tokens คุณจะ poll interaction จนกว่าสถานะจะออกจาก in_progress หรือ queued จากนั้นรวมข้อความจากทุกขั้นตอน model_output
ควรใช้ระดับ thinking ไหนกับ Gemini 4 Carbon?
ระดับ thinking คือตัวควบคุมหลักของคุณต่อคุณภาพ latency และค่าใช้จ่าย คำแนะนำของ Google จากคู่มือ thinking และเอกสารของ Carbon:
| ระดับ thinking | การใช้ token | เหมาะกับ |
|---|---|---|
low |
ใช้ token น้อยที่สุด latency ต่ำที่สุด | งานง่าย ๆ ที่สำคัญเรื่องต้นทุน การวิเคราะห์และการเขียนที่ไม่ซับซ้อน |
medium (ค่าเริ่มต้น) |
สมดุล | งานส่วนใหญ่ รวมถึงโค้ดที่ซับซ้อนและงาน agent |
high |
ใช้ token มากที่สุด token แรกช้าที่สุด | คณิตศาสตร์และวิทยาศาสตร์ที่ยาก โค้ดหรืองาน agent ที่ยากที่สุด |
Google แนะนำให้รันการประเมินผลของคุณที่ทั้งสามระดับ แล้วเลือกใช้ระดับต่ำที่สุดที่ยังตอบโจทย์มาตรฐานคุณภาพของคุณ บน Carbon ช่องว่างระหว่าง low กับ high คือจุดที่งบประมาณของคุณหมดไป
ควรส่งงานไปให้ Gemini 4 Carbon แทน Argon เมื่อไร?
Google พูดตรง ๆ ในเรื่องนี้ว่า "Argon ยังคงเป็นตัวเลือกที่เหมาะสมที่สุดสำหรับงาน software engineering และงานด้านความรู้ส่วนใหญ่" โมเดลทั้งสองใช้ context window 1M, built-in tools และราคาต่อ token ช่วงเปิดตัวแบบเดียวกัน ดังนั้นความต่างอยู่ที่จำนวน token ที่แต่ละตัวใช้ต่อหนึ่งรอบ ใช้ Carbon สำหรับงาน debugging หาสาเหตุรากเหง้าที่ซับซ้อน การออกแบบสถาปัตยกรรม การสังเคราะห์ multimodal ที่หนาแน่น การพิสูจน์ และการ audit ด้านความปลอดภัย ส่วน Argon เก็บไว้สำหรับ interactive coding, ฟีเจอร์ประจำวัน และ production loop ที่ต้องรวดเร็ว การเปรียบเทียบ Gemini 4 Carbon vs Argon ของเราเจาะลึกกว่านี้ และถ้าคุณกำลังเปรียบเทียบ Carbon กับโมเดลใหม่ล่าสุดของ Anthropic ดูได้ที่ Gemini 4 Carbon vs Claude Fable 5.2 และคู่มือ Claude Fable 5.2 API
การเรียกใช้ Gemini 4 Carbon API หนึ่งครั้งมีค่าใช้จ่ายเท่าไร?
Gemini 4 Carbon มีราคา $2 ต่อ input tokens 1M และ $10 ต่อ output tokens 1M (รวม thinking ด้วย) จนถึงวันที่ 30 พฤศจิกายน 2026 จากนั้นจะเป็น $4 และ $20 ตามข้อมูลของ Google
เพื่อให้เห็นภาพในหนึ่งการเรียกใช้ สมมติ request ตัวอย่างที่มี input tokens 2,000 ตัว thinking tokens 6,000 ตัว และ output tokens 1,500 ตัว ตัวเลขเหล่านี้เป็นเพียงตัวอย่าง ไม่ใช่ผลการวัดจริง:
- Input: 2,000 x $2 / 1M = $0.004
- Thinking บวก output: 7,500 x $10 / 1M = $0.075
- รวม: ประมาณ $0.079 ในตอนนี้ และประมาณ $0.158 ตั้งแต่วันที่ 1 ธันวาคม
ปริมาณการคิดแตกต่างกันมากตามแต่ละ prompt จึงควรดู object usage ของคุณเอง สำหรับการคำนวณราคาแบบเต็ม การพุ่งขึ้นของราคาเดือนธันวาคม และต้นทุนต่องาน ดูได้ที่ ราคา Gemini 4 Carbon
ให้ coding agent ของคุณทดสอบ Carbon API ด้วย Apidog CLI
คุณจะต้องปรับระดับ thinking ขีดจำกัด output และ prompt หลายครั้ง แทนที่จะนั่งลองผิดลองถูกกับ JSON หลังทุกการแก้ไข ให้ coding agent ของคุณ (Claude Code, Codex, Cursor) เขียนชุดทดสอบที่ใช้ซ้ำได้และรันด้วย Apidog CLI
ตั้งค่าเพียงครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง agent ของคุณด้วย prompt เดียว:
In Apidog project <projectId>, add an endpoint for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from the GEMINI_API_KEY variable in
environment <envId>. Create a test case that sends model "gemini-4-carbon",
a short prompt and thinking_level "low", and asserts: HTTP 200, status is
"completed", usage.total_thought_tokens exists, and usage.total_tokens is
below 20000. Run it and summarize any failures.
การใช้ low ในชุดทดสอบช่วยให้การรันแต่ละครั้งประหยัดค่าใช้จ่าย Agent จะอ่าน schema ตรวจสอบ payload ของมันเอง และรัน test case:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog test-case category --project <projectId>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
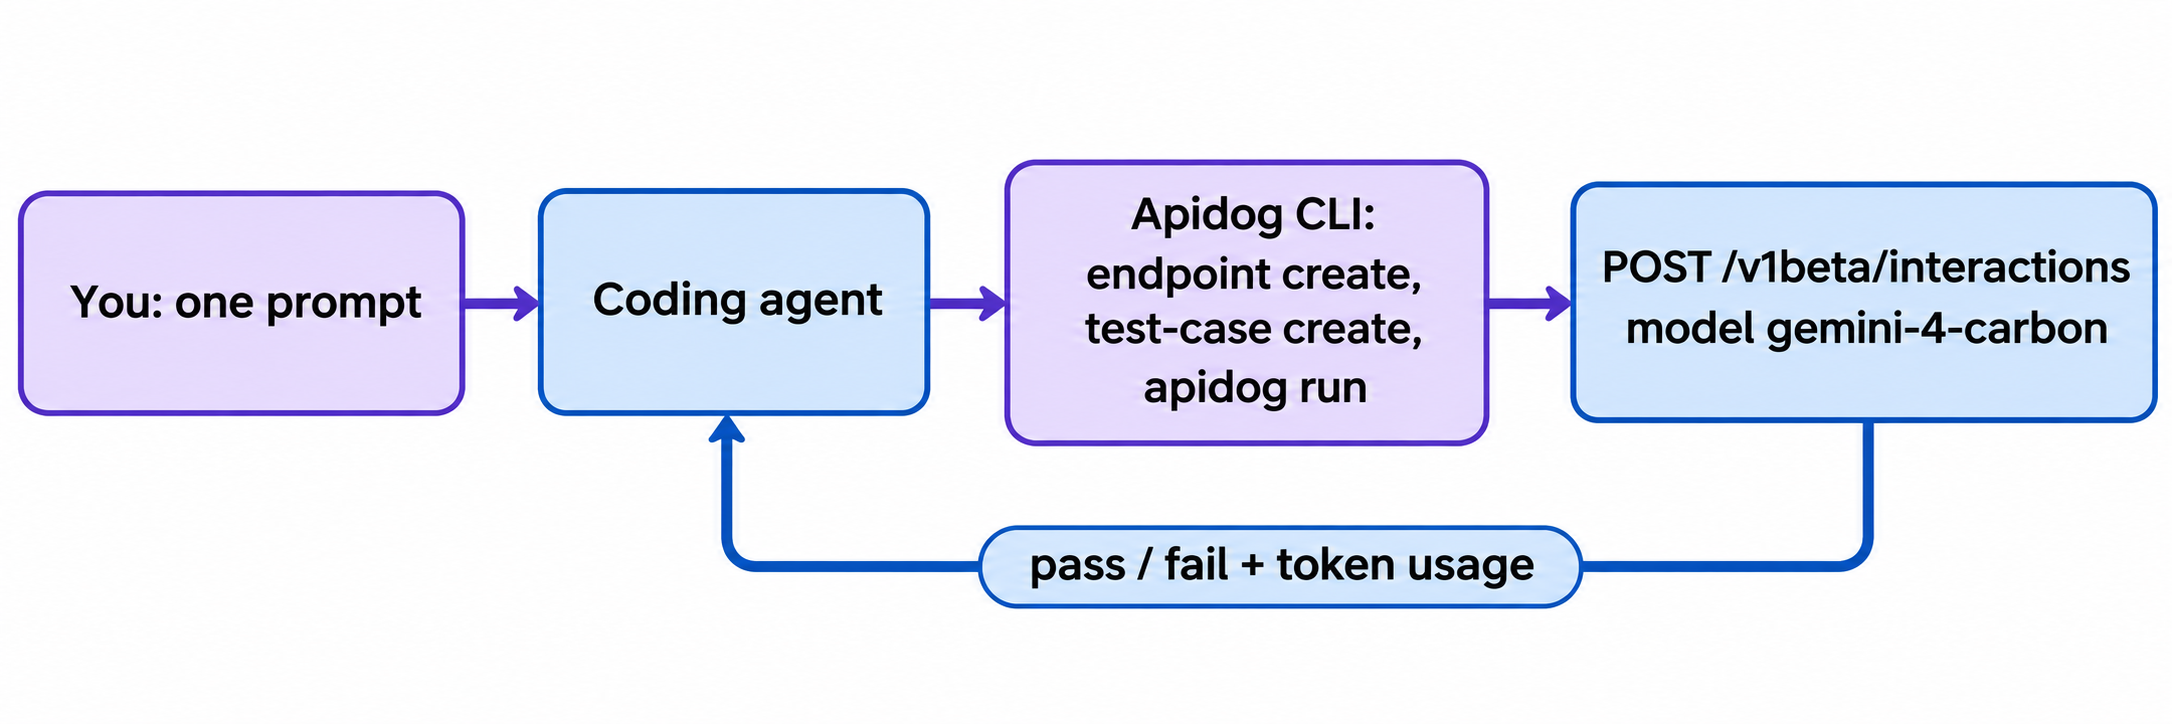
Assertion เรื่อง token budget คือสิ่งที่มีประโยชน์ที่สุด ถ้าการเปลี่ยน prompt ทำให้การคิดใช้ token เกินขีดจำกัดของคุณ ชุดทดสอบจะ fail ก่อนที่บิลจะโต เปลี่ยน -r cli,json เป็น -r junit แล้วคำสั่งเดิมจะรันใน CI ได้ คู่มือ Apidog CLI CI/CD แสดง pipeline ให้ดู และApidog CLI ใน Claude Code อธิบายการตั้งค่า agent ทีละขั้น แผน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน
ถ้าคุณอยากให้ agent ตั้งค่าทุกอย่างตั้งแต่ต้น บอกมันว่า: "Read https://apidog.com/apidog-cli-installation-guide.md and set up Apidog CLI."
คำถามที่พบบ่อย (FAQ)
Gemini 4 Carbon API ฟรีหรือไม่? ไม่ฟรี เอกสารของ Google ระบุว่า Gemini 4 Carbon ไม่สามารถใช้งานได้บน Free tier ของ Gemini API คุณต้องมีโปรเจกต์ paid tier ที่ผูกกับ Cloud Billing และมีเครดิตเติมล่วงหน้าอย่างน้อย $5 ในฝั่งผู้ใช้ทั่วไป Google กำลังเปิดให้ Carbon ใช้งานแก่สมาชิก Google AI Ultra ในแอป Gemini, AI Mode และ Antigravity
Gemini 4 Carbon อยู่บน Vertex AI หรือไม่? โพสต์เปิดตัวของ Google ระบุ Gemini API, Google AI Studio, Android Studio, Gemini for business, Antigravity และ CodeMender แต่ไม่ได้ระบุ Vertex AI จึงควรตรวจสอบรายการโมเดลของ Google Cloud ก่อนวางแผนอ้างอิงมัน
Context window ของ Gemini 4 Carbon มีขนาดเท่าไร? 1,048,576 tokens ใช้ร่วมกันระหว่าง input, thinking และ output การตอบกลับแบบ synchronous จะหยุดที่ 65,536 tokens ส่วนการรันแบบ background สามารถทำงานต่อได้ถึง 1M tokens หักลบ input ของคุณ
ใช้ generateContent แทน Interactions API ได้ไหม? Quickstart ของ Google สำหรับ Carbon ใช้ Interactions API และเอกสารของมันกล่าวถึง GenerateContent API สำหรับการทำ long-decode continuation ฝั่ง client ถ้าแอปของคุณใช้ generateContent อยู่แล้ว ให้ทดสอบการเปลี่ยน model ID ที่นั่นก่อนย้ายระบบ
จะเปลี่ยนจาก Gemini 4 Argon ไปใช้ Carbon อย่างไร? เปลี่ยนค่า model string จาก gemini-4-argon เป็น gemini-4-carbon Google ระบุว่าไม่จำเป็นต้องแก้ไข request schema เพิ่ม max_output_tokens และ HTTP timeouts ของคุณ เพราะ Carbon คิดนานกว่า และคง thinking_level ไว้ที่ medium เว้นแต่งานใดต้องใช้ high