
ยังไม่มี Gemini 4 Argon API สาธารณะ และ Google ยังไม่ได้เผยแพร่ ID โมเดล Google ประกาศเปิดตัว Argon เมื่อวันที่ 30 กันยายน 2026 และปัจจุบันมีให้เฉพาะผู้เข้าร่วมโครงการ Fairwind เท่านั้น โดยกลุ่มพันธมิตร Fairwind ใช้เป็นโมเดลที่จัดการบน Gemini Enterprise Artificial Analysis ระบุว่า Google AI Studio เป็นผู้ให้บริการ API เดียวของ Argon แต่ไม่มีข้อมูลความเร็วหรือความหน่วง ซึ่งเหมาะสมกับการเข้าถึงล่วงหน้าแบบจำกัด (allowlisted pre-release) มากกว่าจะเป็นปลายทางที่คุณสามารถลงทะเบียนใช้งานได้ เมื่อเริ่มเปิดตัวในวงกว้างขึ้น Google กล่าวว่าจะเริ่ม "กับลูกค้า API แบบชำระเงินและสมาชิก Google AI Ultra" ดังนั้นคีย์ Gemini API แบบชำระเงินจะทำให้คุณเป็นคนแรกๆ ที่ได้ใช้งาน
ช่องว่างระหว่างการประกาศและการเข้าถึงนี้คือเวลาที่คุณสามารถใช้ประโยชน์ได้ คู่มือนี้จะแยกสิ่งที่เรายืนยันเกี่ยวกับ Argon API ออกจากสิ่งที่ยังไม่ได้ยืนยัน จากนั้นจะแนะนำโค้ดที่คุณสามารถรันได้วันนี้บน Gemini 3.8 Flash เพื่อให้การเปลี่ยนไปใช้ Argon กลายเป็นการเปลี่ยนเพียงตัวแปรเดียว คุณจะได้สร้างคำขอ ตั้งค่าการแจ้งเตือนเมื่อเปิดใช้งาน (go-live alert) จำลองการตอบกลับใน Apidog และเพิ่มเพดานค่าใช้จ่ายตามราคาของ Argon สำหรับตัวโมเดลเอง เริ่มต้นด้วย Gemini 4 Argon คืออะไร; สำหรับขั้นตอนการเปิดตัว โปรดดูคู่มือ วันที่เปิดตัว Gemini 4 Argon
สิ่งที่ได้รับการยืนยันเกี่ยวกับ Gemini 4 Argon API และสิ่งที่ไม่ได้รับการยืนยัน
โพสต์เปิดตัวของ Google ระบุราคาและข้อจำกัดของเอาต์พุต เกือบทุกอย่างที่จำเป็นสำหรับการผสานรวมยังไม่ได้รับการเผยแพร่
| รายการ | สถานะ | รายละเอียด |
|---|---|---|
| ราคาอินพุต | ยืนยันแล้ว | $2 ต่อ 1 ล้านโทเค็น (ช่วงแนะนำ), $4 หลังจากช่วงแนะนำ |
| ราคาเอาต์พุต | ยืนยันแล้ว | $10 ต่อ 1 ล้านโทเค็น (ช่วงแนะนำ), $20 หลังจากนั้น |
| แคชอินพุต | ยืนยันแล้ว | ลด 95% สำหรับอินพุต: $0.10 ช่วงแนะนำ, $0.20 มาตรฐาน |
| ข้อจำกัดเอาต์พุต | ยืนยันแล้ว | 1 ล้านโทเค็น, เพิ่มขึ้นจาก 64K |
| ส่วนต่อประสาน API (API surface) | ระบุไว้ | เอกสารของ Google ระบุว่าโมเดลใหม่ทั้งหมดจะเปิดตัวบน Interactions API |
| Model ID | ยังไม่เผยแพร่ | ไม่มีในหน้าโมเดล หน้าราคา และบันทึกการเปลี่ยนแปลง |
| Input context window | ยังไม่เผยแพร่ | การประเมินบริบทแบบยาวของ Google ใช้พรอมต์สูงสุด 1 ล้านโทเค็น แต่ไม่ใช่ข้อกำหนด |
| ระดับการคิด (Thinking levels) | ยังไม่เผยแพร่ | การประเมินรันที่ "การตั้งค่าการคิดสูงสุด"; ไม่ทราบชื่อและค่าเริ่มต้น |
| ข้อจำกัดอัตรา (Rate limits) | ยังไม่เผยแพร่ | ไม่มีการประกาศระดับชั้น |
| การรองรับ Batch | ยังไม่เผยแพร่ | ไม่มีราคาแบบ Batch หรือ Flex |
| Long-prompt tier | ยังไม่เผยแพร่ | 3.1 Pro คิดค่าบริการเพิ่มสำหรับพรอมต์ที่เกิน 200K; กฎของ Argon ยังไม่ระบุ |
| ระยะเวลาช่วงแนะนำ | ยังไม่เผยแพร่ | ไม่มีวันสิ้นสุดสำหรับราคา $2/$10 |
สองแถวนี้สมควรได้รับการพิจารณาอย่างใกล้ชิด แถวส่วนต่อประสาน API มาจาก เอกสาร Interactions API ซึ่งระบุว่าโมเดลใหม่จะ "เปิดตัวบน Interactions API" Argon เป็นโมเดลใหม่ ดังนั้นคาดว่าจะเปิดตัวที่นั่นก่อน Google ยังไม่ได้กล่าวว่าจะให้บริการผ่าน generateContent หรือไม่ แถวเอาต์พุตคือขีดจำกัดที่ Google ระบุสำหรับโมเดล แต่ Vals AI ระบุเอาต์พุตสูงสุด 262K สำหรับการกำหนดค่าที่ทดสอบ ดังนั้นอย่าเพิ่งสรุปว่าทุกปลายทางจะให้บริการเต็ม 1 ล้านโทเค็นตั้งแต่วันแรก คู่มือ 1M เอาต์พุตโทเค็นของเราครอบคลุมถึงผลกระทบของขีดจำกัดดังกล่าวต่อการสตรีมมิ่ง, การหมดเวลา และการจัดเก็บข้อมูล
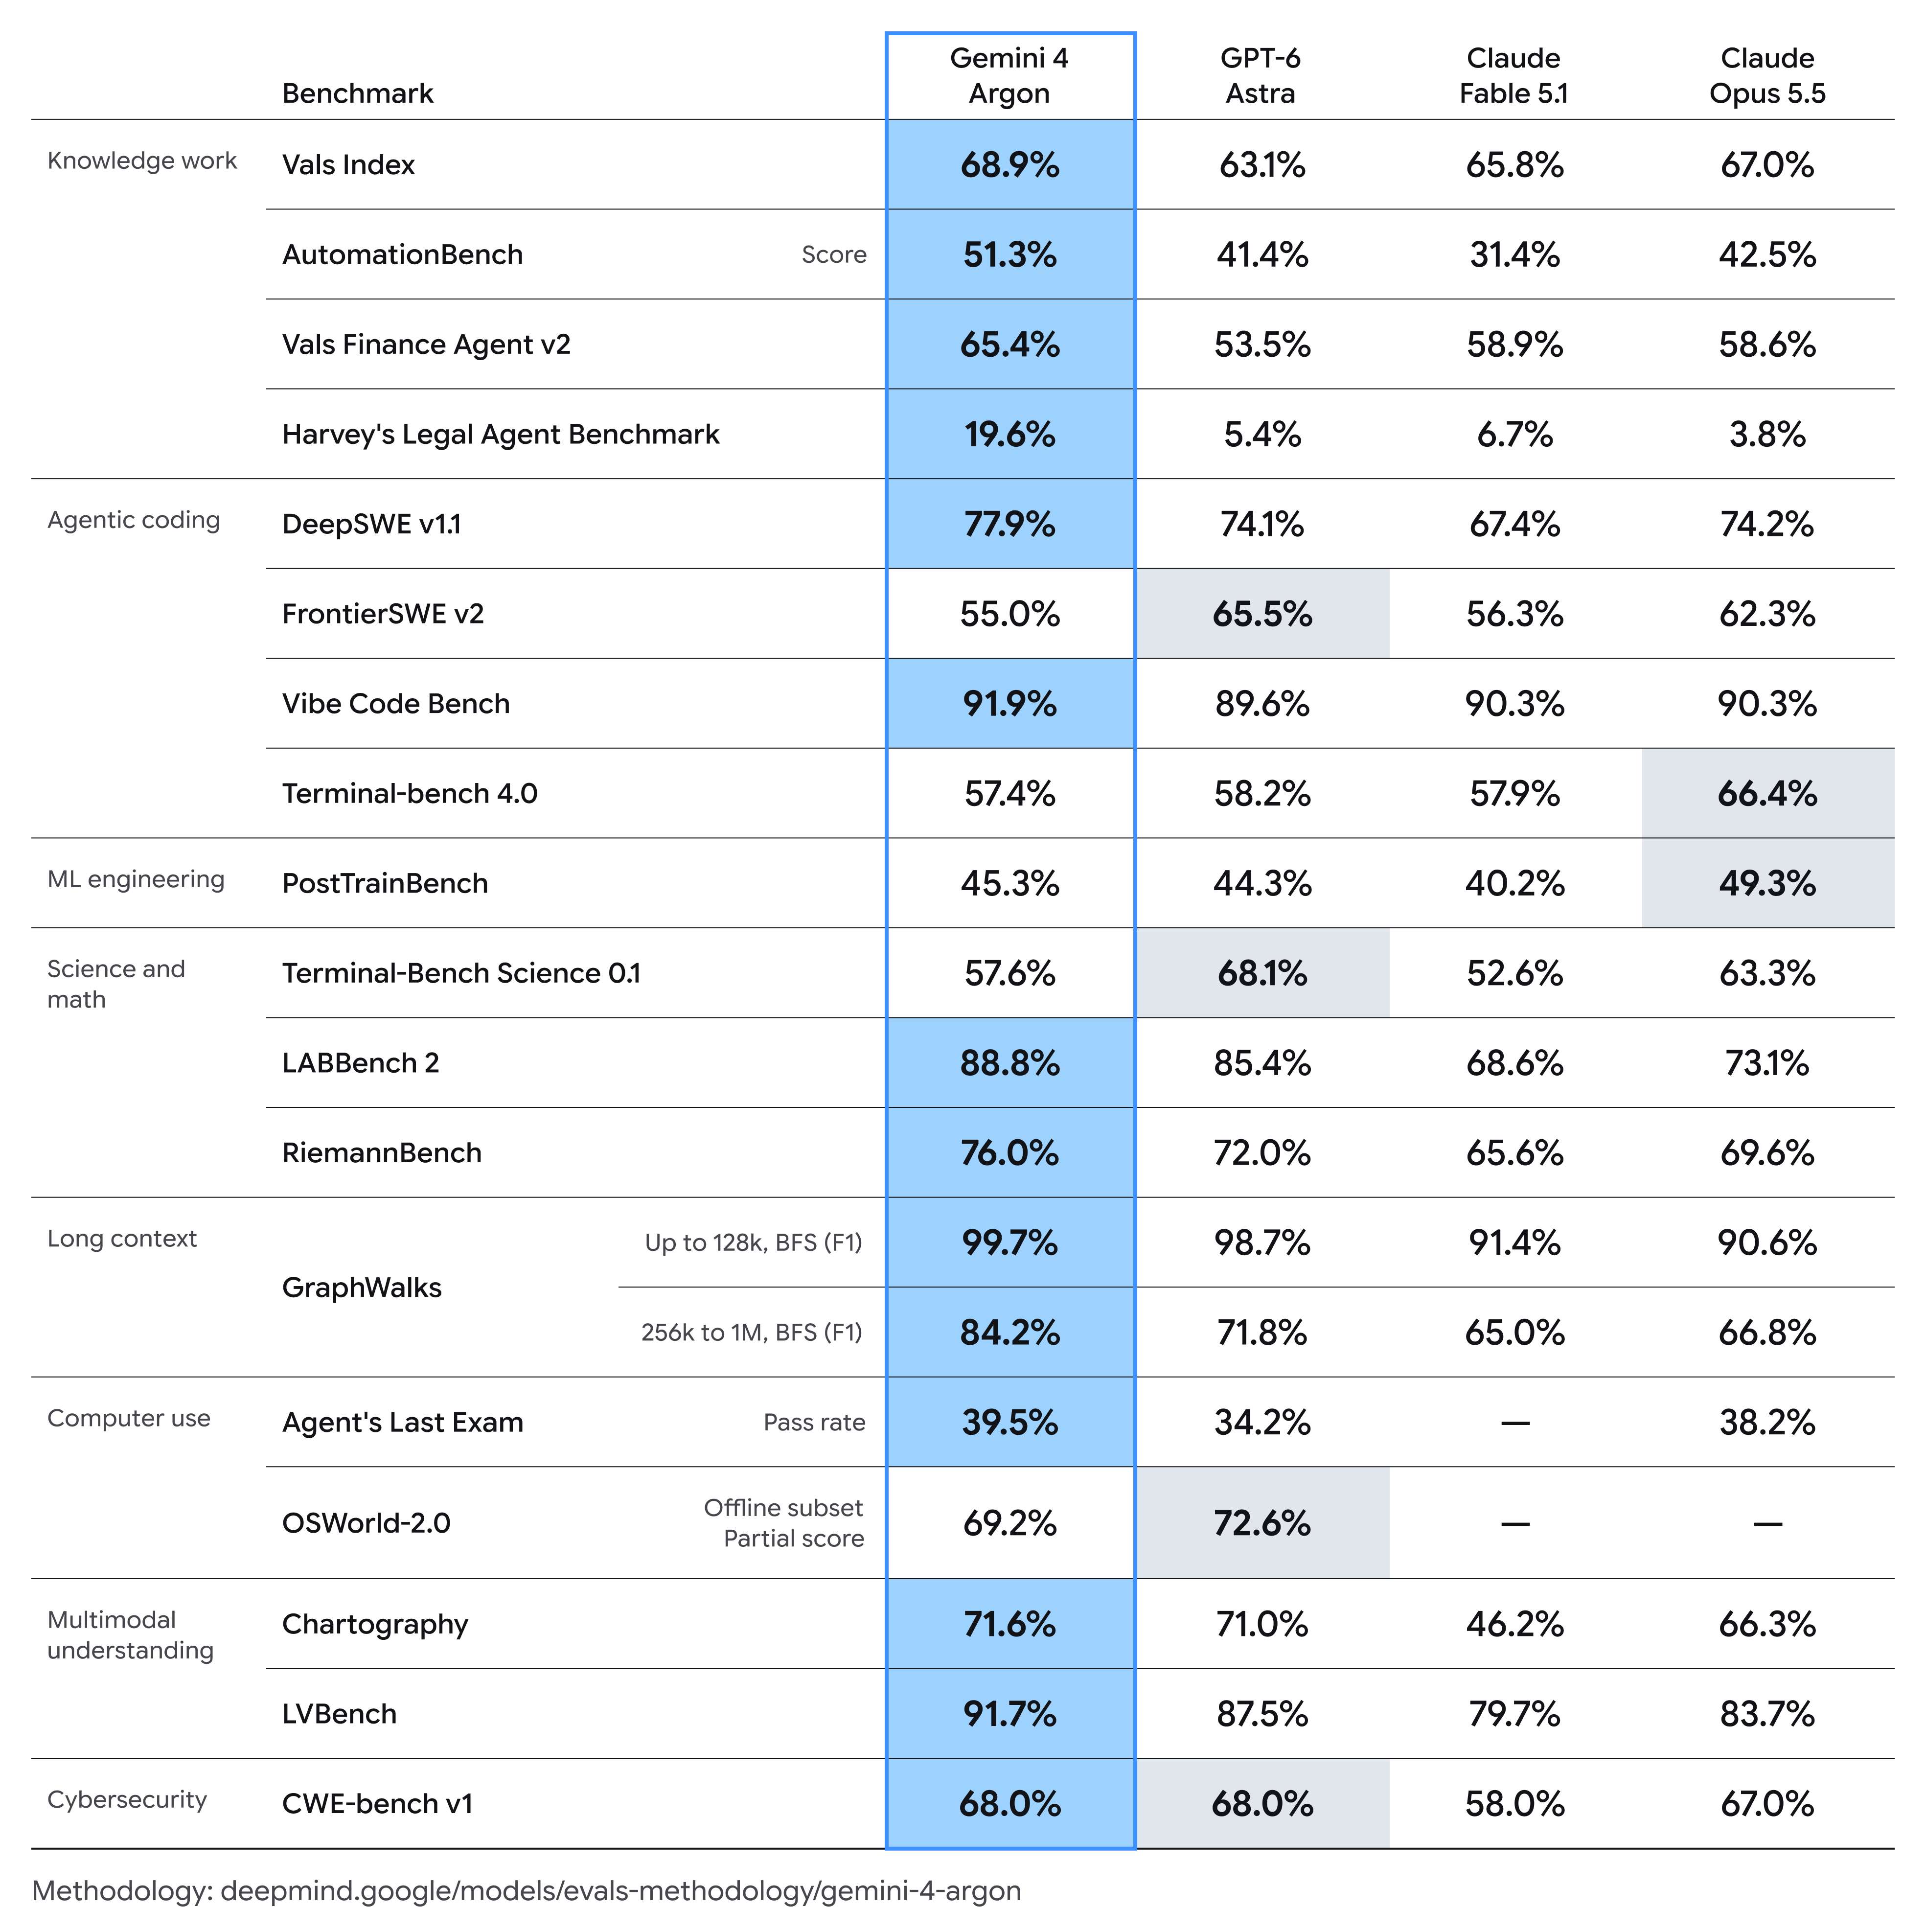
สำหรับเรื่องราคา หนึ่งย่อหน้าก็เพียงพอแล้ว คำขอที่มีพรอมต์ 20,000 โทเค็นและเอาต์พุต 5,000 โทเค็นมีค่าใช้จ่าย 20,000 x $2/1M + 5,000 x $10/1M = $0.04 + $0.05 = $0.09 ในช่วงราคาแนะนำ และ $0.18 ในราคามาตรฐาน $4/$20 ราคาเอาต์พุตช่วงแนะนำของ Argon ($10) ต่ำกว่า Gemini 3.1 Pro Preview ที่ $12 และราคามาตรฐานของมันตรงกับ Claude Opus 5.5 อย่างพอดี การวิเคราะห์ราคา Gemini 4 Argon ครอบคลุมสถานการณ์ทั้งหมด รวมถึงแคชอินพุตและการตอบสนองสูงสุด 1 ล้านโทเค็น
อย่าฮาร์ดโค้ด Model ID ที่คุณพบทางออนไลน์
หากค้นหา Model ID ของ Argon คุณจะพบสตริงต่างๆ บนเว็บไซต์การเปรียบเทียบ (benchmark sites), ตัวรวบรวม (aggregators) และคำขอพูลแบบโอเพนซอร์ส (open-source pull requests) สิ่งเหล่านั้นเป็นเพียงตัวยึดตำแหน่ง (placeholders) Vals AI ใช้ slug ของตัวเองสำหรับหน้าโมเดลของตน คำขอพูลใน GitHub หนึ่งรายการเพิ่ม ID "ชั่วคราว" และพาธสไตล์ OpenRouter นำไปสู่หน้าไม่พบ (not-found page) Google ยังไม่ได้ยืนยันสิ่งใดสิ่งหนึ่งในนั้น และแหล่งข้อมูลหลายแห่งได้เตือนอย่างชัดเจนไม่ให้ฮาร์ดโค้ดการเดา
ID ที่เดาจะล้มเหลวในลักษณะที่ช่วยอะไรไม่ได้เลย: เกิด 404 ใน production ในวันดีพลอย หรือเป็นการสำรองข้อมูลแบบเงียบหาก wrapper ของคุณดักจับข้อผิดพลาดกว้างเกินไป ให้เก็บชื่อโมเดลไว้ในการกำหนดค่าแทน ในตัวอย่างทั้งหมดด้านล่าง โมเดลมาจากตัวแปรสภาพแวดล้อม GEMINI_MODEL ซึ่งมีค่าเริ่มต้นเป็น gemini-3.8-flash ซึ่งเป็นโมเดลที่เสถียรที่คุณสามารถเรียกใช้งานได้ในวันนี้ เมื่อ Google เผยแพร่ ID ของ Argon คุณเพียงแค่เปลี่ยนค่าเดียวเท่านั้น
เตรียมโค้ดของคุณให้พร้อมบน Gemini 3.8 Flash
Gemini 3.8 Flash (gemini-3.8-flash) ทำงานบนปลายทาง (endpoints), ส่วนหัว (headers) และรูปแบบการตอบกลับ (response shapes) เดียวกันกับที่คาดว่า Argon จะใช้ โดยมีค่าใช้จ่าย $0.75/$3.75 ต่อ 1 ล้านโทเค็น จนถึงวันที่ 31 ธันวาคม 2026 คีย์ของคุณอยู่ใน GEMINI_API_KEY; อย่าแปะลงในโค้ดเด็ดขาด การตั้งค่าทั้งหมดอยู่ใน คู่มือ Gemini 3.8 Flash API ของเรา
ขั้นตอนที่ 1: ส่งคำขอ Interactions API
Interactions API คือ API หลักของ Google ซึ่งเปิดให้ใช้งานทั่วไป (Generally Available) ตั้งแต่เดือนมิถุนายน 2026 เก็บทั้งโมเดลและระดับการคิดไว้ในตัวแปร เนื่องจากชื่อระดับของ Argon ยังไม่ได้รับการเผยแพร่
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
Python SDK ต้องการ google-genai เวอร์ชัน 2.3.0 หรือใหม่กว่าสำหรับ Interactions API:
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # reads GEMINI_API_KEY from the environment
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
บน 3.8 Flash ระดับที่ถูกต้องคือ low, medium (ค่าเริ่มต้น) และ high; หากใช้ minimal จะส่งคืน HTTP 400 คู่มือระดับการคิดของเราอธิบายถึงข้อดีข้อเสีย สำหรับการทำงานแบบหลายรอบ ให้ส่ง ID ของการตอบกลับก่อนหน้าเป็น previous_interaction_id และส่ง store: false เพื่อเลือกไม่ใช้การจัดเก็บข้อมูลฝั่งเซิร์ฟเวอร์
ขั้นตอนที่ 2: ทำให้ generateContent path ทำงานต่อไป
โค้ดที่มีอยู่ส่วนใหญ่เรียกใช้ปลายทาง generateContent แบบเก่า ซึ่ง Google ระบุว่ายังคงได้รับการสนับสนุนอย่างเต็มที่ นี่คือคำขอเดียวกัน:
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
สังเกตตำแหน่งของ thinking: generation_config.thinking_level บน Interactions, generationConfig.thinkingConfig.thinkingLevel ที่นี่ หากไคลเอ็นต์ของคุณครอบคลุมทั้งสองแบบ ให้กำหนดเส้นทางโมเดลใหม่ผ่าน Interactions เป็นค่าเริ่มต้น การกำหนดเครื่องมือต้องใช้ความระมัดระวังเช่นเดียวกัน โปรดดู การเรียกใช้ฟังก์ชัน Gemini 3.8 Flash
ขั้นตอนที่ 3: กำหนดเวลาตรวจสอบสถานะพร้อมใช้งานด้วย models.list
อย่ารีเฟรชบันทึกการเปลี่ยนแปลง ให้สอบถาม API ปลายทาง models จะส่งคืนโมเดลที่มีอยู่พร้อมกับขีดจำกัดโทเค็นและวิธีการที่รองรับ:
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # a failed run is the alert
รันทุกชั่วโมงจาก cron หรือตารางเวลา CI โดยใช้คีย์ที่แอปพลิเคชัน production ของคุณใช้ เมื่อเราเรียกใช้การเรียกนี้ในวันที่ 1 ตุลาคม 2026 ด้วยคีย์โปรเจกต์แบบชำระเงิน มันส่งคืนโมเดล 61 รายการ ไม่มี nextPageToken และไม่มีชื่อใดที่มีคำว่า "argon" ในวันที่มันตรงกัน รายการนั้นจะบอกคุณสามสิ่งพร้อมกัน: ชื่อโมเดลจริง, ว่า outputTokenLimit คือ 1M เต็มหรือไม่, และระบุว่ามีวิธีการใดบ้างที่ระบุไว้
ขั้นตอนที่ 4: จำลองการตอบกลับเพื่อให้ไคลเอ็นต์ถูกสร้างขึ้นก่อนการเข้าถึง
คุณไม่จำเป็นต้องมี Argon เพื่อสร้างโค้ดที่ใช้ Argon บันทึกคำขอในขั้นตอนที่ 2 ใน Apidog โดยมี GEMINI_API_KEY และ GEMINI_MODEL เป็นตัวแปรสภาพแวดล้อม ส่งคำขอหนึ่งครั้งไปยัง 3.8 Flash และดึงการตอบกลับจริงไปยังปลายทางเป็นตัวอย่างการตอบกลับ Smart Mock เริ่มต้นของ Apidog สร้างข้อมูลจากสคีมา ดังนั้นให้ตั้งค่าวิธีการจำลองเริ่มต้นของโปรเจกต์เป็น "Response example first" (การตั้งค่าโปรเจกต์, การตั้งค่าฟีเจอร์, การตั้งค่าการจำลอง) URL จำลองจะส่งคืนการตอบกลับที่คุณบันทึกไว้ เพื่อให้ส่วนหน้า, ตัวจัดการคิว และตัวแยกวิเคราะห์ของคุณสามารถทำงานกับมันได้โดยไม่ต้องใช้โทเค็น
โปรดทำความเข้าใจว่าการจำลองนี้คืออะไร: เป็นสคีมาการตอบกลับของ Gemini ปัจจุบัน ไม่ใช่เฉพาะของ Argon เนื่องจาก Google ยังไม่ได้เผยแพร่ แต่มันก็ยังเป็นการเดิมพันที่ถูกต้อง เนื่องจาก Argon คาดว่าจะใช้งานบน API เดียวกัน เพื่อฝึกซ้อมการตอบกลับ Argon ที่มีข้อมูลจำนวนมาก ให้แก้ไข usageMetadata ของตัวอย่างให้มีจำนวนมากและยืนยันว่าโค้ดการเรียกเก็บเงินและการแจ้งเตือนของคุณตอบสนอง
ขั้นตอนที่ 5: ยืนยัน usageMetadata และเพดานค่าใช้จ่าย
ทุกการตอบกลับ generateContent จะรวม usageMetadata เพิ่มสคริปต์ post-processor ใน Apidog ที่กำหนดราคาการตอบกลับแต่ละครั้งตามอัตรามาตรฐานของ Argon เพื่อให้การทดสอบล้มเหลวก่อนที่จะเกิดค่าใช้จ่ายจริง:
// Apidog post-processor: price this response at Gemini 4 Argon's standard rates
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // USD per input token after the intro period
const OUT = 20 / 1e6; // USD per output token; thinking bills as output on current Gemini models
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata is present", () => pm.expect(u).to.be.an("object"));
pm.test("cost under $0.10 at Argon rates", () => pm.expect(cost).to.be.below(0.10));
เลือกเพดานต่อคำขอ; $0.10 เหมาะสำหรับพรอมต์สั้นๆ เช่นนี้ Google ยังไม่ได้ระบุว่า Argon จะคิดค่าใช้จ่ายโทเค็นการคิด (thinking tokens) อย่างไร ดังนั้นสคริปต์จึงถือตามกฎปัจจุบันของ Gemini เก็บคำขอที่บันทึกไว้เดียวกันและรันกับ 3.8 Flash ตอนนี้และ Argon ในภายหลัง: ความแตกต่างในจำนวนโทเค็นและค่าใช้จ่ายคือการเปรียบเทียบการถดถอยของคุณ
คำถามที่พบบ่อย (FAQ)
Gemini 4 Argon API พร้อมใช้งานหรือไม่? ยังไม่เปิดให้สาธารณะ Argon กำลังเปิดตัวให้เฉพาะกลุ่มพันธมิตร Fairwind Program ที่ใช้งานผ่าน Gemini Enterprise ลูกค้า API แบบชำระเงินและสมาชิก Google AI Ultra จะเป็นลำดับถัดไป แต่ยังไม่มีกำหนดวันที่
Model ID ของ Gemini 4 Argon คืออะไร? Google ยังไม่ได้เผยแพร่ ID ใดๆ สตริงบนเว็บไซต์ภายนอกเป็นเพียงตัวยึดตำแหน่ง ดังนั้นให้เก็บชื่อโมเดลไว้ในตัวแปรสภาพแวดล้อมและติดตามจาก models.list
Gemini 4 Argon API จะมีค่าใช้จ่ายเท่าไหร่? $2 สำหรับอินพุตและ $10 สำหรับเอาต์พุตต่อ 1 ล้านโทเค็นในช่วงแนะนำซึ่งยังไม่ระบุระยะเวลา จากนั้นเป็น $4 และ $20 แคชอินพุตลด 95% ดู ราคา Gemini 4 Argon
Argon จะทำงานร่วมกับ generateContent ได้หรือไม่? Google ยังไม่ได้กล่าวไว้ เอกสารระบุว่าโมเดลใหม่ทั้งหมดจะเปิดตัวบน Interactions API ดังนั้นให้สร้างบน Interactions และถือว่า generateContent เป็นทางเลือกสำรอง
Google AI Ultra ให้สิทธิ์เข้าถึง API แก่ฉันหรือไม่? ไม่ใช่ AI Ultra เป็นการสมัครสมาชิกสำหรับผู้บริโภค ไม่ใช่คีย์ API Google กล่าวว่าการเข้าถึง API จะเริ่มจากลูกค้า API แบบชำระเงิน
ขั้นตอนต่อไปของคุณ
ตั้งค่า GEMINI_MODEL ในทุกสภาพแวดล้อม กำหนดเวลาการตรวจสอบ models.list และบันทึกคำขอ Interactions และ generateContent พร้อมกับการยืนยันค่าใช้จ่าย ดาวน์โหลด Apidog เพื่อเก็บคำขอ, การจำลอง และการทดสอบเหล่านั้นไว้ในเวิร์กสเปซเดียว จากนั้นเปลี่ยนตัวแปรเดียวเมื่อ Google เผยแพร่ ID