
Google ได้เปิดตัวโมเดลแปลงคำพูดเป็นคำพูด (speech-to-speech) ใหม่สองตัวเมื่อวันที่ 15 กันยายน 2026 และกระทู้ Hacker News ก็ได้รับคะแนนสะสมมากกว่า 337 คะแนนภายในวันเดียว นั่นเป็นการตอบรับที่ใหญ่หลวงสำหรับการเปิดตัว Voice API และการสนทนาส่วนใหญ่ไม่ได้เกี่ยวกับวิดีโอสาธิต แต่เป็นนักพัฒนาที่ถามคำถามเดียวกัน: มีค่าใช้จ่ายเท่าใดในการสร้างด้วยสิ่งนี้ และคุณจะเชื่อมต่อกับมันได้อย่างไร
นี่คือคู่มือฉบับนั้น gemini-3.8-live และ gemini-3.8-live-extended-thinking กำลังจะเปิดตัวใน Gemini API และ Google AI Studio โดยมี Gemini Enterprise และ Search Live ให้เข้าถึงได้ในรูปแบบพรีวิวส่วนตัว โมเดลทั้งสองรับโทเค็นอินพุตและเอาต์พุตฟรี นอกเหนือจากระดับที่ต้องชำระเงินพร้อมอัตราต่อโทเค็นและต่อนาที ซึ่งเป็นเรื่องผิดปกติสำหรับโมเดลเสียงแบบสด จนกระทั่งคุ้มค่าที่จะเดินผ่านเซสชัน WebSocket ด้วยตัวเอง ไม่ใช่แค่หน้าราคา เราได้เปรียบเทียบผู้ช่วยเสียงสำหรับผู้บริโภคในบทความ GPT-Live vs Gemini Live ไปแล้ว ชิ้นส่วนนี้คือเส้นทางของนักพัฒนาเข้าสู่ API ที่อยู่เบื้องหลังการเปรียบเทียบนั้น
สิ่งที่เปิดตัวจริงเมื่อวันที่ 15 กันยายน
ประกาศของ Google ครอบคลุมสองโมเดล gemini-3.8-live คือโมเดลแปลงคำพูดเป็นคำพูดมาตรฐาน ส่วน gemini-3.8-live-extended-thinking เพิ่มเลเยอร์การให้เหตุผลที่ทำงานในขณะที่โมเดลพูด โดยมีคำอธิบายด้านล่าง ทั้งสองรองรับ 97 ภาษาพร้อมการสลับภาษาอัตโนมัติในระหว่างการสนทนา หมายความว่าผู้โทรสามารถเริ่มประโยคเป็นภาษาอังกฤษและจบเป็นภาษาสเปนได้โดยไม่ต้องตั้งค่าภาษาด้วยตนเอง
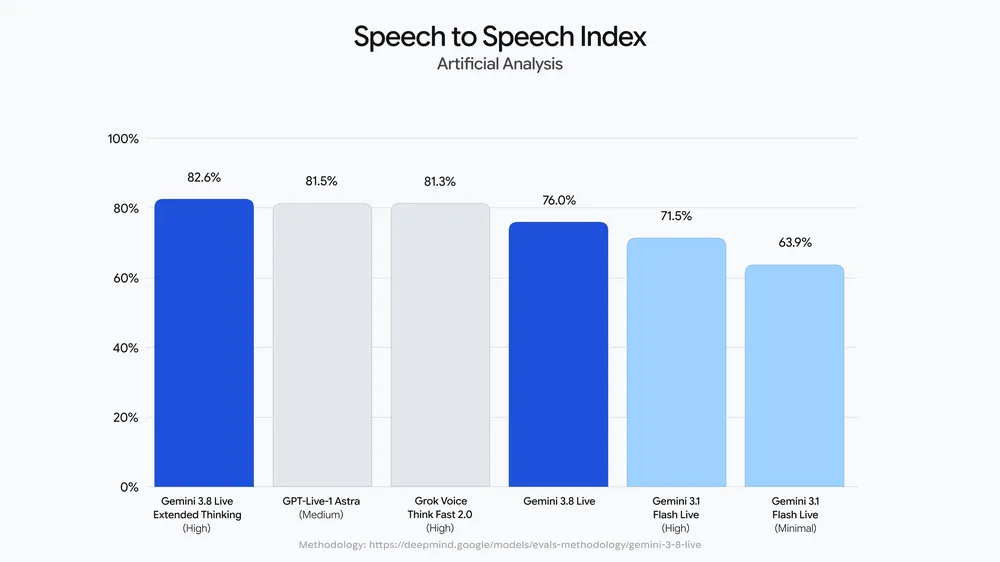
ความพร้อมใช้งานเมื่อเปิดตัว: Gemini API และ Google AI Studio (การเข้าถึงทั่วไป) รวมถึง Gemini Enterprise และ Search Live (พรีวิวส่วนตัว ดังนั้นนักพัฒนาส่วนใหญ่ที่อ่านสิ่งนี้จะเริ่มต้นที่ API หรือ AI Studio) โทเค็นฟรีใช้ได้กับทั้งสองโมเดล ทั้งอินพุตและเอาต์พุต ซึ่งทำให้สามารถสร้างต้นแบบจริงได้โดยไม่ต้องใช้บัตรเครดิต
รายละเอียดหนึ่งที่ Google ยังไม่ได้เผยแพร่: ขีดจำกัดอัตรา (rate limits) สำหรับระดับฟรีของสองโมเดล Live หน้าราคา rate limits เป็นแหล่งข้อมูลที่ถูกต้องเมื่อมีการระบุไว้ ถือว่าตัวเลขใดๆ ที่คุณเห็นที่อื่นยังไม่ได้รับการยืนยัน จนกว่าคุณจะตรวจสอบด้วยตนเองที่นั่น
การเข้าถึง Search Live และ Gemini Enterprise ที่เป็นเพียงพรีวิวส่วนตัว แทนที่จะเปิดเหมือน API เป็นสัญญาณที่ควรตีความ: Google สบายใจที่จะให้นักพัฒนาสร้างสิ่งนี้ในลักษณะที่ใกล้เคียงกับการใช้งานจริง ก่อนที่จะนำโมเดลเดียวกันนี้ไปใช้กับการค้นหาสำหรับผู้บริโภคหรือบัญชีองค์กรแบบชำระเงิน ซึ่งเป็นเรื่องปกติสำหรับการเปิดตัวโมเดลคำพูด และหมายความว่าอินเทอร์เฟซ API เป็นจุดเริ่มต้นที่เสถียรในขณะนี้ ไม่ใช่ตัวอย่างที่ลดทอนฟังก์ชันลงเพื่อประสบการณ์ผู้บริโภคที่ดีขึ้นที่จะมาถึงในภายหลัง
รับคีย์ API ฟรีและเปิดเซสชัน
คีย์ Gemini API มาจาก Google AI Studio โดยผูกติดกับบัญชี Google และสามารถใช้งานได้กับโมเดล Live ในวันเดียวกับที่เปิดตัว เนื่องจากไม่มีขั้นตอนการอนุมัติแยกต่างหากสำหรับระดับฟรี เมื่อคุณมีคีย์แล้ว จุดเชื่อมต่อคือ WebSocket ไม่ใช่ REST endpoint ซึ่งเป็นการปรับเปลี่ยนครั้งแรกหากคุณคุ้นเคยกับการเรียกใช้ generateContent:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent
URL นั้นมาจากบทความเชิงปฏิบัติ hands-on writeup ของ Simon Willison ในวันเปิดตัว ซึ่งตีพิมพ์ควบคู่ไปกับการอ่าน API ใหม่ของเขาอย่างละเอียด เขายังได้ชี้จุดที่น่ารู้ก่อนที่คุณจะสร้าง UI รอบสิ่งนี้: คุณสามารถขัดจังหวะโมเดลกลางคันในระหว่างการตอบกลับได้เช่นเดียวกับที่คุณขัดจังหวะคนกำลังพูด และข้อความถอดเสียงที่ส่งกลับมาอาจรวมถึงคำพูดที่โมเดลเริ่มสร้างแต่ไม่เคยเล่นจนจบ เนื่องจากการเล่นถูกตัดออกโดยการขัดจังหวะของคุณ จัดการสิ่งนี้เป็นสถานะที่แตกต่างกันในไคลเอนต์ของคุณ แทนที่จะสันนิษฐานว่าทุกบรรทัดของข้อความถอดเสียงได้ยินครบถ้วน
เซสชันแบบสองทิศทางผ่านซ็อกเก็ตนั้นเป็นไปตามรูปแบบที่ API แบบสตรีมมิ่งที่ใช้ WebSocket ทุกตัวใช้: ข้อความตั้งค่าแรกที่ระบุโมเดลและการกำหนดค่าการสร้าง จากนั้นเป็นสตรีมของข้อความเนื้อหาที่นำส่วนของเสียงหรือข้อความไปในทิศทางใดทิศทางหนึ่ง โดยเซิร์ฟเวอร์จะผลักดันส่วนการตอบกลับบางส่วนและขั้นสุดท้ายกลับมาเมื่อพร้อม รูปแบบข้อความที่แน่นอนเป็นของ Google ที่จะต้องจัดทำเอกสารอย่างละเอียด และอาจมีการเปลี่ยนแปลงระหว่างพรีวิวและการเปิดตัวทั่วไป ดังนั้น ให้ตรวจสอบชื่อฟิลด์กับ เอกสาร Gemini API แบบสด และเอกสารอ้างอิงสำหรับ SDK ของคุณก่อนที่คุณจะใช้กับไคลเอนต์ที่ใช้งานจริง สิ่งที่เสถียรคือรูปแบบ: เชื่อมต่อ, ส่งการตั้งค่า, สตรีมเนื้อหา, อ่านการตอบกลับแบบสตรีม และคาดหวังว่าการขัดจังหวะจะเป็นเหตุการณ์ปกติมากกว่ากรณีข้อผิดพลาด
ในทางปฏิบัติ นั่นหมายความว่าเซสชันการทำงานแรกของคุณควรมุ่งไปที่ลูปที่เล็กที่สุดเท่าที่จะเป็นไปได้: เปิดซ็อกเก็ต, ส่งข้อความตั้งค่าหนึ่งข้อความที่ระบุโมเดลที่คุณต้องการ (gemini-3.8-live หรือ gemini-3.8-live-extended-thinking), ส่งการตอบกลับเสียงหรือข้อความสั้นๆ เพียงครั้งเดียว และยืนยันว่าคุณได้รับการตอบกลับแบบสตรีมกลับมาก่อนที่จะเพิ่มตรรกะการลองใหม่, การจัดการการเชื่อมต่อใหม่ หรือ UI สร้างเส้นทางการขัดจังหวะเป็นอันดับที่สอง เมื่อเส้นทางที่ไม่มีปัญหาทำงานแล้ว เนื่องจากในการทดสอบให้ดีหมายถึงการพูดแทรกโมเดลกลางคันในระหว่างการตอบกลับโดยเจตนา และตรวจสอบว่าไคลเอนต์ของคุณทำเครื่องหมายข้อความถอดเสียงที่ถูกตัดอย่างถูกต้อง แทนที่จะถือว่าเป็นการตอบสนองที่สมบูรณ์
Extended thinking: เมื่อการให้เหตุผลเกิดขึ้นพร้อมกับการพูด
โมเดล gemini-3.8-live ธรรมดาจะตอบโดยตรง ส่วน gemini-3.8-live-extended-thinking ทำสิ่งที่แตกต่างออกไป: Google กล่าวว่ามัน "ให้เหตุผลและพูดพร้อมกัน" โดยรักษา "การสนทนาที่ต่อเนื่อง" ด้วยการเติมเวลาการให้เหตุผลด้วยคำบอกใบ้ทางวาจา เช่น "ขอฉันตรวจสอบก่อนนะ" แทนที่จะเป็นความเงียบในขณะที่โมเดลกำลังทำงาน
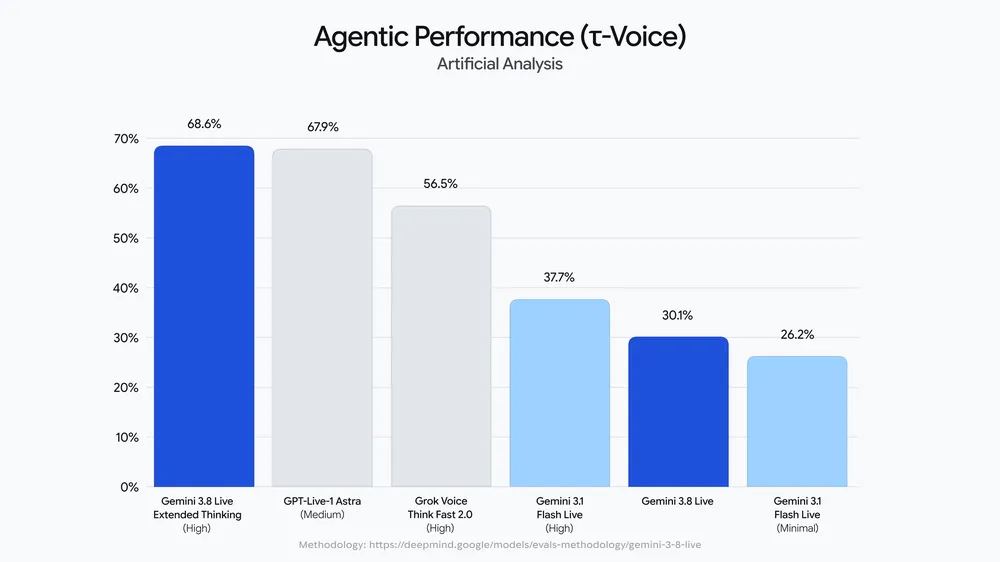
สิ่งนี้สำคัญสำหรับแอปประเภทหนึ่งโดยเฉพาะ: ตัวแทนเสียงที่เรียกใช้เครื่องมือหรือเรียกใช้ API ภายนอกกลางการสนทนา โมเดล extended-thinking "เรียกใช้เครื่องมือและ API ในเบื้องหลังขณะสนทนาต่อ" และการเรียกใช้ฟังก์ชันได้รับการสนับสนุนในทั้งสองโมเดล ลองนึกภาพตัวแทนจองที่ต้องตรวจสอบความพร้อมใช้งานกับ Calendar API: แทนที่จะเงียบไปสองวินาทีในขณะที่การค้นหาทำงาน โมเดลสามารถรับทราบคำขอด้วยเสียงและดำเนินการสนทนาต่อไปในขณะที่การเรียกใช้เสร็จสมบูรณ์ในเบื้องหลัง
เลือก extended thinking เมื่อเซสชันของคุณมีการเรียกใช้เครื่องมือ, การค้นหาหลายขั้นตอน หรือคำตอบที่ต้องใช้การให้เหตุผลมาก ซึ่งความเงียบจะทำให้รู้สึกเหมือนมีอะไรบางอย่างขาดหายไป เลือกโมเดลธรรมดาสำหรับการแลกเปลี่ยนที่สั้นกว่าและมีความหน่วงต่ำ ซึ่งไม่จำเป็นต้องมีค่าใช้จ่ายในการให้เหตุผล ทั้งสองมีราคาต่อโทเค็นเท่ากัน ดังนั้นการเลือกจึงเป็นเรื่องของพฤติกรรม ไม่ใช่งบประมาณ หากตัวแทนของคุณพึ่งพาการเรียกใช้ฟังก์ชันโดยเฉพาะ คู่มือการเรียกใช้ฟังก์ชันสำหรับ Gemini 3.8 Flash ของเราครอบคลุมรูปแบบคำขอที่ Google ใช้ในตระกูล Gemini 3.8 ปัจจุบัน แม้ว่าจะต้องยืนยันเพย์โหลดการเรียกใช้ฟังก์ชันเฉพาะสำหรับ Live กับเอกสาร API ของ Live ก่อนที่จะนำไปใช้งานจริง เนื่องจาก API ข้อความและเสียงไม่รับประกันว่าจะใช้ schema เดียวกัน
ค่าใช้จ่ายจริง
โมเดล Live ทั้งสองใช้ราคามาตรฐานเดียวกัน:
| ประเภท | อัตรา |
|---|---|
| อินพุตข้อความ | $0.75 ต่อ 1 ล้านโทเค็น |
| อินพุตเสียง | $3.00 ต่อ 1 ล้านโทเค็น หรือ $0.005 ต่อนาที |
| อินพุตภาพ/วิดีโอ | $1.00 ต่อ 1 ล้านโทเค็น หรือ $0.002 ต่อนาที |
| เอาต์พุตข้อความ | $4.50 ต่อ 1 ล้านโทเค็น |
| เอาต์พุตเสียง | $12.00 ต่อ 1 ล้านโทเค็น หรือ $0.018 ต่อนาที |
โทเค็นการคิดคำนวณเป็นเอาต์พุต เช่นเดียวกับโมเดล Gemini 3.x อื่นๆ ดังนั้นการให้เหตุผลในเบื้องหลังของ extended thinking จะแสดงอยู่ในรายการเอาต์พุตแทนที่จะเป็นค่าใช้จ่ายแยกต่างหาก
ตัวอย่างการคำนวณ: การโทรด้วยเสียง 10 นาที ทั้งเสียงเข้าและเสียงออกตลอดเวลา ในระดับมาตรฐานแบบชำระเงิน อินพุตเสียง: 10 นาที x $0.005 = $0.05 เอาต์พุตเสียง: 10 นาที x $0.018 = $0.18 รวม: $0.23 สำหรับการสนทนาโต้ตอบ 10 นาทีเต็ม ก่อนที่จะมีการเพิ่มโทเค็นข้อความหรือการเรียกใช้เครื่องมือใดๆ ดำเนินการโทรเดียวกันนั้นในระดับฟรีระหว่างการสร้างต้นแบบและค่าโทเค็นจะเป็นศูนย์ ขึ้นอยู่กับขีดจำกัดอัตราที่ Google จะเผยแพร่ในที่สุด
โมเดล gemini-3.1-flash-live-preview บนหน้าราคาเดียวกันมีอัตราที่เหมือนกับโมเดล Live ใหม่ทั้งสอง ซึ่งควรตรวจสอบหากคุณมีการรวม Live อยู่แล้วบนโมเดลรุ่นเก่า การตัดสินใจด้านราคาไม่ใช่เหตุผลที่จะชะลอการย้ายข้อมูล
นักพัฒนาพูดอะไรบ้างจนถึงตอนนี้
การ สนทนา ใน Hacker News ไม่ได้เป็นบวกอย่างสม่ำเสมอ ข้อร้องเรียนที่เกิดขึ้นซ้ำๆ: ผู้สมัครใช้บริการ Google Workspace และ Google AI Plus แบบชำระเงินยังไม่สามารถเข้าถึงประสบการณ์ Live ใหม่สำหรับผู้บริโภคได้ แม้ว่าพวกเขาจะเป็นลูกค้าที่ชำระเงินแล้ว ในขณะที่ API และ AI Studio เปิดให้เข้าถึงได้ รายงานหนึ่งจากกระทู้อธิบายถึงลูปแบบเอเจนต์ที่โมเดลสร้างข้อกำหนดเพิ่มเติมที่ไม่ได้เป็นส่วนหนึ่งของงานเดิม ซึ่งเป็นโหมดความล้มเหลวที่ควรทดสอบโดยเฉพาะ หากคุณกำลังเชื่อมต่อ Live เข้ากับเอเจนต์อัตโนมัติ แทนที่จะเป็นผู้ช่วยเสียงที่มีมนุษย์เข้ามาเกี่ยวข้อง หากคุณกำลังสร้างสิ่งที่ใกล้เคียงกับลูปอัตโนมัติมากกว่าผู้ช่วยที่มีการควบคุมดูแล ให้เพิ่มการตรวจสอบที่ชัดเจนที่เปรียบเทียบสิ่งที่โมเดลอ้างว่าต้องการกับคำจำกัดความของงานที่คุณให้ไว้ แทนที่จะเชื่อข้อกำหนดที่โมเดลระบุตามตัวอักษร ถือว่าทั้งสองประเด็นเป็นสัญญาณแรกจากกระทู้เดียว ไม่ใช่รายงานข้อบกพร่องที่ได้รับการยืนยัน และทดสอบซ้ำกับกรณีการใช้งานของคุณเองก่อนที่จะสรุปจากข้อมูลเหล่านั้น
ดูโปรโตคอลดิบก่อนที่คุณจะเขียนโค้ดไคลเอนต์
ก่อนที่จะตัดสินใจใช้ไลบรารีไคลเอนต์ การดูเฟรมจริงที่ส่งผ่านสายมีประโยชน์ Apidog สามารถเปิดการเชื่อมต่อ WebSocket ไปยัง BidiGenerateContent endpoint ส่งข้อความตั้งค่า JSON และข้อความเนื้อหาที่ตามมาด้วยตนเอง และแสดงเฟรมที่ถูกสตรีมกลับมาแบบเรียลไทม์ ซึ่งเป็นวิธีที่เร็วที่สุดในการทำความเข้าใจรูปแบบการตั้งค่าแล้วสตรีม ก่อนที่คุณจะเขียนโค้ด SDK รอบๆ Apidog ไม่ได้บันทึกเสียงจากไมโครโฟนให้คุณ คุณต้องจัดเตรียมเพย์โหลดเสียงหรือข้อความด้วยตนเอง และใช้การเชื่อมต่อเพื่อตรวจสอบสิ่งที่เซิร์ฟเวอร์ส่งกลับมา ยืนยันว่าข้อความตั้งค่าของคุณได้รับการยอมรับ และดูว่าการขัดจังหวะทำงานอย่างไรก่อนที่คุณจะสร้างการจัดการข้อผิดพลาดสำหรับการใช้งานจริง เอกสารอ้างอิงโปรโตคอลฉบับเต็มสำหรับการสร้างและทดสอบ WebSocket API ในลักษณะนี้อยู่ที่ docs.apidog.com ดาวน์โหลด Apidog เพื่อลองเชื่อมต่อด้วยตนเองก่อนการสร้างไคลเอนต์ครั้งแรกของคุณ
สำหรับการเปรียบเทียบ บทความ WebSocket vs WebRTC ของเราครอบคลุมเหตุผลที่ Google เลือก WebSocket สำหรับสตรีมแบบสองทิศทางนี้ แทนที่จะเป็นเส้นทาง WebRTC ที่ Voice API ของคู่แข่งบางรายใช้ และข้อดีข้อเสียนั้นมีความหมายอย่างไรสำหรับไคลเอนต์เบราว์เซอร์โดยเฉพาะ
คำถามที่พบบ่อย
Gemini 3.8 Live API ฟรีหรือไม่? ใช่ สำหรับทั้งสองโมเดล โทเค็นอินพุตและเอาต์พุตฟรีในระดับฟรี อัตรามาตรฐานแบบชำระเงินจะถูกนำมาใช้เมื่อคุณใช้เกินขีดจำกัดอัตราที่ Google กำหนด และขีดจำกัดระดับฟรีนั้นยังไม่ได้เผยแพร่ ดังนั้น โปรดตรวจสอบ หน้าราคา rate limits โดยตรง
ความแตกต่างระหว่างสองโมเดลใหม่คืออะไร? gemini-3.8-live ตอบโดยตรง ส่วน gemini-3.8-live-extended-thinking ให้เหตุผลขณะพูด โดยใช้คำพูดเสริมเพื่อครอบคลุมการเรียกใช้เครื่องมือในเบื้องหลังและการค้นหาหลายขั้นตอน โดยมีราคาโทเค็นเท่ากัน
ฉันจำเป็นต้องใช้ WebRTC เพื่อใช้งานสิ่งนี้หรือไม่? ไม่ API นี้ใช้ WebSocket โดยเชื่อมต่อกับ BidiGenerateContent endpoint แทนที่จะเป็นการเชื่อมต่อแบบเพียร์ WebRTC
ฉันสามารถทดสอบสิ่งนี้ได้โดยไม่ต้องเขียนไคลเอนต์หรือไม่? ได้ เปิด WebSocket ใน Apidog ส่งข้อความตั้งค่าและข้อความเนื้อหาด้วยตนเอง และอ่านการตอบกลับแบบสตรีมก่อนที่จะสร้างไคลเอนต์จริงรอบๆ มัน