Google ได้เปิดตัว Gemini 3.7 Flash เมื่อวันที่ 13 สิงหาคม 2026 สามสัปดาห์หลังจาก 3.6 Flash และเรียกมันว่า “โมเดลทำงานหนักที่ชาญฉลาดที่สุดของเรา” ผลการวัดประสิทธิภาพที่เพิ่มขึ้นเป็นการยืนยันความมั่นใจนี้ DeepSWE เพิ่มขึ้นจาก 49.0% เป็น 65.3%, AutomationBench เพิ่มขึ้นจาก 17.0% เป็น 30.4% และราคาเปิดตัวที่ 0.75 ดอลลาร์ต่อ 1 ล้านโทเค็นอินพุตนั้นเป็นเพียงครึ่งหนึ่งของราคา 3.6 Flash ตอนเปิดตัว
การผสมผสานนี้ทำให้เกิดคำถามที่ทีม API ทุกทีมต้องเผชิญในไตรมาสนี้: โมเดล Gemini ที่เร็วและราคาถูกนี้สามารถรองรับปริมาณงานที่คุณเคยส่งไปยัง Claude หรือ GPT ได้แล้วหรือยัง? การเปรียบเทียบนี้จะยึดตามสิ่งที่คุณสามารถตรวจสอบได้: ขนาดหน้าต่างบริบท (context windows), รูปแบบข้อมูล (modalities), การสนับสนุนเครื่องมือ (tool support), โครงสร้างราคา และรูปแบบคำขอ (request schemas) ที่คุณจะใช้งานร่วมด้วย; หากตัวเลขของคู่แข่งไม่สามารถเปรียบเทียบกันได้ ก็จะระบุไว้ และเนื่องจากคำตอบที่ซื่อสัตย์สำหรับคำถาม “คุณควรใช้ API ตัวไหน” คือ “ตัวที่ทำงานได้ดีที่สุดสำหรับปริมาณงานของคุณ” ส่วนสุดท้ายจะแสดงวิธีการรันทั้งสามแบบเคียงข้างกันใน Apidog ก่อนที่คุณจะตัดสินใจ
หากคุณตัดสินใจเลือกใช้ Gemini และต้องการขั้นตอนการตั้งค่า คู่มือเริ่มต้นใช้งาน Gemini 3.7 Flash API จะครอบคลุมถึงคีย์, endpoints และคำขอแรก
TL;DR
- Gemini 3.7 Flash: บริบท 1M โทเค็น, จำกัดเอาต์พุต 64k, รองรับอินพุตหลายรูปแบบได้แก่ ข้อความ รูปภาพ วิดีโอ เสียง และ PDF, พร้อมการเรียกใช้ฟังก์ชัน (function calling), การค้นหาในฐานะเครื่องมือ (search as a tool) และการใช้งานคอมพิวเตอร์ (computer use)
- ราคาโปรโมชัน: 0.75 ดอลลาร์ต่อ 1M โทเค็นอินพุต และ 3.75 ดอลลาร์ต่อ 1M โทเค็นเอาต์พุต ถึงวันที่ 31 ธันวาคม 2026 โดยจะเพิ่มเป็นสองเท่าเป็น 1.50 ดอลลาร์และ 7.50 ดอลลาร์ ในวันที่ 1 มกราคม 2027
- ประสิทธิภาพด้านการเขียนโค้ดที่เพิ่มขึ้นจาก 3.6 Flash: DeepSWE v1.1 จาก 49.0% เป็น 65.3%, FrontierCode 1.1 Main จาก 34.4% เป็น 43.6%, AutomationBench จาก 17.0% เป็น 30.4%
- Claude Fable 5 และ GPT-5.6 Sol ยังคงเป็นผู้นำด้านความลึกของการเขียนโค้ดขั้นสูงและความสอดคล้องของเอเจนต์ ด้วยราคาต่อโทเค็นที่สูงกว่าหลายเท่า
- ผู้ให้บริการทั้งสามใช้รูปแบบคำขอ (request schemas) ที่ไม่เข้ากัน: Google ใช้
contents, Anthropic ใช้ Messages, OpenAI ใช้messages - ผลการวัดประสิทธิภาพทำนายค่าเฉลี่ย ไม่ใช่ปริมาณงานของคุณ; ควรทดสอบด้วย 20 prompts ใน API ทั้งสามก่อนตัดสินใจ
วิธีอ่านการเปรียบเทียบนี้
นี่ไม่ใช่การเปรียบเทียบระหว่างโมเดลขั้นสุดยอดกับโมเดลขั้นสุดยอด Claude Fable 5 และ GPT-5.6 Sol เป็นเรือธงที่ตั้งราคาไว้เพื่อประสิทธิภาพสูงสุด; ส่วน Gemini 3.7 Flash เป็นโมเดลทำงานหนักที่ตั้งราคาเพื่อปริมาณงาน Google กำลังเปิดตัวโมเดลนี้ในขณะที่โมเดลเรือธงยังคงรอคอย: Axios รายงานว่า Gemini 3.5 Pro ยังคงล่าช้า โดย Flash อัปเดตมาก่อน
การเปรียบเทียบนี้ยังคงคุ้มค่าที่จะทำ: คะแนนเปิดตัวของ 3.7 Flash ตอนนี้ทับซ้อนกับช่วงที่โมเดลขั้นสุดยอดเคยอยู่เมื่อหลายสัปดาห์ก่อน และสิ่งนี้เปลี่ยนแปลงการคำนวณเส้นทาง (routing calculus) แม้ว่าโมเดลเรือธงจะยังคงนำหน้าอยู่ก็ตาม
มีข้อควรระวังสองประการตลอดการเปรียบเทียบนี้ ประการแรก ทุกตัวเลขในที่นี้เป็นตัวเลขที่รายงานโดยผู้จำหน่ายในช่วงสัปดาห์เปิดตัว; ควรถือเป็นแนวทางจนกว่าการประเมินอิสระจะออกมา ประการที่สอง รูปแบบการวัดประสิทธิภาพมีความสำคัญ Google รายงาน FrontierCode 1.1 Main ในขณะที่ตัวเลขที่เผยแพร่สำหรับ Claude และ GPT ในการเปิดตัวของพวกเขามาจาก Extended split ดังนั้นคอลัมน์เหล่านั้นจึงไม่ได้อยู่ในตารางเดียวกันที่นี่
ข้อมูลจำเพาะแบบเทียบเคียง
แผ่นข้อมูลจำเพาะแสดงให้เห็นว่า Gemini 3.7 Flash สามารถแข่งขันกับโมเดลที่มีราคาสูงกว่ามากได้อย่างไร รายละเอียดทางเทคนิคฉบับเต็มสามารถดูได้ที่ หน้าโมเดล Gemini Flash
| Gemini 3.7 Flash | Claude Fable 5 | GPT-5.6 Sol | |
|---|---|---|---|
| ผู้พัฒนา | Anthropic | OpenAI | |
| หน้าต่างบริบท | 1M โทเค็น | 1M โทเค็น | 1.05M โทเค็น |
| ขีดจำกัดเอาต์พุต | 64k โทเค็น | ดูเอกสารของผู้ให้บริการ | ดูเอกสารของผู้ให้บริการ |
| รูปแบบอินพุต | ข้อความ, รูปภาพ, วิดีโอ, เสียง, PDF | ข้อความ, รูปภาพ | ข้อความ, รูปภาพ |
| เอาต์พุต | ข้อความ | ข้อความ | ข้อความ |
| การสนับสนุนเครื่องมือ | การเรียกใช้ฟังก์ชัน, การค้นหาเป็นเครื่องมือ, การใช้งานคอมพิวเตอร์ | การเรียกใช้ฟังก์ชัน, การใช้เครื่องมือ | การเรียกใช้ฟังก์ชัน, เครื่องมือในตัว |
| รูปแบบคำขอ | Google contents + generationConfig |
Anthropic Messages | OpenAI messages |
| การยืนยันตัวตน | เฮดเดอร์ x-goog-api-key |
เฮดเดอร์ x-api-key + เวอร์ชัน |
โทเค็น Bearer |
| ราคา (ต่อ 1M โทเค็น) | $0.75 อินพุต / $3.75 เอาต์พุต (ราคาเปิดตัว); $1.50 / $7.50 ตั้งแต่ ม.ค. 2027 | ระดับพรีเมียมขั้นสูงสุด | ระดับพรีเมียมขั้นสูงสุด |
| การวางตำแหน่ง | โมเดลทำงานหนักสำหรับปริมาณงานสูง | งานเอเจนต์ระยะยาว | ความลึกของการเขียนโค้ดระดับคลัง (repository) |
ขณะนี้หน้าต่างบริบทมีขนาดเท่ากันอย่างมีประสิทธิภาพ ดังนั้นแถวนั้นจึงไม่มีผลต่อการตัดสินใจอีกต่อไป ส่วนแถวของรูปแบบข้อมูลและราคาเป็นจุดที่ทั้งสามมีความแตกต่างกัน และส่วนถัดไปจะอธิบายทั้งสองประการนี้
การเขียนโค้ดและงานเอเจนต์
ข้อเรียกร้องหลักของ Google สำหรับ 3.7 Flash มุ่งเน้นไปที่นักพัฒนา: ดีขึ้นในการดีบั๊ก, มีความสามารถมากขึ้นในการสร้างโค้ดที่สามารถใช้งานได้ตั้งแต่ครั้งแรก, และรอบคอบมากขึ้นในการวางแผนหลายขั้นตอนและการเรียกใช้เครื่องมือ ตัวเลขที่เพิ่มขึ้นจากรุ่นสู่รุ่น ซึ่งได้รับการยืนยันใน รายงานการเปิดตัวของ 9to5Google เป็นการสนับสนุนข้อเรียกร้องดังกล่าว
| Benchmark | Gemini 3.6 Flash | Gemini 3.7 Flash |
|---|---|---|
| DeepSWE v1.1 (การแก้ไขระดับคลัง) | 49.0% | 65.3% |
| FrontierCode 1.1 Main | 34.4% | 43.6% |
| WebDev Arena (Elo) | 1538 | 1588 |
| GDP.pdf (การให้เหตุผลเอกสาร) | 22.0% | 34.0% |
| AutomationBench (งานเอเจนต์) | 17.0% | 30.4% |
การเพิ่มขึ้นของ AutomationBench เป็นสิ่งที่ผู้สร้างเอเจนต์ควรให้ความสนใจ การที่เกือบจะเพิ่มเป็นสองเท่าในผลการวัดประสิทธิภาพของเอเจนต์ภายในสามสัปดาห์ บ่งชี้ว่าข้ออ้างที่ว่า “คิดอย่างรอบคอบมากขึ้นในการเรียกใช้เครื่องมือ” นั้นเป็นมากกว่าแค่การตลาด
สิ่งนี้เปรียบเทียบกับ Claude และ GPT ได้อย่างไร? ใน DeepSWE v1.1 โมเดลระดับสูงสุดทำคะแนนได้ 73.0% สำหรับ GPT-5.6 Sol Max ในการเปิดตัว โดยมี Grok 4.6 อยู่ที่ 65.9%; การเปรียบเทียบ Grok 4.6 vs GPT-5.6 Sol vs Claude Fable 5 ของเราครอบคลุมผลลัพธ์เหล่านั้นอย่างละเอียด Sol Max ยังคงเป็นผู้นำอย่างแท้จริงในการแก้ไขข้อบกพร่องขนาดใหญ่ระดับคลัง และจุดแข็งของ Claude Fable 5 คือความสอดคล้องในการประเมินการเขียนโค้ดและเอเจนต์ ซึ่งแทบไม่เคยแย่กว่าอันดับสอง Gemini 3.7 Flash ยังไม่ได้ปิดช่องว่างนั้น มันมาถึงในระยะที่น่าจับตามองด้วยต้นทุนที่น้อยกว่ามาก ซึ่งเป็นข้อเสนอคุณค่าที่แตกต่างจาก “คะแนนที่ดีที่สุดคือผู้ชนะ”
ตัวเลขผู้เชี่ยวชาญสองตัวช่วยเติมเต็มภาพ: 90.7% บน Harvey LAB-AA สำหรับการให้เหตุผลทางกฎหมาย และ 97.0% ในการดึงข้อมูล 128k-needle ซึ่งเป็นคะแนนที่ทำให้หน้าต่าง 1M มีความน่าเชื่อถือในการใช้งานจริง
อินพุตหลายรูปแบบ
นี่คือความแตกต่างเชิงโครงสร้างที่ชัดเจนที่สุดระหว่าง API ทั้งสาม Gemini 3.7 Flash รับข้อความ รูปภาพ วิดีโอ เสียง และ PDF ในอาร์เรย์ contents เดียวกันผ่าน endpoint เดียว Claude และ GPT จัดการข้อความและรูปภาพได้ดี แต่ปริมาณงานวิดีโอและเสียงมักจะต้องผ่านขั้นตอนการถอดความหรือการประมวลผลล่วงหน้าแยกต่างหากก่อนที่ข้อความจะไปถึงโมเดล
หากผลิตภัณฑ์ของคุณเกี่ยวข้องกับเอกสาร การเพิ่มขึ้นของ GDP.pdf จาก 22.0% เป็น 34.0% คือสัญญาณที่เกี่ยวข้อง: การวัดประสิทธิภาพนั้นวัดการให้เหตุผลบนไฟล์ PDF ในโลกจริงที่มีตาราง, การสแกน และเลย์เอาต์ที่เสียหาย การป้อนสัญญาหรือใบแจ้งหนี้เข้าสู่โมเดลโดยตรงโดยไม่ต้องผ่านไปป์ไลน์ OCR จะช่วยขจัดขั้นตอนที่มักเกิดข้อผิดพลาดทั้งหมดออกจากสถาปัตยกรรมของคุณ
กฎปฏิบัติ: สำหรับแชทข้อความและรูปภาพ รูปแบบข้อมูลไม่ได้มีความแตกต่างกันมากนัก สำหรับเฟรมวิดีโอ, การบันทึกการโทร หรือกองเอกสาร, Gemini เป็นเพียงหนึ่งเดียวในสามโมเดลที่ไปป์ไลน์อินพุตสามารถรวมเป็น API call เดียวได้
ปรัชญาการกำหนดราคา
ผู้จำหน่ายทั้งสามรายใช้กลยุทธ์การกำหนดราคาที่แตกต่างกัน และความแตกต่างนี้จะบอกคุณว่าแต่ละโมเดลเหมาะสำหรับใคร
Google กำหนดราคา 3.7 Flash เพื่อแย่งชิงส่วนแบ่งตลาด อัตราโปรโมชันที่ 0.75 ดอลลาร์ต่อ 1M โทเค็นอินพุต และ 3.75 ดอลลาร์ต่อ 1M โทเค็นเอาต์พุต จะมีผลถึงวันที่ 31 ธันวาคม 2026 และเป็นเพียงครึ่งหนึ่งของราคา 3.6 Flash ตอนเปิดตัว ในวันที่ 1 มกราคม 2027 อัตรามาตรฐานจะเพิ่มขึ้นเป็น 1.50 ดอลลาร์และ 7.50 ดอลลาร์ ซึ่งเพิ่มขึ้น 2 เท่าอย่างชัดเจน กำหนดเส้นตายดังกล่าวเป็นปัจจัยบังคับ: Google ต้องการให้ปริมาณการใช้งานของคุณเข้ามาแล้วก่อนที่ราคาจะถูกรีเซ็ต การคำนวณโทเค็นทั้งหมด พร้อมตัวอย่างการทำงานสำหรับแชทบอทและ agent loops อยู่ใน รายละเอียดราคา Gemini 3.7 Flash ของเรา
Anthropic และ OpenAI กำหนดราคาโมเดลเรือธงของตนในฐานะขีดความสามารถระดับพรีเมียม อัตราจะแตกต่างกันไปตามระดับและมีการเปลี่ยนแปลงบ่อยครั้ง แต่รูปแบบยังคงสอดคล้องกัน: โทเค็นเอาต์พุตระดับสูงสุดมีราคาสูงกว่าที่ Flash คิดค่าบริการหลายเท่า และผู้จำหน่ายทั้งสองรายขายความพรีเมียมจากการทำงานผิดพลาดน้อยลง ไม่ใช่จากโทเค็นที่ถูกกว่า Anthropic เพิ่มพารามิเตอร์ effort ที่แลกเปลี่ยนต้นทุนกับขีดความสามารถภายในโมเดลเดียว; ในขณะที่ OpenAI แบ่งระดับตามขนาดของโมเดลแทน
ปรัชญาไหนจะชนะขึ้นอยู่กับเศรษฐศาสตร์ความล้มเหลวของคุณ โมเดลราคาถูกที่ทำงานล้มเหลวจะสร้างภาระงานซ่อมแซมที่แพงกว่าโทเค็นที่ประหยัดได้ โมเดลพรีเมียมจะคุ้มค่าก็ต่อเมื่อมันป้องกันความล้มเหลวเหล่านั้นได้ เปรียบเทียบต้นทุนต่อภารกิจที่สำเร็จ ไม่ใช่ต้นทุนต่อโทเค็น และประเมินราคาใหม่หลังวันที่ 1 มกราคม 2027 เมื่ออัตราของ Gemini เพิ่มเป็นสองเท่า
ความสะดวกในการใช้งาน API
ความแตกต่างของรูปแบบคือสิ่งที่คุณต้องจ่ายเมื่อคุณเปลี่ยนผู้ให้บริการหรือส่งเส้นทางระหว่างผู้ให้บริการเหล่านั้น นี่คือคำขอแบบหนึ่งรอบเดียวกันในทั้งสามรูปแบบ
Gemini API ของ Google ห่อรอบการสนทนาใน contents ด้วย parts และการตั้งค่าการสร้างจะอยู่ใน generationConfig:
{
  "contents": [
    { "role": "user", "parts": [{ "text": "Summarize this changelog." }] }
  ],
  "generationConfig": { "temperature": 0.3, "maxOutputTokens": 1024 }
}
Messages API ของ Anthropic วางโมเดลและ max_tokens ที่จำเป็นไว้ที่ระดับบนสุด โดยมี system prompt เป็นฟิลด์ของตัวเอง:
{
  "model": "claude-fable-5",
  "max_tokens": 1024,
  "system": "You summarize changelogs in three bullets.",
  "messages": [{ "role": "user", "content": "Summarize this changelog." }]
}
OpenAI รวม system prompt เข้าไปในอาร์เรย์ messages โดยตรง:
{
  "model": "gpt-5.6-sol",
  "messages": [
    { "role": "system", "content": "You summarize changelogs in three bullets." },
    { "role": "user", "content": "Summarize this changelog." }
  ]
}
กรณีข้อความดูใกล้เคียงพอที่จะแก้ไขได้ด้วยอะแดปเตอร์ การใช้เครื่องมือคือจุดที่นามธรรมรั่วไหล: Google ประกาศฟังก์ชันในอาร์เรย์ tools ด้วย functionDeclarations และควบคุมการเรียกใช้ผ่าน toolConfig, Anthropic ใช้รูปแบบเครื่องมือของตัวเองพร้อมบล็อกการตอบกลับที่แตกต่างกัน, และ OpenAI ก็มีรูปแบบฟังก์ชันของตัวเองอีกครั้ง รูปแบบของ Streaming chunk ก็แตกต่างกันเช่นกัน แม้ว่าทั้งสามจะใช้ server-sent events เกตเวย์และ endpoints ที่เข้ากันได้จะทำให้รูปแบบแชทพื้นฐานเป็นมาตรฐาน แต่ส่วนประกอบหลายรูปแบบและการเรียกใช้เครื่องมือมักไม่สามารถแปลได้อย่างราบรื่น; เราได้บันทึกปัญหาเดียวกันนี้ในผู้ให้บริการหลายรายใน การเปรียบเทียบรูปแบบ API สำหรับ DeepSeek V4 Pro
คำแนะนำในการรวมระบบนั้นไม่น่าตื่นเต้น: ให้มีเลเยอร์ผู้ให้บริการที่บางระหว่างผลิตภัณฑ์ของคุณกับโมเดล ทีมที่ทำเช่นนี้สามารถเปลี่ยนผู้ให้บริการได้ในเวลาไม่กี่วันแทนที่จะเป็นหลายเดือน
เวลาที่ควรเลือกแต่ละตัว
ผลการวัดประสิทธิภาพและรูปแบบที่สรุปเป็นรายการตัดสินใจ:
- เลือก Gemini 3.7 Flash สำหรับปริมาณงานเอเจนต์สูง, ไปป์ไลน์หลายรูปแบบที่รับข้อมูลวิดีโอ, เสียง หรือ PDF, และปริมาณงานใดๆ ที่ต้นทุนต่อการเรียกใช้เป็นตัวจำกัดกำไรของผลิตภัณฑ์ นอกจากนี้ยังเป็นพื้นที่ทดลองที่ชัดเจนสำหรับการทดลองใช้งานคอมพิวเตอร์; การวิเคราะห์การใช้งานคอมพิวเตอร์เทียบกับ Structured APIs ของเราครอบคลุมถึงเวลาที่ความสามารถนั้นคุ้มค่า
- เลือก Claude Fable 5 สำหรับงานอัตโนมัติระยะยาว: เซสชันเอเจนต์หลายชั่วโมง, งานที่ขั้นตอนหนึ่งที่ผิดพลาดทำให้เสียความคืบหน้าไปเป็นชั่วโมง, และปริมาณงานที่ให้ผลตอบแทนจากการปรับพารามิเตอร์ effort ที่แลกต้นทุนกับความสามารถ
- เลือก GPT-5.6 Sol สำหรับเอเจนต์เขียนโค้ดขนาดคลังที่ทำงานกับโค้ดเบสขนาดใหญ่ที่มีอยู่โดยมีการดูแลน้อยที่สุด และสำหรับทีมที่ต้องการระบบนิเวศของบุคคลที่สามที่ลึกที่สุดรอบๆ API
- เลือก Router หากคุณทำได้ รูปแบบที่ทีมงานฝ่ายผลิตส่วนใหญ่ใช้คือ: โมเดลเริ่มต้นราคาถูกจัดการปริมาณการใช้งานส่วนใหญ่ และ 10% ที่ยากที่สุดจะถูกส่งต่อไปยังโมเดลขั้นสุดยอด ตัวเลขการเปิดตัวของ Gemini 3.7 Flash ทำให้เป็นโมเดลเริ่มต้นที่น่าเชื่อถือในสถาปัตยกรรมดังกล่าว ซึ่งไม่เป็นจริงสำหรับ 3.6 Flash
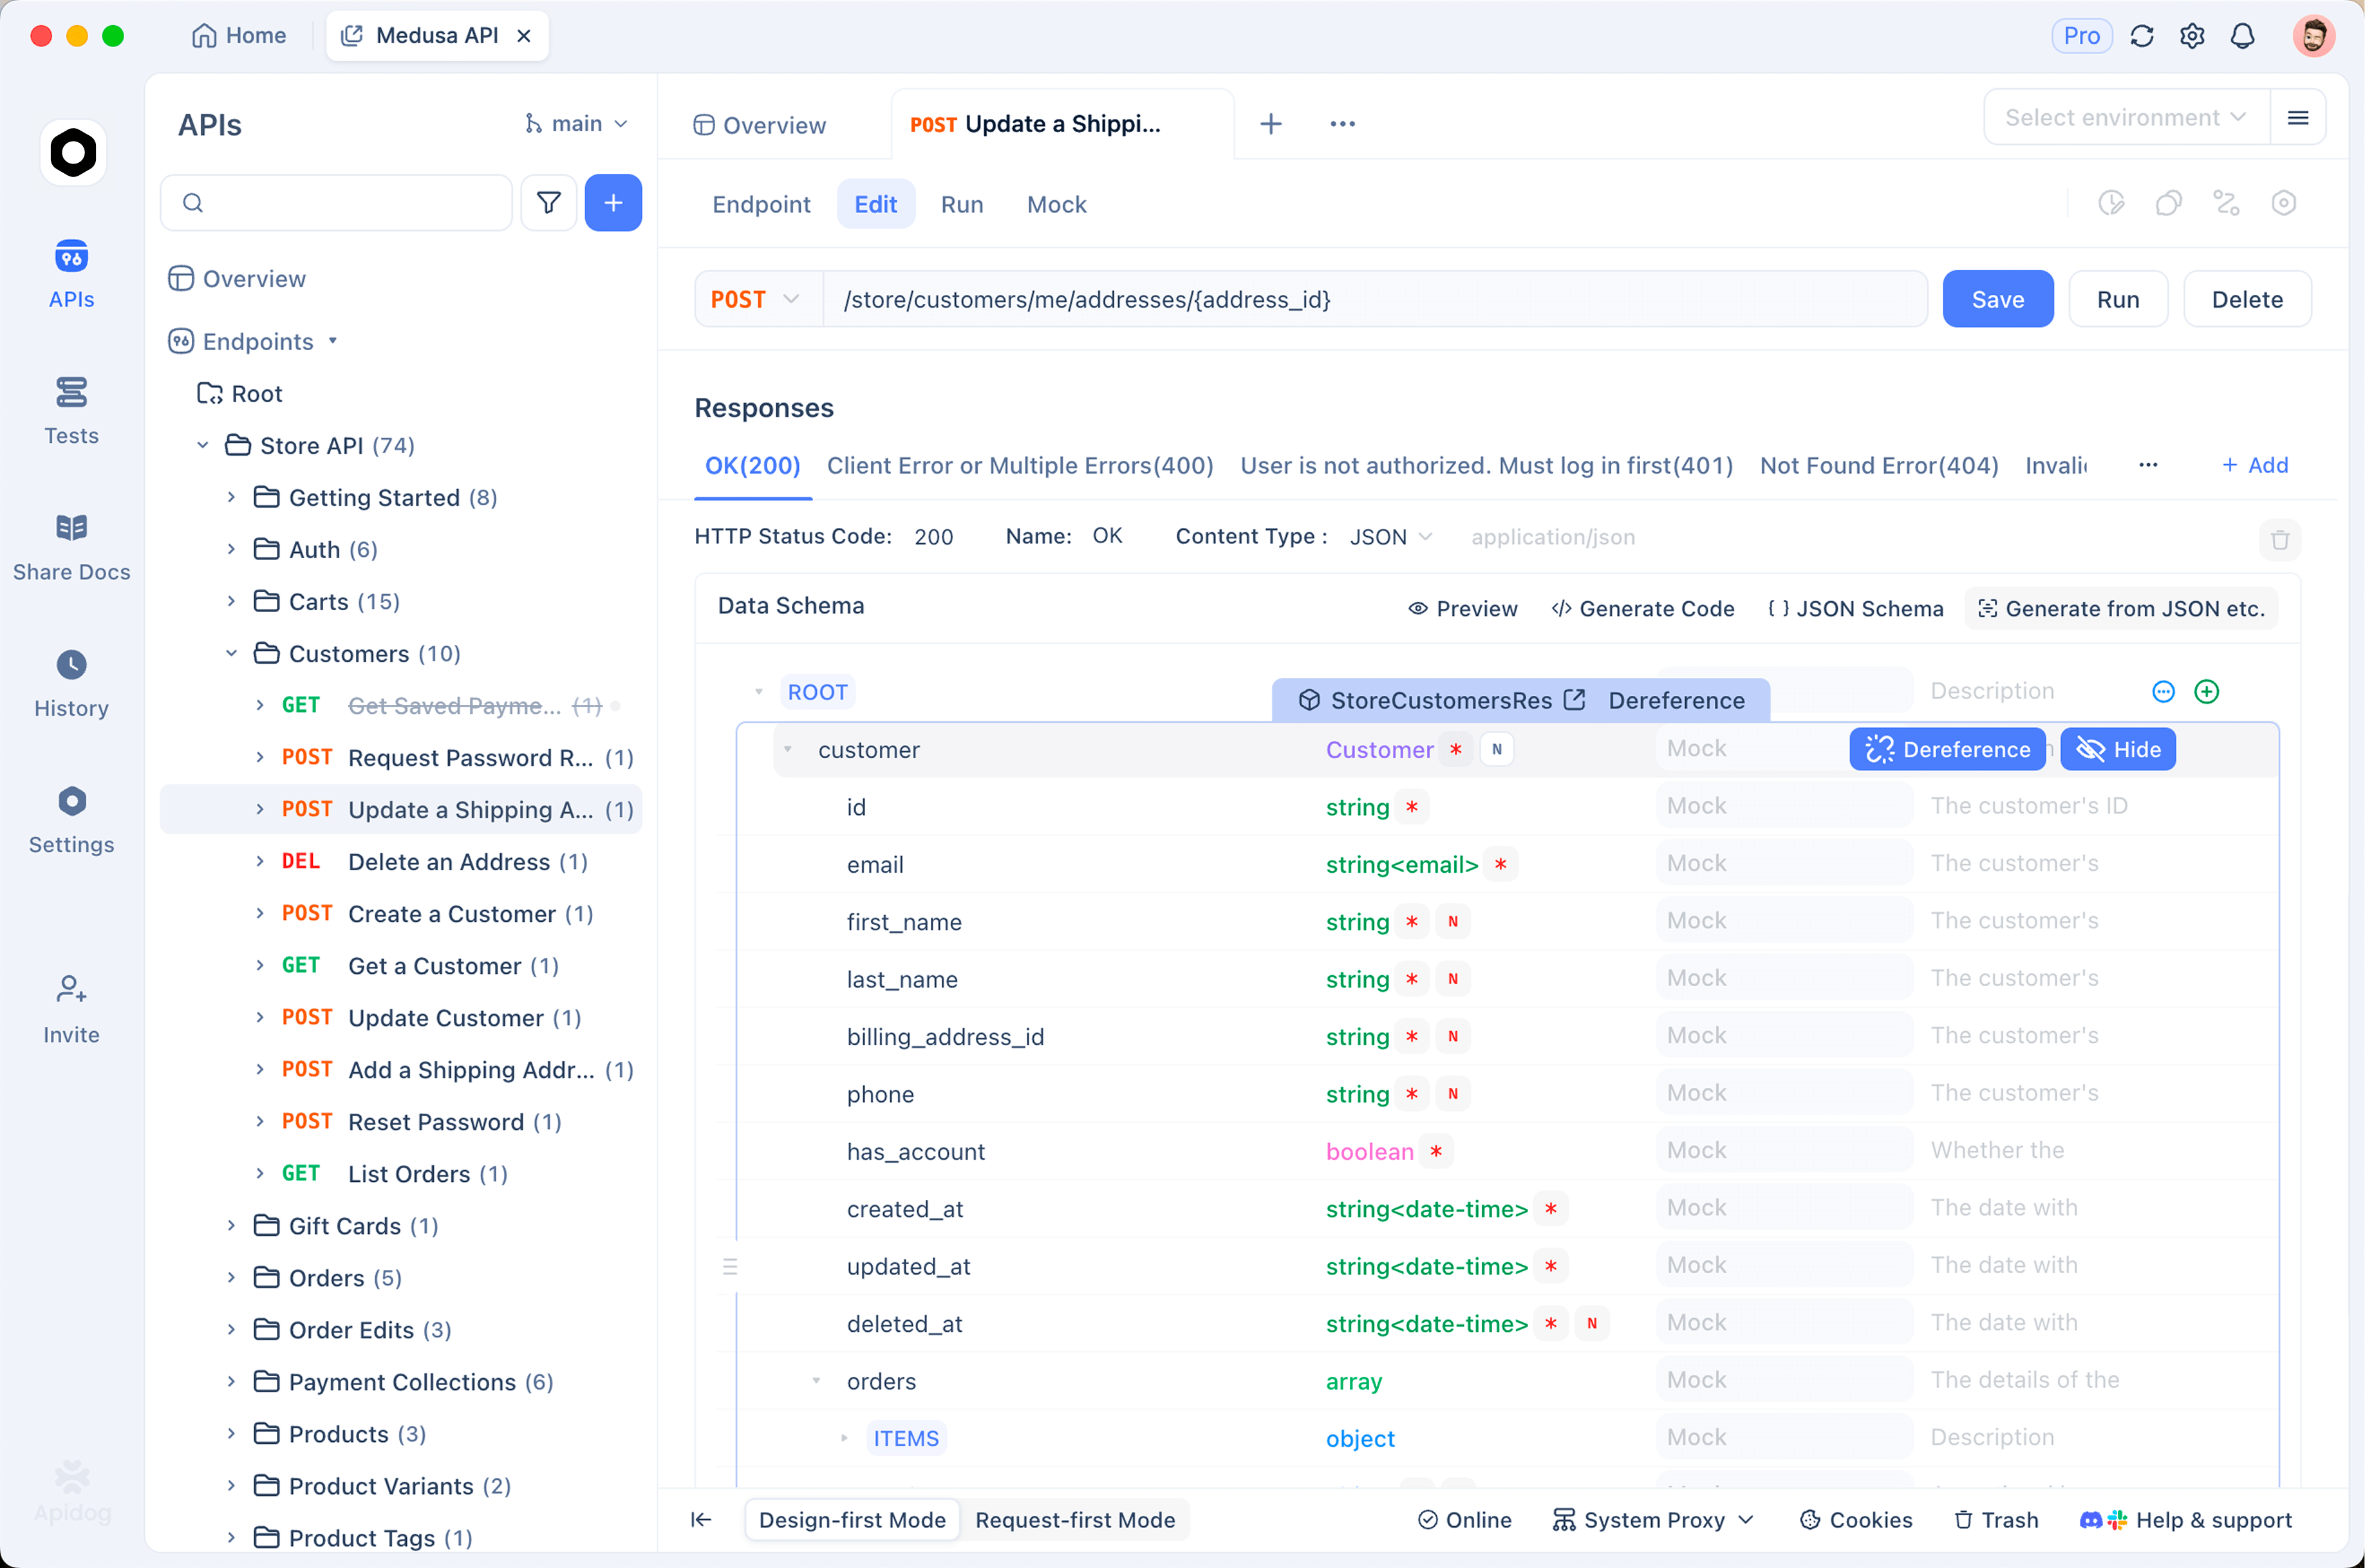
ทดสอบผู้ให้บริการทั้งสามใน Apidog workspace เดียว
การเปรียบเทียบที่สำคัญคือการเปรียบเทียบที่คุณรันด้วย prompts ของคุณเอง Apidog รวบรวมคอลเลกชันสำหรับ Google, Anthropic และ OpenAI ไว้ในโปรเจกต์เดียว ดังนั้นการทดสอบจึงใช้เวลาแค่ช่วงบ่ายแทนที่จะต้องวิ่งแข่งกัน:
- สร้างสามสภาพแวดล้อม, หนึ่งสภาพแวดล้อมต่อผู้ให้บริการ, แต่ละสภาพแวดล้อมมี base URL และ auth header ของตัวเอง:
x-goog-api-keyสำหรับ Gemini,x-api-keyสำหรับ Anthropic, โทเค็น Bearer สำหรับ OpenAI การเปลี่ยนผู้ให้บริการจะกลายเป็นการเลือกจากเมนูแบบดรอปดาวน์ ไม่ใช่การแก้ไขโค้ด - รวบรวม 20 prompts จริง จากผลิตภัณฑ์ของคุณ รวมถึง system prompt, คำจำกัดความเครื่องมือของคุณหากคุณใช้ function calling, และอย่างน้อยห้ากรณีที่ทราบว่ายาก
- เพิ่มการยืนยัน (assertions) สำหรับสิ่งที่คุณสนใจ: ความถูกต้องของการตอบกลับ, จำนวนโทเค็นจากบล็อกการใช้งานของผู้ให้บริการแต่ละราย, เกณฑ์ความล่าช้า สำหรับปริมาณงานที่เรียกใช้เครื่องมือ ให้ยืนยันว่า JSON ของการเรียกใช้เครื่องมือสามารถแยกวิเคราะห์ได้และตรงกับรูปแบบของคุณ; โมเดลมักจะล้มเหลวในจุดนี้มากกว่าในการสร้างข้อความ
- รันแต่ละชุดสามครั้งต่อโมเดล ผลลัพธ์ของ LLM มีความหลากหลาย; การรันสามครั้งจะแสดงความแปรผันที่การสาธิตครั้งเดียวซ่อนไว้ เปรียบเทียบอัตราความสำเร็จและต้นทุนต่อภารกิจที่สำเร็จ
- เก็บชุดทดสอบไว้ การเปิดตัวโมเดลตอนนี้ห่างกันเพียงไม่กี่สัปดาห์; 3.7 Flash ตาม 3.6 มาสามสัปดาห์ ทีมที่มีชุดทดสอบมาตรฐานสามารถตัดสินใจใหม่ได้ภายในบ่ายวันเดียวแทนที่จะต้องคาดเดา
- ไม่ใช่ในระดับสูงสุด GPT-5.6 Sol Max ทำคะแนนได้ 73.0% บน DeepSWE v1.1 เทียบกับ 65.3% ของ 3.7 Flash และ Claude Fable 5 เป็นผู้นำด้านความสอดคล้องในการวัดประสิทธิภาพการเขียนโค้ดและเอเจนต์ สิ่งที่เปลี่ยนไปคืออัตราส่วนราคาต่อคะแนน: 3.7 Flash ทำคะแนนได้ในระดับที่เคยอยู่ในขอบเขตของโมเดลขั้นสุดยอดเมื่อหลายสัปดาห์ก่อน โดยคิดค่าบริการในอัตราของโมเดลทำงานหนัก
- จนถึงวันที่ 31 ธันวาคม 2026, Gemini 3.7 Flash มีค่าใช้จ่าย 0.75 ดอลลาร์ต่อ 1M โทเค็นอินพุต และ 3.75 ดอลลาร์ต่อ 1M โทเค็นเอาต์พุต โมเดลระดับสูงสุดของ Claude และ GPT คิดค่าบริการต่อโทเค็นแพงกว่าหลายเท่า; ตรวจสอบหน้าเพจราคาปัจจุบันก่อนที่คุณจะประมาณการค่าใช้จ่าย โปรดจำไว้ว่าอัตราโปรโมชันจะเพิ่มเป็นสองเท่าในวันที่ 1 มกราคม 2027
- Google มี endpoint ที่เข้ากันได้กับ OpenAI ซึ่งรองรับรูปแบบแชทพื้นฐาน ดังนั้นการเปลี่ยน
base_urlจะใช้งานได้สำหรับข้อความอินพุต-เอาต์พุต ส่วนประกอบหลายรูปแบบและการเรียกใช้เครื่องมือไม่สามารถจับคู่กันได้อย่างสมบูรณ์ ดังนั้นให้ใช้รูปแบบcontentsดั้งเดิมสำหรับสิ่งอื่นนอกเหนือจากการแชทแบบธรรมดา คู่มือการเรียกใช้ฟังก์ชันสำหรับ Gemini 3.7 Flash แสดงรูปแบบเครื่องมือดั้งเดิมอย่างครบถ้วน - ใช่ มีการเรียกใช้ฟังก์ชัน, การค้นหาเป็นเครื่องมือ และการใช้งานคอมพิวเตอร์ รวมถึงการอัปเดตเกราะป้องกันความปลอดภัยด้าน CBRN และไซเบอร์ การปรับปรุง AutomationBench จาก 17.0% เป็น 30.4% เป็นตัวบ่งชี้ที่ใกล้เคียงที่สุดที่เผยแพร่ว่า agentic loop ดีขึ้นเพียงใด
- Gemini API พร้อมคีย์ AI Studio, Google AI Studio, แอป Gemini, Gemini Spark สำหรับสมาชิก AI Pro และ Ultra, Google Antigravity, Android Studio, และ Gemini Enterprise ในกว่า 160 ประเทศ ทีมงาน GCP ฝ่ายผลิตสามารถเรียกใช้ผ่าน Vertex AI ด้วย OAuth แทนที่จะใช้ API key
- สิ่งที่เข้าใจผิดจากการเปรียบเทียบนี้คือ “Gemini ตามทันโมเดลขั้นสุดยอดแล้ว” ยังไม่ใช่; Sol ยังคงมีความลึกในการเขียนโค้ดระดับคลัง และ Fable 5 ยังคงมีความน่าเชื่อถือในระยะยาว สิ่งที่เข้าใจถูกต้องคือจุดต่ำสุดได้ขยับขึ้น: ราคาโมเดลทำงานหนักตอนนี้สามารถซื้อคะแนนที่เคยเป็นระดับพรีเมียมเมื่อไตรมาสที่แล้ว ซึ่งเป็นการรีเซ็ตค่าเริ่มต้นในสถาปัตยกรรมเราเตอร์ใดๆ โมเดลระดับ Flash จัดการปริมาณงานส่วนใหญ่ ส่วนโมเดลเรือธงจัดการกรณีที่ยกระดับขึ้น
- การตัดสินใจสามารถวัดผลได้ ดังนั้นจงวัดผลมัน เชื่อมต่อผู้ให้บริการทั้งสามเข้ากับ workspace เดียว, รัน prompts จริงของคุณด้วยการยืนยัน, และให้ต้นทุนต่อภารกิจที่สำเร็จเป็นตัวเลือกผู้ชนะ ดาวน์โหลด Apidog ฟรี, ตั้งค่าสภาพแวดล้อมทั้งสาม, แล้วคุณจะมีหลักฐานในระดับผู้ให้บริการก่อนที่หน้าต่างราคาโปรโมชันจะปิดลง