
Firecrawl แบบ self-hosted แต่เดิมหมายถึงเพียงอย่างเดียว คือโคลนรีโป รัน Docker Compose และดูแล API, บริการ Playwright, Redis, RabbitMQ และ Postgres ให้ทำงานอยู่บนเครื่องของคุณ แต่วันที่ 18 พฤศจิกายน 2026 Firecrawl ได้เปิดตัวอีกทางเลือกหนึ่ง Firecrawl Local เป็นไบนารี Rust ตัวเดียวที่ scrape, crawl และ map เว็บไซต์เป็น markdown และตอบ API v2 เดียวกันบน localhost:3002 โดยไม่ต้องมีฐานข้อมูล คิว หรือคอนเทนเนอร์
คำตอบสั้นๆ: เลือก Firecrawl Local หากคุณต้องการ scrape, crawl, map และ batch scrape บนแล็ปท็อปหรือในชุดเครื่องมือของ agent โดยไม่มีโครงสร้างพื้นฐานใดๆ เลย ให้เก็บสแตก Docker แบบ self-hosted ไว้หากคุณต้องการงานที่คงอยู่ถาวร รูปแบบ json และ summary การสกัดด้วย LLM ผ่านโมเดลของคุณเอง หรือเส้นทาง search ที่ไม่แตะ Firecrawl Cloud เลย
Firecrawl self-hosted คืออะไร และ Firecrawl Local คืออะไร?
Firecrawl self-hosted คือเซิร์ฟเวอร์ Firecrawl แบบเต็มจาก apps/api ที่รันบนโครงสร้างพื้นฐานของคุณเองด้วย Docker Compose ส่วน Firecrawl Local เป็นบิลด์ที่แยกออกมาและเบากว่าใน apps/local โดยเป็นไบนารีตัวเดียวที่ดึงและทำความสะอาดหน้าเว็บบนเครื่องของคุณโดยใช้โค้ดทำความสะอาด HTML ตัวเดียวกัน และส่งต่อ search, หน้าที่ถูกบล็อก และ Alexandria ให้ Firecrawl Cloud จัดการ
ทั้งสองอย่างอยู่ใน รีโป GitHub ของ Firecrawl ทั้งสองให้บริการ API v2 บนพอร์ต 3002 และทั้งสองเป็นโอเพนซอร์สภายใต้ AGPL-3.0 Firecrawl Local ไม่ได้แทนที่เซิร์ฟเวอร์ README ของ Firecrawl Local ระบุไว้ตรงๆ ว่า คู่มือ self-hosting "อยู่ใน apps/api และไม่ถูกเปลี่ยนแปลงโดย Firecrawl Local"
เพิ่งเริ่มใช้ Firecrawl? เริ่มต้นด้วยคู่มือ web scraping ของ Firecrawlของเรา
เปรียบเทียบ Firecrawl Local กับ Firecrawl self-hosted แบบรวดเร็ว
นี่คือเวอร์ชันสั้น สร้างจากคู่มือ self-hosting, หน้าเปรียบเทียบ open source กับ cloud และ README ของ Local ทั้งหมดอ่านเมื่อวันที่ 19 พฤศจิกายน 2026
| Firecrawl self-hosted | Firecrawl Local | |
|---|---|---|
| สิ่งที่คุณรัน | สแตก Docker Compose: api, playwright-service, redis, rabbitmq, nuq-postgres | ไบนารีตัวเดียว, firecrawl-local |
| การติดตั้ง | git clone, เขียน .env, docker compose up --build -d |
cargo install firecrawl-local |
| ข้อกำหนดเบื้องต้น | Git, Docker Engine, Compose v2 | Rust และคอมไพเลอร์ C; Chrome และ Node 22+ เป็นออปชัน |
| API | v2 บนพอร์ต 3002 | v2 บนพอร์ต 3002 (scrape, map, crawl, batch scrape, health) |
| เส้นทาง search | รวมอยู่ในสแตกเริ่มต้น | ส่งต่อไปยัง Firecrawl Cloud |
รูปแบบ LLM (json, summary) |
เชื่อมต่อผู้ให้บริการที่รองรับ OpenAI หรือ Ollama | ถูกข้ามพร้อมคำเตือน |
| สกรีนช็อต | ต้องใช้ Fire-engine ซึ่งไม่อยู่ในสแตกเริ่มต้น | ใช้งานได้หากติดตั้ง Chrome |
actions ของเบราว์เซอร์ |
ต้องใช้ Fire-engine | ถูกละเว้น |
| การจัดเก็บงาน | คิวที่ใช้ Postgres | ในหน่วยความจำ หมดอายุหลัง 1 ชั่วโมง |
| Alexandria | ไม่ระบุในตารางฟีเจอร์ self-host | ผ่าน Firecrawl Cloud ด้วยบัญชีฟรี |
| การตั้งค่า MCP | ชี้ MCP server ไปยัง URL ของคุณ | firecrawl-local init เขียนไฟล์คอนฟิกให้ |
| สัญญาอนุญาต | AGPL-3.0 | AGPL-3.0 |
Local แลกความลึกกับความเบา: มันเก็บเส้นทางที่ agent เรียกใช้บ่อยที่สุดและตัดสิ่งต่างๆ ที่ต้องใช้คิว โมเดล หรือฟาร์มเบราว์เซอร์ออก
สิ่งที่เปลี่ยนแปลง: จากห้าบริการเหลือไบนารีเดียว
เส้นทาง self-hosted ระบุรีลีส v2.11.162 ไว้ในคู่มือ คุณโคลนรีโป เขียนไฟล์ .env เล็กๆ ที่มีข้อมูลรับรอง Postgres และ USE_DB_AUTHENTICATION=false จากนั้นบิลด์และเริ่มสแตก:
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
docker compose up --build -d
docker compose ps --all
ไฟล์ compose นั้นจะเริ่มคอนเทนเนอร์ api (ซึ่งรัน worker ด้วย) playwright-service สำหรับการเรนเดอร์ redis, rabbitmq และ nuq-postgres สำหรับคิวงาน ไฟล์ compose จำกัด API ไว้ที่ 4 CPU และหน่วยความจำ 8 GB และ Playwright service ที่ 2 CPU และ 4 GB และคู่มือระบุว่าขีดจำกัดเหล่านั้น "ไม่ใช่ข้อกำหนดขั้นต่ำที่ผ่านการตรวจสอบแล้ว"
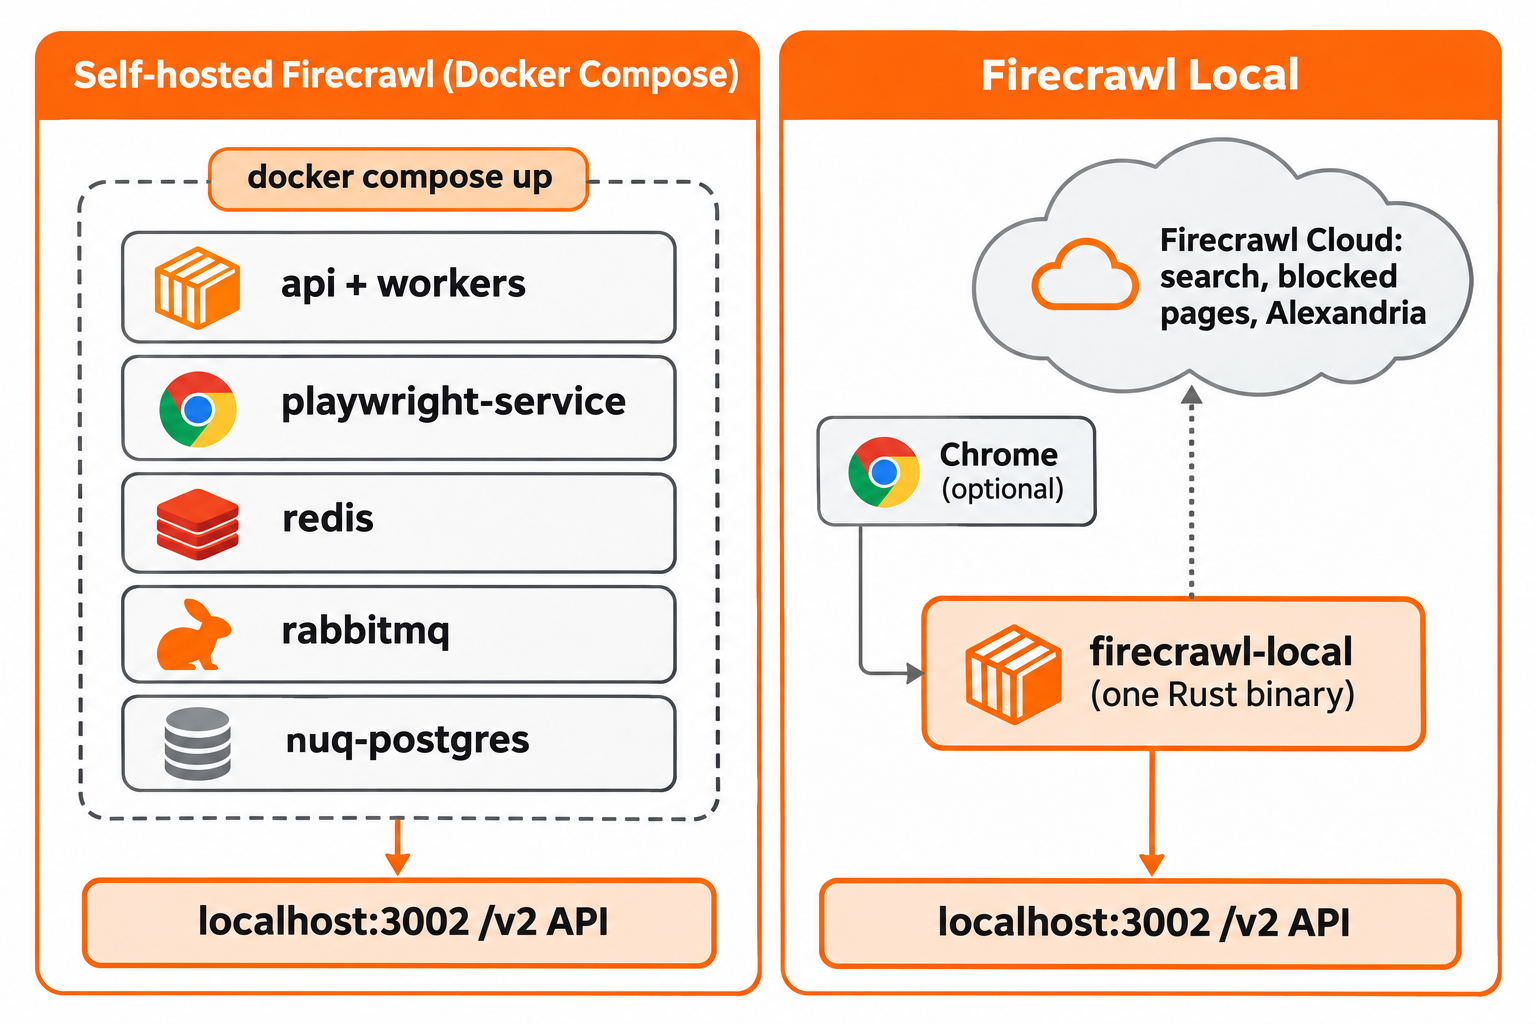
Firecrawl Local ยุบทั้งหมดนั้นเหลือเพียงคำสั่งเดียว:
cargo install firecrawl-local
firecrawl-local scrape https://example.com --markdown
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages
firecrawl-local map https://firecrawl.dev
firecrawl-local serve
ไม่มี .env และไม่มีคอนเทนเนอร์ หน้า JavaScript เรนเดอร์ใน Chrome หรือ Chromium ที่คุณมีอยู่แล้ว หากไม่มี หน้า static ยังคงใช้งานได้ และส่วนที่เหลือจะส่งคืนคำเตือน
คำสั่ง search, find-tools, data และ login เชื่อมต่อไปยัง Firecrawl Cloud firecrawl-local login ใช้ข้อมูลรับรองของ CLI แบบโฮสต์จากคู่มือติดตั้ง Firecrawl CLIของเราใหม่
ความครอบคลุมของ endpoint: แต่ละตัวให้บริการอะไร
นี่คือจุดที่การย้ายระบบมักพัง ดังนั้นตรวจสอบก่อนเปลี่ยน base URL ของ SDK
Firecrawl Local ให้บริการเส้นทางเหล่านี้บนเครื่องของคุณ:
POST /v2/scrapeทำการ scrape URL หนึ่งรายการPOST /v2/mapแสดงรายการ URL ของเว็บไซต์POST /v2/crawlพร้อมด้วยGETและDELETE /v2/crawl/{id}POST /v2/batch/scrapeพร้อมด้วยGETและDELETE /v2/batch/scrape/{id}GET /health
เส้นทาง /v2 อื่นๆ ทั้งหมด เช่น /v2/search จะถูกส่งต่อไปยัง Firecrawl Cloud เว้นแต่ FIRECRAWL_CLOUD จะกำหนดไว้เป็นอย่างอื่น เส้นทาง v0 และ v1 ไม่ได้ให้บริการเลย
Firecrawl self-hosted ครอบคลุม scrape, crawl, map และ search พื้นฐานในสแตกเริ่มต้น ตามหน้าเปรียบเทียบ open source กับ cloud การสกัดด้วย LLM ต้องมีผู้ให้บริการที่คุณเชื่อมต่อเอง Agent, Browser, Interact และแดชบอร์ดไม่ได้รวมอยู่ด้วย
ข้อควรระวังในทางปฏิบัติสองประการ:
- การตรวจสอบสุขภาพแตกต่างกัน คู่มือ self-hosting ตรวจสอบความพร้อมที่
/v0/health/readinessFirecrawl Local ไม่ได้ให้บริการ v0 ดังนั้นให้ใช้GET /healthแทน อัปเดต monitor และ compose healthcheck ของคุณ - Search เปลี่ยนสถานที่ทำงาน บนสแตก Docker search ยังคงอยู่บนโครงสร้างพื้นฐานของคุณ บน Local มันจะไปยัง Firecrawl Cloud และ search แบบไม่ใช้คีย์มีข้อจำกัดอัตรา ตั้งค่า
FIRECRAWL_CLOUD=offหากไม่มีข้อมูลใดออกจากเครื่องได้ จากนั้น search จะหยุดทำงาน
ความเร็วและหน่วยความจำ: อ่านคำกล่าวอ้างอย่างระมัดระวัง
โพสต์เปิดตัวของ Firecrawl บน X ระบุว่า Firecrawl Local เป็น "พื้นฐานการ scrape ที่ใช้ Rust เร็วกว่า 37 เท่า (เทียบกับ self-hosted)" และใช้ "หน่วยความจำน้อยกว่า 230 เท่า (11 MB ตอน idle)" โพสต์ดังกล่าวมียอดดูประมาณ 324K และไลก์ 3.2K ในวันแรก
ให้ถือว่าตัวเลขเหล่านั้นเป็นคำกล่าวอ้างของ Firecrawl README ไม่ได้เผยแพร่วิธีการ benchmark ชุดหน้าเว็บ หรือฮาร์ดแวร์ ดังนั้นเราไม่สามารถบอกได้ว่า "37 เท่า" นั้นวัดอะไร สิ่งที่สถาปัตยกรรมสนับสนุนคือทิศทาง: กระบวนการ idle หนึ่งตัวควรเบากว่าห้าคอนเทนเนอร์ที่ขีดจำกัดของ compose ยอมให้ใช้ได้ถึง 12 GB เฉพาะระหว่างบริการ API และ Playwright มาก
หากความเร็วเป็นตัวตัดสินใจ ให้วัดบน URL ของคุณเอง รัน scrape เดียวกันกับทั้งสองเซิร์ฟเวอร์ เปรียบเทียบเวลา และตรวจสอบว่า markdown ตรงกัน ส่วน Apidog CLI ด้านล่างแสดงวิธีหนึ่งในการทำให้การทดสอบนี้ทำซ้ำได้
ความปลอดภัย การส่งต่อไปยังคลาวด์ และการไหลของข้อมูล
Self-hosting ให้การควบคุมเต็มรูปแบบและความรับผิดชอบเต็มรูปแบบ quickstart ของคู่มือปิดการรับรองความถูกต้องและเตือนว่า "ไม่ใช่สถาปัตยกรรมสำหรับโปรดักชัน" ดังนั้นโวลุ่มถาวร การรับรองความถูกต้อง TLS และการตรวจสอบเป็นสิ่งที่คุณต้องเพิ่มเอง
Firecrawl Local มาพร้อมค่าเริ่มต้นที่เข้มงวดกว่าสำหรับเครื่องเดี่ยว:
serveผูกกับ127.0.0.1และปฏิเสธ localhost และที่อยู่แบบ private เว้นแต่คุณจะส่ง--allow-private- ที่อยู่ link-local และ cloud metadata ถูกบล็อกในทุกโหมด รวมถึงหลังการเปลี่ยนเส้นทาง
scrape,crawlและmcpรองรับ--public-onlyซึ่ง README แนะนำเมื่อ agent ท่องเว็บไซต์ที่คุณไม่เชื่อถือ- การ crawl เคารพ
robots.txt
สิ่งที่ต้องแลกคือการส่งต่อไปยังคลาวด์ ด้วยค่าเริ่มต้น FIRECRAWL_CLOUD=auto search, หน้าที่บล็อกเครื่องของคุณ และ Alexandria จะไปยัง Firecrawl Cloud ผลลัพธ์เหล่านั้นมี "source": "firecrawl-cloud" ติดมาด้วย ตั้งค่า FIRECRAWL_CLOUD=search เพื่ออนุญาตเฉพาะ search หรือ off เพื่อไม่ส่งอะไรเลย
Alexandria ซึ่งเป็นแคตตาล็อกผู้ให้บริการข้อมูลของ Firecrawl ต้องใช้บัญชีฟรีและ firecrawl-local login บทอธิบาย Firecrawl Alexandriaของเราครอบคลุมสิ่งที่มันส่งคืน
คุณควรเลือกอันไหน?
เลือก Firecrawl Local หาก:
- คุณต้องการให้ AI agent ทำ scrape และ crawl บนแล็ปท็อปของคุณ
firecrawl-local initเพิ่ม MCP server ให้กับ Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI และ Codex โดยสำรองคอนฟิกแต่ละรายการก่อน - คุณรันงานสั้นๆ ที่เสร็จภายในหนึ่งชั่วโมง
- คุณต้องการเพียง markdown, HTML, raw HTML และลิงก์
- คุณไม่อยากดูแล Postgres, Redis และ RabbitMQ เอง
ใช้ Firecrawl self-hosted ต่อหาก:
- งาน crawl ต้องอยู่รอดหลังรีสตาร์ทหรือรันนานกว่าหนึ่งชั่วโมง
- คุณต้องการเอาต์พุต
jsonหรือsummaryผ่านโมเดลของคุณเอง - Search ต้องอยู่บนโครงสร้างพื้นฐานของคุณ
- หลายบริการหรือผู้ใช้ใช้แบ็กเอนด์ scraping ตัวเดียวร่วมกันภายใต้การรับรองความถูกต้องของคุณ
หลายทีมจะรันทั้งสองอย่าง: Local บนแล็ปท็อปและใน agent ส่วนสแตก Docker หรือ Firecrawl Cloud ในโปรดักชัน สำหรับการตั้งค่า agent ที่ต้องการเพียง search บทความรวบรวมopen-source web search สำหรับ Claudeของเรามีตัวเลือกอื่นๆ และคู่มือ Firecrawl MCP และ llms.txtครอบคลุม MCP server แบบโฮสต์
การย้ายโค้ด SDK จาก self-hosted ไปยัง Local
โค้ด SDK ของคุณไม่เปลี่ยนแปลง มีเพียง URL เท่านั้น: ตั้งค่า API URL ของ Python หรือ Node SDK เป็น http://localhost:3002 โดยไม่ต้องมี API key สำหรับเส้นทาง local ก่อนจะสลับ ให้ยืนยันว่าโค้ดของคุณไม่เรียก v0 หรือ v1 ไม่เคยขอ json, summary หรือ actions และไม่เคย poll crawl ID ที่เก่ากว่าหนึ่งชั่วโมงหรือข้ามการรีสตาร์ท serve
ให้ coding agent ของคุณรันการทดสอบความเท่าเทียมด้วย Apidog CLI
การสลับแบ็กเอนด์เป็นคำถามเรื่องสัญญา: /v2/scrape บน Local ส่งคืนรูปแบบเดียวกับที่โค้ดของคุณแยกวิเคราะห์อยู่แล้วหรือไม่ อย่า diff response ด้วยมือ รันทั้งสองเซิร์ฟเวอร์เคียงกัน (Docker บน 3002, firecrawl-local serve --port 3012) และให้ coding agent ของคุณทดสอบทั้งสองด้วย Apidog CLI
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
จากนั้นให้พรอมต์หนึ่งครั้งกับ agent:
Self-hosted Firecrawl runs on http://localhost:3002 and Firecrawl Local on
http://localhost:3012. In Apidog project <id>, create two environments,
"self-hosted" and "local". Add test cases for POST /v2/scrape on
https://example.com (assert 200, success: true, non-empty data.markdown) and
POST /v2/map (assert 200 and a non-empty links array). Run the cases against
both environments and tell me every assertion that differs.
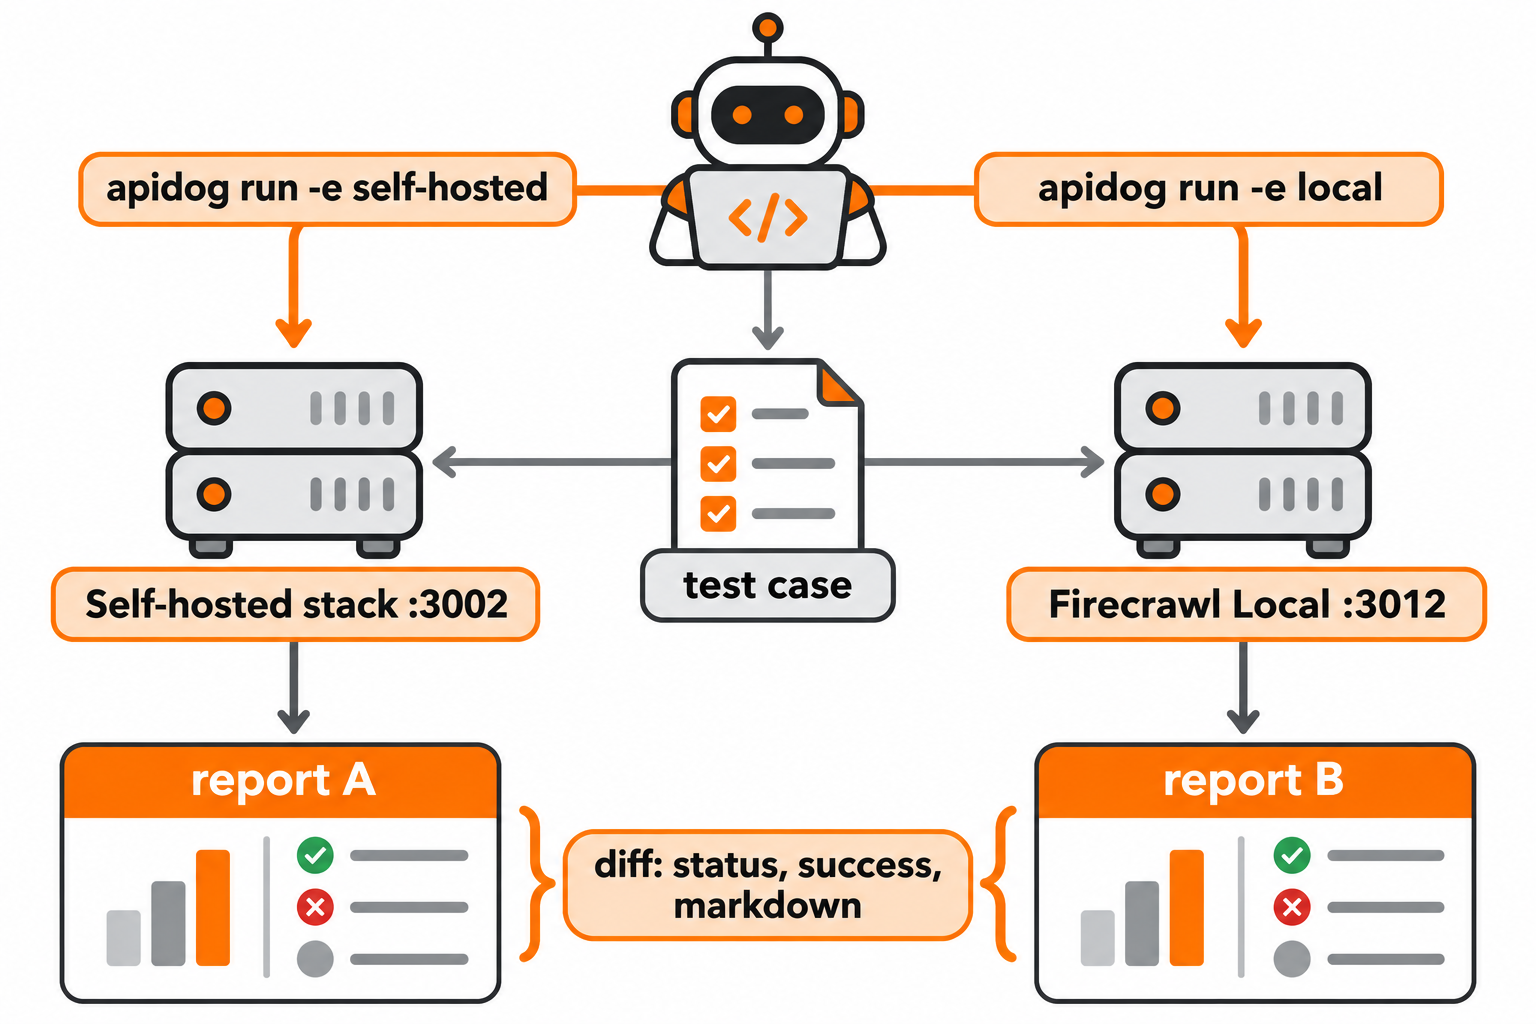
agent อ่าน schema ของ payload ตรวจสอบความถูกต้อง และรันเคสเดียวกันสองครั้ง:
firecrawl-local serve --port 3012 &
apidog environment create self-hosted --project <id> --base-url http://localhost:3002
apidog environment create local --project <id> --base-url http://localhost:3012
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file scrape-case.json
apidog test-case create --project <id> --file scrape-case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json --out-file self-hosted
apidog run --test-case <caseId> --project <id> -e <localEnvId> -r cli,json --out-file local
Apidog CLI ส่งคำขอจากเครื่องของคุณ ดังนั้นพอร์ต localhost ทั้งสองจึงเข้าถึงได้ สลับ -r cli,json เป็น -r junit แล้วการตรวจสอบเดียวกันจะรันใน CI ทุกครั้งที่อัปเกรด Firecrawl คู่มือ Apidog CLI CI/CDของเราแสดงการตั้งค่า และApidog CLI ใน Claude Codeครอบคลุมฝั่ง agent แผน Free ของ Apidog รองรับทีมสูงสุด 4 ผู้ใช้
คำถามที่พบบ่อย
Firecrawl Local แทนที่ Firecrawl self-hosted หรือไม่? ไม่ใช่ มันเป็นบิลด์แยกใน apps/local เซิร์ฟเวอร์แบบเต็มใน apps/api และคู่มือ self-hosting ยังไม่เปลี่ยนแปลง และคุณยังต้องใช้มันสำหรับงานที่คงอยู่ถาวรและรูปแบบ LLM
Firecrawl Local เร็วกว่า Firecrawl self-hosted 37 เท่าจริงหรือไม่? นั่นเป็นคำกล่าวอ้างของ Firecrawl จากโพสต์เปิดตัว พร้อมกับหน่วยความจำน้อยกว่า 230 เท่าและ 11 MB ตอน idle README ไม่ได้เผยแพร่วิธีการ benchmark ดังนั้นให้ทดสอบบน URL ของคุณเอง
Firecrawl Local ทำงานได้โดยไม่ต้องใช้คลาวด์หรือไม่? ได้ ตั้งค่า FIRECRAWL_CLOUD=off แล้วการ scrape, crawl และ map จะอยู่บนเครื่องของคุณ Search, ตัวสำรองสำหรับหน้าที่ถูกบล็อก และ Alexandria จะหยุดทำงาน
Firecrawl self-hosted ฟรีหรือไม่? โค้ดนั้นฟรีภายใต้ AGPL-3.0 ทั้งสำหรับเซิร์ฟเวอร์และ Local คุณจ่ายค่าเครื่องและเวลาที่ใช้ในการรัน Postgres, Redis และ RabbitMQ เอง
AI agent ควรใช้อันไหน? Firecrawl Local ในกรณีส่วนใหญ่ firecrawl-local init ลงทะเบียนเป็น MCP server ในเครื่องมือ agent หกตัว และ --public-only ป้องกัน agent เข้าถึงเครือข่ายส่วนตัวของคุณ