ERNIE 5.5 Flash กับ DeepSeek V4.1 Flash และ GPT-6 Luna แตกต่างกันที่ "ข้อแลกเปลี่ยน" สามแบบ ERNIE 5.5 Flash Preview ใช้ได้ฟรีบน OpenRouter ในวันนี้ DeepSeek V4.1 Flash ให้น้ำหนักโมเดลแบบ open MIT พร้อมราคา $0.30/$1.20 ต่อ 1M tokens ช่วง peak และครึ่งหนึ่งในช่วง off-peak ส่วน GPT-6 Luna มีราคาหน้าเว็บที่ถูกที่สุด: $0.10 ฝั่ง input และ $0.50 ฝั่ง output
ทั้งสามตัวรองรับ context ราว 1M tokens และเรียกใช้ tools ได้ แต่ต่างกันที่โครงสร้างราคา น้ำหนักโมเดล และความพร้อมใช้งาน ราคาทั้งหมดด้านล่างอ้างอิงจากหน้าเว็บทางการ ณ วันที่ 12 พฤศจิกายน 2026 และหัวข้อสุดท้ายจะแสดงการให้ coding agent ของคุณทดสอบทั้งสามตัวด้วย prompt เดียว
สรุปภาพรวม ERNIE 5.5 Flash vs DeepSeek V4.1 Flash vs GPT-6 Luna
| ERNIE 5.5 Flash Preview | DeepSeek V4.1 Flash | GPT-6 Luna | |
|---|---|---|---|
| API model ID | baidu/ernie-5.5-flash-preview:free (OpenRouter) |
deepseek-flash |
gpt-6-luna |
| ค่า input ต่อ 1M | ฟรีบน OpenRouter; ราคาแบบเสียเงิน [VERIFY] | $0.30 ช่วง peak, $0.15 ช่วง off-peak | $0.10 |
| ค่า cached input ต่อ 1M | n/a สำหรับ endpoint ฟรี | $0.006 ช่วง peak, $0.003 ช่วง off-peak | $0.01 |
| ค่า output ต่อ 1M | ฟรีบน OpenRouter; ราคาแบบเสียเงิน [VERIFY] | $1.20 ช่วง peak, $0.60 ช่วง off-peak | $0.50 |
| Context window | 1,024,000 tokens | 1M tokens | 1,050,000 tokens |
| Max output | 1,024,000 (ตามข้อมูลบน OpenRouter) | 384K | 128,000 |
| จำนวนพารามิเตอร์ | 280B รวม, 14B active (MoE) | 552B backbone, 8B active ช่วง prefill / 16B ช่วง decode | ไม่เปิดเผย |
| ประเภท input | ข้อความ | ข้อความ, รูปภาพ | ข้อความ, รูปภาพ |
| Open weights | Base model มี; Preview "เร็วๆ นี้" ภายใต้ Apache 2.0 | มี, MIT | ไม่มี |
| สถานะ | Checkpoint ช่วง preview | Production (เวอร์ชัน 1017) | Production |
แหล่งอ้างอิง: โพสต์เปิดตัวของ Baidu, OpenRouter, ราคา DeepSeek และ หน้า Luna ของ OpenAI
แต่ละโมเดลราคาประหยัดคืออะไร
ERNIE 5.5 Flash Preview เป็นโมเดล post-trained ตัวแรกของ Baidu ที่สร้างบน ERNIE 5.5 Flash Base ซึ่งเปิดตัวบน Hugging Face ต้นเดือนพฤศจิกายน เป็นโมเดล sparse mixture-of-experts ขนาด 280B พร้อมพารามิเตอร์ active 14B และ context 1M tokens Baidu เรียกมันว่า intermediate checkpoint เพราะ post-training ยังไม่เสร็จสมบูรณ์ อ่านเพิ่มเติม: ERNIE 5.5 Flash คืออะไร และ ERNIE 5.1 ตัวก่อนหน้า
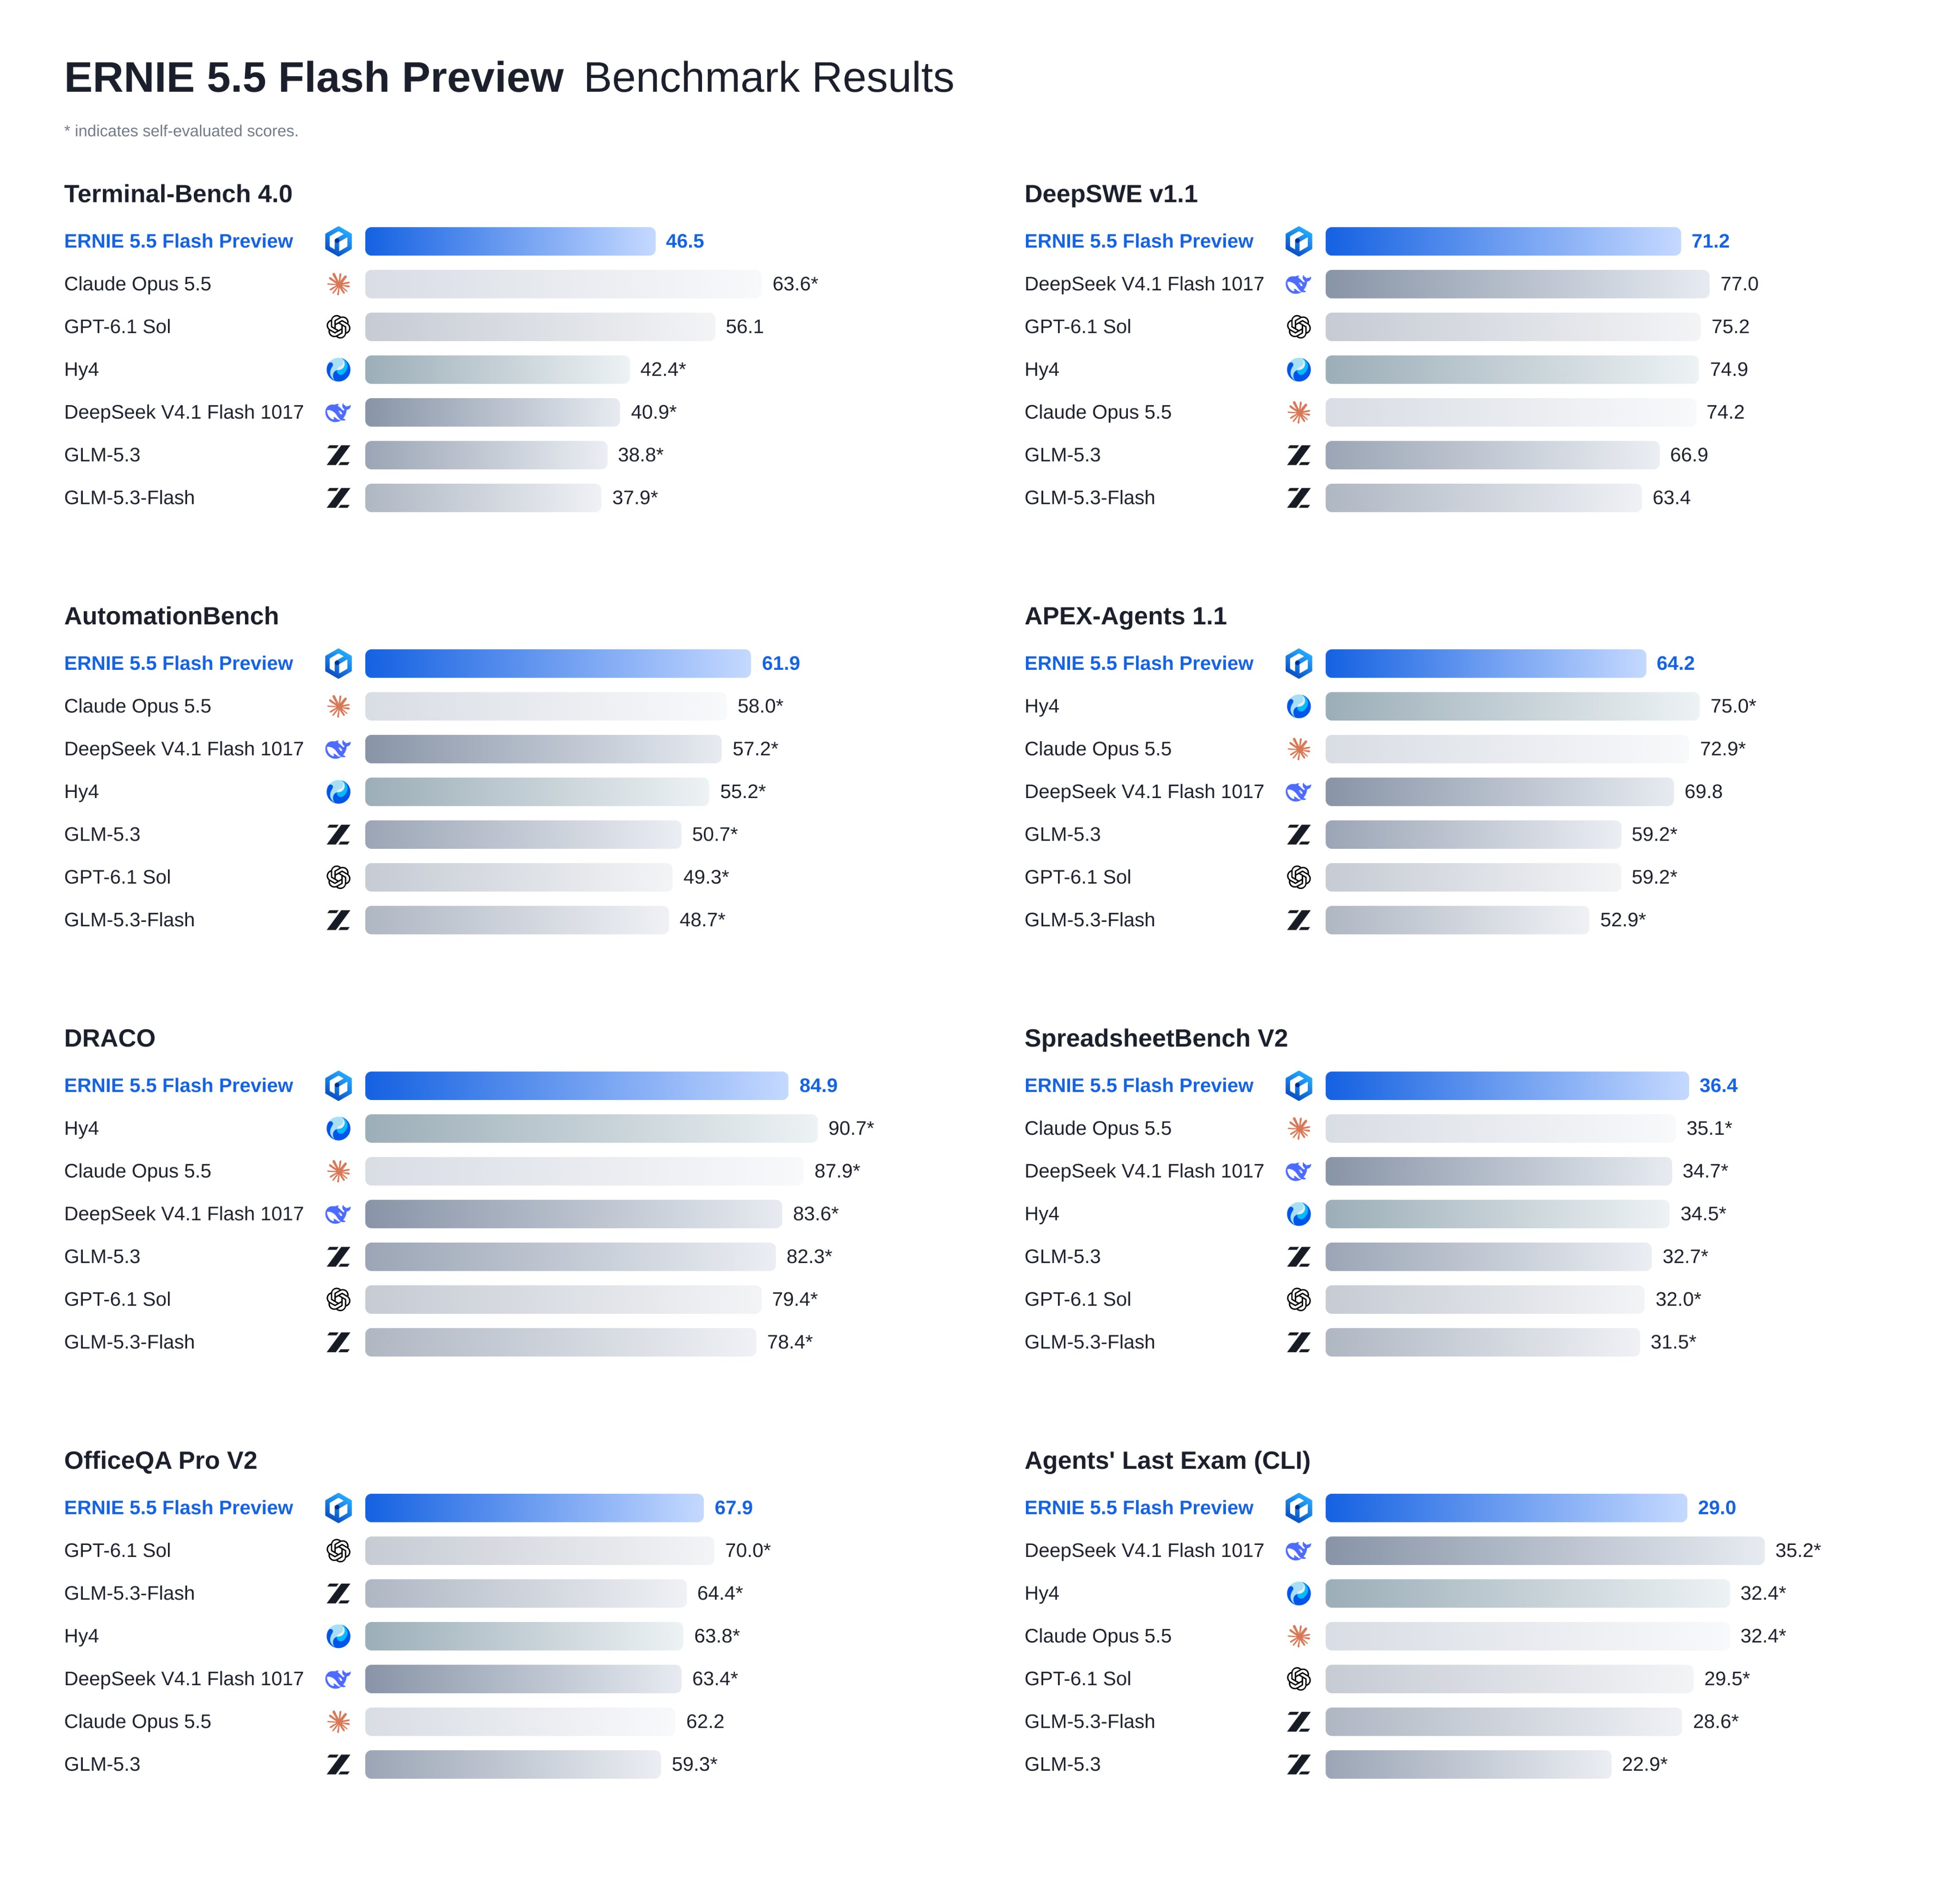
DeepSeek V4.1 Flash เป็น multimodal MoE ที่มีพารามิเตอร์ backbone 552B โดยใช้พารามิเตอร์ active 8B ต่อ token ในช่วง prefill และ 16B ในช่วง decode ซึ่งทำให้งาน agent ที่หนักไปทาง input มีค่าใช้จ่ายต่ำ น้ำหนักโมเดลเป็น MIT บน Hugging Face ดู บทแนะนำ DeepSeek V4.1 Flash
GPT-6 Luna คือ "โมเดลที่มีประสิทธิภาพสูงสุดสำหรับงานโฟกัสและปริมาณสูง" ของ OpenAI รับได้ทั้งข้อความและรูปภาพ รองรับ reasoning effort ตั้งแต่ none ถึง max และใช้งานร่วมกับ tools ของ Responses API ได้ ดู GPT-6 Luna คืออะไร
ราคาต่อ 1M tokens และต้นทุนจริงของการเรียก agent หนึ่งครั้ง
ลูปการทำงานของ agent ต้องส่ง context ยาวชุดเดิมซ้ำในทุกขั้นตอน ดังนั้นเรื่อง caching และกฎตามช่วงเวลาจึงสำคัญไม่แพ้ราคาที่โฆษณา
- GPT-6 Luna: input $0.10, cached input $0.01, cache writes $0.125, output $0.50 Prompt ที่มี input เกิน 272K tokens จะคิด input 2 เท่าและ output 1.5 เท่าสำหรับทั้ง request Batch และ Flex ราคา 50% ของราคามาตรฐาน
- DeepSeek V4.1 Flash: input $0.30 (cache miss), cache hit $0.006, output $1.20 ในช่วง peak ช่วง off-peak ราคาครึ่งหนึ่ง Peak คือ 01:00–04:00 และ 06:00–10:00 UTC วันจันทร์ถึงศุกร์ นอกเหนือจากนั้น รวมถึงวันหยุดสุดสัปดาห์ ถือเป็น off-peak
- ERNIE 5.5 Flash Preview: input และ output $0 บน endpoint
:freeของ OpenRouter ซึ่ง OpenRouter ระบุว่ามีการจำกัดอัตราการเรียก Baidu ยังไม่ได้เผยแพร่ราคาต่อ token แบบเสียเงินในหน้าที่เราเข้าถึงได้ในวันนี้ จึงควรถือว่าตัวเลขใดๆ ที่เห็นจากที่อื่นเป็น [VERIFY]
สมมติ agent หนึ่งขั้นตอนมี input 50,000 tokens และ output 2,000 tokens โดยไม่มี cache:
| โมเดล | ต้นทุนต่อการเรียก 1 ครั้ง | ต้นทุนต่อการเรียก 1,000 ครั้ง |
|---|---|---|
| GPT-6 Luna | $0.0060 | $6.00 |
| DeepSeek V4.1 Flash, ช่วง peak | $0.0174 | $17.40 |
| DeepSeek V4.1 Flash, ช่วง off-peak | $0.0087 | $8.70 |
ERNIE 5.5 Flash Preview, :free |
$0 | $0 (ภายในขีดจำกัด rate limit) |
ทีนี้สมมติว่า input 90% เป็น cache hit ซึ่งเป็นเรื่องปกติสำหรับ agent ที่อ่าน repo ชุดเดิมซ้ำ Luna จะเหลือประมาณ $0.0020 ต่อการเรียก (บวกค่า cache write ครั้งเดียว) DeepSeek เหลือประมาณ $0.0042 ช่วง peak และ $0.0021 ช่วง off-peak ช่องว่างระหว่างสองโมเดลที่เสียเงินเกือบปิดลงในช่วง off-peak
ข้อควรระวังสองข้อ: แต่ละผู้ให้บริการมี tokenizer ของตัวเอง จำนวน token จึงต่างกันสำหรับ prompt เดียวกัน และ reasoning tokens ถูกคิดค่าเป็น output ดังนั้น reasoning effort สูงจะทำให้ค่า output บวมขึ้น วิเคราะห์ราคา DeepSeek V4.1 Flash ของเรา และ การเปรียบเทียบ API tier ต่ำกว่า $1 อธิบายเรื่องคณิตศาสตร์ของ cache ลึกขึ้นอีก
Context window, ความยาว output และความเร็ว
Context ไม่ใช่ตัวตัดสินในศึกนี้ ขีดจำกัด output ต่างกันมากกว่า: 384K สำหรับ DeepSeek, 128,000 สำหรับ Luna และ 1,024,000 ตามที่ระบุสำหรับ endpoint ฟรีของ ERNIE ส่วนคำกล่าวอ้างเรื่องความเร็วต้องพิจารณาอย่างรอบคอบ:
- ERNIE 5.5 Flash Preview: คำอธิบายโมเดลของ OpenRouter ระบุมากกว่า 200 tokens ต่อวินาที แต่ค่า throughput ที่ OpenRouter วัดเอง P50 ในช่วง 3 วันล่าสุดอยู่ที่ 79 tokens ต่อวินาที พร้อม latency P50 ที่ 2.53 วินาที บนผู้ให้บริการรายเดียว (Baidu Qianfan)
- DeepSeek V4.1 Flash: ไม่มีตัวเลข tokens ต่อวินาทีบนหน้าราคา แต่ระบุขีดจำกัด concurrency ที่ 2,500
- GPT-6 Luna: OpenAI จัดอยู่ในระดับ "Fast" พร้อมขีดจำกัดระดับ Build ที่ 5,000 requests และ 2,000,000 tokens ต่อนาที
ควรวัดจากภูมิภาคของคุณเองด้วย prompt ของคุณเอง ส่วน Apidog ด้านล่างจะช่วยจัดระบบให้
Open weights, การเข้าถึงฟรี และสัญญาอนุญาต
- DeepSeek V4.1 Flash เป็นตัวเดียวที่มีน้ำหนัก production ให้ดาวน์โหลดได้ในวันนี้ ภายใต้สัญญาอนุญาต MIT เช่าเซิร์ฟเวอร์รันเองได้ หรือเลือกผู้ให้บริการโฮสต์จาก Hugging Face card ของโมเดล
- ERNIE 5.5 Flash มีสอง artifacts: โมเดล Base (pretraining อย่างเดียว, 33.5T tokens) อยู่บน Hugging Face แล้ว ส่วน Preview ซึ่งเป็นโมเดลแชทและ agent ยังไม่มีน้ำหนักสาธารณะ Baidu บอกว่าจะเปิดให้ใช้ภายใต้ Apache 2.0 "เร็วๆ นี้" วันที่ที่อาจเห็นบนออนไลน์ยังไม่ได้รับการยืนยัน [VERIFY]
- GPT-6 Luna เป็นแบบปิด เข้าถึงผ่าน API ของ OpenAI หรือ Amazon Bedrock โดย free tier ของ API ถูกระบุว่า "Not supported"
สำหรับการทดสอบแบบ $0 endpoint :free ของ ERNIE เป็นประตูที่ง่ายที่สุด DeepSeek และ Luna ก็มีช่องทางฟรีของตัวเอง ดูได้ที่ วิธีใช้ DeepSeek V4.1 Flash ฟรี และ วิธีใช้ GPT-6 Luna ฟรี
ตัวไหนเหมาะกับ agent และงานเขียนโค้ด
แต่ละเจ้าวัด benchmark ในฮาร์นิสของตัวเอง อย่านำตัวเลขเหล่านั้นมาเทียบกันเป็นการทดสอบเดียว ให้เทียบว่าแต่ละตัวเน้นอะไร
DeepSeek V4.1 Flash รายงานคะแนน 90.6 บน Terminal-Bench 2.1 และ 74.2 บน DeepSWE v1.1 ที่ระดับ reasoning effort สูงสุด ทั้งหมดวัดโดย DeepSeek ในฮาร์นิสของตัวเอง Reasoning effort ปรับได้ 1–100 และ endpoint รองรับทั้งรูปแบบ OpenAI, Anthropic และ Responses จึงเสียบเข้า Claude Code, Codex หรือ OpenCode ได้ทันที
ERNIE 5.5 Flash Preview แสดงบนหน้าเปิดตัวของ Baidu ว่าสร้างเกม Unreal Engine 5.8 ในงานเขียนโค้ดเดียวนาน 11 ชั่วโมง และมินิเกมมือถือเกือบ 100 เกมจากเอกสารดีไซน์ แต่เป็น text-only ดังนั้นลูป agent ที่ขับเคลื่อนด้วย screenshot ยังใช้ไม่ได้ในตอนนี้ แดชบอร์ดของ OpenRouter ยังแสดงอัตราข้อผิดพลาด structured-output 21.70% และอัตราข้อผิดพลาด tool-call 1.01% ในช่วง 3 วัน จึงควรตรวจสอบ JSON output ก่อนนำไปใช้ใน pipeline
GPT-6 Luna ชนะเรื่องความหลากหลายของเครื่องมือ Responses API ให้ hosted shell, apply patch, computer use และ MCP ข้อจำกัดหนึ่งอยู่ที่ว่าใน Chat Completions function calling ทำงานได้เฉพาะเมื่อตั้ง reasoning_effort เป็น none หากต้องการใช้ tools พร้อม reasoning ให้ใช้ Responses API
คุณควรเลือกโมเดลราคาประหยัดตัวไหน?
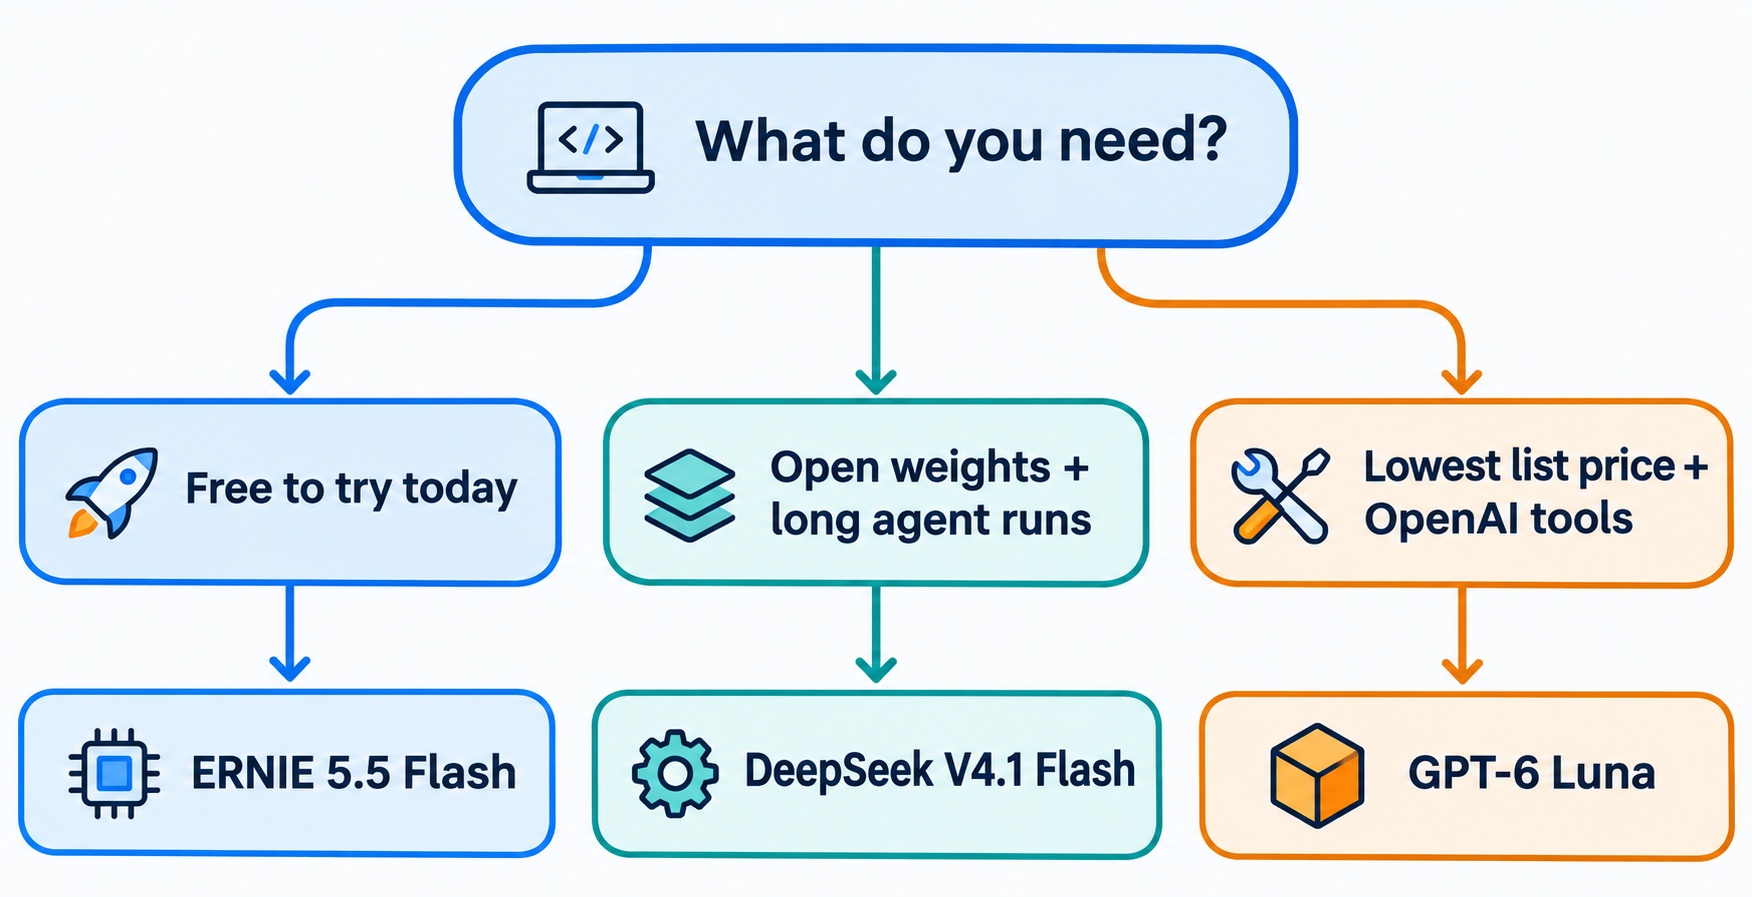
เลือกตามข้อจำกัด ไม่ใช่ตามกระดานคะแนน:
- อยากลองโมเดลใหม่แบบ $0 วันนี้: ERNIE 5.5 Flash Preview บน OpenRouter คาดหวังพฤติกรรมแบบ preview และขีดจำกัด rate limit
- ต้องการ open weights หรือวางแผน self-host: DeepSeek V4.1 Flash
- agent ของคุณทำงานยาว หนักทาง input และจัดตารางช่วง off-peak ได้: DeepSeek V4.1 Flash ซึ่ง cache hit ช่วง off-peak แค่ $0.003 ต่อ 1M
- อยากได้ราคาหน้าเว็บที่ถูกที่สุดและ hosted tools ของ OpenAI: GPT-6 Luna
- ต้องการ input แบบรูปภาพ: DeepSeek V4.1 Flash หรือ GPT-6 Luna ไม่ใช่ ERNIE
ให้ coding agent เทียบทั้งสามตัวด้วย Apidog CLI
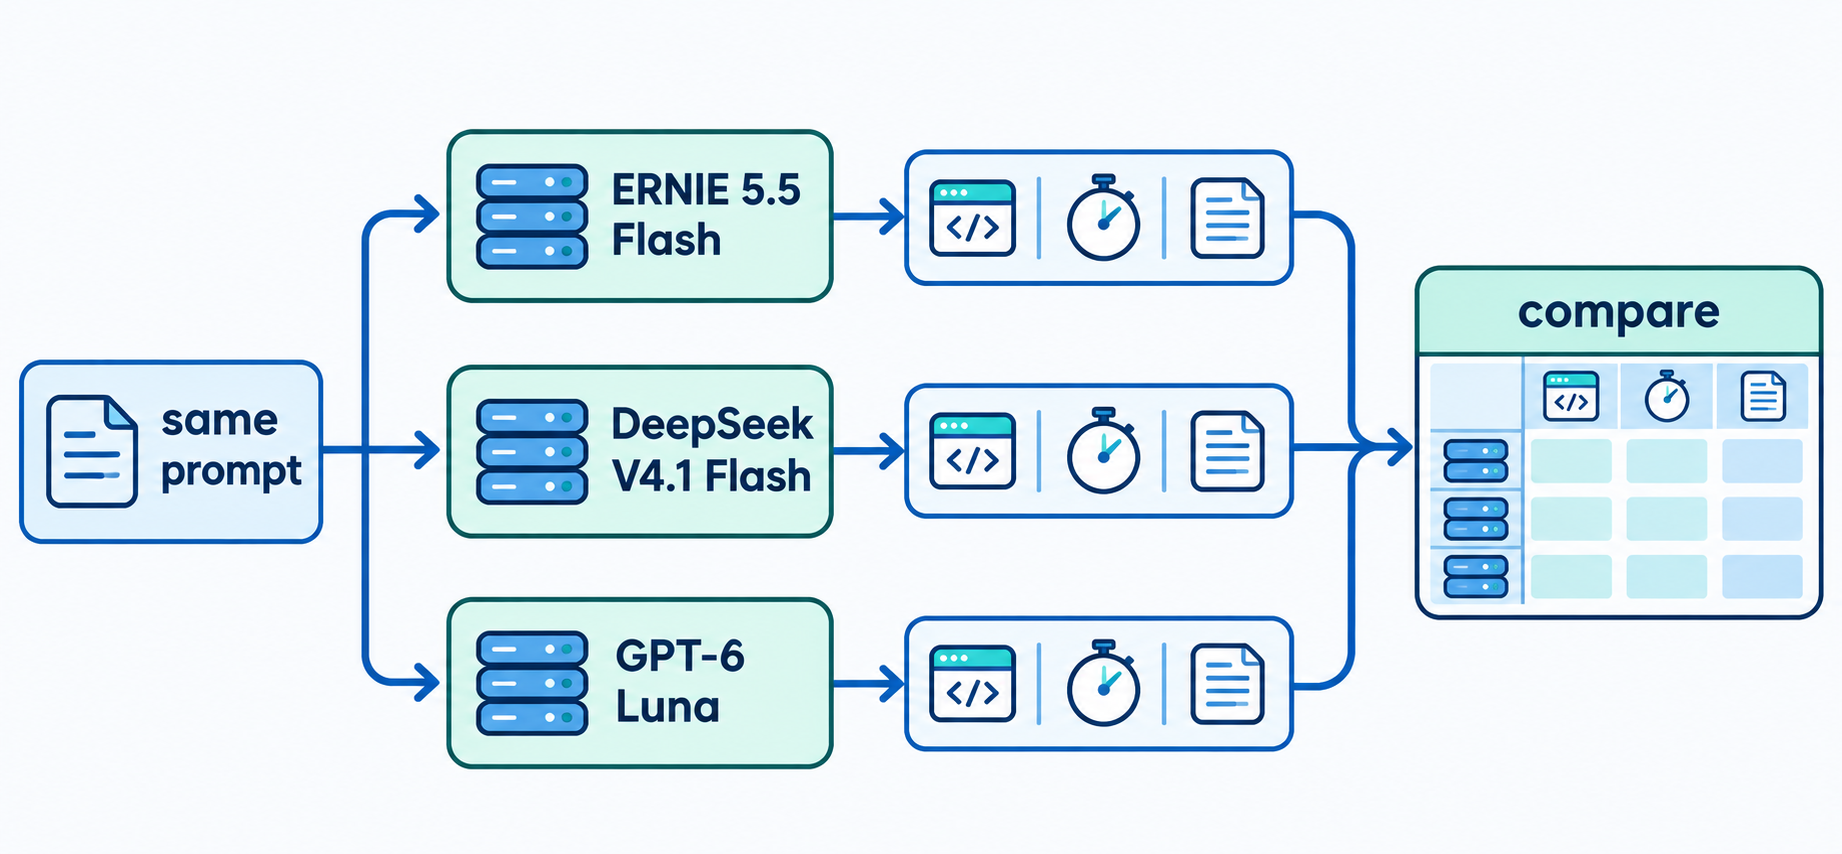
อย่าคลิกเรียก API สามตัวด้วยมือทุกครั้งที่โมเดลอัปเดต ให้ Claude Code, Codex หรือ Cursor สร้างฉากทดสอบหนึ่งชุดแล้วรันกับผู้ให้บริการแต่ละรายด้วย Apidog CLI ทั้งสามรองรับ OpenAI Chat Completions จึงเปลี่ยนแค่ base URL, model ID และ key
ติดตั้ง CLI ครั้งเดียว:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
แล้วสั่ง agent ของคุณด้วย prompt เดียว:
In Apidog project <projectId>, create three environments: ernie-flash
(base URL https://openrouter.ai/api/v1, model baidu/ernie-5.5-flash-preview:free),
deepseek-flash (https://api.deepseek.com, model deepseek-flash) and gpt-6-luna
(https://api.openai.com/v1, model gpt-6-luna). Create one test scenario that POSTs
the same prompt to {{baseUrl}}/chat/completions with model {{model}}, asserts
status 200 and a non-empty choices[0].message.content, and records
usage.completion_tokens. Run it 5 times per environment and give me a table of
pass rate, average response time and output tokens.
Agent จะสร้าง environments ตรวจ payload ของฉากทดสอบกับ schema เขียนไฟล์แล้วรัน:
apidog environment create ernie-flash --project <projectId> --base-url https://openrouter.ai/api/v1 --variables '<json>'
apidog environment create deepseek-flash --project <projectId> --base-url https://api.deepseek.com --variables '<json>'
apidog environment create gpt-6-luna --project <projectId> --base-url https://api.openai.com/v1 --variables '<json>'
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario run <scenarioId> --project <projectId> -e <envId> -n 5 -r cli,json --env-var "apiKey=$OPENROUTER_API_KEY"
การส่ง key ผ่าน --env-var ช่วยให้ key ไม่หลุดเข้าไปใน shared environment รันซ้ำต่อ environment ด้วย key ของผู้ให้บริการนั้นๆ แล้วนำรายงาน JSON มาทำตารางของคุณ คำสั่งรันเดียวกันด้วย -r junit ใช้ใน CI ได้ ดู คู่มือ CI/CD ของ Apidog CLI และ คู่มือตั้งค่ากับ Claude Code แผน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน ทีมเล็กจึงรันงานนี้ได้โดยไม่ต้องจ่ายค่าซีท
คำถามที่พบบ่อย
ERNIE 5.5 Flash ถูกกว่า DeepSeek V4.1 Flash หรือไม่? ตอนนี้ ใช่: endpoint :free บน OpenRouter ราคา $0 ภายในขีดจำกัด rate limit Baidu ยังไม่ได้เผยแพร่ราคาแบบเสียเงินที่เราตรวจสอบได้ จึงยังเทียบแบบเสียเงินกับเสียเงินไม่ได้ในตอนนี้
ตัวไหนมี context window ใหญ่ที่สุด? ใกล้เคียงกันมาก GPT-6 Luna ระบุ 1,050,000 tokens, ERNIE 5.5 Flash Preview 1,024,000 บน OpenRouter และ DeepSeek V4.1 Flash 1M แต่ราคาของ Luna จะเพิ่มเป็นสองเท่าเมื่อ input เกิน 272K tokens
รันโมเดลเหล่านี้ในเครื่องตัวเองได้ไหม? DeepSeek V4.1 Flash ได้: น้ำหนัก MIT บน Hugging Face น้ำหนัก ERNIE 5.5 Flash Base เป็นสาธารณะ แต่โมเดลแชท Preview ยังไม่เปิดให้ใช้ ส่วน GPT-6 Luna ไม่มีน้ำหนักสาธารณะ
ตัวไหนดีที่สุดสำหรับ coding agent? ขึ้นอยู่กับฮาร์นิสของคุณ DeepSeek V4.1 Flash รายงานคะแนน agentic สูงในการทดสอบของตัวเองและรองรับรูปแบบ OpenAI และ Anthropic GPT-6 Luna มีชุด hosted tools กว้างที่สุด ส่วน ERNIE 5.5 Flash Preview ฟรีแต่เป็น text-only และยังอยู่ช่วง preview
GPT-6 Luna มี free API tier ไหม? ไม่มี หน้าโมเดลของ OpenAI ระบุ Free tier ว่า "Not supported" การใช้งานแบบเสียเงินเริ่มที่ $0.10 ต่อ 1M input tokens