DeepSeek ได้เผยแพร่ข้อมูลโมเดล (model card) สำหรับ DeepSeek-V4.1-Flash เมื่อวันที่ 10 กันยายน 2026 และตัวเลขที่ออกมาก็เป็นเรื่องที่น่าอึดอัดใจสำหรับลูกค้า V4-Pro โมเดลที่เล็กกว่าและราคาถูกกว่านี้ได้คะแนนสูงกว่าโมเดลเรือธงในทุกเกณฑ์มาตรฐานการเขียนโค้ดและเอเจนต์ที่ DeepSeek ระบุไว้ มีค่าใช้จ่ายต่อโทเค็นน้อยกว่า 70 ถึง 77% ในช่วงพีค และในวันที่ 14 กันยายน โมเดลนี้จะเข้ามาแทนที่ V4-Pro ทั้งหมด: ทุกคำขอ deepseek-v4-pro จะถูกส่งไปยัง V4.1-Flash และถูกเรียกเก็บเงินในอัตรา Flash
นี่ไม่ใช่การแลกเปลี่ยนระหว่างขนาดเล็กกับขนาดใหญ่ตามปกติ นี่คือการเปรียบเทียบที่มีกำหนดเวลา หากคุณใช้ V4-Pro ในการผลิต คุณมีเวลาสี่วันในการเรียนรู้ว่าอะไรจะเปลี่ยนแปลงเมื่อการเปลี่ยนเส้นทางเกิดขึ้น หากคุณใช้ V4-Flash การเปลี่ยนแปลงได้เกิดขึ้นแล้ว: ชื่อ deepseek-v4-flash ถูกให้บริการโดย V4.1-Flash ในวันนี้
ด้านล่าง: โมเดลทั้งสามเกี่ยวกับสถาปัตยกรรม เกณฑ์มาตรฐานที่ DeepSeek รายงาน ราคา USD และปริมาณงาน จากนั้นเป็นเวิร์กโฟลว์สำหรับการเรียกใช้ชุดพร้อมต์เดียวกันผ่านทั้ง deepseek-v4-pro และ deepseek-flash ใน Apidog ก่อนการเปลี่ยนแปลง เพื่อเปรียบเทียบผลลัพธ์ เวลาแฝง และจำนวนการใช้งาน สำหรับข้อมูลเชิงลึกด้านสถาปัตยกรรม โปรดอ่าน DeepSeek-V4.1-Flash คืออะไร ก่อน สำหรับรายการตรวจสอบการโยกย้าย โปรดดู คู่มือการเลิกใช้งาน V4-Pro
สรุปโดยย่อ
- V4.1-Flash ชนะบนเกณฑ์มาตรฐานของ DeepSeek เอง DeepSWE v1.1 คือหัวข้อข่าว: 74.2 เทียบกับ 62.7 สำหรับ V4-Pro และ 54.4 สำหรับ V4-Flash
- เป็นโมเดลที่ถูกที่สุดในสามรุ่น อินพุตแบบแคชไม่ตรง (cache-miss input) ในช่วงพีคอยู่ที่ $0.30 ต่อ 1 ล้านโทเค็น เทียบกับ $1.32 สำหรับ V4-Pro และ $0.44 สำหรับ V4-Flash รุ่นเก่า
- ถูกสร้างมาเพื่อปริมาณงาน มีพารามิเตอร์ที่ใช้งานอยู่ 8 พันล้านตัวสำหรับการ prefill, แคช KV ขนาด 890 ไบต์ต่อโทเค็น และจำกัดการทำงานพร้อมกันที่ 2,500
- หลังวันที่ 14 กันยายน จะมีตัวเลือกเดียว การรับส่งข้อมูล V4-Pro จะถูกเปลี่ยนเส้นทางไปยัง V4.1-Flash คำถามคือคุณได้และเสียอะไรไป ไม่ใช่ว่าควรเลือกอันไหน
ข้อมูลจำเพาะแบบเปรียบเทียบ
V4.1 เป็นสถาปัตยกรรมใหม่ ไม่ใช่การฝึกซ้ำหลังการโพสต์ DeepSeek เรียกมันว่า Causal Encoder-Decoder (CED): 40 เลเยอร์ แบ่งเป็น 20 encoder และ 20 decoder พร้อมด้วยผู้เชี่ยวชาญที่ถูกกำหนดเส้นทาง 384 คน บวกกับผู้เชี่ยวชาญที่ใช้ร่วมกันหนึ่งคนต่อเลเยอร์ ข้อมูลโมเดล (model card) ระบุว่าส่วนหลักมีพารามิเตอร์ 552 พันล้านตัว (763 พันล้านตัวเมื่อรวมกับ vision encoder)
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| รุ่นสถาปัตยกรรม | V4 MoE | V4 MoE | V4.1 Causal Encoder-Decoder, 40 เลเยอร์ |
| พารามิเตอร์ทั้งหมด | 284 พันล้าน (รายการ OpenRouter ของรุ่น vision) | ไม่เปิดเผยที่นี่ | ส่วนหลัก 552 พันล้าน, 763 พันล้านพร้อม vision encoder |
| พารามิเตอร์ที่ใช้งานอยู่ | 13 พันล้าน | ไม่เปิดเผยที่นี่ | 8 พันล้านสำหรับการ prefill, 16 พันล้านสำหรับการ decode |
| หน้าต่างบริบท | 1 ล้านโทเค็น | 1 ล้านโทเค็น | 1 ล้านโทเค็น |
| เอาต์พุตสูงสุด | 384K โทเค็น | 384K โทเค็น | 384K โทเค็น |
| ความสามารถด้านภาพ | รุ่น Vision-Exp แยกต่างหาก | ไม่เปิดเผยที่นี่ | เป็นธรรมชาติ, DeepSeek-ViT encoder |
| ใบอนุญาต | ไม่ครอบคลุมที่นี่ | ไม่ครอบคลุมที่นี่ | MIT, น้ำหนักโมเดลบน Hugging Face |
| ขีดจำกัดการทำงานพร้อมกัน | 2,500 | 500 | 2,500 |
| สถานะ API | เลิกใช้งานแล้ว, ชื่อแทนถูกให้บริการโดย V4.1-Flash | เปลี่ยนเส้นทางไปยัง V4.1-Flash ในวันที่ 14 ก.ย. | เปิดให้บริการทั่วไป (GA) ตั้งแต่วันที่ 10 ก.ย. โดยมีรหัสโมเดล deepseek-flash |
การแยกจำนวนพารามิเตอร์ที่ใช้งานอยู่เป็นจุดที่น่าสังเกต: V4-Flash ใช้ 13 พันล้านตัวสำหรับทุกโทเค็น ในขณะที่ V4.1-Flash ใช้ 8 พันล้านตัวสำหรับอินพุต และ 16 พันล้านตัวสำหรับเอาต์พุต ซึ่งเป็นส่วนที่คุณภาพอยู่
เกณฑ์มาตรฐาน: 11.5 คะแนนมาจากไหน
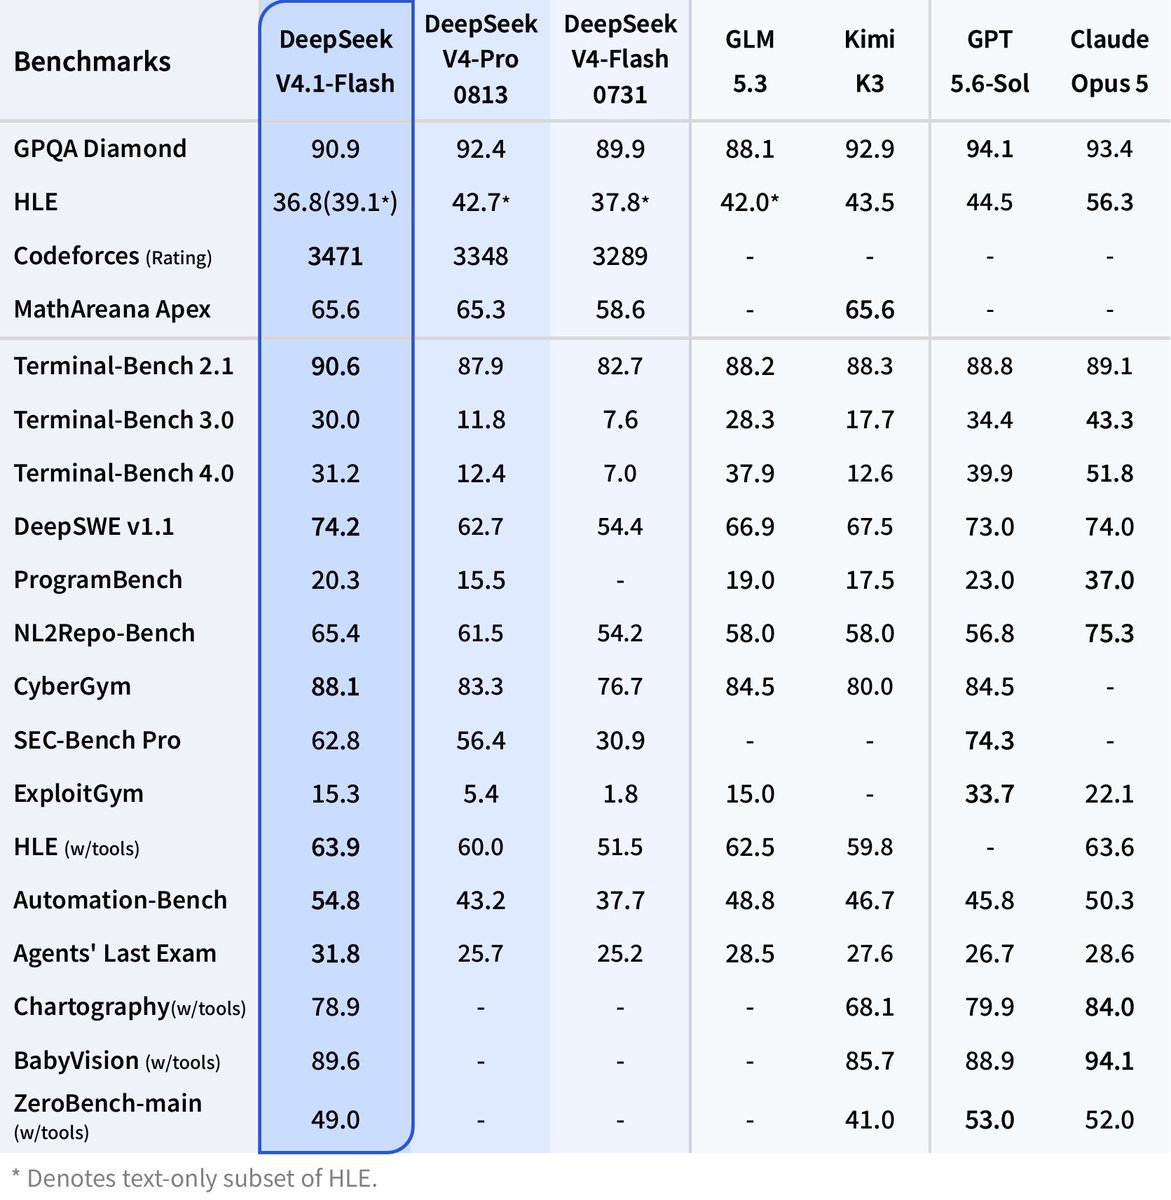
ตัวเลขทั้งหมดด้านล่างนี้ DeepSeek รายงานมาจากข้อมูลโมเดล (model card) ยังไม่มีการเผยแพร่ผลการทดสอบที่เป็นอิสระ และวลี "การทดสอบโดยหลายฝ่าย" ในประกาศการเลิกใช้งานก็ไม่ได้ระบุชื่อฝ่ายเหล่านั้น โปรดพิจารณาว่าเป็นข้อเรียกร้องของผู้จำหน่าย และตรวจสอบด้วยพร้อมต์ของคุณเอง
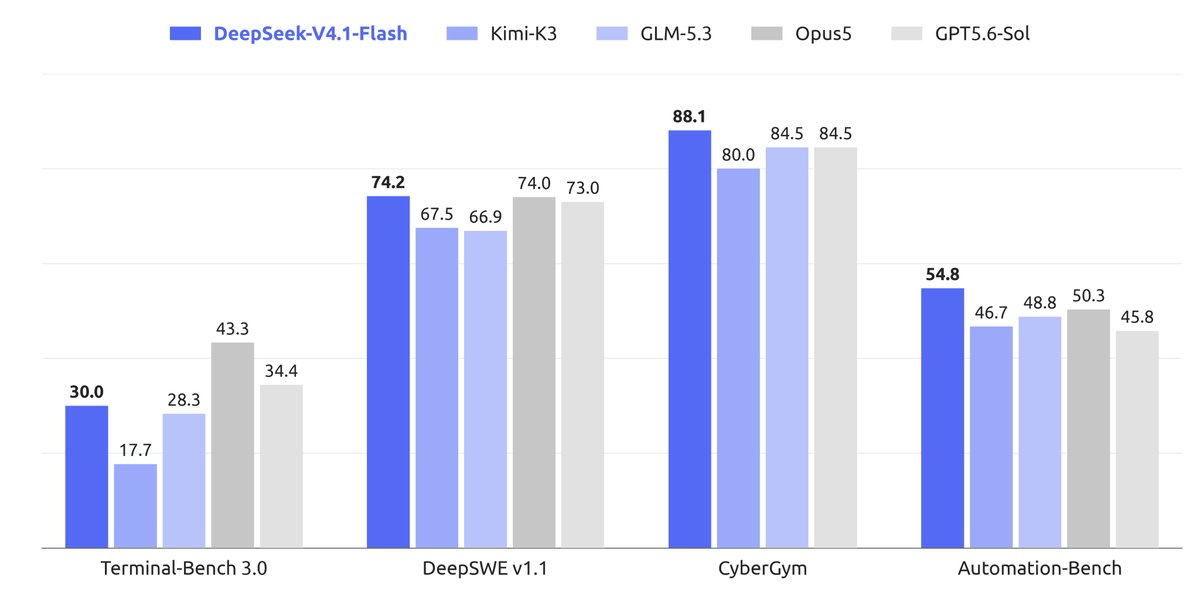
DeepSWE v1.1 (+11.5 เหนือ Pro, +19.8 เหนือ V4-Flash) นี่คือหัวข้อข่าว และเป็นช่องว่างเดียวที่ใหญ่พอจะเปลี่ยนการตัดสินใจได้ DeepSWE วัดงานวิศวกรรมซอฟต์แวร์แบบหลายไฟล์ ซึ่งเป็นภาระงานที่เอเจนต์เขียนโค้ดทำงานตลอดทั้งวัน หากผลนี้ยังคงอยู่กับโปรเจกต์ของคุณ V4.1-Flash จะเขียนโค้ดได้ดีกว่าโมเดลที่มีราคาแพงกว่าถึงสี่เท่า
Terminal-Bench 2.1 (+2.7) งานเอเจนต์ที่ขับเคลื่อนด้วย Shell V4-Flash-0731 เคยเอาชนะ V4-Pro-Preview ได้แล้วในเดือนกรกฎาคม; V4.1 ขยายความเป็นผู้นำได้ไม่ถึงสามจุด เป็นเรื่องจริง แต่ไม่ใช่จุดชี้ขาด
HumanEval (+2.6) และ GSM8K (+0.4) ทั้งสองใกล้ถึงจุดอิ่มตัว: ทุกโมเดลได้คะแนนเกิน 90 ใน GSM8K และ HumanEval ไม่ได้บอกอะไรมากเกี่ยวกับโค้ดที่ใช้ในการผลิต อย่าให้น้ำหนักกับแถวเหล่านี้มากนัก
MiniMax M3 เทียบกับ DeepSeek V4 เทียบกับ Qwen 3.7 มีตัวเลขของโมเดล V4 เทียบกับโมเดลโอเพนซอร์สอื่น ๆ; ยังไม่มีโมเดลใดรวม V4.1 เข้าไป
ค่าใช้จ่าย: สามโมเดล, หกช่วงราคา
ช่วงพีคคือวันจันทร์ถึงศุกร์ เวลา 01:00 ถึง 04:00 และ 06:00 ถึง 10:00 UTC นอกเหนือจากนั้นเป็นช่วงนอกพีค ซึ่งมีราคาครึ่งหนึ่ง อัตราค่าบริการต่อ 1 ล้านโทเค็นจาก หน้าอัตราค่าบริการ มีผลตั้งแต่วันที่ 10 กันยายน แถวของ V4-Flash ใช้อัตรา USD ของวันที่ 21 สิงหาคม 2026 เป็นคอลัมน์ "ก่อน"
| โมเดลและระดับ | อินพุต (แคชตรง) | อินพุต (แคชไม่ตรง) | เอาต์พุต |
|---|---|---|---|
| V4-Flash, นอกช่วงพีค (อัตรา 21 ส.ค.) | $0.007 | $0.22 | $0.66 |
| V4-Flash, ช่วงพีค (อัตรา 21 ส.ค.) | $0.014 | $0.44 | $1.32 |
| V4-Pro, นอกช่วงพีค | $0.022 | $0.66 | $1.98 |
| V4-Pro, ช่วงพีค | $0.044 | $1.32 | $3.96 |
| V4.1-Flash, นอกช่วงพีค | $0.003 | $0.15 | $0.60 |
| V4.1-Flash, ช่วงพีค | $0.006 | $0.30 | $1.20 |
เมื่อเทียบกับ V4-Flash, V4.1 ลดอินพุตแบบแคชตรงได้ประมาณ 57%, อินพุตแบบแคชไม่ตรงประมาณ 32% และเอาต์พุตประมาณ 9% เมื่อเทียบกับ V4-Pro, การลดลงอยู่ที่ 77% สำหรับอินพุตแบบแคชไม่ตรง และ 70% สำหรับเอาต์พุตในช่วงพีค
ตัวอย่างการใช้งานหนึ่งเดือน เอเจนต์เขียนโค้ดประมวลผลอินพุต 2 พันล้านโทเค็นต่อเดือน ด้วยอัตราแคชตรง 70% (พร้อมต์ระบบและบริบทของที่เก็บโค้ดถูกนำกลับมาใช้ใหม่ในการใช้งานแต่ละครั้ง) และสร้างเอาต์พุต 300 ล้านโทเค็น ทั้งหมดในช่วงพีค
| V4-Pro, ช่วงพีค | V4-Flash, ช่วงพีค | V4.1-Flash, ช่วงพีค | V4.1-Flash, นอกช่วงพีค | |
|---|---|---|---|---|
| อินพุตแคชตรง 1.4 พันล้าน | $61.60 | $19.60 | $8.40 | $4.20 |
| อินพุตแคชไม่ตรง 600 ล้าน | $792.00 | $264.00 | $180.00 | $90.00 |
| เอาต์พุต 300 ล้าน | $1,188.00 | $396.00 | $360.00 | $180.00 |
| ยอดรวมรายเดือน | $2,041.60 | $679.60 | $548.40 | $274.20 |
นั่นน้อยกว่า V4-Pro ถึง 73% และการย้ายงานแบตช์ไปช่วงนอกพีคจะช่วยลดลงอีกครึ่งหนึ่ง โทเค็นเอาต์พุตมีผลมากที่สุดในทุกคอลัมน์ ดังนั้นการลดเอาต์พุต 70% จึงสำคัญกว่าหัวข้อข่าวเรื่องแคชตรง การวิเคราะห์ราคา DeepSeek-V4.1-Flash ครอบคลุมการคำนวณแคชตรง
ความเร็วและปริมาณงาน
DeepSeek ไม่ได้เผยแพร่ตัวเลขโทเค็นต่อวินาที ดังนั้นเรื่องราวเกี่ยวกับปริมาณงานจึงอิงตามข้อเท็จจริงทางสถาปัตยกรรมสามประการและเรื่องเล่าหนึ่งเรื่อง
- แคช KV ที่ 890 ไบต์ต่อโทเค็น การแคช KV หลักแบบ FP4 ทำให้แคชทั่วโลกมีขนาดประมาณหนึ่งในสี่ของ V4-Flash บันทึกการเปิดตัว ระบุว่าใช้ HBM เพียง 1 ใน 4 และพื้นที่จัดเก็บ SSD เพียง 1 ใน 8 ของรุ่นก่อนหน้า บริบทขนาด 1 ล้านโทเค็นเต็มต้องการแคชประมาณ 0.9 GB
- 8 พันล้านพารามิเตอร์ที่ใช้งานอยู่สำหรับการ prefill ใช้การประมวลผลต่อโทเค็นอินพุตน้อยกว่า 13 พันล้านของ V4-Flash ดังนั้นเวลาในการรับโทเค็นแรกในบริบทขนาดใหญ่ควรลดลง
- การทำงานพร้อมกัน 2,500 เทียบกับ 500 การรับส่งข้อมูล V4-Pro ที่ถูกเปลี่ยนเส้นทางจะได้รับขีดจำกัดของ Flash ซึ่งเพิ่มขึ้น 5 เท่าสำหรับกลุ่มเอเจนต์
- รายงานของผู้ใช้คนหนึ่ง: “เกือบ 400 t/s” ผู้ใช้ X รายหนึ่งโพสต์ข้อมูลนี้จากการทดสอบวิดีโอในช่วงเบต้า มันเป็นเรื่องเล่าส่วนตัว ไม่ใช่เกณฑ์มาตรฐาน กระทู้เบต้าของ Hacker News ส่วนใหญ่แสดงความกระตือรือร้นเช่นเดียวกัน
วัดค่า p50 และ p95 ของคุณเองก่อนที่จะเชื่อถือสิ่งเหล่านี้
สิ่งที่คุณได้และเสียไปหลังวันที่ 14 กันยายน
จะไม่มีคำถามว่า "ฉันควรเลือกโมเดลไหน" อีกต่อไปหลังจากการเปลี่ยนแปลง deepseek-v4-pro จะกลายเป็นชื่อแทน ดังนั้นการนำเสนอที่ตรงไปตรงมาที่สุดคือการเปรียบเทียบข้อดีข้อเสีย
- คุณจะได้: คะแนนที่สูงขึ้นในทุกเกณฑ์มาตรฐานที่ระบุไว้, ราคาช่วงพีคที่ลดลง 70 ถึง 77%, การทำงานพร้อมกันที่เพิ่มขึ้น 5 เท่า, การป้อนภาพแบบเนทีฟโดยไม่ต้องมีรหัสโมเดลภาพแยกต่างหาก, และปุ่มปรับความพยายามในการให้เหตุผลที่ DeepSeek อธิบายว่าสามารถควบคุมได้อย่างต่อเนื่องในระดับ 1 ถึง 100
- คุณจะเสีย: ความสามารถในการตรึงจุดตรวจสอบของโมเดล V4 รุ่นเก่า พร้อมต์ที่ปรับแต่งมาสำหรับรูปแบบ, ความละเอียด หรือการจัดรูปแบบการเรียกใช้เครื่องมือของ V4-Pro อาจมีการเปลี่ยนแปลงไป ความยาวของเอาต์พุตและจำนวนโทเค็นการให้เหตุผลอาจเปลี่ยนแปลงไป ซึ่งจะส่งผลให้บิลของคุณเปลี่ยนแปลงในลักษณะที่ตารางราคาไม่ได้แสดงไว้ และการเปลี่ยนเส้นทางจะเกิดขึ้นตามกำหนดการของ DeepSeek ไม่ใช่ของคุณ
รายการที่สองนั้นคือเหตุผลที่คุณควรทำการเปรียบเทียบก่อนวันที่ 14 ไม่ใช่หลังจากนั้น
เปรียบเทียบ V4-Pro กับ V4.1-Flash ใน Apidog ก่อนการเปลี่ยนแปลง
Apidog ทดสอบเลเยอร์ API ดังนั้นจึงเป็นสถานที่ที่เหมาะสมในการเรียกใช้ชุดพร้อมต์เดียวกันผ่านรหัสโมเดลทั้งสอง และเปรียบเทียบผลลัพธ์ที่ได้กลับมา
- เพิ่มเอนด์พอยต์ สร้างโปรเจกต์และเพิ่ม
POST https://api.deepseek.com/chat/completionsหรือนำเข้า OpenAPI spec - ใส่คีย์และรหัสโมเดลในสภาพแวดล้อม เก็บ
DEEPSEEK_API_KEYและตัวแปรMODELสร้างสองสภาพแวดล้อม:v4-proด้วยMODEL=deepseek-v4-proและv41-flashด้วยMODEL=deepseek-flashและอ้างอิงถึงสิ่งเหล่านี้เป็นBearer {{DEEPSEEK_API_KEY}}ในส่วนหัว (header) และ"model": "{{MODEL}}"ในส่วนเนื้อหา (body) - บันทึกพร้อมต์จริงของคุณเป็นคำขอ เลือกพร้อมต์ 20 ถึง 30 รายการที่แสดงถึงการใช้งานจริง: พร้อมต์ระบบของคุณ, การเรียกใช้เครื่องมือ, การสรุปบริบทขนาดยาว, การแก้ไขโค้ดหลายไฟล์ บันทึกแต่ละรายการด้วย
stream: falseเพื่อให้วัตถุusageอยู่ในเนื้อหาการตอบกลับ - ยืนยันค่าในฟิลด์ที่มีผลต่อบิลของคุณ สร้างสถานการณ์ทดสอบจากคำขอที่บันทึกไว้และเพิ่มการยืนยัน (assertions) บน
usage.prompt_tokens,usage.completion_tokensและusage.prompt_cache_hit_tokensบันทึกเวลาตอบสนองในแต่ละขั้นตอน และเพิ่มสคริปต์ก่อนการร้องขอที่ประทับชื่อสภาพแวดล้อมลงในส่วนหัวเพื่อให้การทำงานถูกระบุชื่อ - เรียกใช้หนึ่งครั้งต่อสภาพแวดล้อม จากนั้นเปรียบเทียบความแตกต่าง เรียกใช้สถานการณ์ภายใต้
v4-proจากนั้นภายใต้v41-flashเปรียบเทียบจำนวนโทเค็นที่สมบูรณ์ (การเปลี่ยนเส้นทางจะเปลี่ยนบิลเอาต์พุตของคุณ), เวลาแฝงต่อขั้นตอน และเนื้อหาเองเพื่อดูการเปลี่ยนแปลงรูปแบบ - เรียกใช้ซ้ำใน CI ในวันที่ 14 เรียกใช้สถานการณ์เดียวกันด้วย
apidog-cliในไปป์ไลน์ของคุณในช่วงการเปลี่ยนแปลง สิ่งใดก็ตามที่การเปลี่ยนเส้นทางทำให้เกิดข้อผิดพลาดจะปรากฏเป็นการยืนยันที่ไม่สำเร็จ แทนที่จะเป็นตั๋วสนับสนุน
การเปรียบเทียบเดียวกันในรูปแบบสคริปต์:
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Make payment retries in the checkout service idempotent. Return a unified diff."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
เรียกใช้ในช่วงพีคและนอกพีค และเก็บผลลัพธ์ไว้ ดาวน์โหลด Apidog เพื่อเก็บความแตกต่าง, การยืนยัน และประวัติการรันไว้ในที่เดียว
คำถามที่พบบ่อย
V4.1-Flash เขียนโค้ดได้ดีกว่า V4-Pro หรือไม่? ตามตัวเลขที่ DeepSeek รายงาน ใช่: 74.2 เทียบกับ 62.7 ใน DeepSWE v1.1 และ 90.6 เทียบกับ 87.9 ใน Terminal-Bench 2.1 สำหรับการเปรียบเทียบโมเดล V4 กับ Claude ในการเขียนโค้ด โปรดดู DeepSeek V4 เทียบกับ Claude Opus สำหรับการเขียนโค้ด
จะเกิดอะไรขึ้นกับการรวม V4-Pro ของฉันในวันที่ 14 กันยายน? ตั้งแต่เวลา 04:00 UTC ทุกคำขอ deepseek-v4-pro จะถูกให้บริการโดย V4.1-Flash และถูกเรียกเก็บเงินในอัตรา Flash โค้ดของคุณยังคงทำงานได้; โมเดลที่อยู่เบื้องหลังจะเปลี่ยนไป คู่มือการโยกย้าย มีรายการตรวจสอบทั้งหมด
ฉันจำเป็นต้องเปลี่ยนชื่อ deepseek-v4-flash เป็น deepseek-flash หรือไม่? ยังไม่จำเป็นในวันนี้ deepseek-v4-flash และ deepseek-v4-flash-vision-exp ยังคงได้รับการยอมรับและให้บริการโดย V4.1-Flash DeepSeek ยังไม่ได้กำหนดวันที่ยกเลิก ดังนั้นให้เปลี่ยนไปใช้ deepseek-flash ในครั้งถัดไปที่คุณแก้ไขการตั้งค่า
V4.1-Flash เร็วกว่า V4-Pro หรือไม่? DeepSeek กล่าวเช่นนั้นแต่ไม่ได้เผยแพร่ตัวเลขใด ๆ สถาปัตยกรรมสนับสนุนข้ออ้างดังกล่าว: มีพารามิเตอร์ที่ใช้งานอยู่ 8 พันล้านตัวสำหรับการ prefill และแคช KV ที่มีขนาดเพียงหนึ่งในสี่ของ V4-Flash โปรดวัดผลด้วยตัวคุณเอง
ฉันยังสามารถเรียกใช้ V4-Pro ที่อื่นได้หรือไม่? ไม่ได้บน API ของ DeepSeek หลังจากวันที่ 14 ข้อมูลพื้นฐานของโมเดล V4 อยู่ใน DeepSeek V4 คืออะไร น้ำหนักโมเดล V4.1-Flash อยู่บน Hugging Face ภายใต้ใบอนุญาต MIT
สรุปสั้น ๆ
V4.1-Flash มีขนาดเล็กลง ราคาถูกลง และได้คะแนนสูงขึ้นในเวลาเดียวกัน อย่างน้อยก็บนตารางของทางผู้จำหน่าย และตารางนั้นไม่สามารถบอกได้ว่ามันดีกว่าสำหรับพร้อมต์ของคุณหรือไม่ เรียกใช้รหัสโมเดลทั้งสองผ่านชุดพร้อมต์เดียวกันใน Apidog ในสัปดาห์นี้ เก็บความแตกต่างไว้ แล้วคุณจะรู้ว่าอะไรจะเปลี่ยนแปลงในวันที่ 14 กันยายน ก่อนที่ผู้ใช้ของคุณจะรู้