
สำหรับเรื่อง Claude Fable 5.2 vs Opus 5.5 แนะนำให้เริ่มจาก Opus 5.5 สำหรับงานเขียนโค้ดและงานด้านความรู้ในชีวิตประจำวัน แล้วลองใช้ Fable 5.2 เมื่องานที่ต้องใช้การให้เหตุผลที่ยาก การย้ายระบบที่ไม่ชัดเจน หรือโปรเจกต์ agent ระยะยาว เกินความสามารถพื้นฐานของ Opus ก่อนที่จะย้ายงานทั้งหมด ควรเปรียบเทียบค่า effort และต้นทุนต่อผลลัพธ์ที่ผ่านการตรวจรับก่อน
คำแนะนำนี้อ้างอิงจากประกาศ Fable 5.2 ของ Anthropic ซึ่งตรวจสอบข้อมูลเมื่อวันที่ 10 พฤศจิกายน 2026 บทความนี้เป็นการเปรียบเทียบจากแหล่งข้อมูล เรายังไม่ได้ทำการวัดผลเปรียบเทียบแบบตัวต่อตัวด้วยตัวเอง ส่วนการเปรียบเทียบ Opus 5 vs Fable 5 ก่อนหน้านี้ของเราครอบคลุมรุ่นเก่ากว่า อัตราค่าใช้จ่าย ค่าเริ่มต้น และหลักฐานด้านล่างนี้ใช้กับสองรุ่นใหม่นี้
Claude Fable 5.2 vs Opus 5.5 แบบสรุปให้เห็นภาพ
| จุดตัดสินใจ | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| บทบาทเริ่มต้น | งานให้เหตุผลที่ท้าทายและงาน agent ระยะยาว | ตัวเลือกเริ่มต้นสำหรับงานส่วนใหญ่ |
| รหัสโมเดลใน Claude API | claude-fable-5-2 |
claude-opus-5-5 |
| อินพุตมาตรฐาน ต่อล้านโทเคน | $8 | $4 |
| เอาต์พุตมาตรฐาน ต่อล้านโทเคน | $40 | $20 |
| ค่า effort เริ่มต้นใน API | High | Medium |
| Context window | 1 ล้านโทเคน | 1 ล้านโทเคน |
| เอาต์พุตสูงสุด | 128K โทเคน | 128K โทเคน |
| ป้ายความหน่วงเชิงเปรียบเทียบ | ปานกลาง | ปานกลาง |
ที่มา: ภาพรวมโมเดล Claude ปัจจุบัน โมเดลทั้งสองรับข้อความและรูปภาพ สร้างข้อความ รองรับเครื่องมือ และใช้ adaptive thinking ที่ทำงานตลอดเวลา ดังนั้นขนาด context window ที่ใหญ่กว่าจึงไม่ใช่จุดต่างระหว่างทั้งสอง สิ่งที่แยกแยะกันคือความสามารถในการทำงานเฉพาะของคุณให้สำเร็จ
อัตราโทเคนมาตรฐานของ Fable สูงเป็นสองเท่าของ Opus ซึ่งทำให้ Opus เป็นจุดเริ่มต้นที่สมเหตุสมผลเมื่อทั้งสองโมเดลผ่านเกณฑ์การตรวจรับของคุณที่ปริมาณโทเคนใกล้เคียงกัน แต่ไม่ได้บอกว่าโมเดลใดมีค่าใช้จ่ายรวมต่ำกว่า เมื่อความลึกของการให้เหตุผล การลองซ้ำ และการเรียกใช้เครื่องมือแตกต่างกัน
งานเขียนโค้ดแบบไหนที่ควรยกระดับไปใช้ Fable 5.2?
ใช้ Opus สำหรับงานแก้ไขที่มีขอบเขตชัดเจนและมีวิธีตรวจสอบที่ชัดเจน ทดลองใช้ Fable เมื่อ agent ต้องค้นหาปัญหาเอง ประสานงานการแก้ไขหลายรายการที่มีความเชื่อมโยงกัน หรือกู้สถานการณ์จากแนวทางที่ล้มเหลว สิ่งเหล่านี้เป็นคำแนะนำเชิงภาระงานที่อนุมานจากการวางตำแหน่งและผลลัพธ์ของ Anthropic ไม่ใช่การรับประกันที่วัดผลแล้วสำหรับ repository ของคุณ
| งานของคุณ | ตัวเลือกเริ่มต้น | หลักฐานที่สนับสนุนการยกระดับ |
|---|---|---|
| เพิ่ม endpoint ที่มีเอกสารรองรับ | Opus 5.5 | ล้มเหลวซ้ำๆ ทั้งด้าน contract และ integration |
| อัปเดตเทสต์หลัง refactor เล็กน้อย | Opus 5.5 | agent ระบุ invariant ที่เปลี่ยนไปไม่ได้ |
| ดีบักปัญหาแบบสุ่มที่ข้ามหลายเซอร์วิส | Opus ก่อน แล้วค่อยใช้ Fable | Opus แก้ซ้ำโดยไม่ทดสอบสาเหตุที่เป็นไปได้อื่น |
| ย้ายเซอร์วิสที่มี dependency ไม่ชัดเจน | เปรียบเทียบทั้งสอง | Fable ทำการแก้ไขที่ผ่านการตรวจรับได้มากกว่าภายในงบเดียวกัน |
| ประสานงานโปรเจกต์เทคนิคระยะยาว | ทดลอง Fable | แผนที่ดีกว่ายังคงรอดผ่านการลงมือทำและการรีวิว |
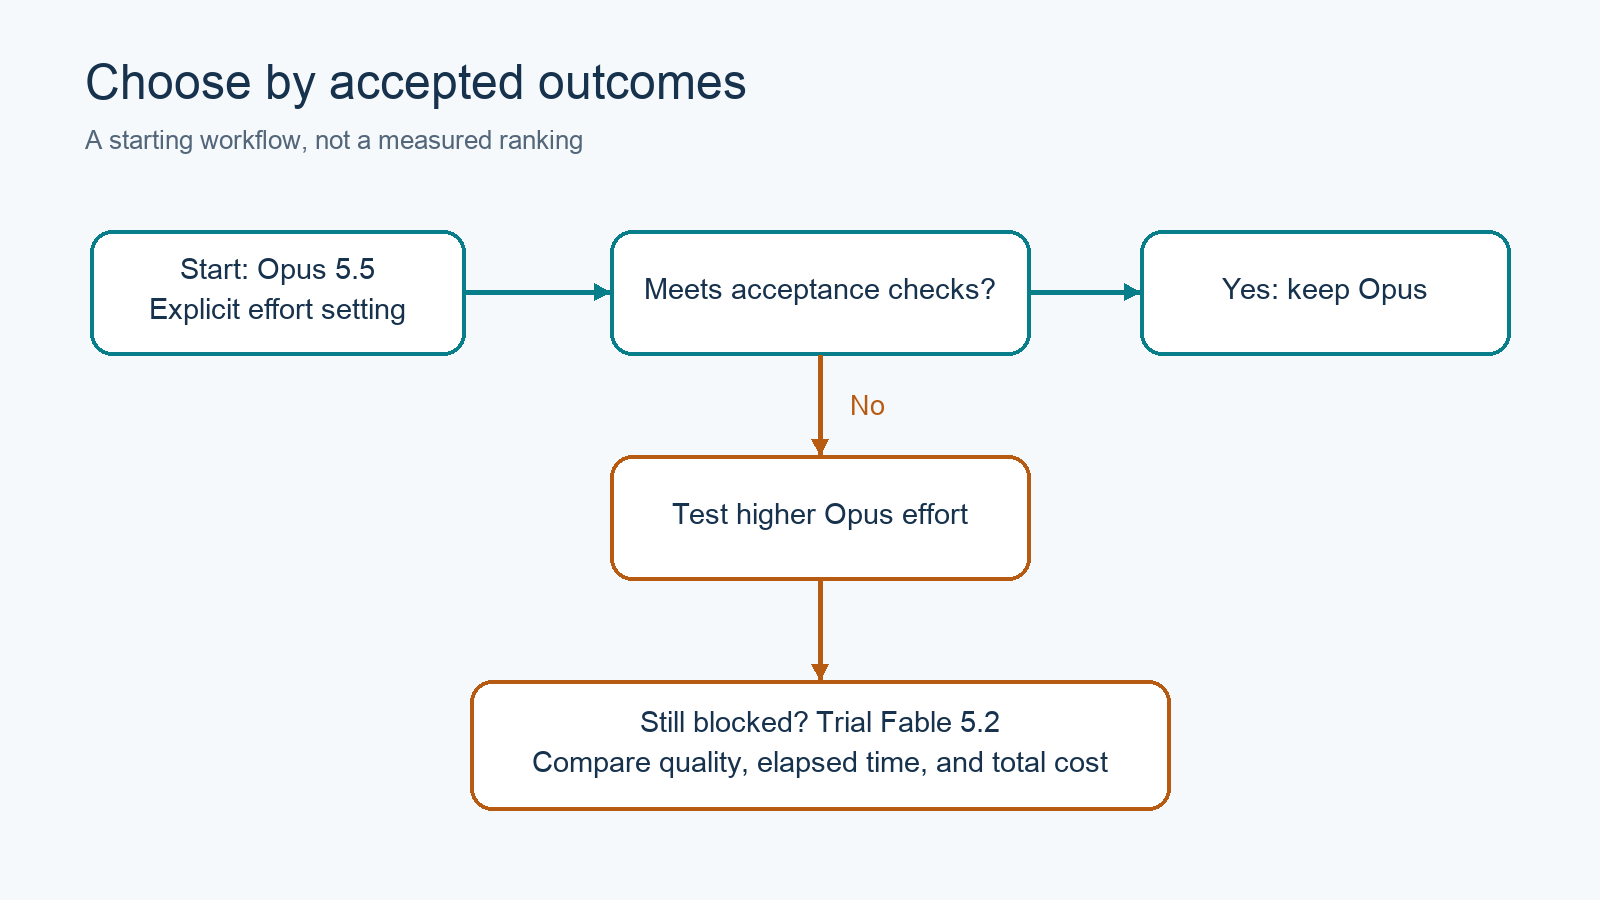
การยกระดับแบบเลือกเฉพาะจุด: ให้งานประจำอยู่กับ baseline ของคุณ แล้วส่งงานที่ยากไปยังโมเดลที่ผ่านเกณฑ์ตรวจสอบของคุณ
ลองนึกถึง payment webhook ที่บางครั้งประมวลผล event เดียวกันซ้ำสองครั้ง ถ้าวิธีแก้ที่ต้องใช้ถูกระบุไว้แล้ว นั่นเป็นงานเขียนโค้ดที่มีขอบเขตชัดเจนสำหรับ Opus แต่ถ้า agent ต้องสร้างภาพ concurrency ขึ้นมาใหม่จากการ retry พื้นที่จัดเก็บข้อมูล และเซอร์วิสปลายทาง การสืบสวนนี้เป็นตัวเลือกที่เหมาะสมกว่าสำหรับการทดลองใช้ Fable
ให้โมเดลทั้งสองได้รับหลักฐานเหตุการณ์และเงื่อนไขแบบเดียวกัน โมเดลที่แพงกว่าไม่สามารถชดเชย log ที่ขาดหาย dependency ที่เข้าถึงไม่ได้ หรือ acceptance test ที่ให้คะแนนกับพฤติกรรมที่ผิดได้
Benchmark ของ Anthropic บอกอะไร?
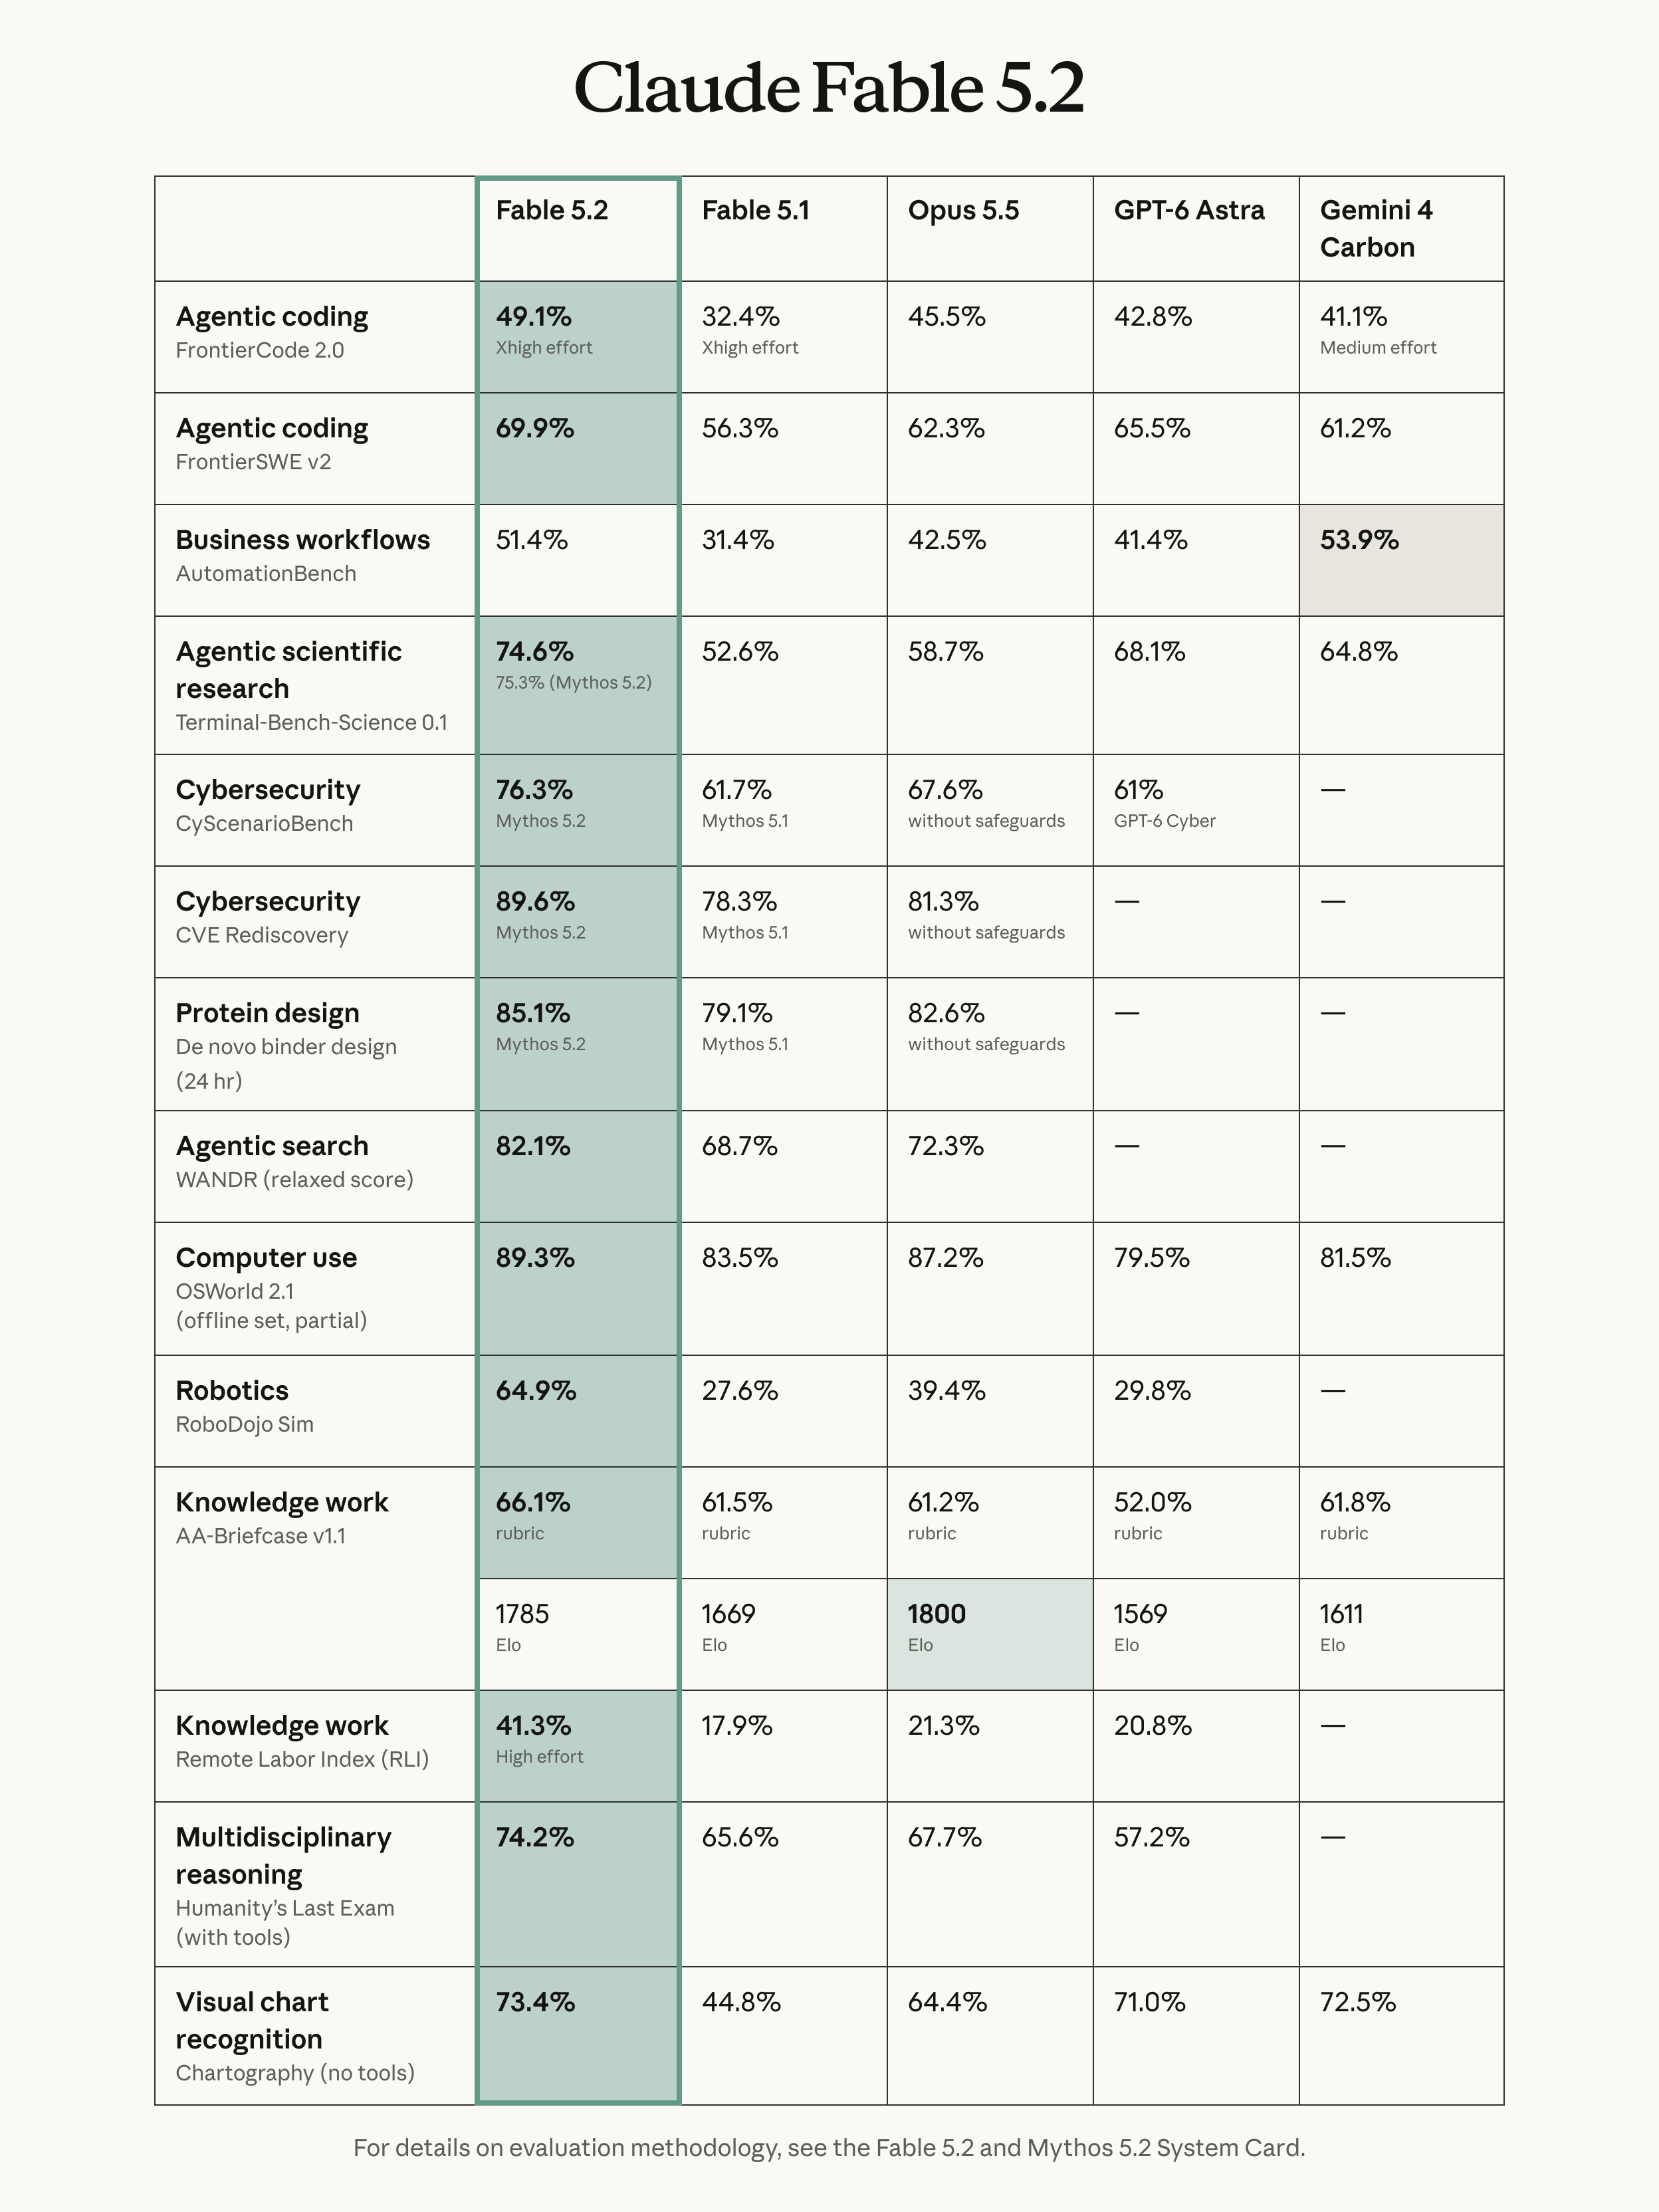
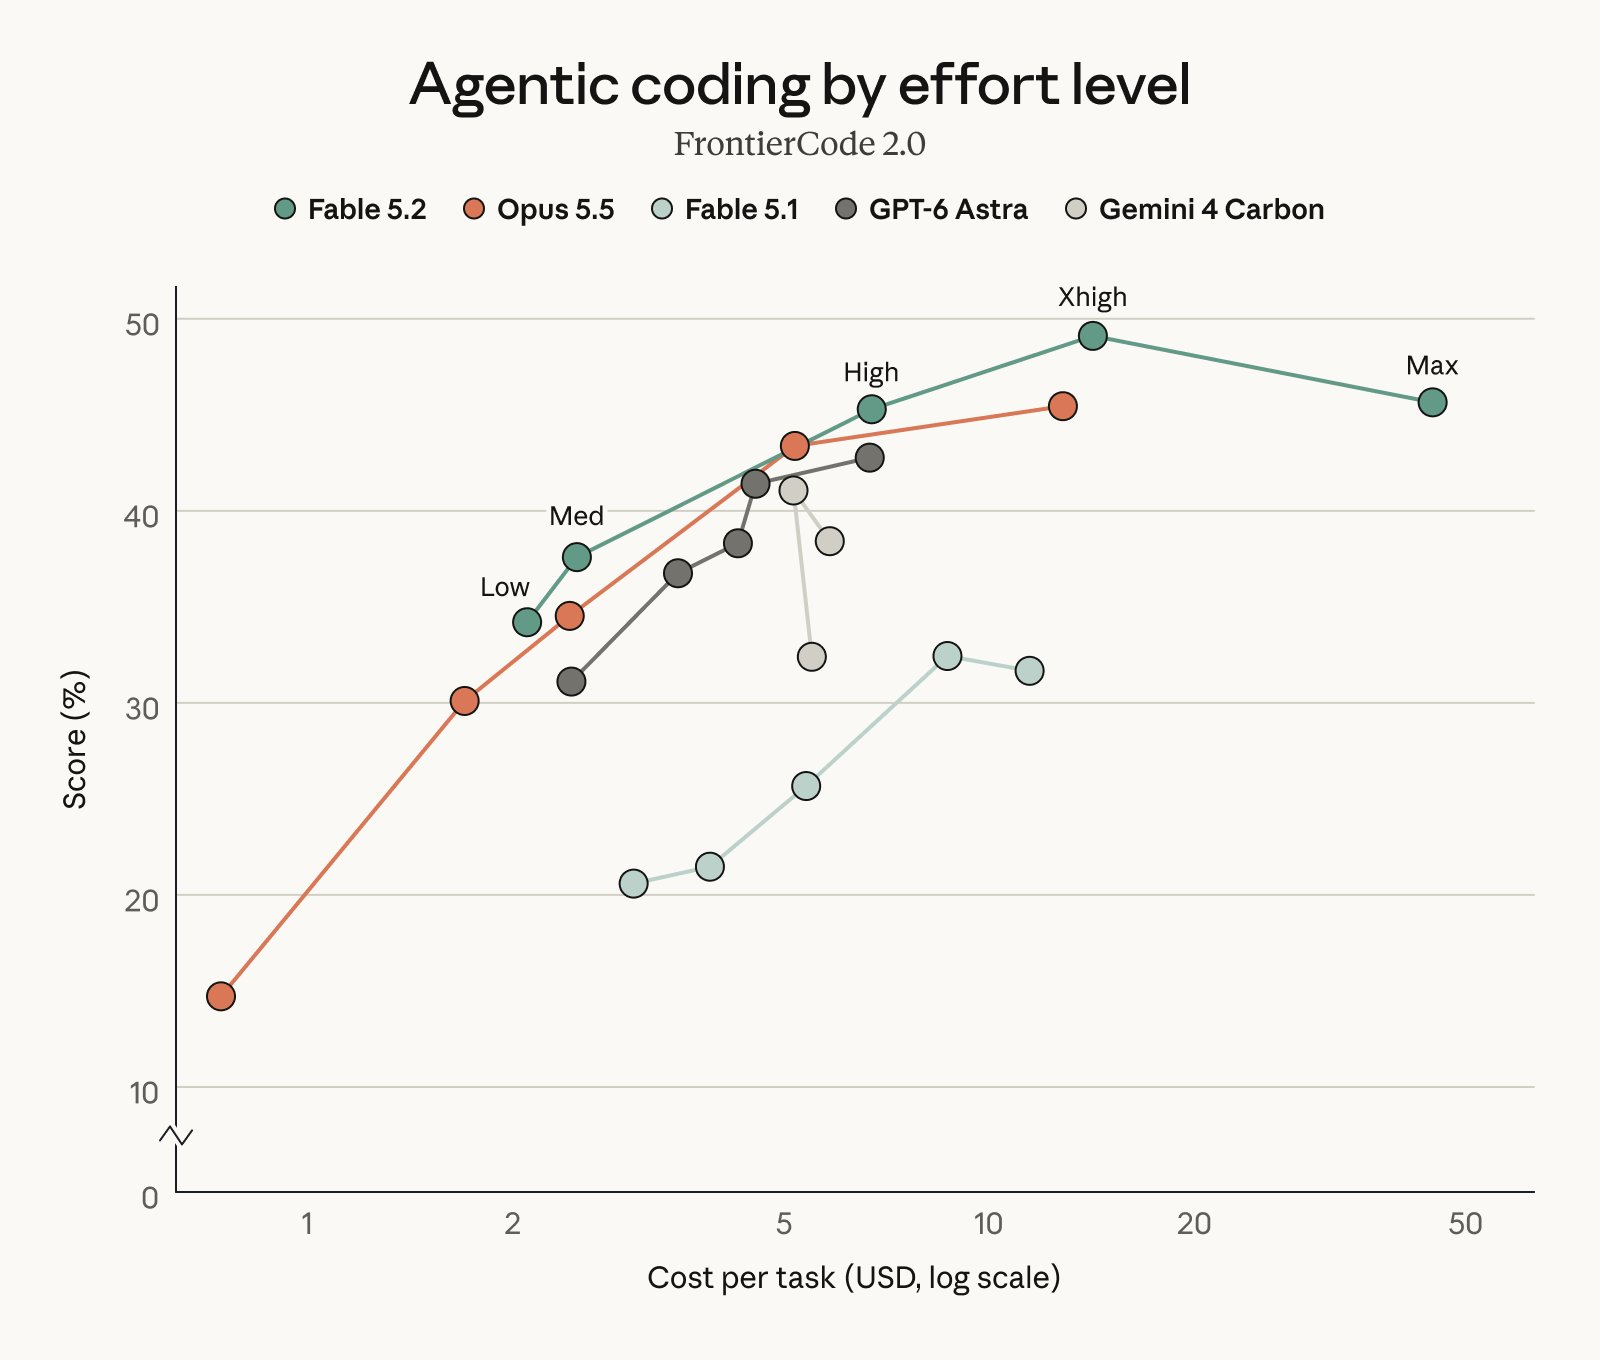
Anthropic รายงานว่า Fable 5.2 ได้คะแนนสูงกว่าในการประเมินด้านการเขียนโค้ดและการให้เหตุผลหลายรายการ สัญญาณเชิงปฏิบัติที่ชัดที่สุดคือผลลัพธ์ด้าน effort เทียบกับต้นทุน: Fable ที่ระดับ High แทบเทียบเท่า Opus ที่ระดับ Max บน FrontierCode 2.0 ด้วยต้นทุนต่องานที่ประมาณครึ่งหนึ่งในการทดสอบช่วงต้นของ Anthropic
| การประเมินที่ผู้ให้บริการรายงาน | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0, agentic coding | 49.1% ที่ระดับ Xhigh | 45.5% |
| FrontierSWE v2, agentic coding | 69.9% | 62.3% |
| WANDR, agentic search, คะแนนแบบ relaxed | 82.1% | 72.3% |
| OSWorld 2.1, ชุด offline บางส่วน | 89.3% | 87.2% |
ตัวเลขเหล่านี้มาจากประกาศดังกล่าว ซึ่งระบุว่าคะแนนใช้ระดับ effort สูงสุดที่มี เว้นแต่จะระบุไว้เป็นอย่างอื่น ตัวเลขเหล่านี้อธิบายเงื่อนไขการประเมินของ Anthropic ไม่ใช่ค่าเริ่มต้นหรืออัตราความสำเร็จที่คาดหวังกับงานของคุณ
การเปรียบเทียบด้านต้นทุนยิ่งแคบกว่านั้น Fable ที่ระดับ High ได้คะแนน 45.3% เทียบกับคะแนนสูงสุด 45.5% ของ Opus ซึ่งสนับสนุนให้ทดสอบคอนฟิกที่ถูกกว่าสำหรับการประเมินนั้น แต่ไม่ได้แปลว่า workflow ของ Fable ทุกแบบมีค่าใช้จ่ายครึ่งหนึ่งของ Opus
หลีกเลี่ยงการเปลี่ยนเปอร์เซ็นต์ใน benchmark ให้กลายเป็นการพยากรณ์ผลิตภาพ คะแนนการเขียนโค้ดไม่ได้วัดคิวรีวิวของคุณ ความเสี่ยงในการ deploy หรือเวลาที่ใช้แก้ไขการย้ายระบบที่ผิดพลาด นอกจากนี้ควรแยกผลลัพธ์ด้าน cybersecurity และ biology ที่มีเฉพาะใน Mythos ออกจากบัญชีคะแนนของ Fable ด้วย เพราะประกาศระบุว่าเป็นโมเดลพื้นฐานร่วมกัน แต่มีมาตรการป้องกันและสิทธิ์การเข้าถึงต่างกัน
ค่า effort เปลี่ยนเงื่อนไขการเปรียบเทียบ
ตั้งค่า effort อย่างชัดเจนเมื่อเปรียบเทียบโมเดล ค่าเริ่มต้นใน API คือ High สำหรับ Fable 5.2 และ Medium สำหรับ Opus 5.5 ประกาศของ Anthropic ระบุแยกต่างหากว่า Medium เป็นค่าเริ่มต้นในแอป Claude และ Claude Code ให้บันทึกทั้งผลิตภัณฑ์และค่าที่ใช้ แทนที่จะสมมติว่าค่าเริ่มต้นเดียวใช้ได้ทุกที่
เอกสารเกี่ยวกับ effort กำหนดระดับ low, medium, high, xhigh และ max สำหรับทั้งสองโมเดล ค่า effort มีผลต่อข้อความตอบกลับ อาร์กิวเมนต์ของเครื่องมือ และกระบวนการคิด เป็นสัญญาณเชิงพฤติกรรม ไม่ใช่เพดานการใช้จ่ายแบบตายตัว
เริ่มจากคอนฟิก Opus ที่ใช้งานได้จริงของคุณ ถ้ายังไม่เพียงพอ ให้เปรียบเทียบ Opus ที่ระดับ effort สูงขึ้นกับ Fable ที่ระดับ Medium หรือ High เก็บการทดลองระดับ Xhigh และ Max ไว้สำหรับงานที่การให้เหตุผลเพิ่มมีแนวโน้มให้ประโยชน์จริง และคุณยอมรับต้นทุนที่เพิ่มขึ้นได้
การเปรียบเทียบที่ effort เท่ากันตอบคำถามหนึ่ง: โมเดลเหล่านี้ทำงานอย่างไรภายใต้ระดับที่ระบุชื่อเดียวกัน ส่วนการเปรียบเทียบที่ต้นทุนเท่ากันตอบอีกคำถาม: คอนฟิกใดให้ผลลัพธ์ที่ยอมรับได้แข็งแรงที่สุดภายในงบของคุณ ทั้งสองแบบไม่สามารถทดแทนกันได้
ความหน่วง: วัดทั้งงาน
ทั้งสองโมเดลมีป้ายความหน่วงเชิงเปรียบเทียบระดับปานกลางในภาพรวมของ Anthropic ป้ายนี้ไม่ได้ชี้ผู้ชนะแบบสากล ให้วัดเวลาจนถึงผลลัพธ์ที่ผ่านการรีวิว รวมเครื่องมือและการลองซ้ำ แทนที่จะมองความเร็วในการสร้างเอาต์พุตเป็นความเร็วของ workflow การพัฒนาทั้งหมดของคุณ
Anthropic ระบุว่า Fable 5.2 สร้างเอาต์พุตเร็วขึ้นสูงสุด 30% เมื่อเทียบกับ Fable 5.1 ซึ่งเป็นการเทียบกับรุ่นก่อนหน้า ไม่ใช่ Opus 5.5 ส่วนโหมดเร็วแบบเลือกใช้ได้ให้ความเร็วในการสร้างโทเคนสูงสุด 2.5 เท่า ซึ่งก็เป็นข้ออ้างของผู้ให้บริการ ไม่ใช่การวัดเวลางานของคุณที่ลดลงจริง
งานที่ใช้เวลาส่วนใหญ่ไปกับการ compile หรือฐานข้อมูลที่ช้าจะไม่เร็วขึ้นตามสัดส่วนของการสร้างโทเคนที่เร็วขึ้น ในทางกลับกัน agent ที่หลีกเลี่ยงแนวทางที่ล้มเหลวสองครั้งอาจเสร็จเร็วกว่าแม้จะสร้างโทเคนช้ากว่า ให้ติดตามทั้งสองแง่มุมแยกจากกันก่อนจ่ายเงินซื้อความเร็วเพิ่ม
เปรียบเทียบต้นทุนต่อผลลัพธ์ที่ผ่านการตรวจรับ
ใช้ยอดใช้จ่ายรวมของ workflow หารด้วยจำนวนผลลัพธ์ที่ผ่านการตรวจรับเป็นตัวชี้วัดสำหรับการตัดสินใจ ราคาโทเคนกำหนดอัตรา แต่ปริมาณโทเคน การใช้ cache ความพยายามที่ล้มเหลว เครื่องมือ และการรีวิว คือสิ่งที่กำหนดว่าคุณได้อะไรมา ตัวเลขคณิตศาสตร์ต่อไปนี้เป็นเพียงตัวอย่างประกอบ ไม่ใช่การวัดพฤติกรรมของโมเดลใดโมเดลหนึ่ง
สมมติว่าหนึ่ง request ใช้โทเคนอินพุตที่ไม่ได้ cache 100,000 โทเคน และโทเคนเอาต์พุต 10,000 โทเคน โดยใช้การ route สากลแบบมาตรฐานและไม่มีค่าใช้จ่ายเครื่องมือเพิ่มเติม:
| คอนฟิก | ค่าอินพุต | ค่าเอาต์พุต | รวม |
|---|---|---|---|
| Opus 5.5 มาตรฐาน | $0.40 | $0.20 | $0.60 |
| Fable 5.2 มาตรฐาน | $0.80 | $0.40 | $1.20 |
| Opus 5.5 โหมดเร็ว | $0.80 | $0.40 | $1.20 |
| Fable 5.2 โหมดเร็ว | $1.60 | $0.80 | $2.40 |
อัตราค่าใช้จ่ายตรวจสอบจากเอกสารราคาของ Anthropic เมื่อวันที่ 10 พฤศจิกายน 2026 สิทธิ์การใช้งานแบบ subscription แยกจากอัตรา API เหล่านี้ ผู้ให้บริการคลาวด์ การใช้ cache ตัวเลือกการเก็บข้อมูลในประเทศ และฟีเจอร์อื่นๆ สามารถเปลี่ยนยอดบิลได้
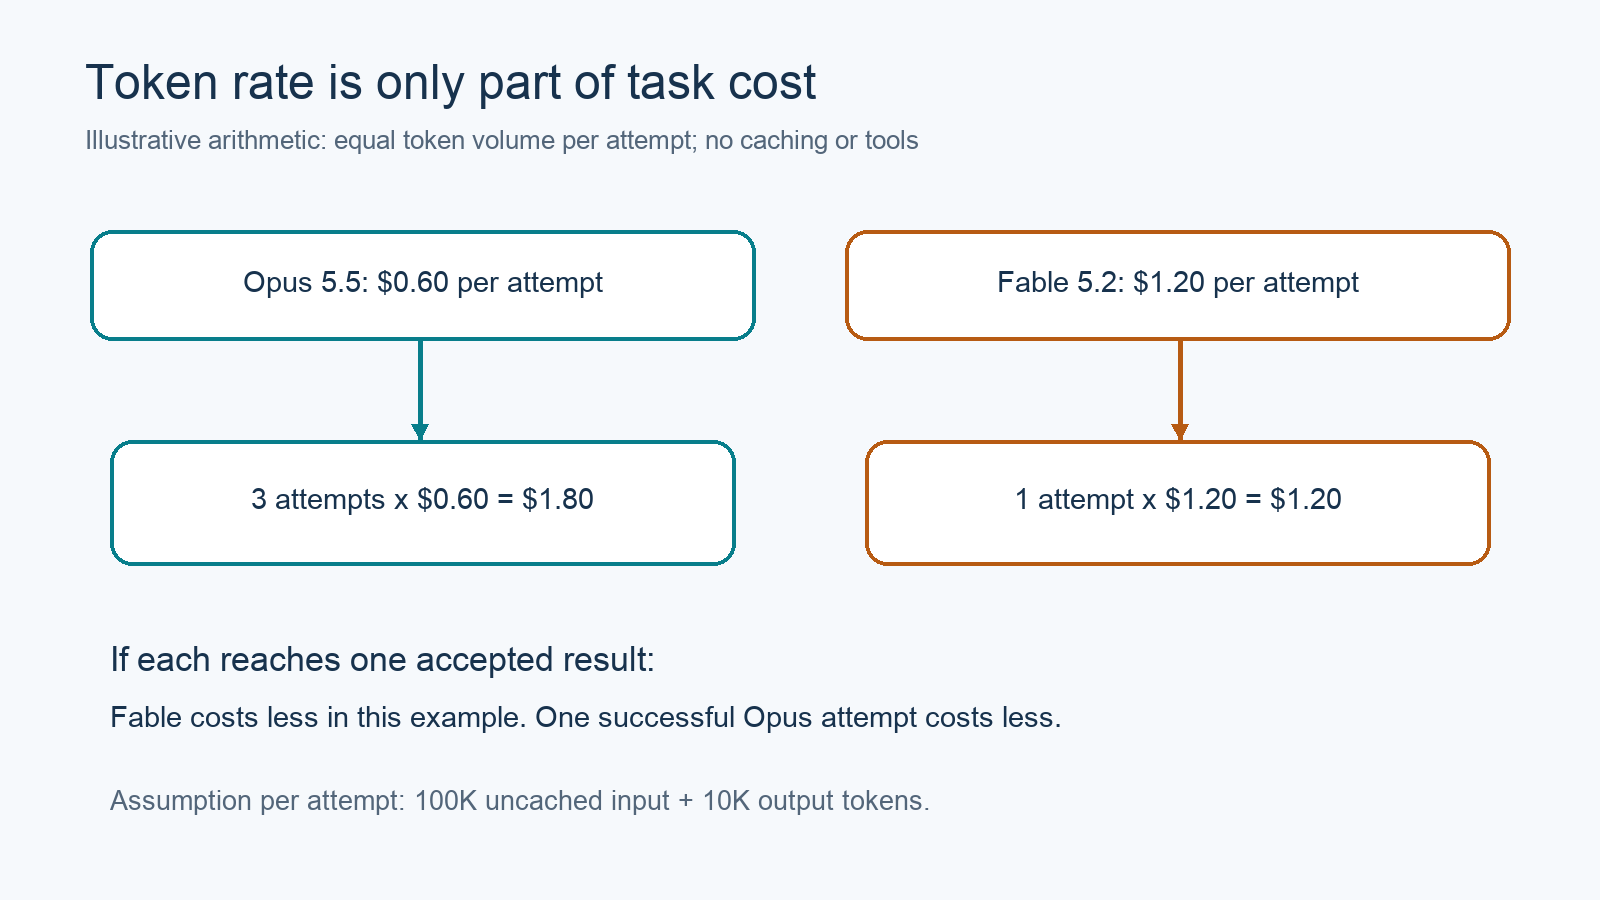
เปรียบเทียบทุกความพยายามที่ต้องใช้จนได้ผลลัพธ์สำเร็จ รวมถึงการลองซ้ำและการรีวิว
ในตัวอย่างง่ายๆ นี้ ความพยายามของ Opus สามครั้งที่ปริมาณเท่ากันมีค่าใช้จ่าย $1.80 ขณะที่ Fable หนึ่งครั้งใช้ $1.20 ซึ่งทำให้ Fable ถูกกว่าก็ต่อเมื่อได้ผลลัพธ์ที่ผ่านการตรวจรับภายในความพยายามเดียวนั้น หาก Opus สำเร็จในครั้งเดียว ก็ยังถูกกว่าอยู่ดี การ retry จริงมักใช้ปริมาณไม่เท่ากัน จึงควรใช้ข้อมูลการใช้งานที่บันทึกไว้ แทนการคูณค่าเฉลี่ยที่เดาเอา
ให้นับเวลาทีมวิศวกรรมใช้รีวิวควบคู่กับค่าใช้จ่าย API ด้วย patch ที่ผ่านเทสต์แต่ต้องแก้ไขเพิ่มอย่างมาก ไม่ได้อยู่ในระดับเดียวกับ patch ที่พร้อมรีวิวทันที
ให้ coding agent ของคุณตรวจสอบ API ด้วย Apidog CLI
ใช้ Apidog CLI ให้ coding agent ของคุณสร้างและรันการตรวจสอบ API ที่ทำซ้ำได้ การตรวจสอบเหล่านี้ช่วยเปิดเผยความเสียหายด้าน request หรือ response เมื่อคุณเปลี่ยนโมเดล แต่ไม่ได้ยืนยันว่าการแก้ไข repository ของ agent ถูกต้องหรือไม่ ควรใช้เทสต์ระดับ repository และการรีวิวโดยมนุษย์ควบคู่ไปด้วย
ตั้งค่า CLI ก่อน แล้วให้ agent ของคุณอ่านคู่มือการติดตั้งอย่างเป็นทางการ:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
ให้ Claude Code หรือ agent ที่คุณใช้พร้อมต์นี้:
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
Agent จะตรวจสอบ schema เลือกหมวดหมู่ test case ที่ถูกต้อง สร้าง case.json แล้วรันคำสั่งลักษณะนี้ โดย flags เหล่านี้ตรวจสอบจาก help ของ CLI 2.2.12 ที่ติดตั้งไว้:
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
แทนที่ placeholder ด้วยทรัพยากรโปรเจกต์ของคุณ นี่คือเทมเพลต workflow ไม่ใช่การเปรียบเทียบโมเดลที่รันจริง ดูการตั้งค่า agent เพิ่มเติมได้จากคู่มือ Apidog CLI ใน Claude Code หรือคู่มือการเชื่อมต่อ Codex
คำถามที่พบบ่อย
Fable 5.2 เก่งกว่า Opus 5.5 ในทุกงานเขียนโค้ดหรือไม่?
ไม่ Anthropic แนะนำ Opus 5.5 สำหรับงานเขียนโค้ดและงานด้านความรู้ส่วนใหญ่ Fable น่าทดลองใช้เมื่องานที่ยากเกินความสามารถพื้นฐานนั้น คะแนน benchmark จากผู้ให้บริการที่สูงกว่าไม่รับประกันผลลัพธ์ที่ดีกว่าในทุกงาน
Fable 5.2 แพงเป็นสองเท่าหรือไม่?
อัตราโทเคนอินพุตและเอาต์พุตมาตรฐานแพงเป็นสองเท่าของ Opus 5.5 แต่ต้นทุนรวมต่องานอาจต่างกัน เพราะแต่ละคอนฟิกใช้โทเคนไม่เท่ากันและต้องใช้จำนวนความพยายามไม่เท่ากัน
ควรใช้ effort สูงสุดเสมอหรือไม่?
ไม่ ให้เปรียบเทียบการตั้งค่ากับเกณฑ์การตรวจรับและงบประมาณของคุณ Effort ที่สูงขึ้นอนุญาตให้ใช้โทเคนมากขึ้น แต่ไม่รับประกันว่าจะดีขึ้นอย่างมีประโยชน์สำหรับงานที่มีขอบเขตชัดเจน
Fable 5.2 เร็วกว่า Opus 5.5 หรือไม่?
แหล่งข้อมูลที่นำมาตรวจสอบในบทความนี้ไม่ได้ชี้ผู้ชนะด้านความหน่วงแบบตัวต่อตัวอย่างสากล ทั้งสองมีป้ายความหน่วงระดับปานกลาง ให้วัด workflow จริงของคุณ และมองโหมดเร็วเป็นคอนฟิกแยกต่างหาก
Apidog ช่วยตัดสินได้ไหมว่าโมเดลใดเขียนโค้ดได้ดีกว่า?
Apidog CLI ช่วยให้ agent ของคุณรันการตรวจสอบ API และเก็บหลักฐานด้าน response ได้ แต่คุณภาพโค้ดยังต้องอาศัยเทสต์ระดับ repository และการรีวิว ใช้ผลลัพธ์ที่ผ่านการตรวจรับเหล่านี้ตัดสินว่าโมเดลและระดับ effort ใดคุ้มค่ากับต้นทุน