Claude Fable 5.1 มีราคา $10 และ $50 ต่อหนึ่งล้านโทเค็น Claude Opus 5 มีราคา $5 และ $25 เอกสารของ Anthropic เองแนะนำให้คุณเริ่มต้นด้วย Opus 5 และย้ายไปใช้ Fable 5.1 ก็ต่อเมื่อ "การประเมินของคุณบน Claude Opus 5 ที่ความพยายามสูงขึ้นยังคงล้มเหลว" นั่นคือกฎที่สามารถทดสอบได้ และการเปรียบเทียบนี้สร้างขึ้นจากกฎดังกล่าว: ในจุดที่ตัวเลขของ Anthropic แสดงให้เห็นว่า Fable 5.1 เหนือกว่า Opus 5 อย่างชัดเจน, ในจุดที่แสดงให้เห็นถึงข้อจำกัดบางประการที่การปรับแต่งพร้อมท์สามารถแก้ไขได้, และในจุดที่การคำนวณราคาเริ่มน่าสนใจ เนื่องจากอัตราการอ่านแคชของ Fable 5.1 เป็นเพียงครึ่งหนึ่งของ Opus 5
แหล่งข้อมูลคือ โพสต์เปิดตัว ของ Anthropic, หน้าโมเดล Fable 5.1 และ หน้าข้อมูลราคา สำหรับภาพรวมของแต่ละโมเดล โปรดดู Claude Fable 5.1 คืออะไร และ Claude Opus 5 คืออะไร
เปรียบเทียบเคียงข้างกัน
| Claude Fable 5.1 | Claude Opus 5 | |
|---|---|---|
| รหัสโมเดล | claude-fable-5-1 |
claude-opus-5 |
| วันที่เผยแพร่ | 1 กันยายน 2026 | 24 กรกฎาคม 2026 |
| การวางตำแหน่ง | การใช้เหตุผลที่ซับซ้อนและงานของเอเจนต์ที่มีขอบเขตยาว | การเขียนโค้ดของเอเจนต์ที่ซับซ้อนและงานระดับองค์กร; เป็นค่าเริ่มต้นที่แนะนำ |
| อินพุต / เอาต์พุต | $10 / $50 | $5 / $25 |
| การอ่านแคช | $0.25 | $0.50 |
| การเขียนแคช (5 นาที / 1 ชั่วโมง) | $12.50 / $20 | $6.25 / $10 |
| แบตช์ | $5 / $25 | $2.50 / $12.50 |
| โหมดเร็ว | ไม่มี | มี ($10 / $50) |
| ระดับความสำคัญ | ไม่มี | ไม่มี |
| บริบท / เอาต์พุตสูงสุด | 1 ล้าน / 128K | 1 ล้าน / 128K (300K ในโหมดแบตช์พร้อมเบต้า) |
| ข้อมูลที่ใช้ในการฝึก (Knowledge cutoff) | มิถุนายน 2026 | พฤษภาคม 2026 |
| ความหน่วงเวลาเปรียบเทียบ | ช้ากว่า | ปานกลาง |
| การคิด | เปิดตลอดเวลา; disabled คืนค่า 400 |
เปิดโดยค่าเริ่มต้น; อนุญาตให้ disabled ที่ระดับ high หรือต่ำกว่า |
การบังคับเลือกเครื่องมือ (tool_choice) |
400 | ยอมรับ |
| ตัวจำแนกความปลอดภัย | ไซเบอร์, ชีวภาพ, LLM ขั้นสูง, การสกัดเหตุผล, อันตรายทั่วไป | เฉพาะไซเบอร์เท่านั้น |
| การไม่เก็บข้อมูล | ไม่สามารถใช้งานได้หากไม่ได้รับอนุญาต | ใช้งานได้ |
| ความพยายามต่อข้อความ (เบต้า) | มี | มี |
| การตรวจสอบการแก้ไขประวัติ | มี | ไม่มี |
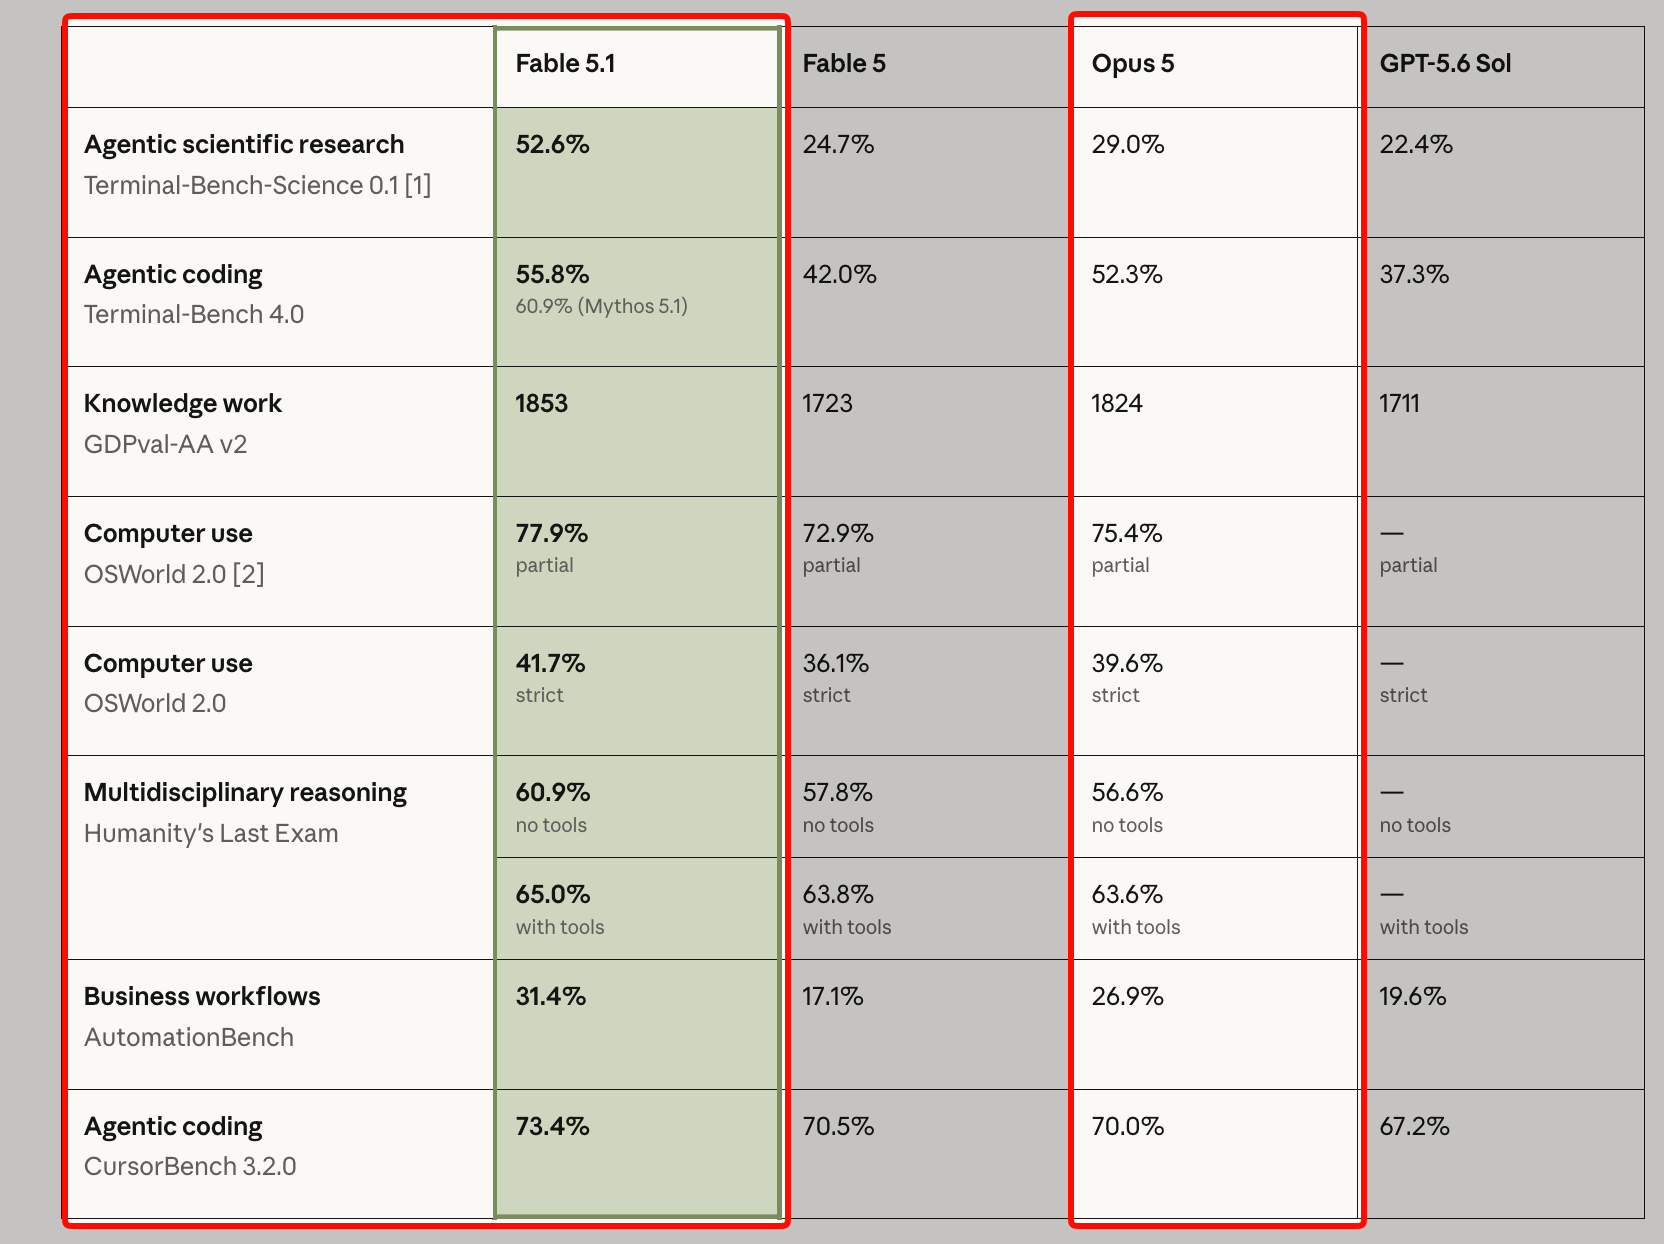
ผลการทดสอบเกณฑ์มาตรฐานกล่าวไว้ว่า
ตัวเลขทั้งหมดมาจาก Anthropic ซึ่งรันโดย Anthropic โดยยังไม่มีการทำซ้ำที่เป็นอิสระ
| เกณฑ์มาตรฐาน | Fable 5.1 | Opus 5 | ส่วนต่าง |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | +23.6 |
| AutomationBench | 31.4% | 26.9% | +4.5 |
| Humanity’s Last Exam (ไม่มีเครื่องมือ) | 60.9% | 56.6% | +4.3 |
| Terminal-Bench 4.0 | 55.8% | 52.3% | +3.5 |
| CursorBench 3.2.0 | 73.4% | 70.0% | +3.4 |
| OSWorld 2.0 (บางส่วน) | 77.9% | 75.4% | +2.5 |
| OSWorld 2.0 (เข้มงวด) | 41.7% | 39.6% | +2.1 |
| Humanity’s Last Exam (พร้อมเครื่องมือ) | 65.0% | 63.6% | +1.4 |
| GDPval-AA v2 | 1853 | 1824 | +29 Elo |
อ่านตารางนี้เป็นสองเรื่องราว: ใน Terminal-Bench-Science, Fable 5.1 ทำคะแนนได้เกือบสองเท่าของ Opus 5 และนั่นคือเกณฑ์มาตรฐานการวิจัยระยะยาวที่เน้นการใช้เครื่องมือหนัก ซึ่งโมเดลจะรันการทดลองในเทอร์มินัลเป็นเวลานาน สำหรับเกณฑ์มาตรฐานอื่นๆ ส่วนต่างอยู่ระหว่างหนึ่งถึงห้าคะแนน ส่วนต่างห้าคะแนนใน AutomationBench ถือว่ามีความหมาย แต่ส่วนต่าง 1.4 คะแนนใน Humanity’s Last Exam พร้อมเครื่องมือ หรือ 29 Elo ใน GDPval อยู่ในช่วงที่พร้อมท์และการตั้งค่าความพยายามของคุณมีผลต่อผลลัพธ์มากกว่าการเลือกโมเดลเสียอีก
ข้อมูลอีกประการที่ควรพิจารณา: Opus 5 เปิดตัวในเดือนกรกฎาคมด้วยคะแนน 52.3% ใน Terminal-Bench 4.0 ซึ่งนำหน้า Fable 5 ที่ทำได้ 42.0% Fable 5.1 กลับมาเป็นผู้นำด้วยคะแนน 55.8% แต่มีส่วนต่างเพียง 3.5 คะแนน ไม่ใช่ 13.8 ข้อได้เปรียบของรุ่น Fable เมื่อเทียบกับรุ่น Opus ในการเขียนโค้ดแบบเอเจนต์นั้นเป็นของจริงและแคบลงกว่าเมื่อเดือนมิถุนายน การเปรียบเทียบ Opus 5 กับ Fable 5 ได้บันทึกสถานะก่อนหน้านั้นของการแข่งขันนี้ไว้
การคำนวณราคาไม่ใช่แค่ 2 เท่า
เมื่อไม่มีการแคช Fable 5.1 มีราคาเป็นสองเท่าของ Opus 5 ในทุกรายการ แต่การอ่านแคชกลับกัน: $0.25 สำหรับ Fable 5.1 เทียบกับ $0.50 สำหรับ Opus 5 ดังนั้นตัวคูณที่มีประสิทธิภาพจึงขึ้นอยู่กับว่าอินพุตของคุณมีส่วนนำหน้าที่แคชไว้มากน้อยเพียงใด
พิจารณารอบการทำงานของเอเจนต์ที่มีโทเค็นที่แคชไว้ 150,000 โทเค็น, โทเค็นอินพุตที่ไม่ได้แคช 1,000 โทเค็น, และโทเค็นเอาต์พุต 800 โทเค็น Opus 5: 5(0.001) + 0.5(0.15) + 25(0.0008) = $0.005 + $0.075 + $0.02 = $0.10 Fable 5.1: 10(0.001) + 0.25(0.15) + 50(0.0008) = $0.01 + $0.0375 + $0.04 = $0.0875 ในรอบนั้น Fable 5.1 มีราคาถูกกว่า
ตอนนี้มาดูการตรวจสอบโค้ดที่มีโทเค็นอินพุตที่ไม่ได้แคช 30,000 โทเค็น และโทเค็นเอาต์พุต 4,000 โทเค็น Opus 5: $0.15 + $0.10 = $0.25 Fable 5.1: $0.30 + $0.20 = $0.50 ซึ่งเป็นสองเท่าพอดี
จุดคุ้มทุน: ค่าใช้จ่ายต่อรอบของ Fable 5.1 จะต่ำกว่า Opus 5 เมื่อโทเค็นอินพุตที่แคชไว้เกินประมาณ 20 เท่าของผลรวมของโทเค็นอินพุตที่ไม่ได้แคชและ 5 เท่าของโทเค็นเอาต์พุต สำหรับลูปเอเจนต์ที่เน้นส่วนนำหน้า เงื่อนไขนี้มักจะเกิดขึ้นบ่อยครั้ง สำหรับงานที่เน้นเอาต์พุตอย่างหนัก มันจะไม่เกิดขึ้นเลย การเขียนแคชก็เป็นสองเท่าใน Fable 5.1 ดังนั้นเซสชันที่รีเซ็ตแคชบ่อยครั้งจะเสียเปรียบไป รายละเอียดราคา Fable 5.1 และ รายละเอียดราคา Opus 5 มีตารางฉบับเต็มให้ดู
Opus 5 เหนือกว่าอย่างชัดเจนในด้านใดบ้าง
ทุกสิ่งที่คุณสามารถรันได้โดยปิดการคิด Opus 5 ยอมรับ thinking: {"type": "disabled"} ที่ระดับความพยายาม high หรือต่ำกว่า Fable 5.1 ไม่เคยยอมรับ สำหรับงานจำแนกประเภท, การสกัดข้อมูล และเส้นทางคำตอบสั้นๆ, Opus 5 ที่ปิดการคิด (หรือที่ระดับความพยายาม low) จะทั้งถูกกว่าและเร็วกว่า
โหมดเร็ว Opus 5 มีโหมดเร็วสำหรับพรีวิวการวิจัยที่ความเร็วเอาต์พุตสูงสุด 2.5 เท่าในราคา $10 และ $50 Fable 5.1 ไม่มีสิ่งที่เทียบเท่า ถ้าเวลาในการตอบสนองสำคัญกว่าคะแนนเกณฑ์มาตรฐานเล็กน้อย นี่คือจุดชี้ขาด
ความหน่วงเวลาโดยทั่วไป Anthropic ระบุว่า Fable 5.1 "ช้ากว่า" และ Opus 5 "ปานกลาง" รอบการทำงานเดียวของ Fable 5.1 ในงานยากที่ความพยายามสูงอาจใช้เวลาหลายนาที
การไม่เก็บข้อมูล Opus 5 มีให้ใช้งานภายใต้ ZDR Fable 5.1 เป็น Covered Model และจะคืนค่า 400 เว้นแต่ Anthropic จะอนุญาตการเข้าถึง ZDR อย่างชัดแจ้ง
การปฏิเสธน้อยลง Opus 5 ใช้ตัวจำแนกเฉพาะทางไซเบอร์เท่านั้น Fable 5.1 ใช้ชุด Fable เต็มรูปแบบ ได้แก่ ไซเบอร์, ชีวภาพ, การพัฒนา LLM ขั้นสูง, การสกัดเหตุผล และอันตรายทั่วไป งานด้านวิทยาศาสตร์ชีวภาพที่ไม่เป็นอันตราย หรืองาน ML ที่ไม่เคยกระตุ้น Opus 5 อาจกระตุ้น Fable 5.1 และเมื่อเป็นเช่นนั้น เป้าหมายสำรองก็คือ Opus 5 อยู่ดี
การบังคับใช้เครื่องมือ Opus 5 ยังคงยอมรับ tool_choice ทั้งแบบ any และ tool Fable 5.1 จะคืนค่า 400 หากการรวมระบบของคุณพึ่งพาการเรียกใช้แบบบังคับ Opus 5 จะช่วยให้คุณไม่ต้องเขียนโค้ดใหม่
ไม่มีการตรวจสอบการแก้ไขประวัติ Opus 5 ไม่สนใจว่าคุณจะแก้ไขรอบการทำงานก่อนหน้าหรือไม่ Fable 5.1 จะทำให้บล็อกการคิดในภายหลังไม่ถูกต้องเมื่อคุณทำเช่นนั้น ระบบที่บีบอัดข้อมูลฝั่งไคลเอ็นต์หรือแทรกการแจ้งเตือนในแต่ละรอบการทำงานกับ Opus 5 ได้ในปัจจุบัน และจำเป็นต้องมีการตรวจสอบก่อนที่จะใช้กับ Fable 5.1
Fable 5.1 เหนือกว่าอย่างชัดเจนในด้านใดบ้าง
การวิจัยระยะยาวและเอเจนต์เทอร์มินัล ผลลัพธ์ Terminal-Bench-Science ที่ 52.6% เทียบกับ 29.0% คือส่วนต่างที่ใหญ่ที่สุดในตารางของ Anthropic หากเอเจนต์ของคุณทำการทดลอง, ทำการวิจัยเว็บหลายขั้นตอน หรือทำงานเป็นเวลาหลายชั่วโมง นี่คืองานที่โมเดลนี้ถูกสร้างขึ้นมาเพื่อรองรับ
การทำงานอัตโนมัติของกระบวนการทางธุรกิจ 31.4% เทียบกับ 26.9% ใน AutomationBench คือส่วนต่างที่สำคัญในเกณฑ์มาตรฐานที่จำลองงานแบบครบวงจรในแอปพลิเคชันต่างๆ
เอเจนต์ที่เน้นส่วนนำหน้าที่แคชไว้ อธิบายไว้ข้างต้น: การอ่านแคชราคา $0.25 ทำให้ Fable 5.1 มีราคาถูกกว่าต่อรอบในลูปที่ครอบงำด้วยส่วนนำหน้า
ข้อมูลที่ใช้ในการฝึก (Knowledge cutoff) มิถุนายน 2026 เทียบกับพฤษภาคม 2026 ห่างกันหนึ่งเดือน แต่นั่นคือข้อมูลที่ใหม่ที่สุดในบรรดาโมเดล Claude ทั้งหมด
การมองเห็นในเอกสารที่มีข้อมูลหนาแน่น Anthropic ระบุว่า Fable 5.1 มีการอ่านแผนภูมิ, เอกสารยื่น, และตารางที่ซ้อนอยู่ในไฟล์ PDF ได้ดีขึ้น โดยเฉพาะอย่างยิ่งกับเครื่องมือครอบตัดและซูม ซึ่งเป็นจุดที่ Fable 5.1 ได้เปรียบ Opus 5 ไม่ได้ถูกเปรียบเทียบในเกณฑ์มาตรฐานการมองเห็นที่เผยแพร่ ดังนั้นถือว่านี่เป็นการอ้างสิทธิ์ที่ต้องทดสอบ
เมื่อ Opus 5 ที่ระดับ xhigh ล้มเหลว นี่คือกฎของ Anthropic และเป็นกฎที่ถูกต้อง หากงานล้มเหลวในการประเมินของคุณบน Opus 5 ที่ระดับ xhigh ให้ลองใช้ Fable 5.1 ที่ระดับ high ก่อนที่คุณจะลองสิ่งอื่นใด
ระดับความพยายามเปลี่ยนการเปรียบเทียบ
ทั้งสองโมเดลมีระดับความพยายามห้าระดับ และ Anthropic กล่าวอ้างที่เจาะจงเกี่ยวกับ Fable 5.1 ในระดับต่ำสุด: ที่ระดับความพยายาม low มักจะ "สามารถแข่งขันได้กับโมเดล Claude Opus และ Claude Sonnet ในด้านค่าใช้จ่ายต่อภารกิจในขณะที่ได้คะแนนสูงกว่า" นั่นเป็นการปรับเปลี่ยนมุมมองในการเลือก แทนที่จะเป็นการเปรียบเทียบ Opus 5 ที่ระดับ high เทียบกับ Fable 5.1 ที่ระดับ high, การเปรียบเทียบที่เป็นธรรมสำหรับงานประจำอาจเป็นการเปรียบเทียบ Opus 5 ที่ระดับ high เทียบกับ Fable 5.1 ที่ระดับ low หรือ medium จำนวนโทเค็นเอาต์พุตที่ความพยายามต่ำกว่าจะน้อยลง ซึ่งช่วยชดเชยราคาต่อโทเค็นที่สูงเป็น 2 เท่า
ในทางกลับกันก็เป็นจริง ข้อได้เปรียบของ Fable 5.1 เหนือ Fable 5 นั้นใหญ่ที่สุดที่ระดับ xhigh และ max ซึ่งหมายความว่าขีดความสามารถสูงสุดที่เหนือกว่า Opus 5 นั้นจะสูงสุดที่ระดับความพยายามที่ใช้เวลามากที่สุดด้วยเช่นกัน ทดสอบทั้งสองโมเดลด้วยระดับความพยายามต่างๆ ในการประเมินของคุณเองก่อนที่จะสรุปอะไรจากตารางเปิดตัว คู่มือความพยายามของ Opus 5 ครอบคลุมทั้งห้าระดับ; ความหมายเหมือนกันกับ Fable 5.1
กรอบการตัดสินใจ
- เริ่มต้นด้วย Opus 5 ที่ระดับ
highนี่คือคำแนะนำเริ่มต้นของ Anthropic, ราคาถูกกว่าครึ่งหนึ่ง, ตัวจำแนกน้อยกว่า, มี ZDR ให้ใช้งาน - เพิ่ม Opus 5 เป็น
xhighสำหรับงานที่ล้มเหลว ถูกกว่าการเปลี่ยนโมเดล - ย้ายงานที่ยังคงล้มเหลวไปที่ Fable 5.1 ที่ระดับ
highทำต่อเส้นทาง ไม่ใช่ทั่วโลก เก็บ Opus 5 ไว้กับทุกอย่างที่ผ่าน - ตรวจสอบโปรไฟล์แคชของสิ่งที่คุณย้าย หากเป็นลูปที่เน้นส่วนนำหน้า Fable 5.1 อาจมีราคาถูกกว่าต่อรอบมากกว่า Opus 5
- ตรวจสอบระบบก่อนขั้นตอนที่ 3 การบังคับเลือกเครื่องมือ (
tool_choice) และการแก้ไขประวัติทั้งสองอย่างจะใช้งานไม่ได้บน Fable 5.1 คู่มือการย้ายระบบ มีรายการตรวจสอบให้
การเรียกใช้การเปรียบเทียบใน Apidog
สร้างคอลเลกชันหนึ่งด้วยพร้อมท์ที่ใช้ในการผลิตของคุณและกำหนด model เป็นตัวแปรสภาพแวดล้อม รันกับ claude-opus-5 ที่ระดับ high, อีกครั้งที่ระดับ xhigh, จากนั้นรันกับ claude-fable-5-1 ที่ระดับ high และ low สำหรับการรันแต่ละครั้ง ให้บันทึกคำตอบ, usage.output_tokens, และ usage.cache_read_input_tokens ในการส่งซ้ำ คูณด้วยอัตราของแต่ละโมเดลในสคริปต์หลังการตอบสนอง แล้วคุณก็จะได้ค่าใช้จ่ายต่อภารกิจต่อโมเดลต่อระดับความพยายามในตารางเดียว Apidog เก็บทุกการรันเป็นประวัติ ดังนั้นการเปรียบเทียบจะยังคงใช้งานได้เมื่อมีการเปิดตัวโมเดลถัดไป ดาวน์โหลด Apidog เพื่อตั้งค่า
คำถามที่พบบ่อย
Claude Fable 5.1 ดีกว่า Opus 5 หรือไม่? ในทุกเกณฑ์มาตรฐานที่ Anthropic เผยแพร่ คำตอบคือ "ใช่" โดยมีส่วนต่างตั้งแต่ 1.4 คะแนนถึง 23.6 คะแนน ส่วนต่างที่ใหญ่ที่สุดอยู่ใน Terminal-Bench-Science; ส่วนใหญ่แล้วส่วนต่างอื่นๆ อยู่ต่ำกว่าห้าคะแนน นี่คือผลลัพธ์ที่จัดทำโดยผู้ขาย
Fable 5.1 คุ้มค่ากับราคาที่แพงกว่า Opus 5 สองเท่าหรือไม่? สำหรับการวิจัยระยะยาวและเอเจนต์เทอร์มินัล, การทำงานอัตโนมัติของธุรกิจ, และลูปเอเจนต์ที่เน้นส่วนนำหน้า (ซึ่งการอ่านแคชที่ถูกกว่าสามารถทำให้มีค่าใช้จ่ายต่อรอบน้อยลง) มักจะคุ้มค่า สำหรับงานที่เน้นเอาต์พุต, มีความอ่อนไหวต่อความหน่วงเวลา, หรืองานจำแนกประเภท จะไม่คุ้มค่า กฎของ Anthropic เองคือ: ย้ายขึ้นไปก็ต่อเมื่อ Opus 5 ที่ระดับความพยายามสูงขึ้นไม่ผ่านการประเมินของคุณเท่านั้น
Fable 5.1 หรือ Opus 5 ตัวไหนเร็วกว่ากัน? Opus 5 Anthropic ระบุว่ามีความหน่วงเวลา "ปานกลาง" เทียบกับ "ช้ากว่า" สำหรับ Fable 5.1 และ Opus 5 มีโหมดเร็วที่ความเร็วเอาต์พุตสูงสุด 2.5 เท่า Fable 5.1 ไม่มี
Opus 5 มีตัวจำแนกความปลอดภัยเหมือน Fable 5.1 หรือไม่? ไม่ Opus 5 ใช้ตัวจำแนกเฉพาะทางไซเบอร์เท่านั้น Fable 5.1 เพิ่มชีวภาพ, LLM ขั้นสูง, การสกัดเหตุผล และอันตรายทั่วไป เมื่อ Fable 5.1 ปฏิเสธ, Opus 5 เป็นหนึ่งในสองเป้าหมายสำรองที่อนุญาต
ฉันสามารถใช้ Fable 5.1 ภายใต้การไม่เก็บข้อมูลเช่นเดียวกับ Opus 5 ได้หรือไม่? ไม่ได้ Fable 5.1 ต้องการการเก็บข้อมูล 30 วัน และเป็น Covered Model Opus 5 มีให้ใช้งานภายใต้ ZDR
การสนทนาสามารถย้ายระหว่าง Opus 5 และ Fable 5.1 ได้หรือไม่? ย้ายขึ้น ได้: Fable 5.1 สามารถอ่านบล็อกการคิดของ Opus 5 ได้ ย้ายลง API จะทิ้งบล็อกการคิดของ Fable 5.1 ก่อนที่ Opus 5 จะเห็น (โดยไม่เรียกเก็บเงิน) และ Opus 5 จะวางแผนรอบนั้นใหม่