
Cerebras ขายเพียงตัวเลขเดียว คือ ความเร็ว จุดขายคือชิปแบบ wafer-scale ของบริษัทผลักโทเคนออกมาได้เร็วกว่าที่คลัสเตอร์ GPU จะทำได้ และระดับฟรีก็เป็นวิธีที่บริษัทใช้ทำให้คุณสังเกตเห็นมัน แต่คำว่า "เร็ว" ไม่ใช่สิ่งที่คุณควรเชื่อตามคำบอกเล่าของผู้ขาย มันคือสิ่งที่คุณต้องวัดเอง บนการเชื่อมต่อของคุณเอง ด้วยพรอมป์ของคุณเอง แล้วเก็บไว้เป็นบันทึกที่คุณรันซ้ำได้ทุกครั้งที่ Cerebras ปล่อยโมเดลใหม่หรือเปลี่ยนลิมิต
คู่มือนี้จะวัดค่านั้นไปพร้อมกับคุณ คุณจะได้ API key ของ Cerebras เรียก chat completion จริงไปยังเอนด์พอยต์ที่เข้ากันได้กับ OpenAI จับเวลาของโทเคนแรกและเวลาของคำตอบทั้งหมด และให้ coding agent ของคุณเปลี่ยนคำขอทั้งหมดให้เป็นเทสต์ผ่าน CLI ของ Apidog เพื่อให้มันอยู่รอดผ่านการสลับโมเดลครั้งถัดไป
สรุปสั้น ๆ
Cerebras มอบระดับ Free Trial ให้บัญชีใหม่: เครดิตมูลค่า $5 ที่หมดอายุ 30 วันหลังจากได้รับ จำกัดขอบเขตไว้ที่สองโมเดล (gpt-oss-120b และ qwen-3.8-27b) ที่ 5 คำขอต่อนาที และ 30K โทเคนที่ยังไม่ถูกแคชต่อนาทีต่อโมเดล ตามลิมิตอัตราการใช้งานที่ Cerebras เผยแพร่ API นี้เข้ากันได้กับ OpenAI ที่ https://api.cerebras.ai/v1 ดังนั้นคุณสามารถชี้ไคลเอนต์ OpenAI ที่มีอยู่ไปที่มันได้โดยแก้แค่สามบรรทัด ด้านล่างนี้ คุณจะสร้างคำขอที่วัดเวลาไปถึงโทเคนแรกและจำนวนโทเคนต่อวินาทีด้วยตัวเอง แทนที่จะเชื่อหน้าเพจการตลาด
ระดับฟรีเอกสารอะไรไว้บ้าง และไม่อะไรบ้าง
หน้าเพจราคาของ Cerebras เรนเดอร์ตัวเลขฝั่งไคลเอนต์ ซึ่งหมายความว่าอัตราค่าบริการต่อล้านโทเคนแบบเจาะจงสำหรับการใช้งานแบบเสียเงินนั้นไม่ใช่สิ่งที่คุณดึงออกมาจากการดึงหน้าเพจแบบสแตติกได้ อย่าเดาตัวเลขนั้น เมื่อคุณต้องการมัน ให้เปิดแท็บบิลลิงในคอนโซล Cerebras Cloud ด้วยตัวเอง เพราะนั่นเป็นที่เดียวที่รับประกันว่าอัตราปัจจุบันถูกต้อง
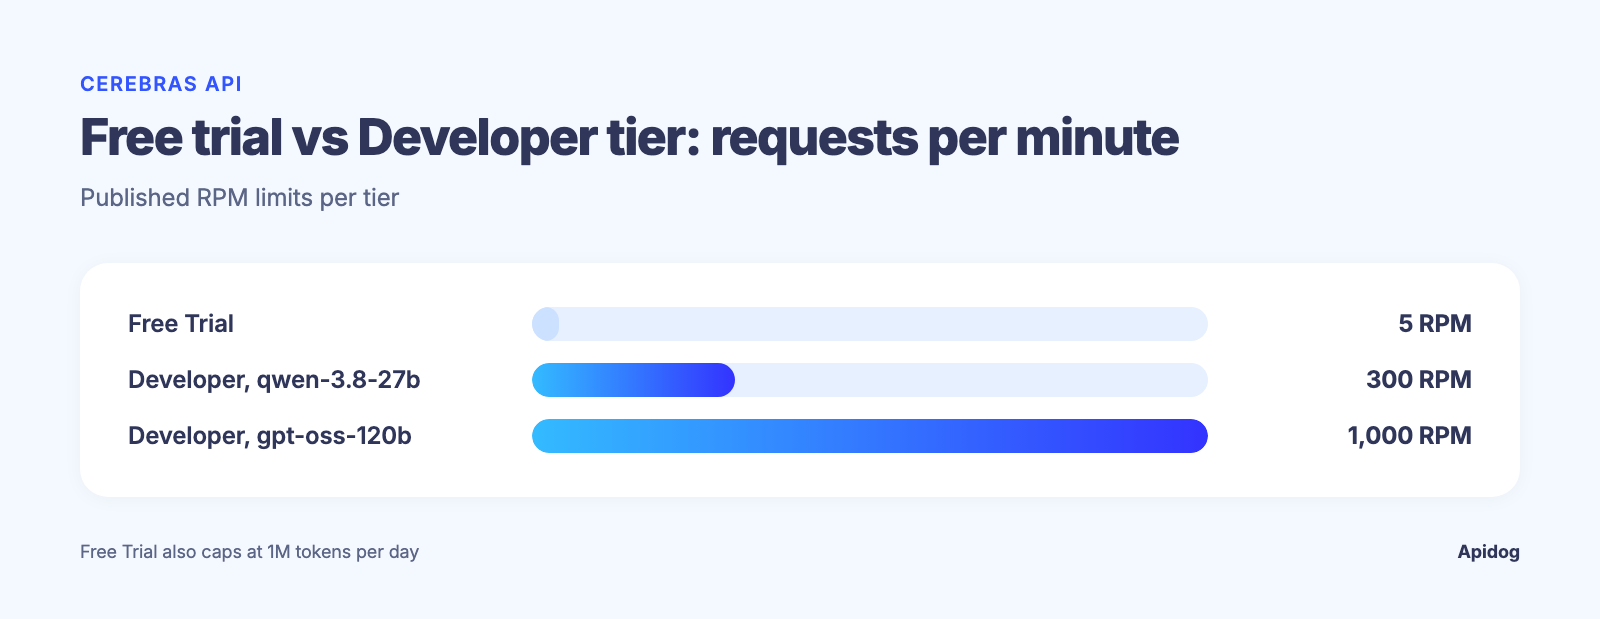
สิ่งที่เอกสารระบุไว้อย่างชัดเจนในหน้าเพจลิมิตอัตราการใช้งานสำหรับการสนับสนุน คือโครงสร้างของระดับ Free Trial:
| ระดับ | โมเดล | RPM | TPM ที่ไม่ถูกแคช | TPM ทั้งหมด | TPH | TPD |
|---|---|---|---|---|---|---|
| Free Trial | gpt-oss-120b, qwen-3.8-27b |
5 | 30K | 90K | 1M | 1M |
Developer (gpt-oss-120b) |
จ่ายตามการใช้งานจริง | 1,000 | 1M | 3M | ไม่มี | ไม่มี |
Developer (qwen-3.8-27b) |
จ่ายตามการใช้งานจริง | 300 | 150K | 450K | ไม่มี | ไม่มี |
มีสองเรื่องที่สำคัญตรงนี้ อย่างแรก "TPM ที่ไม่ถูกแคช" คือเพดานจริง มันคือโทเคนที่ต้องใช้การประมวลผลเต็มรูปแบบ และโควตา TPM รวมของคุณจะอยู่ที่ประมาณสามเท่าของจำนวนนั้นเมื่อนับการแคชฮิตแล้ว อย่างที่สอง บัญชี Free Trial ถูกจำกัดด้วยเครดิตและเวลา ไม่ได้จำกัดด้วยจำนวนคำขอตลอดไป เมื่อเงิน $5 หมดหรือครบ 30 วัน คุณจะตกลงไปอยู่ที่ระดับใดก็ตามที่บัญชีของคุณอนุญาตจนกว่าจะเพิ่มวิธีการชำระเงิน ทุกอย่างที่เกินเลยตารางนี้ (ราคาต่อโทเคน ราคาต่อที่นั่ง เงื่อนไขระดับองค์กร) อยู่หลังหน้าเพจราคาที่เรนเดอร์ด้วย JavaScript และคอนโซล ไม่ใช่เอกสารสแตติก ดังนั้นตรวจสอบตรงนั้นก่อนที่คุณจะตั้งงบประมาณโดยอิงจากมัน
หากคุณเคยชนกำแพงแบบนี้กับผู้ให้บริการรายอื่น รูปแบบก็เหมือนกับที่กล่าวถึงในคู่มือของเราเรื่องสิ่งที่ควรทำเมื่อคุณได้รับข้อความตอบกลับ 429 rate-limit-exceeded: อ่านเนื้อหาข้อผิดพลาด ถอยออกมา แล้วตรวจแดชบอร์ดก่อนที่คุณจะสมมติว่า API ทำงานผิดพลาด
รับคีย์และเรียกหนึ่งครั้งจริง ๆ
สมัครที่ cloud.cerebras.ai เปิด API Keys แล้วสร้างคีย์ขึ้นมา ควิกสตาร์ตของ Cerebras เองบอกให้คุณตั้งมันเป็นตัวแปรสภาพแวดล้อมเพื่อที่มันจะไม่ไปอยู่ในบอดีของคำขอด้วยมือ:
export CEREBRAS_API_KEY="your-key-here"
Base URL คือ https://api.cerebras.ai/v1 และเอนด์พอยต์ chat completions ก็ตรงกับรูปแบบของ OpenAI ทุกประการ: POST /v1/chat/completions พร้อม model และอาร์เรย์ messages ความเข้ากันได้นี้มีระบุไว้ในเอกสารอ้างอิง API และนั่นคือเหตุผลที่คุณสามารถเอา Cerebras ไปใส่ในโค้ดที่เขียนสำหรับไลบรารีไคลเอนต์ของ OpenAI ได้โดยเปลี่ยน base URL และคีย์ การเรียกด้วย curl แบบดิบ ๆ มีหน้าตาแบบนี้:
curl https://api.cerebras.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${CEREBRAS_API_KEY}" \
  -d '{
    "model": "qwen-3.8-27b",
    "messages": [
      {"role": "user", "content": "Explain time-to-first-token in two sentences."}
    ]
  }'
รันมันดู แล้วคำตอบจะมาพร้อมกับอะไรมากกว่าแค่ข้อความที่คอมพลีต มันมีบล็อก usage (prompt_tokens, completion_tokens, total_tokens) และบล็อก time_info (queue_time, total_time) ที่ Cerebras ส่งกลับมาในทุกการเรียก
หากทีมของคุณกำลังทดสอบมากกว่าหนึ่งโมเดลหรือผู้ให้บริการ นี่เป็นจังหวะที่ดีที่จะเลิกพึ่งคำสั่ง curl แบบครั้งเดียว หัวข้อ Apidog CLI ด้านล่างมีให้ coding agent ของคุณเปลี่ยนการเรียกนี้ให้เป็นเทสต์ที่มันรันซ้ำได้ทุกครั้งที่ Cerebras เพิ่มโมเดลหรือเปลี่ยนลิมิต
วัดคำกล่าวอ้างเรื่องความเร็ว: เวลาไปถึงโทเคนแรกและโทเคนต่อวินาที
มีสองตัวเลขที่บอกคุณว่าคำว่า "เร็ว" เป็นจริงสำหรับภาระงานของคุณหรือไม่: เวลาไปถึงโทเคนแรก (TTFT) และจำนวนโทเคนที่สร้างต่อวินาที ทั้งสองไม่ได้ปรากฏเป็นเมตริกหลักในคำตอบของ API ดังนั้นคุณต้องคำนวณมันจากสิ่งที่การเรียกให้คุณมา
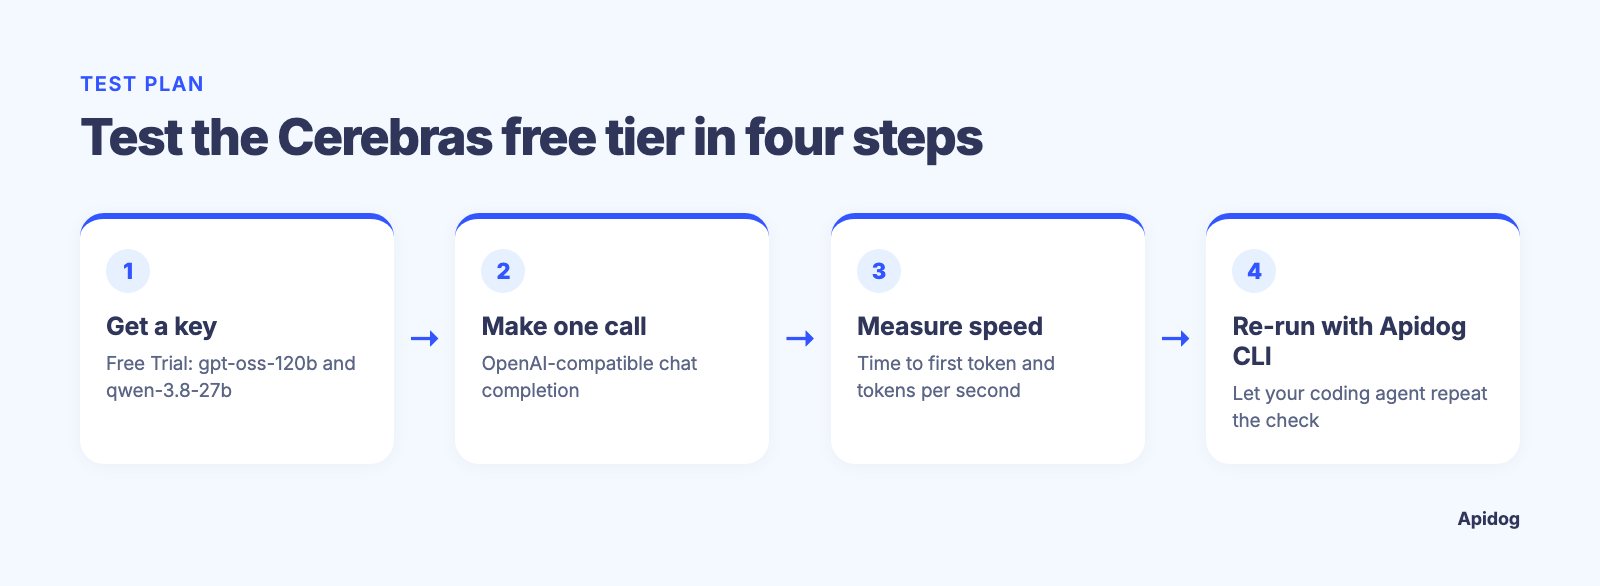
สำหรับ TTFT ให้สตรีมคำตอบและบันทึกช่องว่างของเวลาจริงระหว่างการส่งคำขอกับการรับชังก์แรก:
import time
from cerebras.cloud.sdk import Cerebras

client = Cerebras()
start = time.perf_counter()
first_token_at = None

stream = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Write a haiku about wafer-scale chips."}],
    stream=True,
)

for chunk in stream:
    if first_token_at is None and chunk.choices[0].delta.content:
        first_token_at = time.perf_counter() - start
        print(f"Time to first token: {first_token_at:.3f}s")
สำหรับจำนวนโทเคนต่อวินาที ให้ใช้การเรียกแบบไม่สตรีมแล้วหารจำนวนโทเคนที่คอมพลีตด้วย total_time ที่ Cerebras รายงานใน time_info:
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Explain the CS-3 wafer-scale engine in 100 words."}],
)

tokens = response.usage.completion_tokens
seconds = response.time_info.total_time
print(f"{tokens / seconds:.1f} tokens/sec")
รันสคริปต์นี้สักสองสามครั้ง ในช่วงเวลาต่าง ๆ กัน ด้วยพรอมป์ที่ใกล้เคียงกับสิ่งที่ผลิตภัณฑ์ของคุณส่งไป เก็บสคริปต์ทั้งสองไว้และรันซ้ำทุกครั้งที่ Cerebras เพิ่มโมเดลเข้าไปในระดับฟรี เพราะตัวเลขโทเคนต่อวินาทีเปลี่ยนไปตามโมเดล ไม่ใช่แค่ตามผู้ให้บริการ
อ่านลิมิตก่อนที่ลิมิตจะอ่านคุณ
การออกแบบลิมิตอัตราการใช้งานของ Cerebras มีจุดละเอียดอ่อนหนึ่งจุดที่ควรรู้ก่อนคุณจะเขียนสคริปต์อะไร: มันติดตามถังโทเคนสองถังแยกกันต่อองค์กร คือ TPM ที่ไม่ถูกแคชและ TPM ทั้งหมด และบังคับใช้ทั้งสองพร้อมกัน การระดมยิงพรอมป์สั้น ๆ ซ้ำ ๆ อาจชนเพดานคำขอต่อนาทีก่อนที่จะเข้าใกล้เพดานโทเคนเลย ซึ่งเป็นกับดักแบบเดียวกับที่อธิบายไว้ในบทความภาพรวมของเราเรื่องการจำกัดอัตราการใช้งานของ API ทำงานอย่างไร
ช่องโหว่ที่ตรงไปตรงมาอย่างหนึ่งในเอกสาร: Cerebras ไม่ได้เผยแพร่ชุดเฮดเดอร์ตอบกลับ x-ratelimit-* แบบที่ผู้ให้บริการบางรายทำ เอกสารอ้างอิง API ไม่ได้ระบุไว้เลย และหน้าเพจลิมิตอัตราการใช้งานก็เช่นกัน ต่างจากchat completions API ของ OpenAI เองที่ส่งเฮดเดอร์โควตาคงเหลือกลับมาในทุกการเรียก ซึ่งเป็นรูปแบบที่คู่มือลิมิตอัตราการใช้งานของ OpenAI ของเราครอบคลุมไว้ละเอียดกว่า สำหรับ Cerebras สองที่ที่คุณตรวจสอบสถานะจริงของคุณได้คือส่วน Limits ในคอนโซล Cloud และบอดีของคำตอบ 429 ซึ่งระบุว่าคุณเกินเพดานโทเคนแบบไม่ถูกแคชหรือแบบรวมทั้งหมด จงสร้างลอจิกการลองใหม่ของคุณโดยอิงจากบอดีข้อผิดพลาดนั้น แทนที่จะสมมติว่าเฮดเดอร์จะบอกคุณก่อน
ให้ coding agent ของคุณรันซ้ำด้วย Apidog CLI
การวัดในไฟล์ทดลองไม่ได้พิสูจน์อะไรในเดือนหน้า ให้ coding agent ของคุณเปลี่ยนการเรียกให้เป็นเทสต์ที่มันรันซ้ำได้ผ่าน Apidog CLI ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
โทเคนได้มาจาก Apidog ใต้ Account Settings, API Access Token จากนั้นส่งพรอมป์ให้เอเจนต์หนึ่งข้อความ:
Use Apidog CLI on project <id>. Create a Cerebras environment with base URL
https://api.cerebras.ai/v1 and add POST /chat/completions with Bearer auth from
{{CEREBRAS_API_KEY}} and model set to {{MODEL}}. Create a test case asserting
status 200 and time_info.total_time under {{MAX_TOTAL_TIME}}, run it for
gpt-oss-120b and qwen-3.8-27b, and report completion tokens per second for each.
คำสั่งที่มันรัน ตรวจสอบเทียบกับ Apidog CLI 2.2.7:
apidog environment create Cerebras --project <id> --base-url https://api.cerebras.ai/v1
apidog endpoint create --project <id> --file cerebras-chat.json
apidog cli-schema validate test-case-create --file speed-case.json
apidog test-case create --project <id> --file speed-case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d models.csv \
  --delay-request 12000 --env-var "CEREBRAS_API_KEY=$CEREBRAS_API_KEY" -r cli,json
models.csv มีคอลัมน์ MODEL หนึ่งคอลัมน์ ดังนั้นการรันครั้งเดียวครอบคลุมทั้งสองโมเดล และอะไรก็ตามที่ Cerebras ปล่อยต่อไปก็เพิ่มอีกแถวเดียว --delay-request 12000 เว้นระยะการเรียกให้ห่างกัน 12 วินาทีเพื่อให้อยู่ใต้ 5 คำขอต่อนาทีของ Free Trial สำหรับเส้นทาง 429 ให้ขอเคสที่สองที่จงใจระดมยิงเกินลิมิตนั้นและตรวจสอบบอดีข้อผิดพลาด เพื่อให้มันถูกบันทึกและทำเวอร์ชันไว้ แทนที่จะต้องมาค้นพบใหม่ในโปรดักชัน นั่นคือเวิร์กโฟลว์ ไม่ใช่การวัดประสิทธิภาพครั้งเดียว ดูบทความรวมของเราเรื่องเครื่องมือทดสอบ API ที่สร้างมาสำหรับภาระงานของเอเจนต์และ LLM หากคุณกำลังเปรียบเทียบตัวเลือก และApidog CLI ใน Claude Code สำหรับฝั่งเอเจนต์
ระดับฟรีหรือระดับ Developer: เมื่อไหร่ควรย้าย
ระดับ Free Trial ถูกสร้างมาเพื่อสิ่งที่คู่มือนี้พาคุณทำพอดี นั่นคือการยืนยันคำกล่าวอ้างเรื่องความเร็วและรูปแบบคำขอก่อนที่คุณจะผูกบัตร เมื่อคุณสร้างบน Cerebras จริง ๆ แล้ว การกระโดดขึ้นไปของระดับ Developer จาก 5 RPM เป็น 1,000 RPM บน gpt-oss-120b คือตัวเลขที่มักบังคับให้ต้องตัดสินใจ ไม่ใช่ราคาต่อโทเคน หากปริมาณพรอมป์ของคุณมาเป็นระลอกแทนที่จะสม่ำเสมอ ให้เปรียบเทียบตัวเลขของ Cerebras กับทางเลือกอื่นก่อนที่คุณจะตัดสินใจ รายการทางเลือกแทน OpenRouter ของเราและบทความแนะนำระดับ API ฟรีของ Groq ของเราต่างก็ควรอ่านเทียบกับตารางด้านบน เพราะความเร็วในการประมวลผลและเพดานของระดับฟรีแตกต่างกันระหว่างผู้ให้บริการมากกว่าที่บทความเปรียบเทียบส่วนใหญ่ยอมรับ ความแตกต่างหนึ่งที่ควรรู้ก่อนเลือก: Groq ระบุลิมิตของแผนฟรีรายโมเดลไว้โดยตรง ตัวอย่างเช่น openai/gpt-oss-120b ที่ 30 RPM, 1,000 RPD, 8K TPM และ 200K TPD พร้อมทั้งส่งเฮดเดอร์ตอบกลับ x-ratelimit-* ในทุกการเรียก คุณจึงรู้งบประมาณคงเหลือจากตัวคำตอบเองเสมอ Cerebras ไม่ให้ทั้งสองอย่าง คุณต้องอ่านสถานะของคุณจากคอนโซล Cloud หรืออนุมานจากบอดี 429 ตามที่กล่าวไปข้างต้น
คำถามที่พบบ่อย
ระดับฟรีของ Cerebras ต้องใช้บัตรเครดิตหรือไม่? ระดับ Free Trial อิงกับเครดิต ($5 หมดอายุหลัง 30 วัน) แทนที่จะเป็นแผนฟรีแบบต่อเนื่อง และเอกสารของ Cerebras เองก็บอกให้คุณไปดูที่คอนโซล Cloud สำหรับข้อกำหนดการสมัครปัจจุบัน เพราะรายละเอียดนั้นเปลี่ยนได้โดยไม่ขึ้นกับเอกสารสแตติก
มีโมเดลอะไรบ้างในระดับฟรี? ณ เอกสารลิมิตอัตราการใช้งานปัจจุบัน มีสองโมเดล: gpt-oss-120b และ qwen-3.8-27b ทั้งคู่ใช้ลิมิต Free Trial เดียวกัน (5 RPM, 30K TPM แบบไม่ถูกแคช)
ใช้โค้ด OpenAI SDK เดิมของฉันกับ Cerebras ได้ไหม? ได้ ชี้ base URL ของไคลเอนต์ไปที่ https://api.cerebras.ai/v1 แล้วสลับมาใช้คีย์ Cerebras ของคุณ รูปแบบ /v1/chat/completions ตรงกัน ตามเอกสารอ้างอิง API
ทำไมฉันถึงได้ 429 ทั้งที่ยังไม่ถึงงบโทเคน? Cerebras บังคับใช้ TPM แบบไม่ถูกแคช, TPM รวม และ RPM เป็นเพดานแยกกัน การยิงคำขอเล็ก ๆ รัว ๆ อาจชนลิมิต RPM ได้ก่อนที่ถังโทเคนใดจะเต็ม ซึ่งเป็นโหมดความล้มเหลวแบบเดียวกับที่กล่าวถึงในคู่มือแก้ปัญหา rate-limit-exceeded ของเรา
ฉันจะตรวจสอบการใช้งานปัจจุบันโดยไม่ต้องชนกำแพงก่อนได้อย่างไร? Cerebras ไม่ส่งเฮดเดอร์ตอบกลับโควตาคงเหลือ ดังนั้นให้ตรวจส่วน Limits ในคอนโซล Cloud โดยตรง แทนที่จะอนุมานจากคำตอบของ API แผนฟรีของ Groq ใช้แนวทางตรงกันข้ามและส่งเฮดเดอร์ x-ratelimit-* ในทุกการเรียก ดังนั้นชั่งน้ำหนักความแตกต่างนี้หากการมอนิเตอร์ผ่านเฮดเดอร์สำคัญกับระบบของคุณ
ข้อได้เปรียบจริงของ Cerebras ปรากฏอยู่ในบล็อก time_info ของการเรียกของคุณเอง ไม่ใช่ในพาดหัวการตลาด