
แผนภาพโรงงานซอฟต์แวร์ภายในของ OpenAI ของ Gergely Orosz เป็นที่พูดถึงกันมากในสัปดาห์นี้: ผู้สร้างยื่นผลลัพธ์ที่ต้องการ, Codex เขียนโค้ด, กลุ่มตัวแทนผู้เชี่ยวชาญตรวจสอบความเสี่ยง, และตัวแทนหนึ่งคนคอยดูแลการติดตั้งใช้งานพร้อมกับตรวจสอบแดชบอร์ดที่สร้างขึ้นเอง นอกจากนี้ ในส่วนที่สำคัญที่สุดสำหรับวิศวกรของ OpenAI เอง มันยังเป็นคำอธิบายเครื่องมือภายในที่คุณไม่สามารถติดตั้งได้
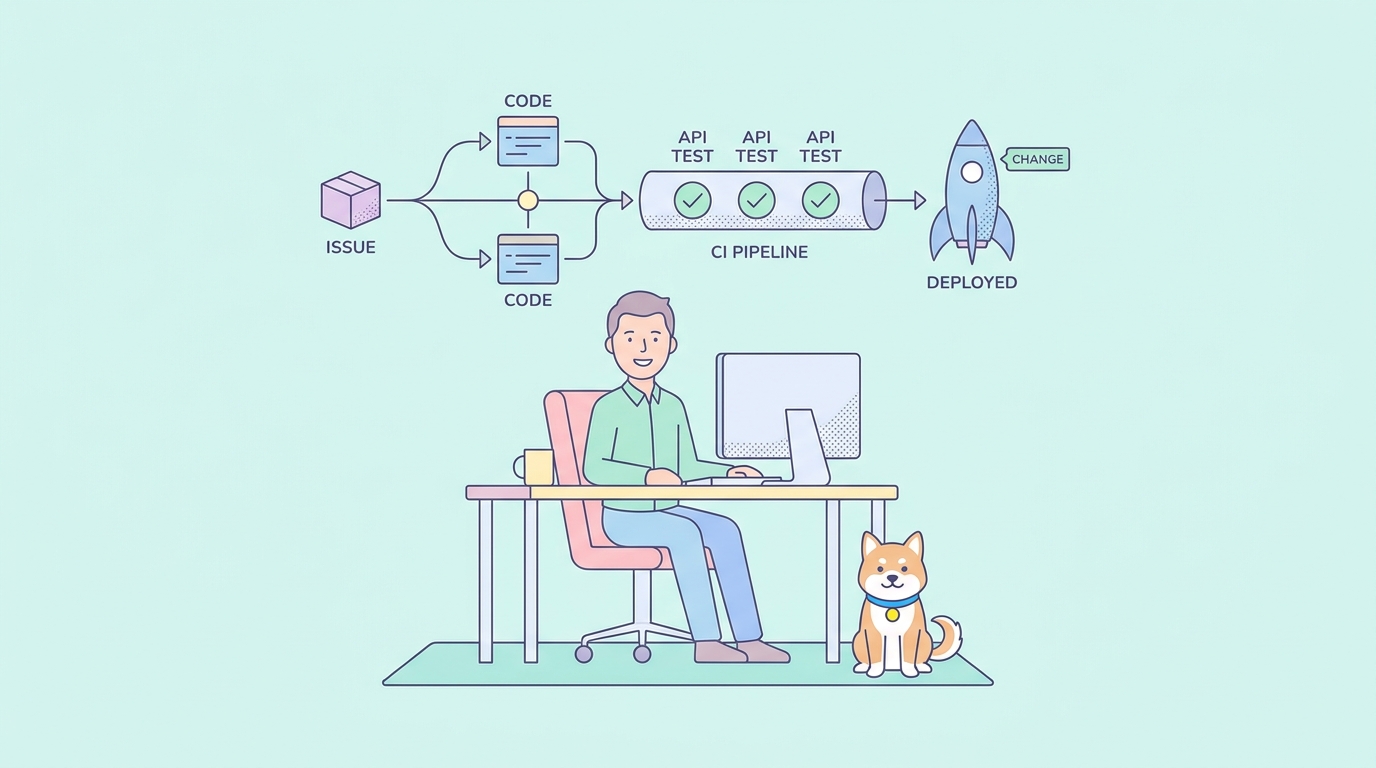
Perf Factory, Sevbot และการปรับใช้แบบอัตโนมัติ (agentic deploy) พร้อมแดชบอร์ดที่สร้างเองนั้นทำงานบนโครงสร้าง observability ภายในของ OpenAI และไม่ได้เป็นส่วนหนึ่งของผลิตภัณฑ์ Codex ที่คุณสามารถซื้อได้ สิ่งที่คุณสามารถสร้างได้ในสัปดาห์นี้คือวงจรที่เล็กลงแต่ยังคงทำงานได้จริง: ผู้สร้างกำหนดผลลัพธ์ที่ต้องการเป็นประเด็นปัญหา, Codex ดำเนินการใน branch, CI ตรวจสอบว่าการเปลี่ยนแปลงทำงานได้จริง, ตัวแทนผู้ตรวจสอบหนึ่งหรือสองคนตรวจสอบ, และมนุษย์อนุมัติสิ่งที่มีความเสี่ยงก่อนที่จะเผยแพร่เบื้องหลัง feature flag สิ่งทั้งหมดนี้ขึ้นอยู่กับรายละเอียดหนึ่งที่แผนภาพต้นฉบับละเลยไป: "CI ผ่าน" จะมีความหมายก็ต่อเมื่อ CI ตรวจสอบสิ่งที่ถูกต้อง สำหรับ API นั่นหมายถึงการทดสอบ API ไม่ใช่แค่โค้ดที่เรียกใช้ API เท่านั้น
สิ่งที่แผนภาพทำถูกต้อง (และสิ่งที่คุณไม่สามารถลอกเลียนแบบได้)
ส่วนสาธารณะของบทความ Pragmatic Engineer อธิบายวงจรหลักที่ Codex “ทำการเปลี่ยนแปลงโค้ดหลายครั้งจนกว่าจะบรรลุเป้าหมาย และจากนั้นจะตรวจสอบว่าซอฟต์แวร์ทำงานได้ตามที่ควรจะเป็น” พื้นที่ที่มีความเสี่ยงต่ำสามารถอนุมัติได้โดยอัตโนมัติ; การเปลี่ยนแปลงที่มีความเสี่ยงสูงจะได้รับการตรวจสอบจาก AI มากขึ้น หรือต้องผ่านการอนุมัติจากมนุษย์ โครงสร้างดังกล่าว คือ การเสนอ, การยืนยัน, การตรวจสอบตามระดับความเสี่ยง สามารถนำไปปรับใช้ได้ ทีมต่างๆ ได้นำแนวคิดนี้ไปใช้กับบอท Pull Request และ CI gates มานานหลายปีแล้ว; เอเจนต์เพียงแค่ทำให้วงจรเร็วขึ้นและมีการดูแลน้อยลง
สิ่งที่ไม่สามารถนำไปปรับใช้ได้คือกลไกภายในที่อยู่รอบๆ Perf Factory ทำการคัดกรองการแจ้งเตือนและแดชบอร์ดเพื่อค้นหาปัญหาความล่าช้าและเสนอแนวทางแก้ไข Sevbot ทำการตรวจสอบเหตุการณ์และตอบคำถามใน Slack แม้ว่าจะไม่ได้ดำเนินการแก้ไขเองก็ตาม Agentic deploy จะเฝ้าดูการเปลี่ยนแปลงที่นำขึ้นสู่ Production และสร้างการตรวจสอบของตัวเองโดยใช้ telemetry stack ภายในของ OpenAI ไม่มีส่วนประกอบทั้งสามนี้รวมอยู่ในผลิตภัณฑ์ Codex ภายนอกที่วางจำหน่าย สิ่งที่วางจำหน่ายคือแอปเดสก์ท็อป, คำสั่ง /goal สำหรับงานที่ใช้เวลานาน, และปลั๊กอินบทบาท (role plugins) และทักษะที่คุณสามารถกำหนดค่าได้เอง หน้าผลิตภัณฑ์ Codex ของ OpenAI ครอบคลุมสิ่งที่ใช้งานได้จริง
วงจรห้าขั้นตอนที่คุณสามารถใช้งานได้ในสัปดาห์นี้
เวอร์ชันย่อส่วนจะมีลักษณะดังนี้:
- ผู้สร้างยื่นผลลัพธ์ที่ต้องการเป็นประเด็นปัญหา ไม่ใช่รายการงาน แต่เป็นการอธิบายสถานะสุดท้าย: "คำสั่งซื้อสามารถมีรหัสส่วนลดเสริมที่ลดราคารวมได้" การส่งประเด็น GitHub เดียวกันนั้นให้กับ Agent ใน Sharkly เป็นการรวมระบบที่พร้อมใช้งาน: ประเด็นปัญหานั้นจะกลายเป็น Task และผลลัพธ์ที่ได้จะกลับมาเป็น PR แทนที่จะเป็นตั๋วแยกต่างหากเพื่อทำการกระทบยอด ปัจจุบันนี้เปิดให้ใช้งานฟรีสำหรับองค์กรที่มีพนักงานไม่เกิน 10 คน
- Codex ทำงานใน branch ด้วยคำสั่ง
/goalตามที่อธิบายไว้ใน วิธีการที่คำสั่ง/goalขับเคลื่อนการทำงานอัตโนมัติของ Codex และ Claude Code คุณกำหนดเป้าหมายให้ Agent และปล่อยให้มันทำงานวนซ้ำด้วยตัวเองจนกว่าจะบรรลุเป้าหมาย - CI รันการบิวด์, unit tests, และ API test scenarios นี่คือขั้นตอนที่ทีมส่วนใหญ่ข้ามไปหรือไม่ก็สร้างไม่สมบูรณ์
- ตัวแทนผู้ตรวจสอบหนึ่งหรือสองคนตรวจสอบความแตกต่าง และมนุษย์จะตรวจสอบสิ่งใดก็ตามที่มีความเสี่ยงสูงกว่าระดับต่ำ เครื่องมือตรวจสอบโค้ดด้วย AI สามารถตรวจพบข้อผิดพลาดจำนวนมากก่อนที่มนุษย์จะเปิด PR เสียอีก ใน Sharkly นี่คือส่วนที่ Ready for Release ทำงาน: มนุษย์จะต้องย้ายงานออกจากสถานะนี้ก่อนที่สิ่งใดๆ จะไปถึงสถานะ Done และตัวแทนผู้ตรวจสอบที่แยกต่างหากสามารถอยู่ใน Crew เดียวกันกับผู้ที่เขียนโค้ดได้
- ติดตั้งใช้งานเบื้องหลัง feature flag เพื่อให้การรวมโค้ดที่ไม่ดีกลายเป็นการสลับปิดเปิด ไม่ใช่เหตุการณ์ฉุกเฉิน
ขั้นตอนที่ 3 คือจุดที่วงจรจะทำงานได้จริงหรือไม่ก็หลอกคุณ
ทำไม CI ต้องทดสอบ API ไม่ใช่แค่โค้ด
คุณสมบัติการตรวจสอบของ Codex เอง ซึ่งครอบคลุมอยู่ใน วิธีการทำงานของการตรวจสอบโค้ดของ Codex จะอ่านความแตกต่าง (diff) และระบุปัญหาที่ชัดเจน มันไม่ได้รันบริการของคุณและตรวจสอบว่ามันส่งคืนอะไร Unit tests หาก Agent เป็นคนเขียนหรือดูแลไว้ ส่วนใหญ่จะตรวจสอบว่าโค้ดทำงานตามที่โค้ดตั้งใจ ซึ่งไม่เหมือนกับการตรวจสอบว่า API ทำงานตามที่สัญญากำหนดไว้ Agent ที่แก้ไข handler สามารถผ่าน unit test ทุกตัวได้ ในขณะที่อาจจะทำให้การตอบสนองที่ลูกค้าทุกรายพึ่งพาเสียหายไปอย่างเงียบๆ
สมมติว่าคุณใช้งาน Orders API POST /api/orders จะสร้างคำสั่งซื้อและส่งคืนบันทึก; GET /api/orders/{id} จะดึงข้อมูลหนึ่งรายการด้วย ID คุณดูแล OpenAPI spec สำหรับทั้งสองอย่าง และคุณได้สร้าง Apidog test scenarios เพื่อตรวจสอบ: สร้างคำสั่งซื้อ, ดึงข้อมูลกลับมา, และตรวจสอบสี่สิ่งที่คุณสมบัติ unit test ทั่วไปมักจะไม่ได้ทำ:
- รหัสสถานะ (Status codes)
POST /api/ordersส่งคืน201ไม่ใช่200หรือ500ที่เงียบหายไปในกรณีขอบเขตของการตรวจสอบความถูกต้อง - Schema การตอบสนองเทียบกับ OpenAPI spec ฟิลด์
total_amountยังคงเป็นตัวเลข,statusยังคงเป็นหนึ่งในค่า enum ที่คุณกำหนดไว้, และไม่มีฟิลด์ใดที่ลูกค้าต้องพึ่งพาหายไปอย่างเงียบๆ หรือถูกเปลี่ยนชื่อ - ความล้มเหลวในการยืนยันตัวตน (Auth failures) คำขอที่ไม่มีโทเค็นที่ถูกต้องจะส่งคืน
401ไม่ใช่ 200 พร้อมกับเนื้อหาว่างเปล่า ซึ่งเป็นข้อบกพร่องที่เกิดขึ้นบ่อยอย่างน่าประหลาดใจ - เกณฑ์ความล่าช้า (A latency threshold) สถานการณ์จำลองยืนยันว่าการตอบสนองกลับมาภายในขีดจำกัดที่กำหนดไว้ เพื่อให้การเปลี่ยนแปลงที่เพิ่มการเรียกฐานข้อมูลที่ไม่ได้จัดกลุ่ม (unbatched database call) ภายใน handler ถูกตรวจพบก่อนที่ลูกค้าจะสังเกตเห็น
สิ่งเหล่านี้คือการตรวจสอบที่การปรับโครงสร้างโค้ดระดับ handler สามารถทำให้เสียหายไปอย่างเงียบๆ ได้ ในขณะที่ unit test ทุกตัวยังคงผ่านอยู่ เนื่องจาก unit test มักจะจำลองขอบเขตที่ API scenario ใช้งานจริง
การเชื่อมต่อเข้ากับ Pipeline
คุณสามารถรันเวอร์ชัน CLI ของสถานการณ์เหล่านี้ในเครื่องของคุณได้อยู่แล้ว หากคุณปฏิบัติตาม วิธีการใช้ Apidog CLI ใน Codex คำสั่งเดียวกันนี้จะทำงานใน CI งาน GitHub Actions ที่ทำการ build, รัน unit tests, และจากนั้นรัน Apidog scenario จะมีลักษณะดังนี้:
name: CI

on:
  pull_request:
  push:
    branches: [main]

jobs:
  build-test-verify:
    runs-on: ubuntu-latest
    steps:
      - name: Check out repository
        uses: actions/checkout@v4

      - name: Set up Node.js
        uses: actions/setup-node@v4
        with:
          node-version: '20'

      - name: Install dependencies
        run: npm ci

      - name: Build and run unit tests
        run: npm run build && npm test

      - name: Install Apidog CLI
        run: npm install -g apidog-cli

      - name: Run orders API test scenario
        env:
          APIDOG_ACCESS_TOKEN: ${{ secrets.APIDOG_ACCESS_TOKEN }}
        run: |
          apidog run \
            --access-token $APIDOG_ACCESS_TOKEN \
            -t 88214 \
            -e 3301 \
            -r cli,junit

      - name: Upload Apidog reports
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: apidog-reports
          path: apidog-reports/
ค่า -t และ -e คือ ID scenario และ environment จริงของคุณจาก Apidog ไม่ใช่ค่าตัวยึดที่คุณสร้างขึ้นเอง เอกสารอ้างอิงคำสั่ง apidog run ครอบคลุมทุกแฟล็ก และ รายงานการทดสอบ Apidog CLI อธิบายเอาต์พุต JUnit ที่งานอัปโหลด apidog run จะออกด้วยค่าที่ไม่ใช่ศูนย์เมื่อมีการยืนยันที่ล้มเหลว ดังนั้น GitHub Actions จะทำเครื่องหมายว่างานล้มเหลวในลักษณะเดียวกับ unit test ที่ล้มเหลว
ลักษณะของพรอมต์ของ Agent
จุดประสงค์ของ /goal คือคุณอธิบายผลลัพธ์ที่ต้องการและเงื่อนไขการออก และ Codex จะวนซ้ำโดยที่คุณไม่จำเป็นต้องอนุมัติทุกขั้นตอน สำหรับตัวอย่างรหัสส่วนลด พรอมต์ที่สมเหตุสมผลคือ:
/goal Add an optional `discount_code` field to POST /api/orders. Validate it
against the promotions service and apply the discount to `total_amount` in
the response. Do not rename or remove any existing response field. Run
`npm test` and `apidog run --access-token $APIDOG_ACCESS_TOKEN -t 88214 -e 3301
-r cli` before you finish. Both must exit 0. If the Apidog run fails, read the
failing assertion and fix the handler, not the test.
บรรทัดสุดท้ายนั้นสำคัญ Agent ที่อยู่ภายใต้ความกดดันที่จะทำให้การตรวจสอบเป็นสีเขียว บางครั้งจะแก้ไขการยืนยัน (assertion) แทนที่จะแก้ไขข้อบกพร่อง การบอกอย่างชัดเจนว่าควรแก้ไขส่วนใดของวงจร จะช่วยให้ test scenario เป็นแหล่งของความจริง ไม่ใช่อุปสรรคที่ต้องหลีกเลี่ยง
เมื่อ Agent ผิดสัญญา
Codex เพิ่มฟิลด์ส่วนลด และในกระบวนการได้เปลี่ยนชื่อ total_amount เป็น totalAmount เพราะเป็นธรรมเนียมในไฟล์ที่มันอ่านอยู่ใกล้เคียง Unit test ยังคงผ่าน; พวกมันตรวจสอบการคำนวณส่วนลด ไม่ใช่ชื่อฟิลด์ การบิวด์สำเร็จ จากนั้น Apidog scenario รันใน CI ตรวจสอบการตอบสนองเทียบกับ OpenAPI spec และล้มเหลว: spec ระบุ total_amount, แต่ตอนนี้การตอบสนองมี totalAmount และการยืนยัน schema ก็ตรวจพบได้ทันที
CI รายงานการออกด้วยค่าที่ไม่ใช่ศูนย์และชี้ไปที่การยืนยัน schema ที่ล้มเหลวในเอาต์พุต JUnit Codex อ่านความล้มเหลว, เห็นว่าการเปลี่ยนชื่อเป็นสาเหตุ, และเปลี่ยนกลับในขณะที่ยังคงรักษากลไกส่วนลดไว้ สถานการณ์จำลองผ่าน, การบิวด์เป็นสีเขียว, และ pull request ถูกส่งไปตรวจสอบพร้อมกับการรับประกันจริงที่อยู่เบื้องหลังคำว่า "ผ่าน" หากไม่มีการตรวจสอบระดับ API การเปลี่ยนชื่อนั้นจะถูกปล่อยออกไป และลูกค้าทุกรายที่กำลังแยกวิเคราะห์ total_amount จะได้รับผลกระทบในการเผยแพร่ครั้งถัดไป
การแบ่งระดับความเสี่ยงที่คุณสามารถอ้างอิงจาก Spec ได้
แทนที่จะใช้ความรู้สึกคลุมเครือว่าอะไรถือเป็นความเสี่ยงต่ำ ให้ผูกการจัดประเภทความเสี่ยงของคุณเข้ากับการเปลี่ยนแปลงของ OpenAPI (OpenAPI diff) การเปลี่ยนแปลงที่เพิ่มฟิลด์เสริมพร้อมค่าเริ่มต้นเป็นผู้สมัครสำหรับการรวมอัตโนมัติเมื่อการทดสอบผ่าน การเปลี่ยนแปลงที่ลบฟิลด์, เปลี่ยนชื่อฟิลด์ หรือเปลี่ยนรหัสสถานะ จะไม่ถือว่ามีความเสี่ยงต่ำ ไม่ว่าส่วนที่เหลือของ diff จะเป็นอย่างไร กฎเดียวนี้ก็สามารถตรวจจับสิ่งส่วนใหญ่ที่ตัวแทนผู้เชี่ยวชาญด้านการตรวจสอบจะธงไว้ได้อยู่แล้ว ส่งสิ่งใดก็ตามที่กฎธงไว้ให้ผู้ตรวจสอบที่เป็นมนุษย์ หรือให้ เครื่องมือตรวจสอบโค้ด AI ตรวจสอบอีกครั้งก่อนการรวม
เผยแพร่เบื้องหลัง Flag ไม่ใช่ปล่อยทิ้งไป
เมื่อการเปลี่ยนแปลงผ่าน CI และการตรวจสอบแล้ว ให้ปรับใช้มันเบื้องหลัง feature flag แทนที่จะปล่อยให้ผู้ใช้ทุกคนเห็นทันที นี่คือทางเลือกที่ถูกกว่าสำหรับขั้นตอนการปรับใช้แบบอัตโนมัติ (agentic deploy) ของ OpenAI: ไม่มี Agent คอยดูแลการปล่อยใช้งานหรือสร้างแดชบอร์ดของตัวเอง การใช้ flag ที่เริ่มต้นที่ 5% ของปริมาณการใช้งาน และมีบุคคลที่ตรวจสอบอัตราข้อผิดพลาดก่อนที่จะเปิดเป็น 100% จะช่วยให้คุณได้รับความปลอดภัยส่วนใหญ่โดยไม่ต้องมีเครื่องมือภายใน หากมีสิ่งผิดปกติ คุณก็แค่ปิด flag แทนที่จะต้อง roll back การรวมโค้ดภายใต้ความกดดัน
โครงสร้างที่มีอยู่แล้ว
คุณไม่จำเป็นต้องเชื่อมต่อทั้งห้าขั้นตอนจากศูนย์ orchflows เป็นโครงการโอเพนซอร์สที่ปรากฏในการตอบกลับกระทู้ของ Orosz: เป็นคำสั่ง /software-factory ที่ได้รับอนุญาตภายใต้ MIT สำหรับ Claude Code และ Codex ซึ่งสร้างขึ้นจากทักษะที่นำกลับมาใช้ซ้ำได้จำนวนเล็กน้อย มันเป็นโครงสร้างเริ่มต้น ไม่ใช่สิ่งทดแทนสำหรับขั้นตอน CI และการตรวจสอบที่กล่าวมาข้างต้น คุณยังคงต้องชี้ไปยัง test scenarios และกฎความเสี่ยงของคุณเอง
สิ่งที่ไม่ควรสร้าง
อย่าพยายามสร้าง Perf Factory, Sevbot หรือ agentic deploy ที่มีแดชบอร์ดที่สร้างขึ้นเองใหม่ทั้งหมด สิ่งเหล่านี้เป็นระบบภายในของ OpenAI ที่เชื่อมต่อกับ telemetry ที่ทีมส่วนใหญ่ไม่ได้ใช้งาน มนุษย์ที่ OpenAI ยังคงเป็นผู้กำหนดผลลัพธ์ที่ต้องการ, อนุมัติการเปลี่ยนแปลงที่มีความเสี่ยงสูง, อนุญาตการบรรเทาเหตุการณ์ และเข้าเวร (oncall); ตามที่ OpenAI กล่าวไว้ว่า "การเข้าเวรไม่ใช่เรื่องในอดีต" คัดลอกส่วนของวงจรที่เป็นวินัยทางวิศวกรรมที่ดีเท่านั้น: ตรวจสอบก่อนการรวม, จัดระดับความเสี่ยงตามสิ่งที่เปลี่ยนแปลงไปจริง, และให้มนุษย์ดูแลสิ่งที่ไม่ปลอดภัยอย่างชัดเจน
ทำให้วงจรทำงาน
เริ่มต้นด้วยขั้นตอน CI; มันจะทำให้ขั้นตอนอื่นๆ ทั้งหมดน่าเชื่อถือ สร้าง test scenario ของ Orders API ของคุณใน Apidog ซึ่งครอบคลุมรหัสสถานะ, schema, การยืนยันตัวตน, และงบประมาณความล่าช้า เชื่อมต่อเข้ากับ pipeline ของคุณด้วย CLI, ชี้ /goal ไปที่ประเด็นจริง, และให้ Codex ทำงานวนซ้ำกับการตรวจสอบที่ยืนยันพฤติกรรม API จริงๆ แทนที่จะเชื่อคำพูดของ Agent ดาวน์โหลด Apidog เพื่อสร้าง scenario แรก จากนั้นเพิ่มขั้นตอนการตรวจสอบและ flag เมื่อวงจรพิสูจน์ตัวเองแล้ว