
โมเดลแปลงเสียงเป็นข้อความแบบโอเพนซอร์สที่ดีที่สุดในเดือนตุลาคม 2026 คือ Nemotron 3.5 Transcribe ของ NVIDIA ซึ่งเปิดตัวเมื่อวันที่ 28 ตุลาคม บน Hugging Face Open ASR Leaderboard ที่อัปเดตในวันเดียวกัน มันมีค่าเฉลี่ยอัตราความผิดพลาดของคำ (word error rate) 5.33% และอยู่ในอันดับที่ 9 จาก 61 โมเดล ทั้งแปดโมเดลที่อยู่เหนือขึ้นไปเป็น API เชิงพาณิชย์แบบปิด OpenAI whisper-large-v3 ซึ่งยังเป็นค่าเริ่มต้นในบทแนะนำหลายแห่ง อยู่ในอันดับที่ 41 ที่ 7.16%
ด้านล่างนี้คือเก้าโมเดลการรู้จำเสียงแบบ open-weight ที่น่าพิจารณาในตอนนี้ จัดอันดับตาม leaderboard นั้น พร้อมความเร็ว จุดแข็ง และงานที่แต่ละตัวเหมาะสม ตัวเลข WER และความเร็วทั้งหมดมาจาก leaderboard ณ วันที่ 29 ตุลาคม 2026
หากคุณกำลังเลือกระหว่าง hosted API แทน อ่าน คู่มือ Nemotron 3.5 Transcribe API และ คู่มือ Whisper API ของเรา
วิธีที่เราจัดอันดับ
Open ASR Leaderboard รันทุกโมเดลบนชุดทดสอบภาษาอังกฤษชุดเดียวกัน: การประชุม (AMI), สายการเงิน (Earnings22), พอดแคสต์และ YouTube (GigaSpeech), หนังสือเสียง (LibriSpeech), สายการเงิน (SPGISpeech), เสียงรบกวน (URGENT24), เสียงสนทนา (Voice Arena Monsoon), คำกล่าวในรัฐสภา (VoxPopuli) และชุดส่วนตัวอีกสองชุด ตัวชี้วัดการจัดอันดับคือ WER เฉลี่ย โดยยิ่งต่ำยิ่งดี
เรายังแสดง RTFx ซึ่งเป็นมาตรวัดความเร็วของ leaderboard: จำนวนวินาทีของเสียงที่ถอดความเป็นข้อความต่อวินาทีของการประมวลผล ยิ่งสูงยิ่งเร็ว API แบบปิดแสดง “NA” เพราะไม่สามารถจับเวลาบนฮาร์ดแวร์เดียวกันได้
เรานับโมเดลเป็น open-weight เมื่อ checkpoint ของมันดาวน์โหลดได้ และ leaderboard รายงาน RTFx สำหรับมัน ตรวจสอบสัญญาอนุญาตแต่ละรายการก่อนใช้เชิงพาณิชย์
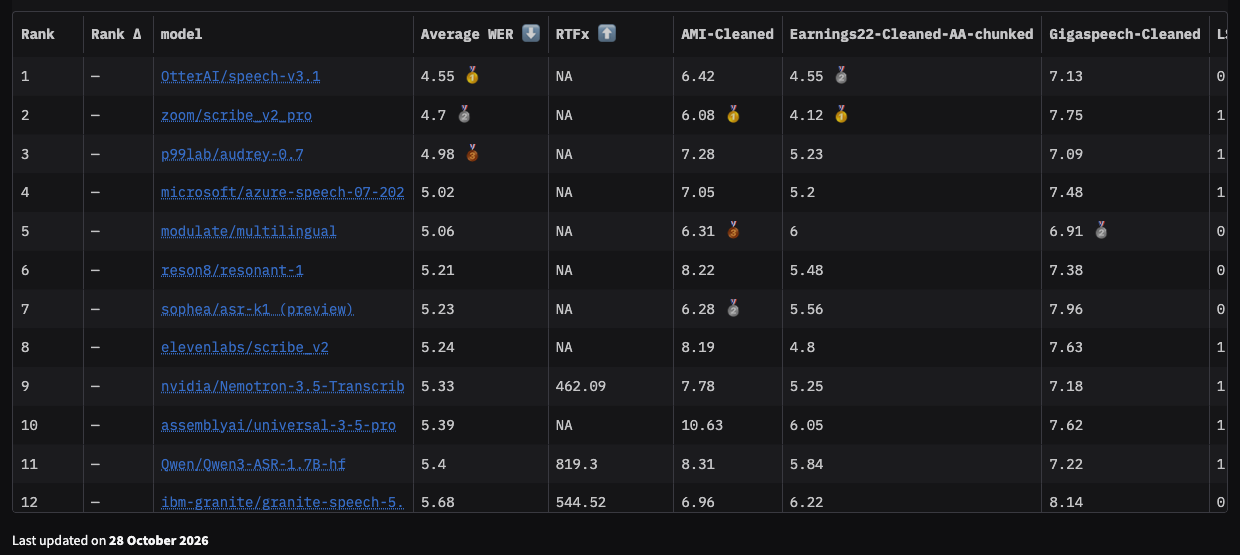
ภาพรวมการจัดอันดับ
| อันดับ (open) | โมเดล | WER เฉลี่ย | RTFx | อันดับรวม |
|---|---|---|---|---|
| 1 | NVIDIA Nemotron 3.5 Transcribe 30B-A4B | 5.33% | 462 | 9 |
| 2 | Qwen3-ASR-1.7B | 5.40% | 819 | 11 |
| 3 | IBM Granite Speech 5.0 2B | 5.68% | 545 | 12 |
| 4 | Cohere Transcribe (03-2026) | 5.77% | 902 | 14 |
| 5 | TheStage AI Whisper large-v3 turbo | 5.91% | 1,177 | 17 |
| 6 | NVIDIA Canary-Qwen 2.5B | 5.94% | 862 | 21 |
| 7 | NVIDIA Parakeet TDT 0.6B (versions) | 5.98% ถึง 6.18% | ไม่เปรียบเทียบ | 24 ถึง 31 |
| 8 | Mistral Voxtral Small 24B | 6.38% | ไม่เปรียบเทียบ | 35 |
| 9 | OpenAI Whisper large-v3 | 7.16% | ไม่เปรียบเทียบ | 41 |
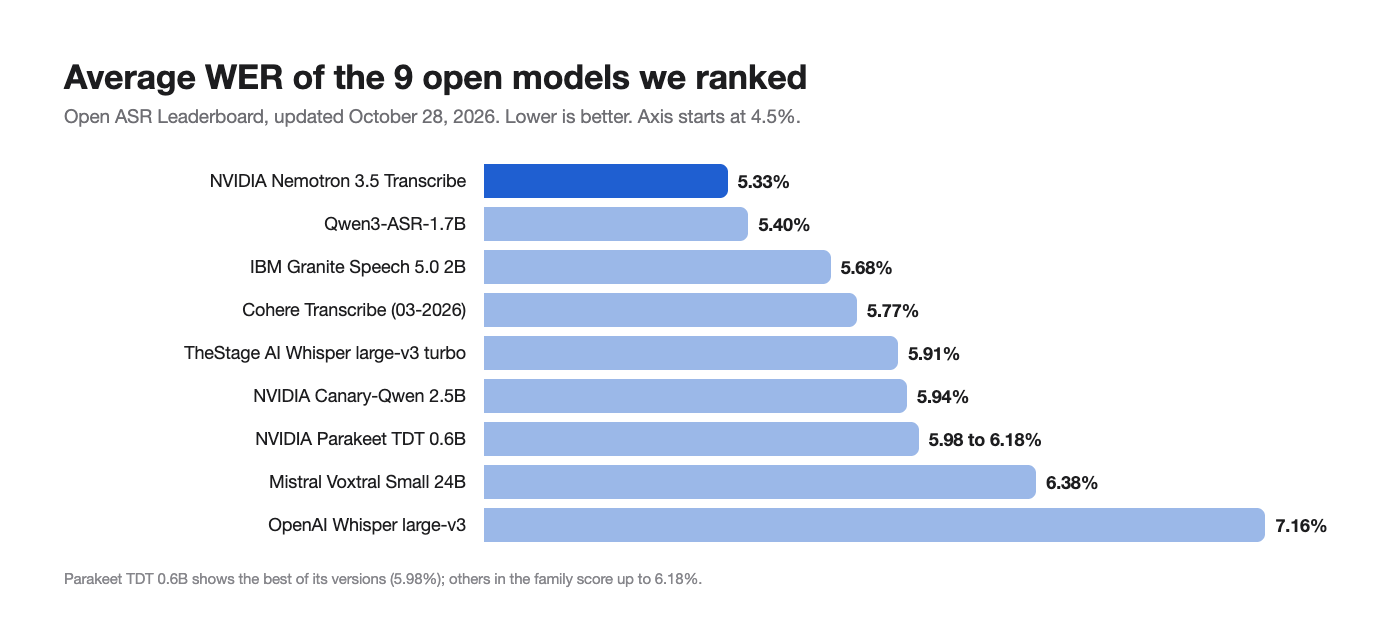
สำหรับบริบท API แบบปิดที่ดีที่สุดบนบอร์ดเดียวกัน: Otter speech-v3.1 ที่ 4.55%, Zoom Scribe v2 Pro ที่ 4.70%, ElevenLabs Scribe v2 ที่ 5.24%, AssemblyAI Universal-3.5 Pro ที่ 5.39% และ OpenAI gpt-transcribe ที่ 5.96% Nemotron 3.5 Transcribe เอาชนะ AssemblyAI และโมเดลโฮสต์ของ OpenAI ขณะที่ดาวน์โหลดได้ฟรี
1. NVIDIA Nemotron 3.5 Transcribe: ดีที่สุดโดยรวม
5.33% WER, RTFx 462, สัญญาอนุญาต OpenMDW-1.1
โมเดลใหม่ของ NVIDIA ไม่ใช่เครือข่าย ASR แบบคลาสสิก แต่เป็นโมเดลภาษาที่เสริมด้วยเสียง: encoder ASR ขนาด 600M พารามิเตอร์ และ speaker encoder ป้อนเข้าสู่ LLM แบบผสม Mamba-2 และ Transformer mixture-of-experts ที่มีพารามิเตอร์รวม 34B และ active ประมาณ 4.3B การออกแบบนี้จึงทำให้มันทำได้มากกว่าการถอดเสียง
เหตุผลที่มันอยู่อันดับหนึ่ง:
- 40 ภาษา โดย 13 ภาษาถูกจัดว่า “ชั้นนำ”
- ไฟล์หนึ่งชั่วโมงในรอบเดียว โดยมี context 65,536 โทเคน
- การระบุผู้พูด (สูงสุดแปดคน) และ timestamps ระดับคำจากโมเดลเดียว
- Prompts: คำพูดแบบคำต่อคำหรือแบบเรียบเรียง, คำศัพท์บริบทสำหรับศัพท์เฉพาะ, การแปล
- ความแม่นยำแบบยาว: WER เฉลี่ย 10.98% บนชุด long-form ของ leaderboard เทียบกับ 13.37% สำหรับ Parakeet-TDT-0.6B-v3 ตามการ์ดโมเดล
- การประชุม: cpWER เฉลี่ย 15.80% บนชุดผู้พูดหลายคน ดีกว่า pipeline DiCoW + DiariZen ที่ 16.83%
ข้อแลกเปลี่ยน: ต้องใช้ GPU ใหญ่ (H100 80 GB หนึ่งตัวใน BF16 หรือ RTX 5090 กับ weights NVFP4) ไม่สตรีม และการตอบคำถามจากเสียงรองรับเฉพาะภาษาอังกฤษ
เลือกใช้เมื่อ: การประชุม พอดแคสต์ สายการเงิน คลังหลายภาษา และงานที่ป้ายชื่อผู้พูดหรือไฟล์หนึ่งชั่วโมงสำคัญ เริ่มจากเส้นทางฟรี หรือรันในเครื่อง
2. Qwen3-ASR-1.7B: ความแม่นยำต่อเงินที่จ่ายให้ GPU ดีที่สุด
5.40% WER, RTFx 819
Qwen3-ASR-1.7B ของ Alibaba ตามหลัง Nemotron เพียง 0.07 คะแนนในค่าเฉลี่ยภาษาอังกฤษ ขณะที่ทำงานเร็วประมาณ 1.8 เท่าบนฮาร์ดแวร์ของ leaderboard จากโมเดลที่มีขนาดรวมเล็กกว่าหนึ่งในยี่สิบ ในการเปรียบเทียบหลายภาษเจ็ดภาษาของ NVIDIA เอง Nemotron นำชัดกว่า: WER เฉลี่ย 4.62% เทียบกับ 6.49%
เลือกใช้เมื่อ: การถอดเสียงแบบกลุ่มที่เน้นอังกฤษบน GPU เล็กลง ซึ่งคุณไม่ต้องการการระบุผู้พูดในตัว หากคุณใช้โมเดล multimodal ของ Qwen อยู่แล้ว ดูคู่มือQwen3.5-Omni ของเรา
3. IBM Granite Speech 5.0 2B: ดีที่สุดกับเสียงประชุมเมื่อเทียบตามขนาด
5.68% WER, RTFx 545
Granite Speech 5.0 ของ IBM ทำ WER 6.96% บนบันทึกการประชุม AMI ซึ่งเป็นคะแนน AMI ที่ดีที่สุดในบรรดาหกโมเดลโอเพนซอร์สชั้นนำที่นี่ และดีกว่า Nemotron ที่ 7.78% บนชุดนั้น จุดอ่อนของมันคือสายการเงิน SPGISpeech ที่ 3.36%
เลือกใช้เมื่อ: ทีมองค์กรที่ใช้สแต็ก Granite ของ IBM เป็นมาตรฐาน และการถอดเสียงประชุมบน GPU ระดับกลาง
4. Cohere Transcribe: เร็วและแม่นยำ
5.77% WER, RTFx 902
โมเดลถอดเสียงเดือนมีนาคม 2026 ของ Cohere Labs จับคู่คะแนนความแม่นยำโอเพนซอร์สระดับห้าอันดับแรกกับความเร็วที่สูงที่สุดแห่งหนึ่งที่นี่ จุดแข็งที่สุดคือ LibriSpeech (0.97% clean, 2.05% other) และอ่อนกว่าบน VoxPopuli ที่ 5.38%
เลือกใช้เมื่อ: pipeline ภาษาอังกฤษปริมาณมากที่ throughput สำคัญพอๆ กับความแม่นยำ
5. TheStage AI Whisper large-v3 turbo: เร็วที่สุดในกลุ่มชั้นนำ
5.91% WER, RTFx 1,177
นี่คือบิลด์ Whisper large-v3 turbo ที่ปรับแต่งจาก TheStage AI และเป็นโมเดลที่เร็วที่สุดในรายการของเรา มันได้ 1.62% บน SPGISpeech ซึ่งเป็นคะแนนดีที่สุดอันดับสามบนชุดนั้นจากทั้ง 61 โมเดล มันแสดงให้เห็นว่าตระกูล Whisper ยังมีชีวิตอีกมากเมื่อมีคนปรับแต่ง
เลือกใช้เมื่อ: ทีมที่มีโค้ด Whisper อยู่แล้วและต้องการอัปเกรดความเร็วและความแม่นยำแบบแทนที่ได้ทันที
6. NVIDIA Canary-Qwen 2.5B: เรือธง NVIDIA รุ่นก่อน
5.94% WER, RTFx 862
Canary-Qwen เป็นโมเดลเสียงบวก LLM รุ่นก่อนของ NVIDIA และ Nemotron 3.5 Transcribe มาแทนที่ในตำแหน่งสูงสุด มันยังเร็ว และคะแนน SPGISpeech 1.70% ยอดเยี่ยม ในการทดสอบ preference-ASR ของ NVIDIA Nemotron ได้ 7.56% เทียบกับ Canary-Qwen ที่ 8.16%
เลือกใช้เมื่อ: การติดตั้ง NeMo ที่มีอยู่ซึ่งยังย้ายไป GPU 80 GB ไม่ได้
7. NVIDIA Parakeet TDT 0.6B: ตัวเลือกจริงจังที่เล็กที่สุด
5.98% ถึง 6.18% WER ในแต่ละเวอร์ชัน
Parakeet TDT มีหลายเวอร์ชันขนาด 0.6B พารามิเตอร์บนบอร์ด ทุกเวอร์ชันต่างกันประมาณ 0.2 คะแนน ที่ 600M พารามิเตอร์ มันเป็นโมเดลที่เล็กที่สุดที่นี่ที่ยังคงใกล้ 6% WER จึงรันบน GPU ขนาดพอประมาณได้ จุดอ่อนของมันคือเสียงแบบยาว ซึ่ง Nemotron เอาชนะได้มากกว่าสองคะแนน
เลือกใช้เมื่อ: อุปกรณ์ edge, GPU ราคาถูก และคลิปสั้นเช่นคำสั่งเสียงหรือตัวอย่างสาย
8. Mistral Voxtral Small 24B: เสียงบวก LLM ที่แข็งแกร่ง
6.38% WER
Voxtral Small จับคู่อินพุตเสียงกับโมเดลภาษา Mistral 24B ดังนั้นเช่นเดียวกับ Nemotron มันสามารถตอบคำถามเกี่ยวกับเสียง ไม่ใช่แค่ถอดเสียง มันตามหลังห้าอันดับแรกใน WER ล้วนๆ การเปรียบเทียบ Voxtral กับ Whisper ของเราครอบคลุมการเปิดตัวก่อนหน้าอย่างละเอียด
เลือกใช้เมื่อ: ผู้ช่วยเสียงและ Q&A เสียงที่โมเดลภาษาสำคัญกว่าคะแนน WER จุดสุดท้าย
9. OpenAI Whisper large-v3: Baseline
7.16% WER, อันดับรวม 41
Whisper large-v3 ยังเป็นโมเดลโอเพนซอร์สที่ถูกนำไปใช้กว้างที่สุด โดยมีระบบนิเวศ wrapper, fine-tune และบทแนะนำมากที่สุด ในด้านความแม่นยำตอนนี้มันตามหลังทุกโมเดลอื่นในรายการนี้ หากคุณรันมันในโปรดักชัน การเปลี่ยนไปใช้หนึ่งในหกอันดับแรกคือการอัปเกรดคุณภาพที่ถูกที่สุดที่มี
เลือกใช้เมื่อ: ต้นแบบที่พึ่งพาเครื่องมือเฉพาะ Whisper หรือเป็น baseline ที่ต้องเอาชนะ
คุณควรเลือกอันไหน?
| งานของคุณ | เลือก |
|---|---|
| การประชุมที่มีผู้พูดหลายคน | Nemotron 3.5 Transcribe |
| พอดแคสต์หรือสายหนึ่งชั่วโมงในรอบเดียว | Nemotron 3.5 Transcribe |
| คลังหลายภาษา | Nemotron 3.5 Transcribe |
| งานแบบกลุ่มภาษาอังกฤษบน GPU เล็กลง | Qwen3-ASR-1.7B |
| Throughput สูงสุด | TheStage Whisper large-v3 turbo หรือ Cohere Transcribe |
| ฮาร์ดแวร์ edge หรือต้นทุนต่ำ | Parakeet TDT 0.6B |
| Q&A เสียงบวกการถอดเสียง | Nemotron 3.5 Transcribe หรือ Voxtral Small |
| โค้ด Whisper ที่มีอยู่ เปลี่ยนแปลงน้อยที่สุด | TheStage Whisper large-v3 turbo |
ข้อควรระวังหนึ่งอย่าง: ค่าเฉลี่ยของ leaderboard ซ่อนช่องว่างตามโดเมน Nemotron ดีที่สุดโดยรวม แต่ Granite เอาชนะมันบน AMI และหลายโมเดลเอาชนะมันบน LibriSpeech ทดสอบสองหรือสามอันดับแรกกับบันทึกของคุณเอง 50 ถึง 100 รายการก่อนตัดสินใจ
วัดประสิทธิภาพผู้เข้าชิงด้วย coding agent และ Apidog CLI
วิธีที่เร็วที่สุดในการทำ bake-off คือให้ coding agent ของคุณทำ เสิร์ฟสองหรือสามโมเดลหลัง endpoint /v1/audio/transcriptions สไตล์ OpenAI (SGLang-Omni เสิร์ฟ Nemotron แบบนี้) จากนั้นให้ agent สร้างและรันการตรวจสอบเดียวกันกับแต่ละตัวด้วย Apidog CLI
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้ prompt หนึ่งข้อกับ agent ของคุณ:
In Apidog project <id>, create one environment per speech server (nemotron, qwen3-asr,
whisper) with its baseUrl. Create test cases that POST each file in samples/ to
{{baseUrl}}/v1/audio/transcriptions, assert status 200 and non-empty text, and save the
transcript to a variable. Run the cases against each environment and give me a table
of failures and response times per server.
Agent อ่าน schema ตรวจสอบ payload เขียนเคสและรันตาม environment:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
ให้คะแนน transcript ที่บันทึกไว้เทียบกับข้อความอ้างอิงด้วยสคริปต์ WER ใดก็ได้ และเก็บ run ของ environment ที่ชนะใน CI ด้วย -r junit ดู Apidog CLI ใน Claude Code และ Apidog CLI ใน CI/CD pipeline
คำถามที่พบบ่อย
โมเดลแปลงเสียงเป็นข้อความโอเพนซอร์สที่แม่นยำที่สุดคืออะไร? NVIDIA Nemotron 3.5 Transcribe ที่ WER เฉลี่ย 5.33% บน Open ASR Leaderboard วันที่ 28 ตุลาคม 2026
Whisper ยังดีอยู่ไหม? มันใช้ได้ แต่ whisper-large-v3 อยู่อันดับ 41 ที่ 7.16% บิลด์ Whisper ที่ปรับแต่งเช่น large-v3 turbo ของ TheStage ได้ 5.91%
โมเดลโอเพนซอร์สตัวไหนเร็วที่สุด? ในบรรดาโมเดลที่นี่ TheStage AI Whisper large-v3 turbo ที่ RTFx 1,177
โมเดลโอเพนซอร์สเอาชนะ API แบบเสียเงินได้แล้วหรือ? บางตัว Nemotron 3.5 Transcribe เอาชนะ AssemblyAI Universal-3.5 Pro (5.39%) และ OpenAI gpt-transcribe (5.96%) Otter, Zoom และ ElevenLabs ยังนำโดยรวม สำหรับตัวเลือกโฮสต์ ดูสรุป API แปลงเสียงเป็นข้อความ ของเรา
ตัวไหนรองรับ speaker diarization? Nemotron 3.5 Transcribe ทำในโมเดลเดียวกัน สูงสุดแปดผู้พูด ตัวอื่นส่วนใหญ่ต้องมีขั้นตอน diarization แยก
คำตัดสิน
สำหรับทีมส่วนใหญ่ในปลายปี 2026 เริ่มด้วย Nemotron 3.5 Transcribe หากคุณมี GPU 80 GB หรือจ่าย $0.12 ต่อชั่วโมงบน hosted API ได้ เลือก Qwen3-ASR-1.7B เมื่องบ GPU ตึง และ Parakeet เมื่อฮาร์ดแวร์ตึงยิ่งกว่า ไม่ว่าคุณจะเลือกอะไร ทดสอบกับเสียงของคุณเอง และให้ agent ของคุณรันการตรวจสอบ Apidog ต่อไปเพื่อให้โมเดลที่คุณเลือกยังทำงานได้ดีหลังทุกการอัปเกรด