คำตอบแบบสรุปย่อ: การเรียกใช้เครื่องมือแบบอะซิงโครนัส (Async tool calls) สำหรับ AI Agent คือการแยกคำสั่ง run() แบบบล็อกการทำงาน (blocking) ออกเป็นข้อตกลงย่อยๆ ได้แก่ start() ส่งคืน Job handle กลับมาทันที, status() รายงานความคืบหน้า, stop() ใช้ยกเลิกงาน และผลลัพธ์จะถูกส่งกลับมาภายหลังในรูปแบบของ Event ที่ Agent จะอ่านในรอบการทำงาน (turn) ถัดไป ทำให้ Agent ยังสามารถสนทนาและรับคำสั่งใหม่ๆ ได้อย่างต่อเนื่องในระหว่างที่งานที่ใช้เวลานานกำลังทำงานอยู่เบื้องหลัง
ทุกวันนี้ Agent ส่วนใหญ่ยังคงใช้วิธีเรียกใช้เครื่องมือแล้วหยุดรอ หากคุณถามคำถามที่สองในระหว่างที่ระบบกำลังรันชุดทดสอบนาน 6 นาที คำถามนั้นก็ต้องค้างรออยู่ในคิว พฤติกรรมนี้อาจไม่เป็นปัญหาสำหรับการค้นหาข้อมูลที่ใช้เวลาเพียง 200 มิลลิวินาที แต่มันจะกลายเป็นเรื่องน่าหงุดหงิดทันทีเมื่องานนั้นเป็นการ Deploy หรือการ Crawl ข้อมูล
บทความวิจัยล่าสุดจากทีม DeepSeek Harness ในชื่อ “Exploring Super-agent Design” ได้นำเสนอทางออกสำหรับปัญหานี้เรียกว่า "Full-duplex" ซึ่งเป็นการแทนที่คำสั่ง run() แบบบล็อกการทำงานด้วย start() และ stop() โดยคู่มือนี้จะเจาะลึกการทำงานในฝั่ง Agent Loop ทั้งข้อตกลงของเครื่องมือ (Tool contract), รูปแบบการส่งผลลัพธ์กลับเข้ามา, การยกเลิกงาน ตลอดจนโครงสร้าง API ที่เครื่องมือแต่ละตัวต้องการ สำหรับการจัดการการเรียก HTTP ที่ใช้เวลานาน สามารถอ่านเพิ่มเติมได้ที่ AI Agents and Long-Running API Calls: Polling vs Webhooks
การเรียกใช้เครื่องมือแบบอะซิงโครนัส (Async Tool Calls) ใน Agent Loop คืออะไร?
การเรียกใช้เครื่องมือแบบอะซิงโครนัส คือการเรียกใช้งานเครื่องมือที่ส่งคืน Handle แทนที่จะส่งผลลัพธ์สุดท้ายกลับมาในทันที โดย Agent Loop จะบันทึก Handle นั้นไว้ จบรอบการทำงานของตัวเอง และพร้อมรับคำสั่งใหม่จากผู้ใช้ต่อไป เมื่อการทำงานเบื้องหลังเสร็จสิ้น Runtime จะส่ง Completion Event แทรกเข้ามาในการสนทนา และโมเดลจะอ่านข้อความนั้นในรอบถัดไปเหมือนกับข้อความทั่วไป
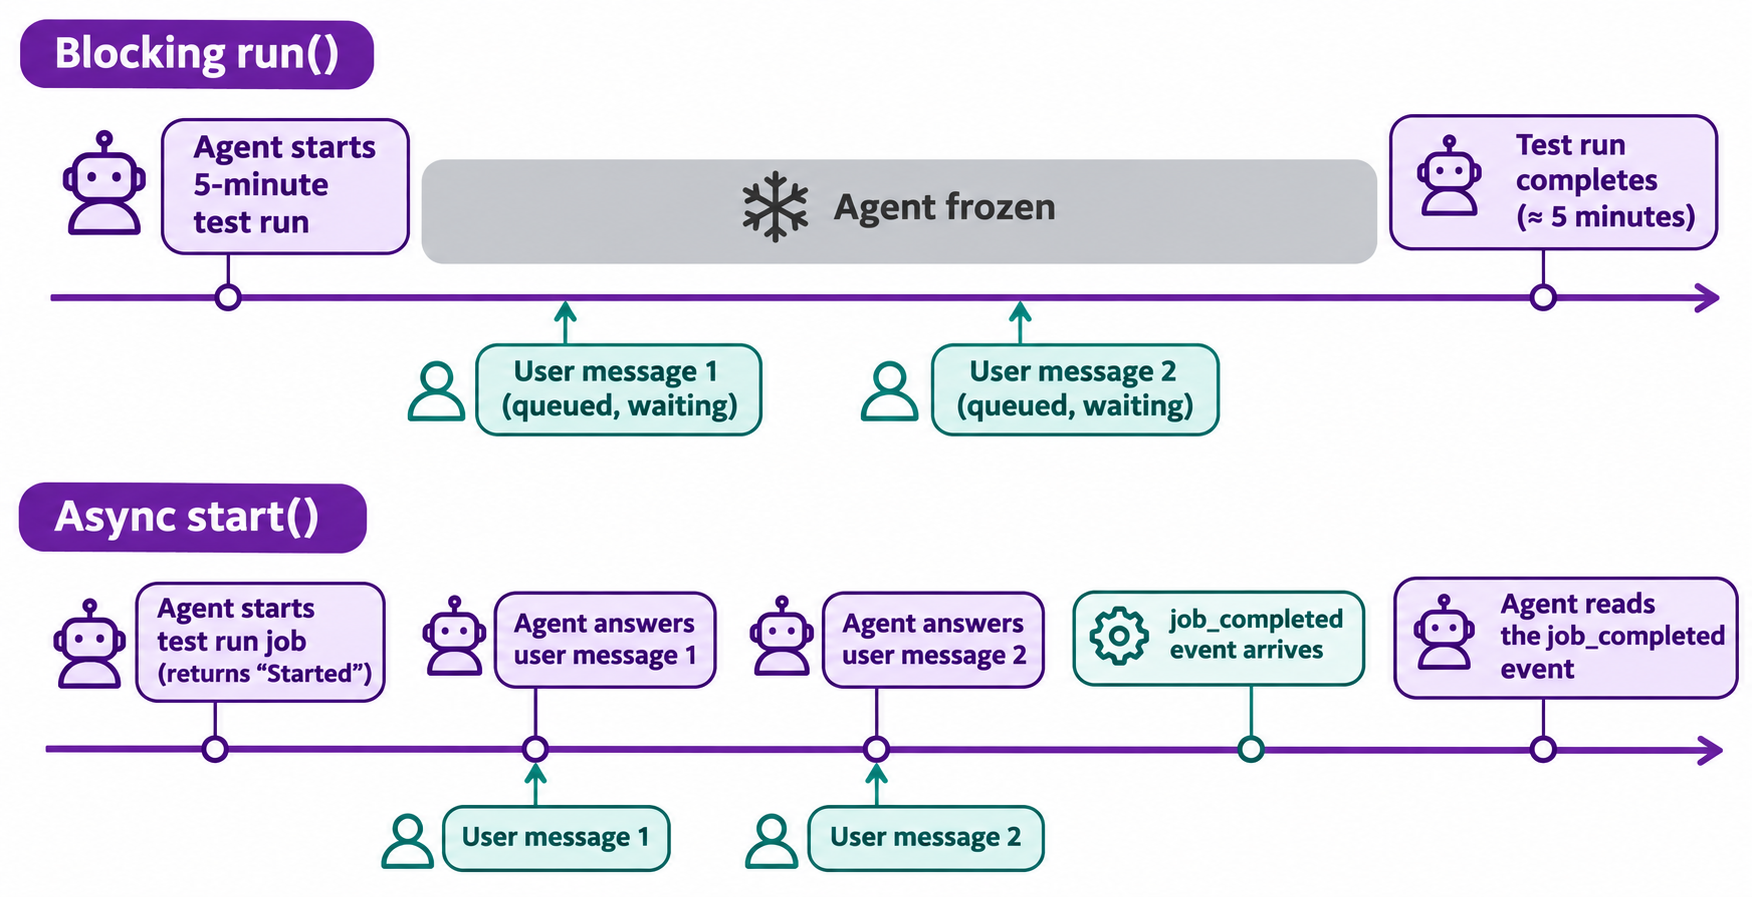
ความแตกต่างอยู่ที่ว่า “ใครเป็นคนรอ”: ถ้าเป็น run() ตัวโมเดลจะต้องรอ แต่ถ้าเป็น start() ฝั่ง Runtime จะเป็นผู้รับหน้าที่รอแทน
Blocking run() |
Async start() |
|
|---|---|---|
| สิ่งที่ส่งกลับมา | ผลลัพธ์สุดท้าย | Job id, “Started” |
| สถานะของ Agent ขณะทำงาน | หยุดนิ่ง (ค้างรอ) | ยังพูดคุย วางแผน หรือเริ่มงานอื่นๆ ได้ |
| ข้อความใหม่จากผู้ใช้ | ติดคิวรอจนกว่าเครื่องมือจะทำงานเสร็จ | จัดการได้ทันที |
| การยกเลิก | ต้องยุติการทำงานทั้งรอบ | stop(job_id) |
บทความของ DeepSeek อธิบายแนวคิดนี้ในเชิงสถาปัตยกรรม ไม่ใช่ฟีเจอร์สำเร็จรูปที่พร้อมเปิดสวิตช์ใช้งาน โดยระบุว่าระบบ Full-duplex ได้รับการพัฒนาไว้ใน DeepSeek Harness แล้วแต่ยังไม่ได้เปิดใช้งานเป็นค่าเริ่มต้น และมีบางส่วนอยู่ในปลั๊กอินต้นแบบชื่อ dsh-superagent-prototype ซึ่งผู้เขียนระบุชัดเจนว่าไม่ใช่ผลิตภัณฑ์อย่างเป็นทางการของ DeepSeek จึงควรมองว่าเป็นแนวทางการออกแบบสำหรับนำไปปรับใช้ สำหรับข้อมูลเบื้องหลัง สามารถดูเพิ่มเติมได้ที่ DeepSeek Harness คืออะไร และบทความแนะนำ วิธีสร้าง Super Agent
ปัญหาของการบล็อก: เครื่องมือที่ทำงานช้าเพียงตัวเดียวทำให้ Agent หยุดชะงักทั้งระบบ
ลองนึกภาพ Coding Agent ที่ได้รับคำสั่งให้รันชุดทดสอบ (ใช้เวลา 5 นาที) พร้อมกับตอบคำถามเกี่ยวกับ Import ที่ทำงานผิดพลาด หากใช้การเรียกแบบบล็อก คำถามของคุณจะต้องรอให้ชุดทดสอบรันเสร็จก่อน ทั้งที่คำถามนั้นไม่ได้มีความเกี่ยวข้องกับผลการทดสอบเลย ซึ่งนำไปสู่ 3 ปัญหาหลัก:
- ความหน่วงสะสม (Latency stacks): เครื่องมือทุกตัวที่ทำงานช้าจะเพิ่มเวลาเข้าไปในการทำงานทั้งหมดที่ต่อคิวอยู่ด้านหลัง
- คำสั่งตกยุคหรือไม่ทันการณ์ (Instructions go stale): หากผ่านไป 2 นาทีแล้วคุณพิมพ์บอกว่า “ข้าม e2e test ไปเลยละกัน” ตัว Agent จะไม่สามารถรับรู้คำสั่งนี้ได้เลยจนกว่าการรันจะสิ้นสุด
- ปัญหาหมดเวลาเชื่อมต่อ (Timeouts bite): เกตเวย์มักจะตัดการเชื่อมต่อที่เปิดค้างไว้นานหลายนาที ทำให้คำสั่ง
run()ที่ยาวนานอาจล้มเหลว แม้ว่าตัวงานเบื้องหลังจะประมวลผลสำเร็จก็ตาม
บทความเรียกคุณสมบัติที่ทุกคนต้องการนี้ว่า "Productive" ซึ่งหมายถึง Agent สามารถรับคำสั่งถัดไปได้ทันทีโดยไม่ต้องรองานก่อนหน้าเสร็จ และการใช้เครื่องมือแบบอะซิงโครนัสคือหัวใจสำคัญที่ทำให้เกิดสิ่งนี้
start, status, stop: ข้อตกลงการทำงานของเครื่องมือแบบอะซิงโครนัส
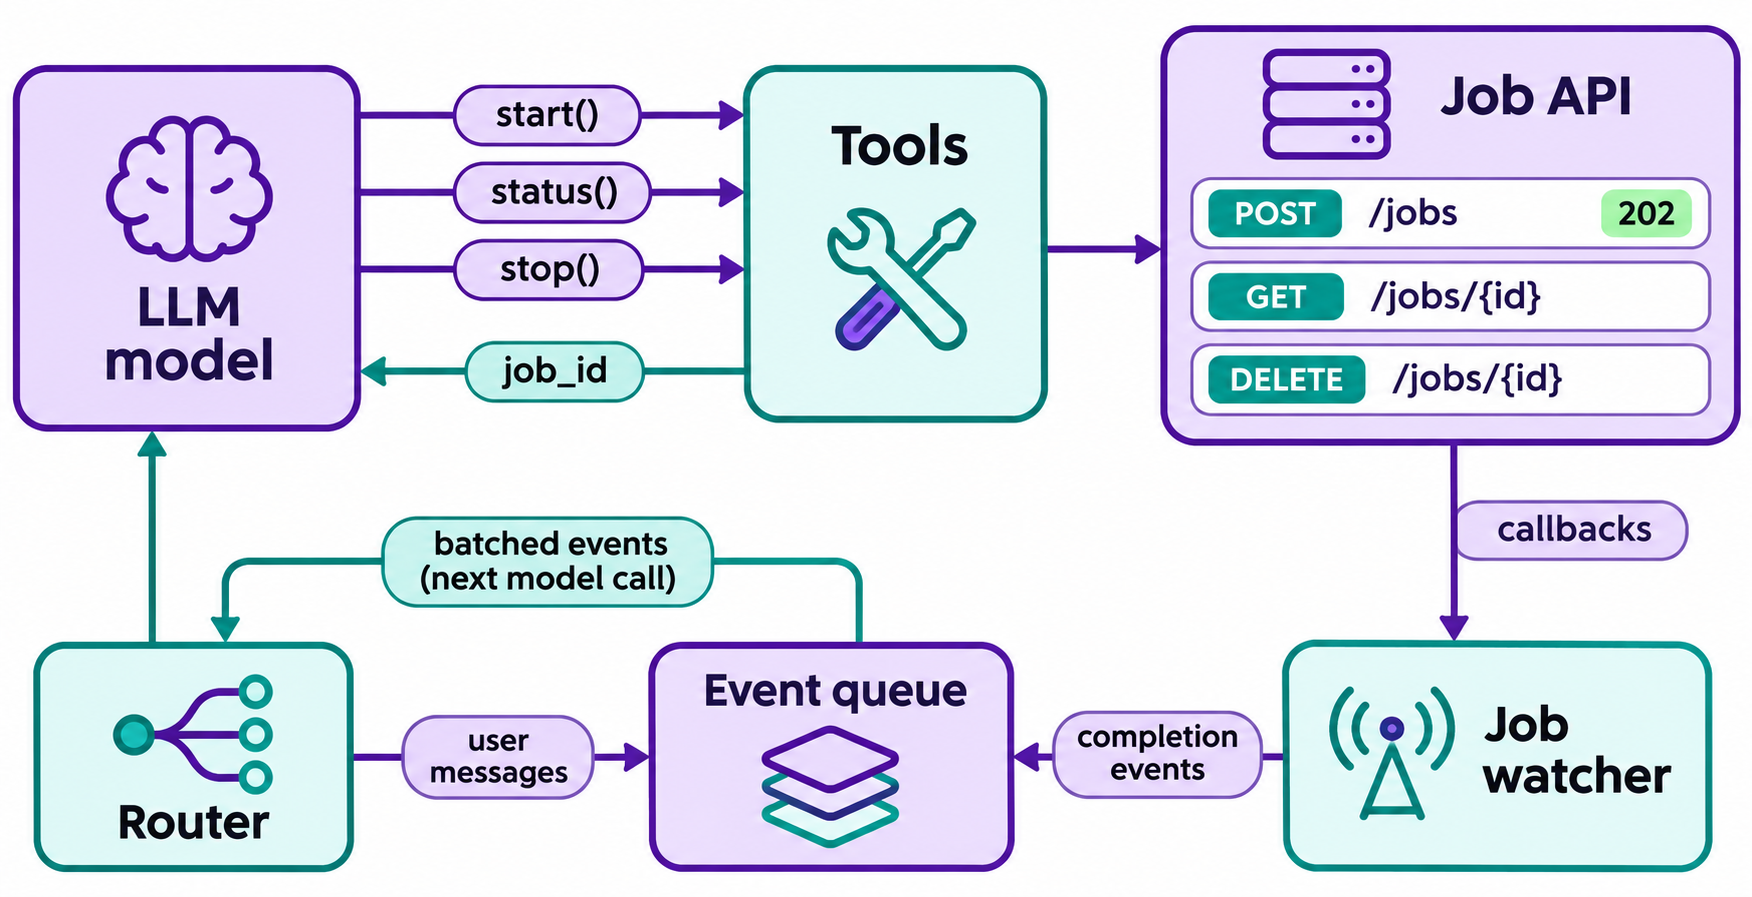
แทนที่จะให้โมเดลมีเครื่องมือเพียงตัวเดียวสำหรับงานที่ใช้เวลานาน ให้เปลี่ยนมาเตรียมเครื่องมือ 3 ตัวที่มีโครงสร้างข้อมูลขากลับขนาดกะทัดรัด
{
  "name": "start_test_run",
  "description": "Start the test suite. Returns immediately with a job_id. The result arrives later as a job_completed event; do not wait for it.",
  "input_schema": {
    "type": "object",
    "properties": {
      "suite": { "type": "string", "enum": ["unit", "e2e", "all"] },
      "idempotency_key": { "type": "string" }
    },
    "required": ["suite", "idempotency_key"]
  }
}
คำสั่ง start_test_run จะส่งคืนเพียง {"job_id": "job_8f2", "status": "queued"} เท่านั้น ส่วน get_job_status(job_id) จะส่งคืนสถานะ queued, running, done หรือ failed พร้อมข้อความสั้นๆ ระบุความคืบหน้า และ stop_job(job_id) จะส่งคำขอยกเลิกงานพร้อมรายงานสถานะล่าสุดที่ไปถึง
มีกฎสองข้อที่จะช่วยให้โมเดลทำงานได้อย่างถูกต้อง: ระบุใน Description ชัดเจนว่า “ไม่ต้องรอ (do not wait)” มิเช่นนั้นโมเดลจะคอยเรียก get_job_status ซ้ำๆ ถี่ๆ (Tight loop) และห้ามส่งข้อมูลผลลัพธ์กลับมาจาก start เป็นอันขาด เพราะจะทำให้โมเดลต้องมาคอยคาดเดารูปแบบข้อมูลที่ได้รับ
รูปแบบการส่งผลลัพธ์กลับเข้ามาในลูป
การให้โมเดลเป็นฝ่ายทำ Polling คอยสอบถามสถานะควรเป็นเพียงแผนสำรอง ไม่ใช่แนวทางหลัก การออกแบบที่ดีกว่าคือการให้ Runtime คอยเฝ้าติดตามสถานะของงาน แล้วส่ง Push Completion Event เข้ามาในการสนทนาเสมือนเป็นข้อความใหม่ข้อความหนึ่ง:
[event] job_completed job_id=job_8f2 tool=start_test_run status=done
summary: 412 passed, 3 failed (auth/session.test.ts)
details: get_job_result(job_8f2)
รักษาขนาดของ Event ให้สั้นกระชับ และเก็บข้อมูลผลลัพธ์ฉบับเต็มไว้ให้เรียกดูผ่านเครื่องมือ Fetch เพื่อป้องกันไม่ให้ Log ขนาดยาว 40,000 บรรทัดหลุดเข้าไปกินพื้นที่ Context
จากนั้นให้นำระบบ Batching มาใช้ โดยบทความของ DeepSeek อธิบายถึงตัว Router ที่ทำหน้าที่รวบรวมทริกเกอร์ต่างๆ ที่เข้ามาในระหว่างรอบการทำงาน แล้วนำมารวมกันสำหรับการเรียกใช้โมเดลในรอบถัดไป ซึ่งประกอบด้วย Input ที่ยาวและ Output ที่สั้น โดยรวมไว้ในขั้นตอน Prefill ในการทดลองของพวกเขา อัตราทริกเกอร์เพิ่มขึ้นจาก 1 เป็น 40 ครั้งต่อนาที ขนาดแบทช์เฉลี่ยเพิ่มขึ้นจาก 1.0 เป็น 2.8 และเวลาที่ใช้ต่อการตัดสินใจหนึ่งครั้งลดลงจาก 6.4 วินาทีเหลือเพียง 1.6 วินาที ตัวเลขเหล่านี้เป็นผลการทดสอบเฉพาะในการวิจัย ไม่ใช่เกณฑ์มาตรฐานทั่วไป แต่การเรียกโมเดลครั้งเดียวที่อ่านได้ 3 อีเวนต์ย่อมดีกว่าการเรียก 3 ครั้งเพื่ออ่านทีละอีเวนต์อย่างแน่นอน กฎง่ายๆ คือ ในระหว่างที่โมเดลกำลังประมวลผลคำตอบ ให้เก็บอีเวนต์และข้อความของผู้ใช้เข้าคิวไว้ และเมื่อจบรอบการทำงาน จึงส่งข้อมูลเหล่านั้นเข้าไปพร้อมกันตามลำดับที่ได้รับ
ลำดับการประมวลผล การยกเลิก และ Idempotency Keys
ลำดับการประมวลผล (Ordering): งานต่างๆ อาจเสร็จสิ้นโดยไม่เรียงตามลำดับ หากงาน B จำเป็นต้องรองาน A ต้องกำหนดความเกี่ยวข้องกันให้ชัดเจน ไม่ว่าจะด้วยการเริ่มงาน B หลังจากได้รับ Completion Event ของงาน A แล้วเท่านั้น หรือออกแบบให้ API รองรับพารามิเตอร์ depends_on
การยกเลิก (Cancellation): คำสั่ง stop เป็นเพียงคำร้องขอ ไม่ใช่การรับประกันว่าจะยกเลิกได้ทันที ดังนั้นควรส่งสถานะสุดท้ายที่แท้จริงกลับมา (เช่น cancelled หรือ done หากงานเสร็จสิ้นไปก่อนหน้าแล้ว) เพื่อให้โมเดลสามารถรายงานต่อผู้ใช้ได้อย่างตรงไปตรงมา ส่วนขยาย Tasks ของ MCP ก็ใช้แนวทางเดียวกัน โดยเอกสารระบุว่าการยกเลิกเป็นแบบประสานความร่วมมือ (Cooperative) ดังนั้น Task จึงอาจเข้าสู่สถานะสิ้นสุดอื่นที่ไม่ใช่ cancelled ได้เช่นกัน
Idempotency Keys: โมเดลมักจะลองส่งคำขอซ้ำ (Retry) เสมอ ดังนั้นหากการเชื่อมต่อหลุด อาจทำให้เกิดการเรียกคำสั่ง start ซ้ำรอบสอง จึงควรกำหนดให้มี idempotency_key ในทุกคำสั่ง start และออกแบบให้ API ส่งคืนข้อมูลของ Job เดิมเมื่อพบ Key ซ้ำ หากไม่มีระบบนี้ คำสั่งอย่าง “รัน migration” อาจถูกทำงานซ้ำสองรอบได้
ผลลัพธ์บางส่วน (Partial results): นำเสนอข้อมูลผลลัพธ์เบื้องต้น (เช่น ข้อมูล 50 หน้าแรกที่ Crawl ได้) ผ่านคำสั่ง get_job_result(job_id, cursor) แทนที่จะต้องรอให้งานทั้งหมดเสร็จสมบูรณ์
การจัดการพื้นที่ Context: เมื่อโมเดลประมวลผลงานที่เสร็จสิ้นแล้ว ให้สรุปข้อมูลของงานเหล่านั้นเหลือเพียงบรรทัดเดียวเพื่อไม่ให้กินพื้นที่บริบท
การหมดเวลา (Timeouts): ควรกำหนดเวลาสิ้นสุด (Deadline) ให้กับทุกงาน และส่งอีเวนต์ job_timed_out แจ้งเตือนเมื่อหมดเวลา
โครงสร้างของ API เบื้องหลังที่ควรจะเป็น
เครื่องมือแบบอะซิงโครนัสจะมีประสิทธิภาพได้ก็ต่อเมื่อมี Job API เบื้องหลังที่รองรับอย่างเหมาะสม นั่นคือ รับงานเข้ามา ส่ง ID คืนกลับไป และเปิดให้ผู้เรียกเข้ามาตรวจสอบสถานะได้ โดย RFC 9110 ได้นิยามสถานะ 202 Accepted ไว้ว่า “คำขอได้รับการยอมรับเพื่อนำไปประมวลผลแล้ว แต่การประมวลผลยังไม่เสร็จสมบูรณ์” และเอกสาร 202 reference ของ MDN ได้อธิบายการนำไปใช้งานจริงไว้
ตัวอย่างรูปแบบ Job API ขั้นต่ำสำหรับเครื่องมือ start():
| การเรียกใช้งาน | การตอบกลับ | ผู้ใช้งาน |
|---|---|---|
POST /jobs (พร้อมส่วนหัว Idempotency-Key) |
202 + {"job_id", "status":"queued"} + Location: /jobs/{id} |
start |
GET /jobs/{id} |
200 + queued, running, done หรือ failed |
status, Job Watcher |
GET /jobs/{id}/result |
200 พร้อมข้อมูล Output หรือ 409 หากยังไม่เสร็จสิ้น |
เครื่องมือ Fetch |
DELETE /jobs/{id} |
202 ส่งคำขอยกเลิกแล้ว ตามด้วย 404 หรือ 409 ในการเรียกหลังจากนั้น |
stop |
| Callback URL (ไม่บังคับ) | POST กลับไปยังผู้เรียกเมื่องานเสร็จสิ้น |
Job Watcher |
ระบบ Callback คือกลไกที่ช่วยให้ Runtime สามารถใช้วิธี Push Event ได้แทนที่จะต้องทำ Polling หากคุณต้องการแนวทางในการเลือกระหว่างสองวิธีนี้ สามารถดูข้อดีข้อเสียเปรียบเทียบได้ใน Webhooks vs Polling และสำหรับเนื้อหาเกี่ยวกับ Event-driven API สามารถอ่านเพิ่มเติมได้ที่ AsyncAPI คืออะไร
หากเครื่องมือของคุณรองรับ MCP ปัจจุบันมีมาตรฐานสำหรับเรื่องนี้แล้ว โดยข้อกำหนดของ MCP (เวอร์ชัน 2026-07-28) ได้ระบุให้ Tasks เป็นส่วนขยายเสริม (Optional extension): ฝั่งเซิร์ฟเวอร์สามารถตอบกลับการเรียก tools/call ด้วย CreateTaskResult ที่มี taskId แนบมาด้วย จากนั้นฝั่งไคลเอนต์จะคอยสอบถามผ่าน tasks/get (หรือรอรับจาก notifications/tasks) และใช้ tasks/cancel เพื่อขอยกเลิกงาน โดยมีสถานะต่างๆ ได้แก่ working, input_required, completed, failed และ cancelled ทั้งนี้ ทั้งไคลเอนต์และเซิร์ฟเวอร์ต้องเปิดใช้ฟีเจอร์นี้ และการรองรับของโฮสต์อาจแตกต่างกันไป จึงควรตรวจสอบไคลเอนต์ของคุณให้รอบคอบก่อนนำไปใช้งานจริง
ให้ Coding Agent ช่วยสร้างและทดสอบ Job API ด้วย Apidog CLI
Job API เป็นส่วนที่คุณสามารถตรวจสอบความถูกต้องได้ก่อนที่จะนำ Agent ใดๆ เข้ามาใช้งานจริง เพียงส่งมอบการออกแบบและชุดทดสอบให้กับ Coding Agent แล้วให้มันควบคุมการทำงานผ่าน Apidog CLI คุณเพียงแค่เขียน Prompt คำสั่งเดียว ตัว Agent จะจัดการเขียนสเปก สร้าง Test Case และสั่งรันให้ทั้งหมด
การตั้งค่าเริ่มต้นใช้เพียง 3 คำสั่ง:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้ป้อน Prompt นี้ให้กับ Agent ของคุณ:
In Apidog project <projectId>, design the job API a start() tool needs:
POST /jobs returns 202 with job_id, GET /jobs/{id} returns queued|running|done|failed,
DELETE /jobs/{id} cancels. Create the endpoints, then create test cases that assert:
202 and a job_id on create, a status that reaches done within 60 seconds,
the same job_id when the Idempotency-Key repeats, and 409 or 404 on GET result after cancel.
Run them against the staging environment <envId> and summarize failures.
Agent จะอ่านรูปแบบโครงสร้าง Payload แต่ละแบบจาก CLI ทำการตรวจสอบความถูกต้อง (Validate) จากนั้นจึงสร้างและรันคำสั่ง:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file post-jobs.json
apidog endpoint create --project <projectId> --file post-jobs.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-create-202.json
apidog test-case create --project <projectId> --file case-create-202.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
ตัวรายงานผลแบบ cli จะแสดงผลว่าแต่ละ Assertion ผ่านหรือไม่ผ่านบนเทอร์มินัล ขณะที่รายงานแบบ json จะให้ข้อมูลที่มีโครงสร้างเพื่อให้ Agent นำไปอ่านและวิเคราะห์อธิบายต่อได้ เมื่อชุดทดสอบผ่านเรียบร้อยแล้ว คุณสามารถรันคำสั่งเดียวกันนี้บน CI โดยใช้ -r junit ได้เช่นกัน ซึ่งสามารถดูรายละเอียดของลูปนี้ได้ใน คู่มือ Apidog CLI Agent Workflow และดูวิธีการตั้งค่า Agent ได้ที่ Apidog CLI ใน Claude Code ทั้งนี้ แพ็กเกจฟรีของ Apidog รองรับการใช้งานสูงสุด 4 ผู้ใช้
เมื่อใดที่ควรใช้ และเมื่อใดที่ไม่คุ้มค่าที่จะใช้เครื่องมือแบบอะซิงโครนัส
ควรใช้ Async เมื่อ:
- เครื่องมือนั้นใช้เวลาประมวลผลนานกว่าสองสามวินาทีเป็นประจำ (เช่น การบิลด์, การรันชุดทดสอบ, การ Crawl, การเรนเดอร์ หรือการ Deploy)
- ผู้ใช้จำเป็นต้องมีปฏิสัมพันธ์หรือสนทนากับ Agent ในระหว่างที่งานกำลังดำเนินอยู่
ควรใช้ Blocking ต่อไปเมื่อ:
- การเรียกใช้งานใช้เวลาส่งผลลัพธ์กลับมาไม่เกิน 1-2 วินาที
- ขั้นตอนถัดไปไม่สามารถเริ่มต้นได้หากยังไม่มีผลลัพธ์ของขั้นตอนนี้อยู่ดี
- ไม่มีระบบ Job API ที่แท้จริงรองรับเบื้องหลัง เพราะการสร้างเครื่องมือแบบ Async ปลอมๆ ที่ภายในยังคงบล็อกการทำงานอยู่นั้น มีแต่จะเพิ่มความซับซ้อนโดยไม่ได้ประโยชน์อะไร
แนวทางปฏิบัติที่เรียบง่ายคือ: ให้การอ่านข้อมูล (Read) เป็นแบบ Blocking ส่วนการเขียนข้อมูลที่ใช้เวลานาน (Long write) หรือการประมวลผลที่หนักหน่วง (Long computation) ให้เปลี่ยนมาใช้แบบ Async
คำถามที่พบบ่อย (FAQ)
การเรียกใช้เครื่องมือแบบอะซิงโครนัส (Async tool calls) กับแบบขนาน (Parallel tool calls) แตกต่างกันอย่างไร? การเรียกใช้แบบขนานจะเป็นการสั่งรันเครื่องมือหลายตัวพร้อมกันภายในรอบการทำงาน (turn) เดียวกัน แต่โมเดลก็ยังคงต้องหยุดรอให้ทุกตัวทำงานเสร็จอยู่ดี ในขณะที่การเรียกใช้แบบอะซิงโครนัสจะส่งผลลัพธ์เบื้องต้นกลับมาทันที และการทำงานจริงจะไปเสร็จสิ้นในรอบถัดๆ ไป ทำให้โมเดลสามารถสนทนาและโต้ตอบต่อได้ในระหว่างที่งานกำลังดำเนินอยู่
จำเป็นต้องใช้ MCP ในการสร้างเครื่องมือแบบอะซิงโครนัสหรือไม่? ไม่จำเป็น เพียงแค่มีเครื่องมือที่ส่งคืน Job ID กลับมา และมี Runtime ที่สามารถแทรก Completion Event เข้ามาได้ก็ทำงานได้แล้ว แต่ส่วนขยาย Tasks เสริมของ MCP จะเข้ามาช่วยกำหนดมาตรฐานสำหรับการจัดการ Handle, การทำ Polling และการขอยกเลิกงาน หากทั้งฝั่งไคลเอนต์และเซิร์ฟเวอร์ของคุณรองรับ
Agent รู้ได้อย่างไรเมื่องานเสร็จสิ้น? ฝั่ง Runtime จะเป็นผู้แจ้งให้ทราบ โดยตัว Job Watcher จะคอยเช็กข้อมูลจาก Job API หรือรอรับ Callback แล้วจึงส่ง Completion Event แบบกระชับแทรกเข้ามาในการสนทนา จากนั้นโมเดลจะอ่านข้อมูลนี้ในรอบการทำงานถัดไป
จะเกิดอะไรขึ้นหากผู้ใช้สั่งยกเลิกระหว่างที่งานกำลังทำอยู่? ตัว Agent จะเรียกคำสั่ง stop(job_id) จากนั้น API จะบันทึกคำขอ และตัว Job จะรายงานสถานะสุดท้ายที่แท้จริงออกมา หากงานประมวลผลเสร็จสิ้นไปก่อนที่คำขอยกเลิกจะไปถึง Agent ก็ควรแจ้งตามจริงว่างานเสร็จสิ้นแล้ว แทนที่จะรายงานว่าถูกยกเลิก
โหมด Full-duplex ของ DeepSeek เป็นฟีเจอร์ที่สามารถเปิดใช้งานได้เลยหรือไม่? ยังไม่ใช่ฟีเจอร์สำเร็จรูปสำหรับผู้ใช้ทั่วไป บทความระบุว่าฟังก์ชันนี้ถูกพัฒนาไว้ใน DeepSeek Harness แต่ยังปิดการใช้งานไว้เป็นค่าเริ่มต้น และปลั๊กอินที่เกี่ยวข้องยังเป็นเพียงตัวต้นแบบที่ผู้เขียนระบุว่าไม่ใช่ผลิตภัณฑ์ทางการของ DeepSeek จึงควรนำมาใช้เป็นแนวทางอ้างอิงในการออกแบบสถาปัตยกรรมเท่านั้น