
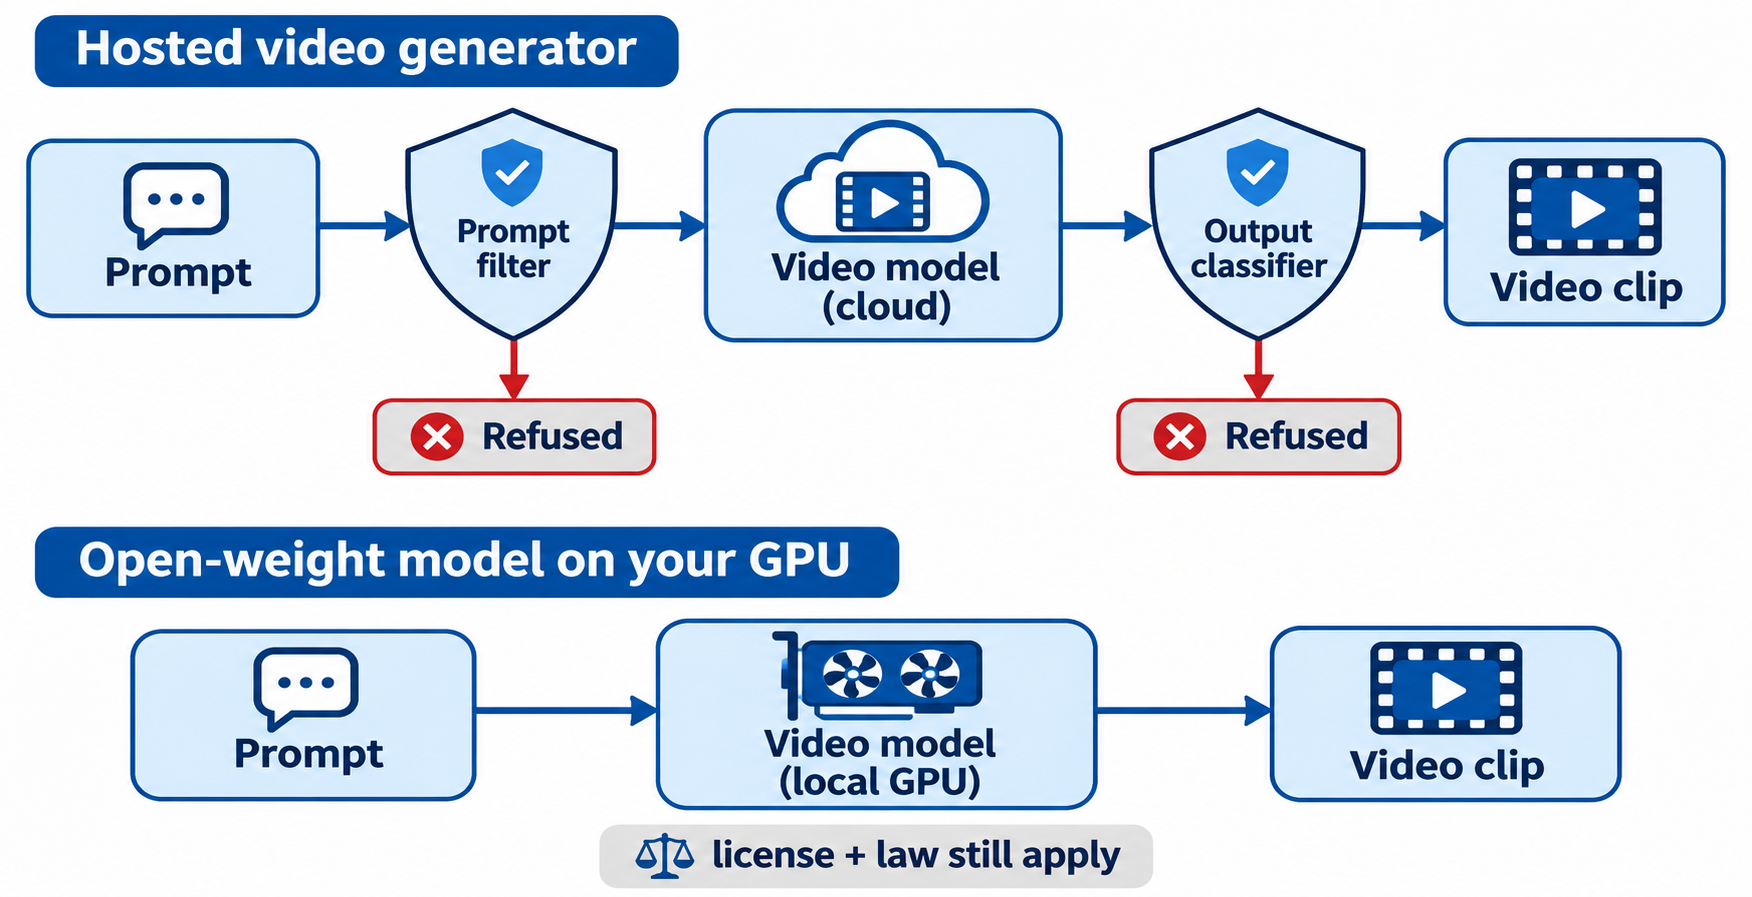
คำตอบโดยสรุป: เครื่องมือสร้างวิดีโอ AI ที่ไร้ข้อจำกัดในความหมายที่แท้จริง จะมีอยู่บนฮาร์ดแวร์ของคุณเองเท่านั้น: โมเดล open-weight อย่าง Wan2.2, HunyuanVideo-1.5 และ LTX-2 สามารถรันได้โดยไม่มีตัวกรองฝั่งเซิร์ฟเวอร์ บริการแบบ hosted ทุกตัวล้วนมีนโยบายด้านเนื้อหา หากคุณต้องการลดการปฏิเสธที่ผิดพลาด (false positive) โดยไม่มี GPU แพลตฟอร์มหลายโมเดลอย่าง A2E ช่วยให้คุณสลับโมเดลได้เมื่อโมเดลหนึ่งแจ้งว่า prompt ไร้อันตรายไม่ผ่าน
คำว่า "ไร้ข้อจำกัด" ในบทความนี้หมายถึงอิสระในการสร้างสรรค์: มีการปฏิเสธน้อยลงสำหรับ prompt ที่ชอบด้วยกฎหมาย เช่น ภาพยนตร์สั้นแนวสยองขวัญ ฉากสงคราม ฉากทำสตั๊นต์ หรือวิดีโออธิบายเรื่องการแพทย์ ไม่ได้หมายถึงเนื้อหาโป๊เปลือย และไม่เคยหมายถึงการใช้ใบหน้าหรือเสียงของบุคคลจริงโดยไม่ได้รับความยินยอม บทความนี้เป็นฉบับวิดีโอที่มาคู่กับคู่มือ AI image generators with no restrictions ของเรา
"ไร้ข้อจำกัด" หมายความว่าอย่างไรสำหรับเครื่องมือสร้างวิดีโอ AI
เครื่องมือสร้างวิดีโอ AI ที่ไร้ข้อจำกัด คือเครื่องมือที่รัน prompt ของคุณโดยไม่มีตัวกรองเนื้อหาฝั่งผู้ให้บริการ ในทางปฏิบัติ นั่นหมายถึงโมเดล open-weight ที่คุณรันเองเท่านั้น เครื่องมือแบบ hosted ทั้งหมดมีการกรอง แต่แตกต่างกันที่ความถี่ในการปฏิเสธ prompt ที่ไม่มีอันตราย และจำนวนโมเดลที่คุณลองใช้ได้ภายใต้บัญชีเดียว
เครื่องมือสร้างวิดีโอแบบ hosted มักตรวจสอบสองรอบ: ตัวกรอง prompt จะอ่านข้อความของคุณก่อน และตัวจำแนกผลลัพธ์ (output classifier) จะตรวจสอบเฟรมต่าง ๆ ก่อนที่คลิปจะถูกส่งกลับมา ฝ่ายใดฝ่ายหนึ่งก็ปฏิเสธได้ หากรันโมเดลในเครื่องเอง ทั้งสองชั้นนี้จะไม่มีอยู่เลย
เครื่องมือสร้างวิดีโอ AI ที่ดีที่สุดแบบไร้ข้อจำกัด: รายการสรุป
นี่คือการเปรียบเทียบตัวเลือกหลัก ราคาและเครดิตมาจากหน้าเว็บทางการของแต่ละเจ้า ตรวจสอบเมื่อวันที่ 13 พฤศจิกายน 2026
| เครื่องมือ | ประเภท | ตัวกรอง | ช่องทางใช้ฟรี | เหมาะกับ |
|---|---|---|---|---|
| A2E | Hosted, หลายโมเดล | นโยบายผู้ให้บริการ | 30 เครดิต/วัน, มีลายน้ำ, 720p | ใช้หลายโมเดลในบัญชีเดียว พร้อม API |
| Kling 4.0 | Hosted | นโยบายผู้ให้บริการ | ดูหน้าเว็บทางการ | ฉากที่มีการเคลื่อนไหวรุนแรงพร้อมเสียง |
| Gemini Omni Flash | Hosted (Google) | นโยบายของ Google | ดูหน้าเว็บทางการ | คลิป 3–15 วินาทีพร้อมเสียงในตัว |
| Grok Imagine | Hosted (xAI) | นโยบายของ xAI | API แบบเสียเงิน คิดเงินตามวินาที | คลิปสั้นไม่เกิน 15 วินาที, 1080p บนเวอร์ชัน 1.5 |
| Seedance 2.5 | Hosted (ByteDance) | นโยบายของ ByteDance | ดูหน้าเว็บทางการ | แชตเดียวยาวได้ถึง 30 วินาที |
| Wan2.2 | Open weights | ไม่มีตัวกรองบนเครื่องคุณ | น้ำหนักโมเดลฟรี | รันเครื่อง 720p ที่ 24fps บน GPU ระดับสูงหนึ่งตัว |
| HunyuanVideo-1.5 | Open weights | ไม่มีตัวกรองบนเครื่องคุณ | น้ำหนักโมเดลฟรี | รันเครื่องแบบเบา (14 GB เมื่อใช้ offloading) |
| LTX-2 | Open weights | ไม่มีตัวกรองบนเครื่องคุณ | น้ำหนักโมเดลฟรี | วิดีโอพร้อมเสียงตรงกัน รันในเครื่อง |
1. A2E: บัญชีเดียว หลายโมเดลวิดีโอ
A2E เป็นแพลตฟอร์ม AI สร้างภาพและวิดีโอแบบครบวงจร ติดอยู่ในรายการนี้เพราะความหลากหลาย ไม่ใช่เพราะไม่สนนโยบาย: เมื่อโมเดลหนึ่งปฏิเสธ prompt ที่ไร้อันตราย คุณรันใหม่บนโมเดลอื่นด้วยบัญชีและเครดิตเดียวกันได้ โมเดลวิดีโอมี Seedance 2.5, Kling 4.0, Wan 3.0, Veo 3.1, Sora 2 และ Grok Imagine ควบคู่กับ face swap, talking photo, lip sync และ voice clone
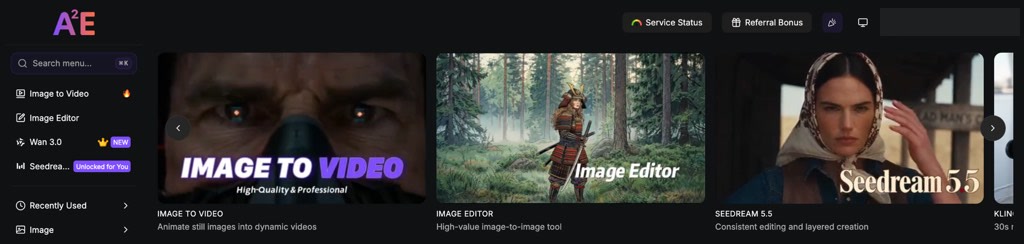
บัญชีใหม่รับเครดิตฟรี 100 เครดิต พลัส 30 เครดิตต่อวันจากการเช็คอิน โดยผลลัพธ์เป็น 720p ติดลายน้ำ แพ็กเกจ Pro ราคา $14.9 ต่อเดือน ได้ 1,500 เครดิต ไม่มีลายน้ำ และเข้าถึง API ได้ ในการทดสอบของเราเมื่อวันที่ 13 พฤศจิกายน 2026 คลิป image to video ความยาว 5 วินาทีบนโมเดล V2 ของ A2E ใช้เครดิต 40 เครดิต และเรนเดอร์เสร็จในประมาณ 2 นาที การ face swap บนคลิปเดียวกันรันฟรีตามโควตา และใบหน้าใหม่ติดอยู่ครบทุกเฟรม
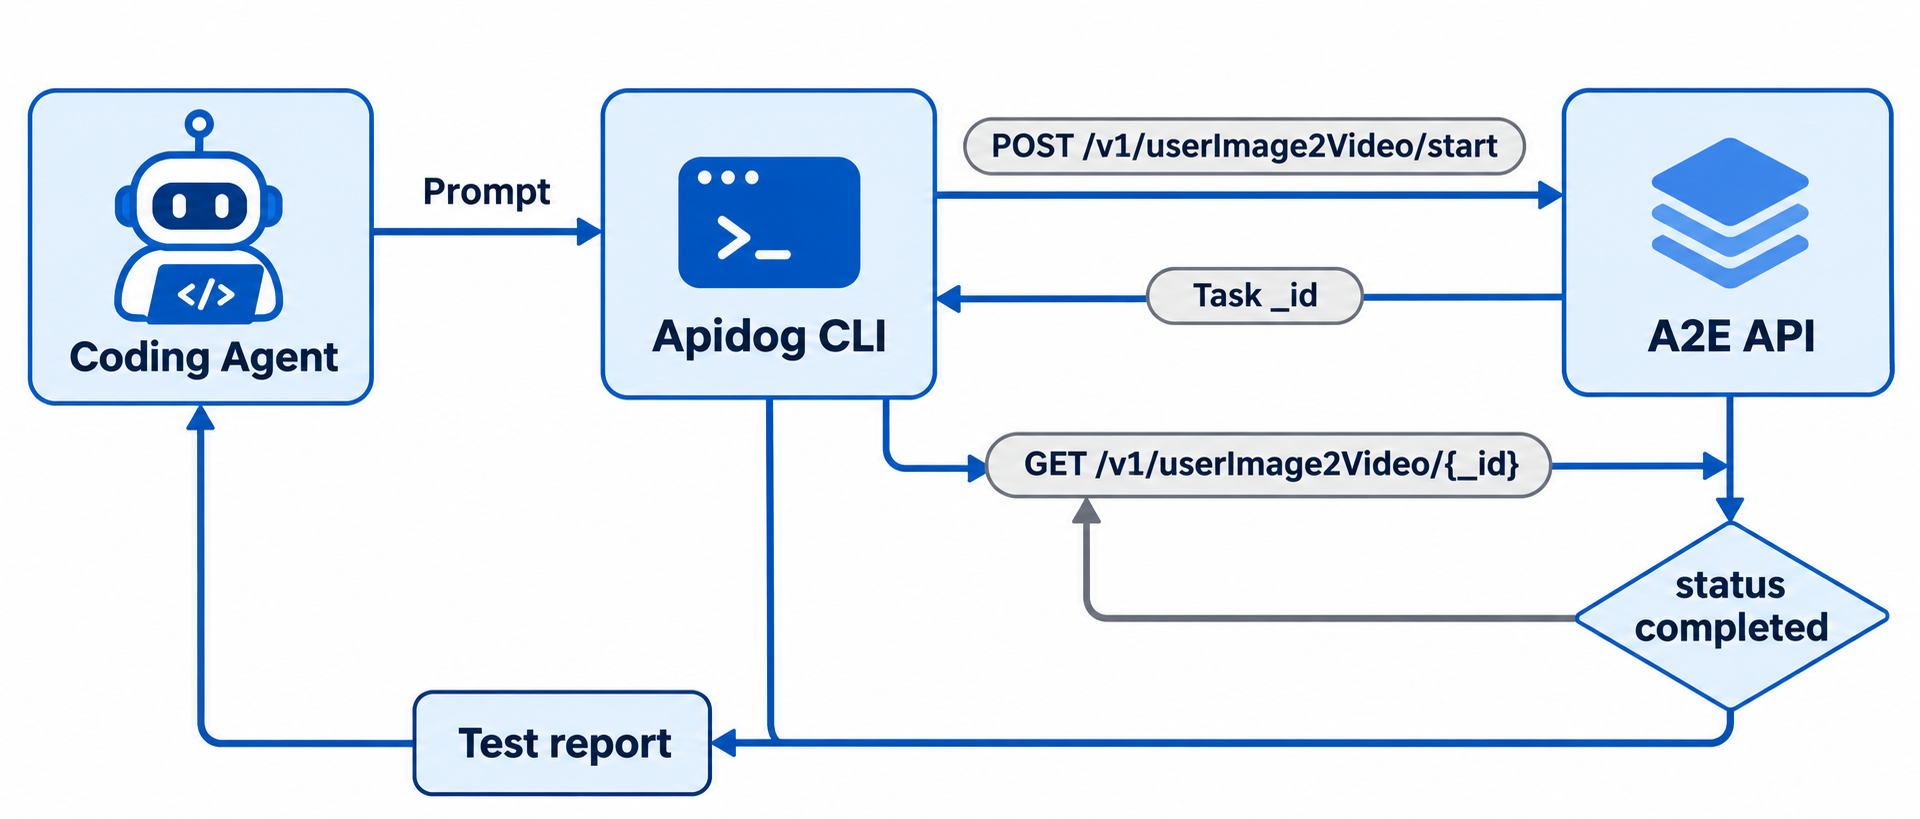
นักพัฒนามี REST API ที่ https://api.a2e.ai พร้อม OpenAPI spec และไฟล์ SKILL.md สำหรับ coding agent งานต่าง ๆ เป็นแบบ async: คุณเริ่มงาน แล้วค่อยตรวจสอบสถานะผ่าน _id จนกว่าจะเสร็จ
สรุป: ช่องทาง hosted ที่ง่ายที่สุดในการลดการปฏิเสธ เพราะการสลับโมเดลแค่กดดรอปดาวน์ ไม่ต้องสมัครสมาชิกใหม่ ข้อกำหนดของ A2E ยังคงมีผลบังคับ และเว็บไซต์มีลิงก์แบบฟอร์มรายงาน CSAM
2. Kling 4.0
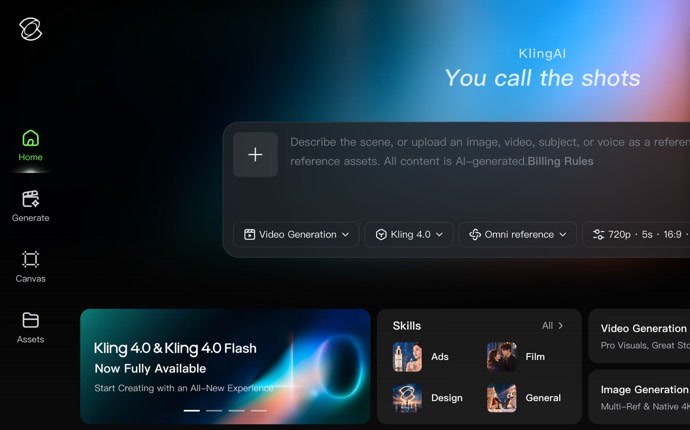
Hosted. เว็บไซต์ของ Kling เปรียนเทียบ Kling 4.0 ในด้านความสมจริงทั้งภาพและเสียง และฉากที่มีการเคลื่อนไหวรุนแรงอย่างเสถียร กล่อง prompt รับข้อความบวกรูปภาพ วิดีโอ ตัวละคร หรือเสียงเป็นข้อมูลอ้างอิง เริ่มต้นที่ 720p, 5 วินาที และสัดส่วน 16:9 โดยรอบมี motion control, lip sync, talking avatar และ video to audio พร้อม Canvas แบบ node-based และช่องทาง MCP และ API สำหรับงานกลุ่ม แพ็กเกจเสียเงินเริ่มที่ $6.99 และ Kling ยังอยู่ในเมนูของ A2E ด้วย
สรุป: ตัวเลือกที่แข็งแรงสำหรับคลิปแนวแอ็กชัน ตรวจสอบโควตาฟรีก่อนที่ kling.ai
3. Google Gemini Omni Flash (เดิมคือ Veo)
Hosted. Google ปิดตัวโมเดล preview ของ Veo 3.1 ใน Gemini API เมื่อวันที่ 22 ตุลาคม 2026 และเอกสารวิดีโอของทางการตอนนี้ชี้นักพัฒนาไปที่ Gemini Omni Flash (gemini-omni-1.2-flash) สร้างคลิปได้ถึง 15 วินาทีพร้อมเสียงในตัว จากอินพุตแบบข้อความ รูปภาพ หรือวิดีโอ รักษาความสม่ำเสมอของตัวละครข้ามรูปอ้างอิงได้ถึง 6 รูป และให้คุณปรับแต่งหรือต่อคลิปได้หลายรอบ นโยบาย Generative AI Prohibited Use Policy ของ Google เป็นตัวกำกับว่าคุณสร้างอะไรได้
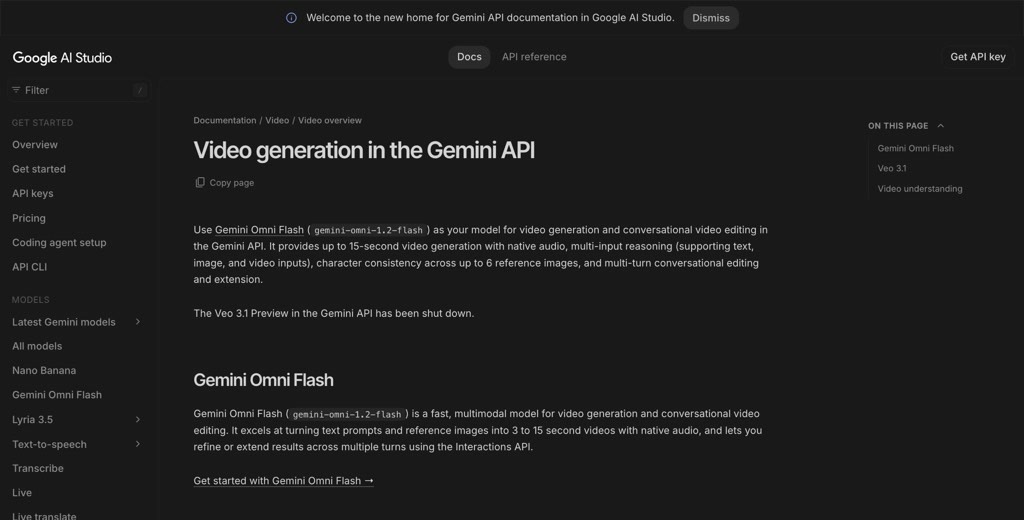
สรุป: คุณภาพดีภายในระบบนิเวศของ Google แต่ไม่ใช่ตัวเลือกถ้าปัญหาหลักของคุณคือการถูกปฏิเสธ
4. Grok Imagine
Hosted. โมเดลวิดีโอของ xAI รันในแอป Grok และผ่าน xAI API บน grok-imagine-video-1.5, text to video เรนเดอร์ที่ 1080p แบบ native และโมเดล 1.5-lite ถูกที่สุดต่อวินาที คลิปยาว 1–15 วินาที เปิดเสียงเป็นค่าเริ่มต้น และ SDK ของ xAI จัดการ async polling ให้คุณ การกลั่นกรองเหมือนกันทั้งในแอปและ API ดังนั้น API จะไม่ปฏิเสธน้อยลง แต่แต่ละงานรายงานสถานะของตัวเอง ยังอยู่ในเมนูของ A2E ด้วย บทวิเคราะห์ Grok Imagine no restrictions ของเรา อธิบายว่าอะไรเปลี่ยนไป และอะไรยังใช้ได้
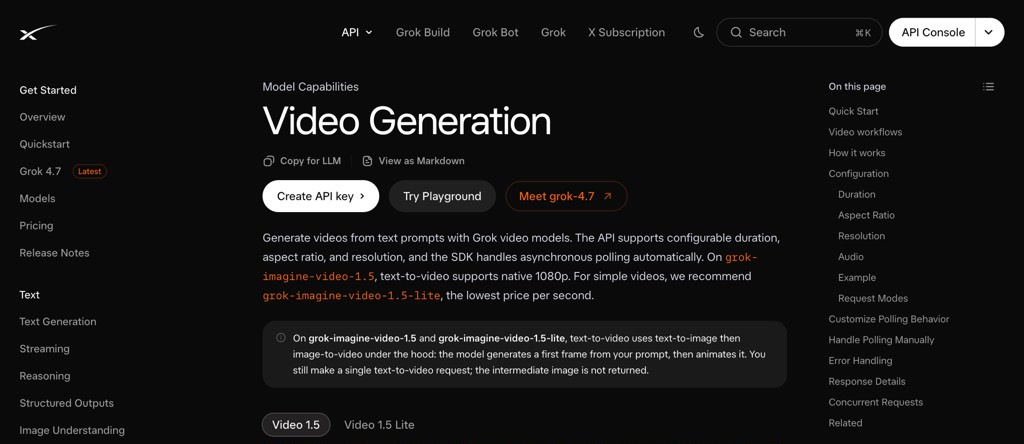
สรุป: คลิปสั้น รวดเร็ว ถูก แต่ตัวกรองยังติดกับดักกับ prompt ที่ไร้อันตรายอยู่
5. Seedance 2.5
Hosted. Seedance 2.5 ของ ByteDance สร้างเสียงและวิดีโอพร้อมกัน ออกแบบมาเพื่อการเล่าเรื่อง 30 วินาทีในแชตเดียว ที่สูงถึง 1080p รับรูปอ้างอิงได้ถึง 30 รูป วิดีโอ 10 ไฟล์ และคลิปเสียง 10 ไฟล์ เข้าถึงได้ผ่านแอปของ ByteDance, BytePlus ModelArk API และผู้ให้บริการบุคคลที่สาม รวมถึง A2E บล็อกใบหน้าคนจริงในรูปอ้างอิงทุกช่องทาง คู่มือ Seedance 2 prompts that avoid content flags ของเรา อธิบายถ้อยคำที่ทำให้ตัวกรองติดโดยไม่ตั้งใจ
สรุป: ตัวเลือกดีที่สุดสำหรับแชตยาวเดี่ยว ตราบใดที่คุณเลี่ยงใบหน้าคนจริง
6. Wan2.2
Open weights, รันในเครื่อง. Wan2.2 เป็นโมเดลสัญญาอนุญาต Apache 2.0 มีทั้ง text to video, image to video และ speech to video ใช้โครงสร้าง Mixture-of-Experts และฝึกด้วยรูปภาพมากกว่า Wan2.1 ถึง 65.6% และวิดีโอมากกว่า 83.2% โมเดล TI2V-5B รองรับทั้ง text และ image to video ที่ 720p และ 24fps และ README ระบุว่ารันบนการ์ดระดับผู้บริโภคอย่าง RTX 4090 ได้ ส่วนโมเดล Animate-14B แยกต่างหาก รองรับการ animate และเปลี่ยนตัวละคร
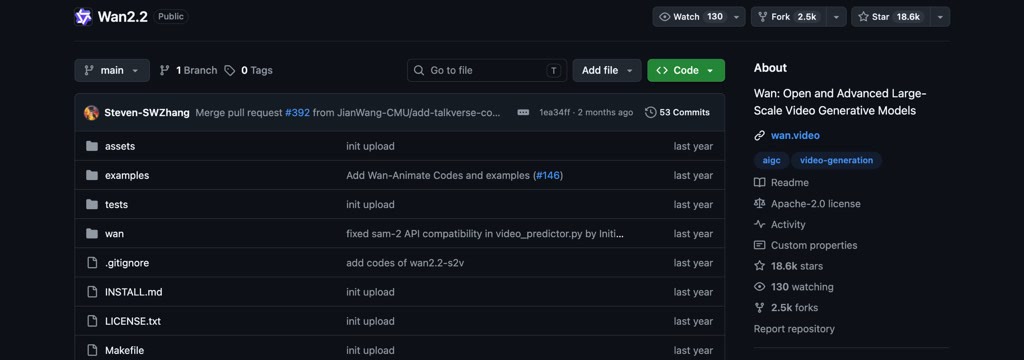
สรุป: จุดเริ่มต้นแบบรันในเครื่องที่ดีที่สุด ถ้าคุณมี GPU ระดับสูงหนึ่งตัว
7. HunyuanVideo-1.5
Open weights, รันในเครื่อง. HunyuanVideo-1.5 เป็นโมเดล 8.3B พารามิเตอร์ สำหรับ text to video และ image to video ออกแบบมาให้รันบน GPU ระดับผู้บริโภค README ระบุขั้นต่ำที่หน่วยความจำ GPU 14 GB เมื่อเปิดใช้ model offloading และโมเดล image-to-video แบบ step-distilled ความละเอียด 480p เรนเดอร์คลิปเสร็จในประมาณ 75 วินาทีบน RTX 4090 เครื่องเดียว โค้ดสำหรับฝึกโมเดลและสคริปต์ปรับจูน LoRA ก็เปิดให้ใช้เช่นกัน เผยแพร่ภายใต้สัญญาอนุญาตชุมชนของ Tencent เอง จึงควรอ่านก่อนใช้เชิงพาณิชย์
สรุป: ตัวเลือกแบบรันในเครื่องที่เบาที่สุด ถ้าสัญญาอนุญาตเหมาะกับการใช้งานของคุณ
8. LTX-2
Open weights, รันในเครื่อง. LTX-2 จาก Lightricks สร้างวิดีโอพร้อมเสียงตรงกันในโมเดลเดียว มีหลายโหมดประสิทธิภาพ โค้ดเป็น Apache 2.0 ขณะที่น้ำหนักโมเดลมีสัญญาอนุญาตโมเดลของตัวเองตามที่ระบุใน README และ Hugging Face ให้คุณยอมรับข้อกำหนดก่อนดาวน์โหลด quick start ปัจจุบันดึงน้ำหนัก LTX-2.5 ประมาณ 66 GiB จึงควรวางแผนพื้นที่ดิสก์ รองรับ fp8 quantization และ offload เมื่อหน่วยความจำ GPU จำกัด และใน repo มี LoRA trainer ด้วย
สรุป: ตัวเลือกแบบรันในเครื่อง เมื่อคุณต้องการเสียงในรอบการประมวลผลเดียว
สำหรับทั้งสามโมเดล open-weight ComfyUI เป็น front end ที่นิยมใช้: โหลดน้ำหนักโมเดล ต่อ workflow แล้วสร้างผลลัพธ์แบบออฟไลน์ คุณแลกตัวกรองของผู้ให้บริการกับเวลาและฮาร์ดแวร์ในการตั้งค่า
วิธีลดการปฏิเสธแบบ false positive บนเครื่องมือแบบ hosted
การปฏิเสธส่วนใหญ่กับ prompt ที่ชอบด้วยกฎหมาย เกิดจากถ้อยคำ ไม่ใช่เจตนา:
- อธิบายฉากตรงตามจริง. "พ่อครัวหั่นหอมด้วยมีดขนาดใหญ่" ใช้ได้ดีกว่า prompt ที่เน้นคำกริยาแนวรุนแรง
- เลี่ยงชื่อบุคคลจริง. ผู้ให้บริการส่วนใหญ่บล็อก prompt ที่ระบุชื่อบุคคลสาธารณะ ด้วยเหตุผลที่ดี
- เริ่มจากรูปของคุณเอง. มันให้โมเดลเห็นตัวแบบที่ชัดเจนและได้รับความยินยอมแล้ว
- ใช้ negative prompt เพื่อกดเรื่องเลือดสาด ภาพเบลอ และความผิดเพี้ยนออกไป
- สลับโมเดล. prompt ที่โมเดลหนึ่งปฏิเสธ มักผ่านบนอีกโมเดลหนึ่ง
ให้ coding agent ของคุณทดสอบ A2E API ด้วย Apidog CLI
ในวิดีโอ API ส่วนที่เสี่ยงคืองาน async ที่กลับมาเป็น failed หรือการปฏิเสธที่ UI ของคุณไม่รองรับ ให้ coding agent ของคุณเขียนและรันเช็คเหล่านี้ด้วย Apidog CLI
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
curl -sL https://video.a2e.ai/dev/openapi-spec -o a2e-openapi.json
apidog import --project <projectId> --format openapi --file ./a2e-openapi.json
จากนั้นให้ agent ของคุณ (Claude Code, Codex, Cursor หรือ OpenCode) หนึ่ง prompt:
In Apidog project <projectId>, create a test case for POST /v1/userImage2Video/start
with a Bearer token from the environment variable A2E_TOKEN. Assert the response
has code 0 and a data._id. Then call GET /v1/userImage2Video/{_id} until
current_status is completed or failed, and fail the test on failed with the
reason. Run it against environment <envId> and summarize the result.
การรันจริงใช้เครดิต A2E จึงให้ agent เพิ่ม mock expectation สำหรับสถานะ failed (apidog cli-schema get mock-create แล้ว apidog mock create) และทดสอบการจัดการข้อผิดพลาดกับมัน ใน CI, apidog run --test-case <caseId> -r junit ให้รายงานแบบ JUnit; ดู Apidog CLI in a CI/CD pipeline
คุณควรเลือกเครื่องมือสร้างวิดีโอ AI ตัวไหน?
- ไม่มีตัวกรองจากผู้ให้บริการเลย, GPU 14 GB ขึ้นไป: HunyuanVideo-1.5 หรือ Wan2.2 TI2V-5B บน ComfyUI
- เสียงและวิดีโอจากโมเดลเดียวในเครื่อง: LTX-2
- หลายโมเดล hosted ในบัญชีเดียว: A2E
- คลิปแนวแอ็กชัน: Kling 4.0
- แชตยาวเดี่ยว: Seedance 2.5
- สร้างผลิตภัณฑ์: API ของ A2E บวกการทดสอบด้วย Apidog CLI สำหรับวงจรชีวิตงาน async
คำถามที่พบบ่อย
มีเครื่องมือสร้างวิดีโอ AI ที่ไร้ข้อจำกัดอย่างแท้จริงหรือไม่?
มีเฉพาะโมเดล open-weight ที่คุณรันเอง เช่น Wan2.2, HunyuanVideo-1.5 และ LTX-2 โมเดลเหล่านี้ไม่มีตัวกรองฝั่งผู้ให้บริการ แต่สัญญาอนุญาตและกฎหมายท้องถิ่นของคุณยังมีผลบังคับ และบริการแบบ hosted ทุกตัวบังคับใช้นโยบายด้านเนื้อหาระดับหนึ่ง
A2E ใช้ฟรีหรือไม่?
A2E มีแพ็กเกจ Free ราคา $0 พร้อมเครดิตโบนัส 30 เครดิตต่อวันจากการเช็คอิน มีลายน้ำ และผลลัพธ์ 720p การเข้าถึง API เริ่มที่แพ็กเกจ Pro ราคา $14.9 ต่อหนึ่งเดือน
ทำไมเครื่องมือสร้างวิดีโอ AI ของฉันถึงปฏิเสธ prompt ที่ไร้อันตราย?
ตัวกรอง prompt และตัวจำแนกผลลัพธ์ติดกับคำที่ผูกกับความรุนแรงหรือบุคคลจริง แม้ในฉากที่ไร้เจตนาร้าย ลองอธิบายฉากตรงตามจริง แล้วลองอีกโมเดลหนึ่ง
image to video ถูกปฏิเสธน้อยกว่า text to video หรือไม่?
มักเป็นเช่นนั้น เพราะรูปของคุณเองให้โมเดลเห็นตัวแบบที่ชัดเจน แต่ตัวจำแนกผลลัพธ์ยังตรวจเฟรมอยู่ดี จึงไม่ใช่การรับประกัน