
OpenAI LifeVal은 자녀를 학교에 등록하거나, 가계 예산을 관리하거나, 정부 기관을 상대하는 등 일상생활 과제 169개로 구성된 벤치마크로, AI 에이전트가 브라우저 사용, 컴퓨터 사용 및 커넥터를 통해 수행합니다. 루브릭이 각 시도를 평가하며, 점수는 0에서 1까지의 평균 보상입니다. GPT-6 Astra는 xhigh 노력에서 80.6%를 기록합니다.
이것이 짧은 요약입니다. 아래에서는 OpenAI가 LifeVal을 어떻게 구축했는지, 발표한 모든 모델 점수(페이지의 인터랙티브 차트 안에만 있는 노력별 수치 포함), 그 숫자가 추론 노력에 대해 말하는 바, 그리고 이 벤치마크가 빠뜨린 것을 확인할 수 있습니다.
OpenAI LifeVal이란?
LifeVal은 OpenAI Research의 벤치마크로, 코딩이나 시험 문제가 아닌 일상생활의 잡일을 모델이 얼마나 잘 끝내는지 측정합니다. 169개의 과제는 에이전트 방식입니다. 모델이 브라우징하고, 컴퓨터를 조작하고, 커넥터를 호출하면, 시나리오별 루브릭이 결과를 채점합니다.
OpenAI는 일곱 가지 과제 영역을 제시합니다:
- 돌봄
- 건강
- 교육
- 가사 관리
- 개인 재정
- 쇼핑
- 정부 서비스 이용
대표 지표는 평균 보상입니다. 각 점수는 한 과제 내의 시도들을 평균한 다음, 169개 과제 평균을 동일 가중치로 평균합니다. 80.6%라는 점수는 보상 0.806을 의미합니다. 차트 주석에는 "No WTP weighting"이라고 되어 있는데, 이는 나중에 다시 다루겠습니다.
OpenAI가 LifeVal 과제 세트를 구축한 방법
OpenAI가 과제 목록을 처음부터 만들어낸 것은 아닙니다. 사람들이 실제로 시간을 보내는 방식에서 출발했으며, 두 개의 공개 데이터 세트와 자체 설문 조사를 사용했습니다:
- 미국 노동통계국의 American Time Use Survey로, 미국인들이 시간별로 무엇을 하는지 기록합니다.
- Multinational Time Use Study로, 국가 간 시간 사용 일기를 조화시킵니다.
- 인구통계학적으로 대표성 있는 응답자 3,995명을 대상으로 한 자체 설문 조사로, 어디에 AI의 도움을 원하는지 물었습니다.
시간 사용 데이터는 OpenAI에게 사람들의 하루를 채우는 활동이 무엇인지 알려줍니다. 설문 조사는 그중 어떤 활동을 사람들이 에이전트에게 맡길 것인지 알려줍니다. 겹치는 부분이 169개의 시나리오가 되었습니다.
페이지에는 점수가 표시된 다섯 개의 예시 과제 카드가 있습니다. 이는 무작위 샘플이 아니라 OpenAI가 선택한 예시입니다:
| 예시 과제 (OpenAI 선택) | 점수 |
|---|---|
| 이사 후 맞는 유치원에 등록하기 | 93.1% |
| 홍수 전에 자원봉사자 관리하기 | 98.0% |
| 가족을 위한 새 집 찾기 | 100% |
| 멀리 떨어진 할머니와 함께 경기 보기 | 96.3% |
| 새로 당뇨병 진단을 받은 부모를 위한 식사 준비 | 90.4% |
LifeVal 점수: 모든 OpenAI 모델
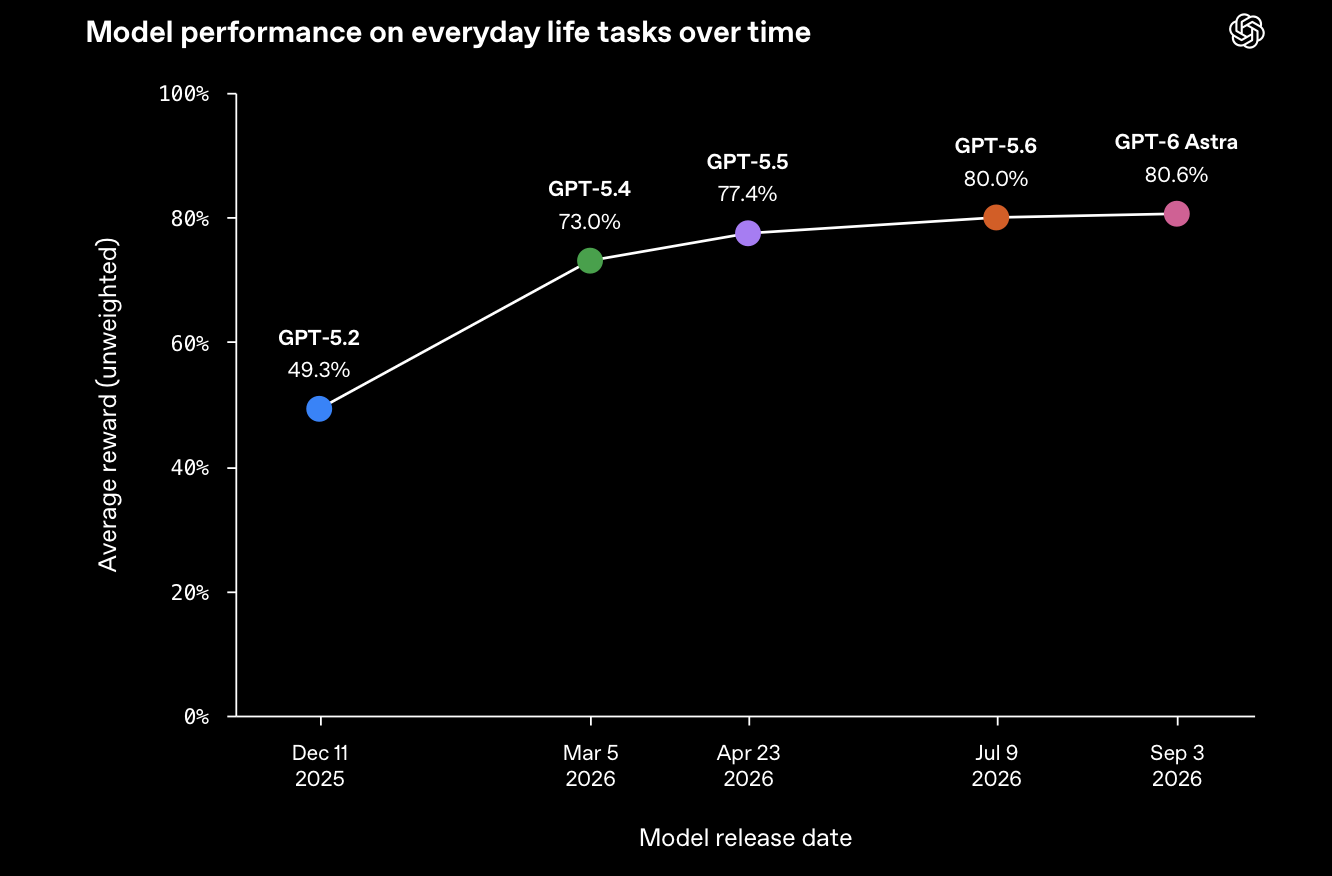
OpenAI의 첫 번째 차트는 각 모델을 xhigh 추론 노력에서 출시일 대비로 표시합니다. GPT-6 Astra는 "출시 블로그 xhigh 설정"을 사용합니다.
| 모델 | 출시일 | LifeVal 평균 보상 (xhigh) |
|---|---|---|
| GPT-5.2 | 2025-12-11 | 49.3% |
| GPT-5.4 | 2026-03-05 | 73.0% |
| GPT-5.5 | 2026-04-23 | 77.4% |
| GPT-5.6 | 2026-07-09 | 80.0% |
| GPT-6 Astra | 2026-09-03 | 80.6% |
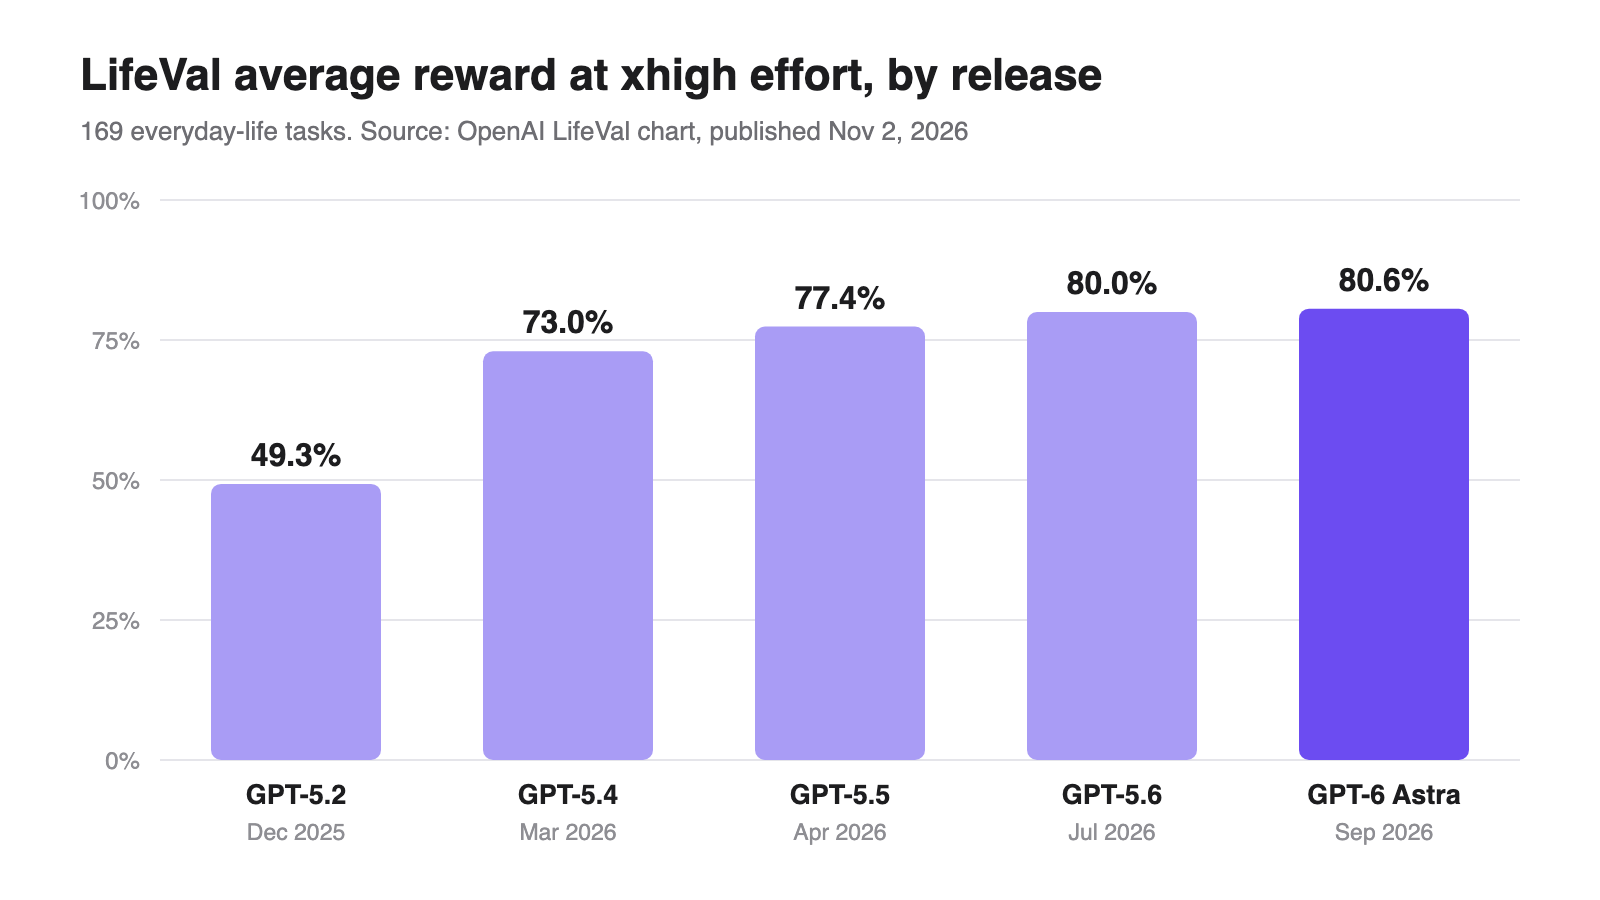
곡선은 가파르다가 평평해집니다. GPT-5.2에서 GPT-5.4까지는 3개월 만에 23.7점이 올랐습니다. 그다음 세 번의 출시는 합쳐서 7.6점을 추가했고, GPT-6 Astra는 GPT-5.6을 0.6점 차로 앞섰습니다.
GPT-5.4의 도약은 품질만이 아니었습니다. xhigh에서 평균 지연 시간은 121.0초에서 16.7초로, 생성 토큰은 과제당 202.0K에서 30.6K로 떨어졌습니다. 더 새로운 모델은 약 7분의 1의 출력으로 훨씬 더 나은 답에 도달했습니다.
GPT-6.1 Sol과 GPT-6.1 Terra는 둘 다 출시되었음에도 불구하고 어느 차트에도 나타나지 않습니다. 타임라인은 2026년 9월 3일에 멈춥니다. 에이전트 제품을 위해 GPT-6.1 Sol과 Astra 중에서 선택 중이라면, LifeVal은 아직 도움이 되지 않습니다.
추론 노력별 LifeVal
두 번째 차트가 더 유용하며, 마우스를 올려야만 볼 수 있습니다. 모든 모델을 추론 노력별로 분류하며, 각 지점마다 보상, 지연 시간, 생성 토큰, API 비용의 네 가지 숫자가 있습니다. 각 설정의 보상은 다음과 같습니다:
| 모델 | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| GPT-5.2 | 27.7% | 37.2% | 45.2% | 49.3% | n/a |
| GPT-5.4 | 62.8% | 70.1% | 72.0% | 73.0% | n/a |
| GPT-5.5 | 57.1% | 71.3% | 75.6% | 77.4% | n/a |
| GPT-5.6 | 63.9% | 75.0% | 78.8% | 80.0% | 82.6% |
| GPT-6 Astra | 66.6% | 77.6% | 80.7% | 80.6% | 82.5% |
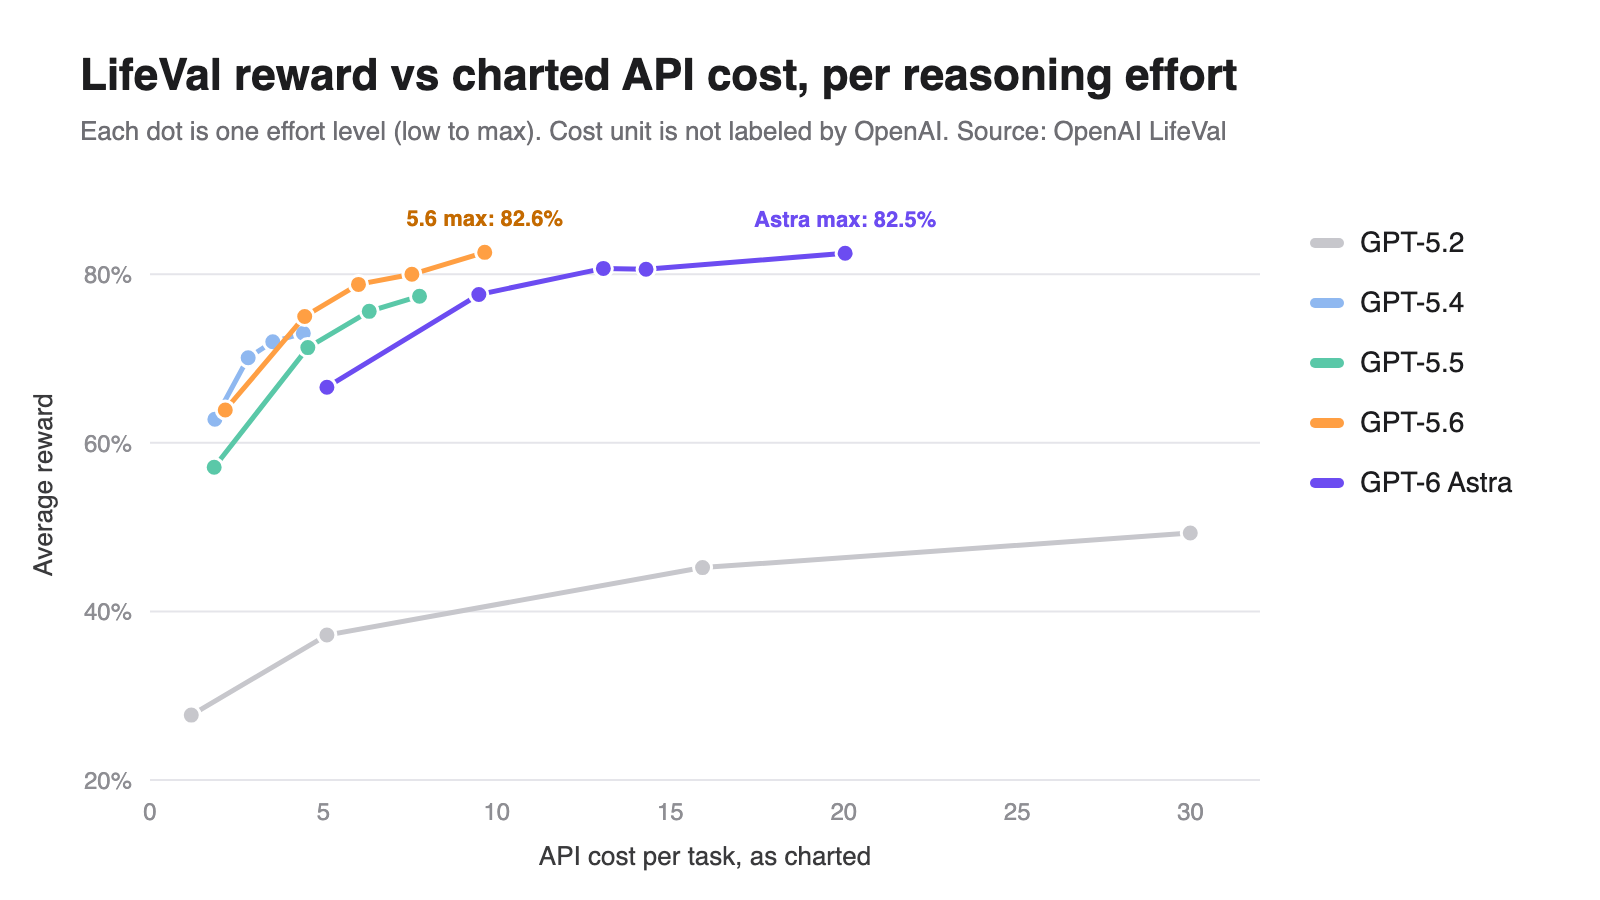
비용 열에 대한 참고 사항. OpenAI는 이를 API 비용이라고 표시하지만 단위를 명시하지 않으므로, 아래 수치는 "차트에 표시된 과제당 API 비용"으로 취급하고 비율로 사용하는 것이 좋으며, 달러로 해석하지 마세요.
GPT-5.6 max는 GPT-6 Astra max와 동일
| 설정 | 보상 | 지연 시간 | 토큰 | 차트 비용 |
|---|---|---|---|---|
| GPT-5.6, max | 82.6% | 22.2 s | 29.7K | 9.65 |
| GPT-6 Astra, max | 82.5% | 20.6 s | 26.3K | 20.04 |
| GPT-5.6, xhigh | 80.0% | 17.5 s | 20.7K | 7.55 |
| GPT-6 Astra, high | 80.7% | 13.6 s | 12.4K | 13.07 |
GPT-5.6 max는 Astra max를 약 절반의 차트 비용으로 0.1점 앞섭니다. 동일한 노력에서 Astra의 GPT-5.6 대비 우위는 모든 설정에서 3점 미만이며, xhigh에서는 0.6점, max에서는 사라집니다. Astra는 조금 더 빠르고 토큰을 덜 사용하지만, 이러한 과제에서는 대략 두 배의 비용을 지불하게 됩니다. 자체 트래픽과 이 비율을 비교하려면 GPT-5.6 가격 분석과 GPT-6 Astra API 가이드에서 토큰당 요금을 확인하세요.
"high" 이상의 추론은 거의 이득이 없음
GPT-6 Astra에서 high는 80.7%, xhigh는 80.6%를 기록합니다. 추가 노력은 1.4초와 2.1K 토큰을 더 소모하면서 점수는 약간 더 낮습니다. GPT-5.4도 같은 양상을 보입니다: high에서 xhigh로 1점 차이입니다.
큰 이득은 곡선의 아래쪽에 있습니다. GPT-5.5를 low에서 medium으로 옮기면 14.2점이 추가됩니다. high에서 xhigh로 옮기면 1.8점이 추가됩니다. 에이전트가 이와 같은 일상 과제를 실행한다면, medium 또는 high가 먼저 테스트할 설정입니다. OpenAI의 추론 가이드는 Responses API에서 effort 매개변수가 어떻게 작동하는지 설명합니다.
LifeVal이 빠뜨린 것
LifeVal은 유용한 신호이지만, 자체 보고된 것입니다. 인용하기 전에 그 한계를 알아두세요.
- 공개되지 않았습니다. 다운로드 가능한 과제 세트도, 공개 리더보드도 없으며, OpenAI는 루브릭이나 채점자를 어떻게 보정했는지 공개하지 않았습니다. 다시 실행할 수 없습니다.
- OpenAI 모델만 점수화합니다. Claude, Gemini 또는 오픈 가중치 모델은 나타나지 않으므로, GPT-6.1 Sol이 Claude Sonnet 5.5와 어떻게 비교되는지 또는 다른 교차 공급업체 비교에 대해서는 아무 말도 하지 않습니다.
- 가중치 버전이 어딘가에 존재합니다. 차트에는 "No WTP weighting"이라고 되어 있는데, WTP는 지불 의향을 의미합니다. 이는 OpenAI가 각 과제에 대해 사람들이 지불할 금액으로 가중치를 둔 변형을 계산하거나 고려했지만 공개하지 않았음을 시사합니다.
- 예시 카드는 직접 고른 것입니다. 페이지의 다섯 카드는 90.4%에서 100% 사이의 점수를 받았습니다. 최고 모델의 169개 과제 평균은 80.6%입니다. 예시는 벤치마크의 최고의 날을 보여주며, 일반적인 날이 아닙니다.
이 모든 것이 LifeVal을 틀렸다고 만드는 것은 아닙니다. 이것은 벤더 벤치마크로 만듭니다. 다른 출시 차트를 읽는 방식으로 읽으세요: 자체 과제에서 테스트할 수 있는 주장으로 말입니다.
Apidog CLI로 자체 추론 노력 테스트 실행하기
LifeVal의 노력별 표는 보상 대비 비용 곡선입니다. 자체 프롬프트에 대해 동일한 곡선을 그릴 수 있습니다. 수동으로 요청을 보내는 대신, 코딩 에이전트에게 작업을 맡기고 Apidog CLI를 구동하게 하세요.
CLI를 설치하고 로그인한 다음 에이전트에 Apidog 스킬을 추가하세요:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그런 다음 Claude Code, Codex 또는 Cursor에 다음 프롬프트를 주세요:
In Apidog project <projectId>, add a POST https://api.openai.com/v1/responses
endpoint that sends {{model}}, reasoning.effort = {{effort}} and my test prompt.
Create a test case that asserts status 200 and saves latency,
usage.output_tokens and usage.output_tokens_details.reasoning_tokens.
Add a test data set with effort = low, medium, high, xhigh, run the case
once per row against environment <envId>, and give me a table of
latency, tokens and estimated cost per effort.
에이전트는 각 페이로드 스키마를 읽고 JSON을 검증한 다음 다음과 같이 작성합니다:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json

apidog test-case category --project <projectId>
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json

apidog cli-schema validate test-data-create --file efforts.json
apidog test-data create --project <projectId> --file efforts.json

apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d <testDataId> -r cli,json --out-dir ./effort-runs
-d 플래그는 데이터 행당 한 번의 반복을 제공하고, -r cli,json은 에이전트에게 테이블을 작성할 JSON 보고서를 제공합니다. 나중에 Apidog 앱에서 실행을 검토하려면 --upload-report를 추가하세요. apidog run 명령 참조에는 모든 플래그가 나열되어 있고, Claude Code 설정 가이드는 에이전트 측면을 다룹니다.
실제 프롬프트 중 하나가 아니라 다섯 개나 열 개에 대해 실행하세요. LifeVal이 169개 과제를 평균하는 데는 이유가 있습니다: 단일 프롬프트는 노력보다 분산에 대해 더 많은 것을 알려줍니다.
모델을 선택할 때 LifeVal을 신뢰해야 할까?
방향을 위해 사용하고 결정을 위해 사용하지 마세요. LifeVal은 실행에 옮길 수 있는 세 가지를 알려줍니다: OpenAI의 모델은 2025년 12월과 2026년 3월 사이에 다단계 일상 과제에서 훨씬 나아졌고, 그 이후 이득은 작으며, high 이상의 추론 노력은 이런 종류의 작업에서는 거의 이득이 없습니다.
알려주지 못하는 것은 비 OpenAI 모델이 어떻게 점수를 받을지, 자체 과제가 OpenAI의 169개와 어떻게 비교되는지, 또는 채점자가 무엇에 보상을 주는지입니다. 이를 위해서는 위에서처럼 자체 노력 스윕을 실행하고 볼 수 있는 숫자를 비교하세요. GPT-6 Astra 실습 테스트는 실행할 가치가 있는 검사 종류의 시작점입니다.
자주 묻는 질문
LifeVal은 무엇의 약자인가요?
OpenAI는 페이지에서 이름을 풀어 쓰지 않습니다. 이는 일상생활("Life") 과제에 대한 평가("Val")입니다: 돌봄, 건강, 교육, 가사 관리, 개인 재정, 쇼핑, 정부 서비스에 걸친 169개의 에이전트 시나리오입니다.
GPT-6 Astra의 LifeVal 점수는?
xhigh 노력에서 평균 보상 80.6%로, OpenAI가 Astra 출시 블로그에서 사용한 설정입니다. max 노력에서 Astra는 82.5%, high에서는 80.7%를 기록합니다.
LifeVal을 직접 실행할 수 있나요?
아니요. OpenAI는 과제 세트, 루브릭 또는 채점자를 공개하지 않았습니다. Apidog CLI와 같은 테스트 하네스로 자체 프롬프트에서 노력 대비 비용 분석을 근사할 수는 있지만, LifeVal 점수를 재현할 수는 없습니다.
LifeVal에 Claude나 Gemini가 포함되나요?
아니요. 두 차트 모두 GPT-5.2부터 GPT-6 Astra까지 OpenAI 모델만 포함합니다. GPT-6.1 Sol과 GPT-6.1 Terra도 빠져 있습니다.
LifeVal 비용 열은 달러인가요?
OpenAI는 이를 API 비용이라고 표시하지만 단위를 명시하지 않습니다. 과제당 달러 수치로 사용하기보다는 설정을 서로 비교하는 데 사용하세요. 예를 들어 GPT-5.6 max의 9.65와 Astra max의 20.04를 비교할 수 있습니다.
일상적인 에이전트 과제에는 어떤 추론 노력을 사용해야 하나요?
LifeVal에서 medium 또는 high가 대부분의 이득을 포착합니다. GPT-6 Astra는 high에서 80.7%, xhigh에서 80.6%를 기록하므로, 더 많은 비용을 지불하기 전에 자체 과제에서 medium과 high를 테스트하세요.