
Jev는 TypeSafe AI의 새로운 종류의 모델입니다. 텍스트를 작성하지 않습니다. 프로그램 상태를 제공하고, 답을 얻어야 하는 질문을 선언하면, 보정된 확률과 함께 유형화된 답변을 반환합니다: 예/아니오 확률, 목록에서 선택, 또는 루브릭(평가 기준표)에 따른 점수. TypeSafe는 이를 "시스템 원 모델(System One Model)"이라고 부르며, 그 요지는 간단합니다: 소프트웨어 내 대부분의 AI 호출은 산문을 요구하는 것이 아니라, 결정을 요구합니다. LLM을 분류기에 연결하고 그 응답에서 레이블을 추출하기 위한 파서를 작성했다면, Jev는 구조화된 출력이 첫 단계였던 것처럼, 바로 그러한 작업을 위해 만들어졌습니다.
2026년 9월 16일, Vercel AI Gateway에 출시되어 대부분의 개발자에게 알려지게 되었습니다. 이 가이드는 Jev가 무엇인지, 언어 모델과 어떻게 다른지, 세 가지 질문 유형, 직접 및 게이트웨이를 통한 호출 방법, 그리고 라우팅 로직에 적용하기 전 Apidog에서 테스트하고 모의(mock)하는 방법을 다룹니다.
Jev란 무엇인가
TypeSafe의 출시 게시물은 Jev를 "최첨단 지능형 함수 호출: 비정형 상태 입력, 유형화된 확률적 결정 출력"이라고 설명합니다. 세 가지 속성이 이를 정의합니다.
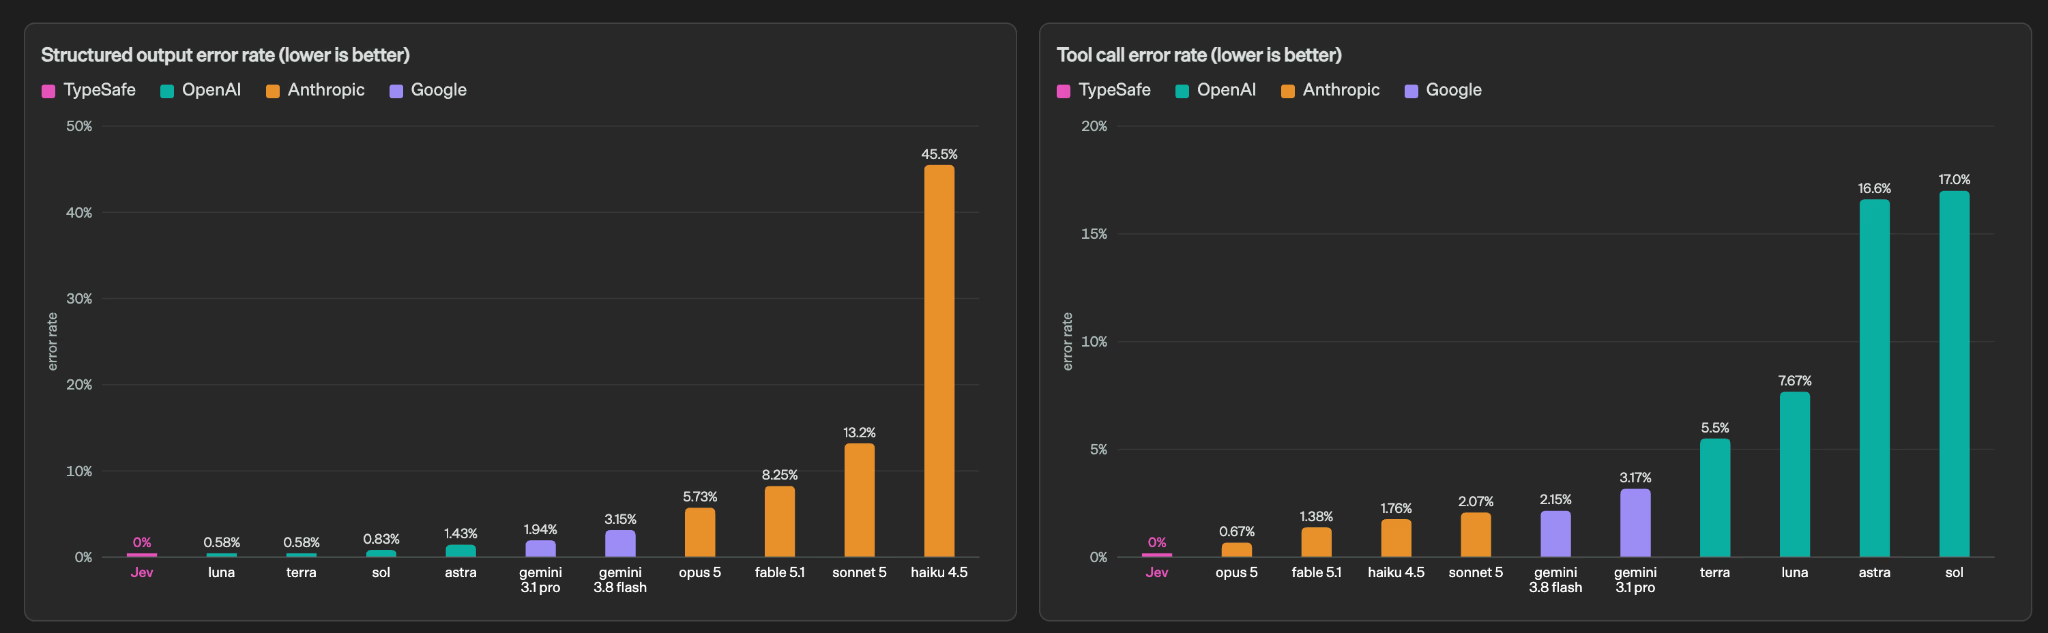
출력은 유형화되며, 호출 전에 선언됩니다. 각 질문의 형태를 미리 정의합니다. 모델은 해당 형태 내에서만 답변할 수 있으므로, 파싱할 필요가 없고 스키마 불일치를 파악할 필요도 없습니다. TypeSafe는 이를 Jev가 "절대 타입 오류를 일으키지 않는다"고 표현합니다.
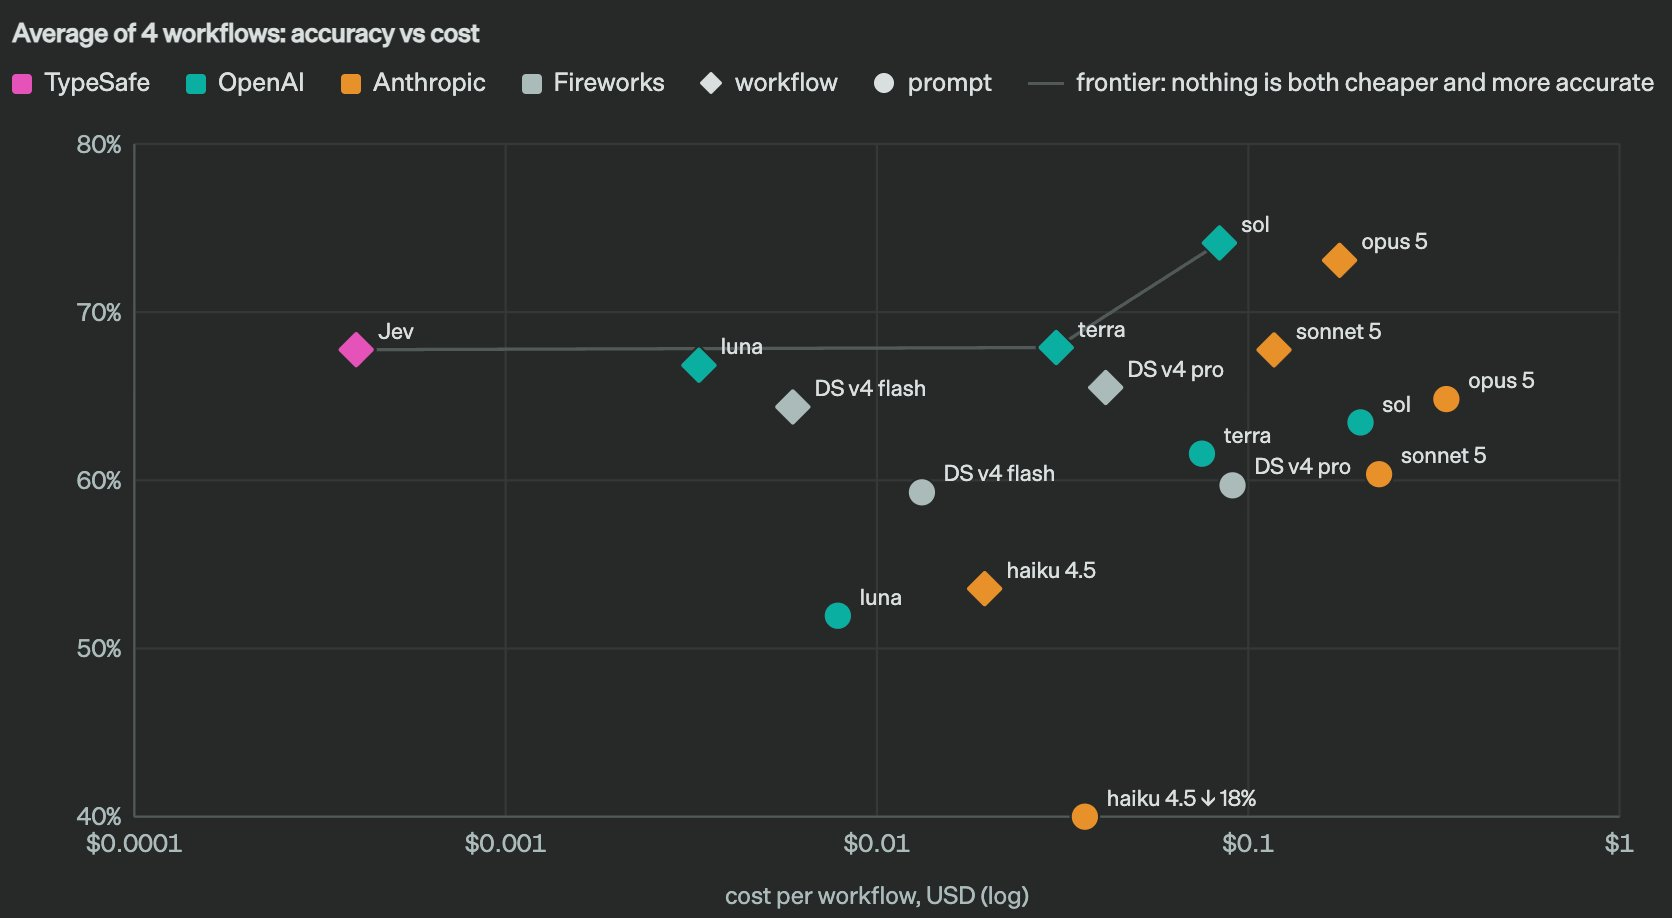
모든 답변은 확률을 포함합니다. 예/아니오 질문은 true를 반환하지 않고, 0.97과 같은 숫자를 반환합니다. 선택 질문은 옵션 전반에 걸친 전체 분포를 반환합니다. TypeSafe는 보정된 결정을 위한 강화 학습(Reinforcement Learning for Calibrated Decisions)이라는 방법을 사용하여 모델을 훈련했으며, 주장은 높은 신뢰도가 높은 정확도를 의미하므로 임계값을 설정할 수 있다는 것입니다: 명확한 사례는 자동화하고, 불확실한 사례는 사람에게 전달합니다.
질문은 하나의 요청으로 병렬적으로 답변됩니다. 언어 모델은 한 번에 하나의 토큰을 생성합니다. Jev는 선언된 모든 질문을 동일한 상태에 대해 한 번에 평가하며, 이것이 TypeSafe가 70ms에서 500ms에 이르는 종단 간(end-to-end) 응답 시간을 인용하는 이유입니다. 이는 공급업체 자체 수치이므로, 벤치마크가 아닌 사용자 워크로드에 대해 검증해야 할 주장으로 취급하십시오.
Jev가 언어 모델과 다른 점
| 언어 모델 | Jev | |
|---|---|---|
| 출력 | 파싱해야 하는 자유 형식 텍스트 | 선언한 유형화된 값 |
| 샘플링 | 순차적, 토큰 단위 | 모든 질문 병렬 처리 |
| 신뢰도 | 기본적으로 노출되지 않음 | 모든 답변에 대한 확률 |
| 최적 용도 | 작문, 채팅, 요약 | 결정, 라우팅, 점수 매기기, 검증 |
| 입력 | 메시지 | 구조화된 상태: 문자열, 객체 또는 배열 |
| 이미지 | 자주 지원됨 | 현재는 텍스트만 |
명확한 트레이드오프가 있습니다: Jev는 문자열 생성을 완전히 포기합니다. 채팅 모델이 아니며 문서를 요약하지도 않습니다. Jev가 적합한 곳은 애플리케이션 내의 "스마트 조건문"입니다: 이 티켓은 어떤 팀이 처리해야 하는지, 이 버그는 얼마나 심각한지, 이 답변은 보내기에 안전한지, 빌드가 통과했는지 등입니다.
세 가지 질문 유형
Jev의 직접 API는 세 가지 기본 요소를 노출합니다. 각 요소는 사용자가 선택한 키 아래의 JSON 객체입니다.
Noul: 예/아니오 확률. TypeSafe에서 부울 타입에 부여한 이름입니다. 답변이 '예'일 확률을 반환하며, 코드에서 이를 임계값으로 사용합니다.
{ "is_urgent": { "type": "noul", "instructions": "이 메시지는 긴급함을 표현합니까?" } }
응답: { "type": "noul", "noul": 0.99 }.
Choice: 명명된 세트에서 하나의 옵션 선택. criteria는 옵션 이름을 설명에 매핑하며, 최대 255개의 옵션을 가질 수 있습니다. 답변은 최상위 선택과 전체 분포 및 신뢰도 수치를 포함합니다.
{ "department": { "type": "choice", "instructions": "어떤 팀이 이 문제를 처리해야 합니까?",
  "criteria": { "billing": "청구, 인보이스, 결제 문제",
                "shipping": "배송 상태, 지연, 분실된 패키지",
                "returns":  "교환, 환불, 손상된 품목" } } }
응답: { "type": "choice", "choice": "returns", "confidence": 1.0, "probabilities": { "returns": 1.0, "shipping": 0.0, "billing": 0.0 } }.
Score: 순서가 있는 척도상의 위치. criteria는 2개에서 10개까지의 레벨 설명 배열이며, 가장 낮은 레벨이 먼저 옵니다. 점수는 확률 가중치 위치이므로, 척도의 칸 사이에도 올 수 있습니다.
{ "bug_severity": { "type": "score", "instructions": "보고된 문제의 심각도는 어느 정도입니까?",
  "criteria": [ "외관상 문제; 기능에 영향 없음",
                "기능 손상, 하지만 해결책 존재",
                "차단 문제; 해결책 없음" ] } }
응답: { "type": "score", "score": 1.3, "confidence": 0.54, "probabilities": { "0": 0.0, "1": 0.7, "2": 0.3 }, "legend": { "0": "외관상...", "1": "손상...", "2": "차단..." } }.
한 가지 이름 지정의 차이점: Vercel AI SDK를 통해 예/아니오 유형은 boolean이라고 불리고 답변 필드는 probability입니다. TypeSafe 자체 API에서는 noul입니다. 같은 아이디어이지만, 키가 다릅니다.
Jev를 호출하는 두 가지 방법
직접 호출. console.typesafe.ai/settings/keys에서 키를 얻은 다음, Bearer 토큰과 함께 POST https://api.typesafe.ai/v1/systemone 요청을 보냅니다. 모델 ID는 jev-latest이며, 현재 jev-1.13.0으로 확인됩니다; jev-preview는 최신 빌드를 가리킵니다(공식 여부와 관계없이). 빠른 시작 가이드에 따라 Python 및 JavaScript SDK가 존재하지만, 원시 엔드포인트는 단일 POST이며, Apidog에서 사용할 형식입니다.
Vercel AI Gateway를 통해. 모델 ID는 typesafe-ai/jev이며, AI SDK(버전 7 이상)의 experimental_evaluate를 사용하여 호출합니다. 평가 문서의 한 가지 주의사항: 평가는 Gateway의 OpenAI 호환 또는 Anthropic 호환 엔드포인트가 아닌 AI SDK를 통해서만 사용할 수 있습니다. AI Gateway의 GPT-5.6 Sol 워크스루에서처럼 이미 Gateway를 통해 모델을 라우팅하고 있다면, 이것이 자연스러운 경로입니다. 저희 Vercel AI SDK 가이드가 설정을 다룹니다.
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: '지원 상담원이 고객에게 전액 환불을 발행했습니다.',
  questions: { refunded: { type: 'boolean', instructions: '환불이 이루어졌습니까?' } },
});
// result.answers.refunded -> { type: 'boolean', probability: 0.99 }
curl을 사용한 첫 번째 요청
이는 단일 호출에서 세 가지 유형 모두로 지원 메시지를 분류합니다:
export TYPESAFE_API_KEY="..."

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "제 카드가 한 주문에 대해 두 번 청구되었고 오늘 바로 해결해야 합니다.",
    "questions": {
      "department": { "type": "choice", "instructions": "어떤 팀이 이 문제를 처리합니까?",
        "criteria": { "billing": "청구 및 환불", "shipping": "배송", "technical": "버그" } },
      "urgency": { "type": "score", "instructions": "이것은 얼마나 긴급합니까?",
        "criteria": ["낮음", "중간", "높음"] },
      "wants_refund": { "type": "noul", "instructions": "고객이 환불을 요구하고 있습니까?" }
    }
  }'
응답에는 `model`, 질문 ID로 키가 지정된 `answers` 객체, 그리고 `input_tokens` 및 `output_tokens`가 포함된 `usage`가 있습니다. `answers.department.choice`, `answers.urgency.score`, `answers.wants_refund.noul`을 읽고 임계값을 적용하십시오.
Apidog에서 Jev 테스트 및 모의(mock)
확률을 반환하는 모델은 테스트의 모습을 바꿉니다. 더 이상 문자열을 단언하는 것이 아니라, 숫자가 특정 선을 넘는지 단언하는 것입니다. Apidog는 이를 일회성 curl이 아닌 저장되고 반복 가능한 검사로 만듭니다.
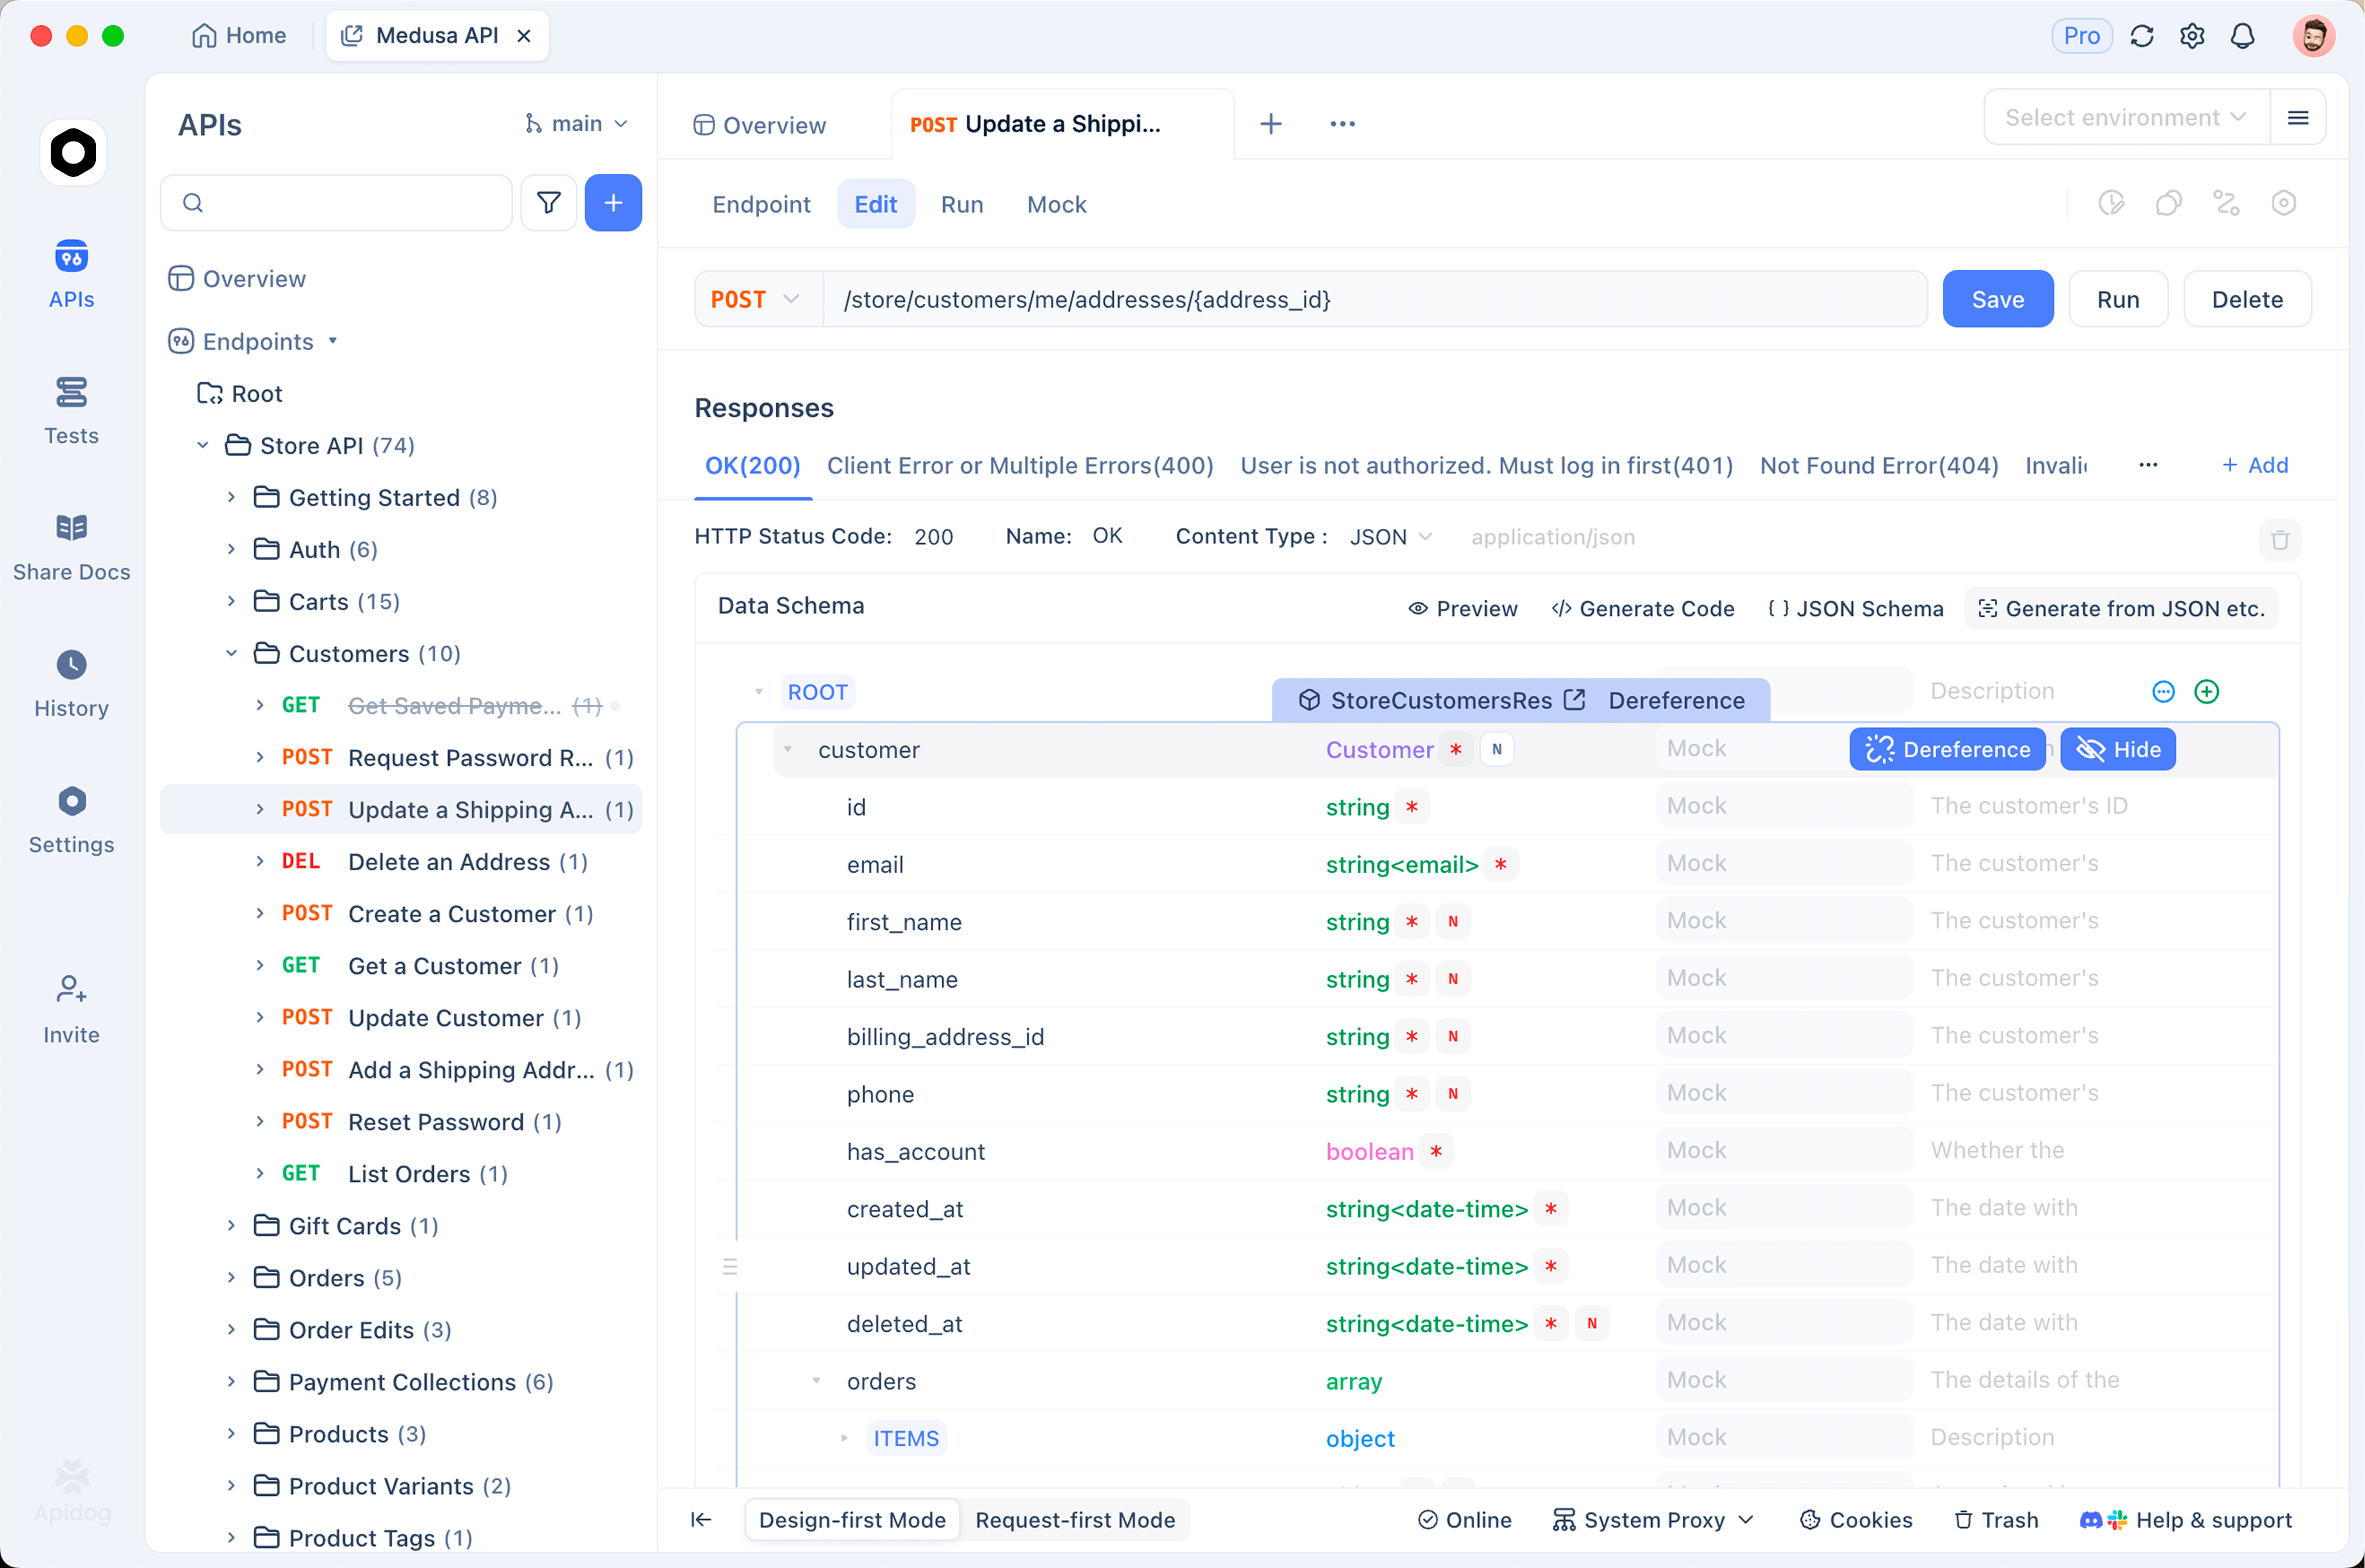
키 저장. 환경 관리(Environment Management)를 열고 `TypeSafe`라는 이름의 환경을 생성한 다음, 로컬 필드에 실제 값으로 `TYPESAFE_API_KEY`를 추가하여 컴퓨터에 유지하고 팀에 동기화되지 않도록 합니다. 환경 및 비밀 변수에 대한 저희 가이드가 스코프 규칙을 다룹니다.
요청 구축. 새 요청, `POST https://api.typesafe.ai/v1/systemone`, `{{TYPESAFE_API_KEY}}`를 포함한 Bearer Token 인증 유형, curl 예시의 JSON 본문. 이를 전송하고 응답 패널에서 답변을 읽으십시오.
텍스트가 아닌 결정에 단언. `answers.department.choice`가 `billing`과 같고, `answers.wants_refund.noul`이 `0.9`보다 크며, `answers.urgency.score`가 `1.5`보다 큰 것과 같은 후처리 단언을 추가하십시오. 이제 Jev의 동작이나 사용자 기준 문구의 회귀는 조용히 티켓을 잘못 라우팅하는 대신 테스트에 실패하게 됩니다.
프런트엔드용으로 모의. 응답을 모의로 저장하면, 토큰을 사용하거나 모델을 기다릴 필요 없이 안정적인 `answers` 객체를 기반으로 티켓 UI를 구축하고 시연할 수 있습니다. 형태가 선언되어 있기 때문에, 모의 응답과 실제 응답이 서로 달라질 수 없습니다.
시나리오로 저장. 몇 가지 상태, 즉 침착한 메시지, 화난 메시지, 모호한 메시지를 연결하고 모호한 경우에 신뢰도가 떨어지는지 단언하십시오. 이것이 임계값이 제대로 작동하는지 알려주는 확인입니다. 이를 설정하려면 Apidog를 다운로드하십시오. 무료 요금제는 4인 팀까지 지원합니다.
가격, 제한 및 오류
TypeSafe의 모델 페이지에서:
- 가격: 백만 입력 토큰당 $0.042. 출력 토큰은 청구되지 않습니다. Gateway에서도 백만 입력당 $0.042로 동일하게 명시되어 있습니다.
- 요청 제한: 초당 250,000 토큰, 분당 1,200 요청 (동적으로 조정됨).
- 컨텍스트: 요청당 64k 토큰, 그 중 32k는 `state` 및 가장 긴 질문에 사용됩니다.
- 입력: 텍스트만 가능합니다. 문자열, JSON 객체 또는 텍스트 배열. 이미지, 오디오, 비디오는 불가합니다.
- 언어: 영어가 가장 좋으며, 다른 언어는 정확도가 낮아질 수 있습니다.
오류는 HTTP 상태 코드로 반환됩니다: 키가 없거나 유효하지 않으면 `401`, 본문 유효성 검사에 실패하면 `422`(단일 레벨의 Score, 기준이 없는 Choice 등), 요청 제한을 초과하면 `429`, 서비스 과부하 시 `529`입니다. 마지막 두 가지의 경우 물러났다가 다시 시도하십시오. SDK는 기본적으로 이를 수행합니다.
자주 묻는 질문
Jev는 LLM을 대체합니까?
아니요. LLM 호출 중 결정을 요청하고 이를 얻기 위해 텍스트를 파싱하던 부분을 대체합니다. 생성, 채팅, 요약은 여전히 언어 모델이 필요합니다.
Jev는 환각 현상을 일으킬 수 있습니까?
틀릴 수는 있지만, 선언한 스키마 외의 답변을 생성할 수는 없습니다. TypeSafe의 주장은 스키마 일치가 보장되므로 "환각된" 레이블은 불가능하다는 것입니다. 낮은 신뢰도의 잘못된 레이블은 여전히 가능하며, 이것이 확률이 중요한 이유입니다.
실제로 "보정된"이란 무엇을 의미합니까?
만약 모델이 `0.9`라고 말한다면, 해당 종류의 질문에 대해 약 90%의 시간 동안 정확해야 합니다. 이를 통해 임계값을 선택하고 그 이상을 자동화할 수 있습니다. 숫자를 신뢰하기 전에 자체 데이터로 테스트하십시오. 레이블이 지정된 상태로 Apidog에 저장된 시나리오는 이를 수행하는 저렴한 방법입니다.
Jev를 사용하려면 Vercel이 필요합니까?
아니요. api.typesafe.ai의 직접 API는 Bearer 키로 자체적으로 작동합니다. Vercel AI Gateway는 이미 AI SDK를 사용하는 경우의 편의 기능이며, `experimental_evaluate`를 지원하는 유일한 경로입니다. 어느 쪽이든, 선언된 형태 뒤에 있는 JSON 스키마 기본 사항을 아는 것이 좋습니다.
Jev가 적합한 곳
질문에 고정된 답변 세트가 있고 그에 대한 확률이 필요할 때(라우팅, 분류, 점수 매기기, 검증, 가드레일) Jev를 사용하십시오. 단어가 필요한 모든 것에는 언어 모델을 유지하십시오. 형태를 선언하고, Apidog에서 임계값을 테스트하며, 신뢰도 숫자가 무엇을 자동화할지 결정하게 하십시오.