
GPT-Live-1.1은 OpenAI의 전이중(full-duplex) 음성 모델로, 2026년 11월 20일부터 API에서 사용할 수 있습니다. 말하는 도중에도 듣고, 추론과 도구 호출은 사용자가 선택한 백엔드 모델에 위임하며, 분 단위로 과금됩니다. 활성 분당 $0.05, 대기 분당 $0.02입니다. Realtime API가 아닌 단일 엔드포인트인 v1/live/sessions를 통해 접근합니다.
이전에 발행한 GPT-Live란 무엇인가 글에서는 개발자가 직접 호출할 수 있기 전의 ChatGPT 음성 기능을 다뤘습니다. 이 가이드에서는 API 모델을 다룹니다. 무엇이 새로워졌는지, 비용은 얼마인지, 세션이 어떻게 동작하는지, 그리고 GPT-Realtime과 어떻게 다른지 살펴봅니다.
GPT-Live-1.1이란?
GPT-Live-1.1은 실시간으로 음성 대화를 진행하면서, 실제 사고는 별도의 백엔드 모델이 수행하는 음성 모델입니다. 오디오와 텍스트를 입력받고 오디오와 텍스트를 반환하며, 말하는 동안에도 계속 듣고 있기 때문에 상대방이 문장 중간에 끼어들거나 내용을 추가할 수 있습니다. 모델 ID는 gpt-live-1.1이며, 스트리밍과 함수 호출을 지원합니다.
GPT-Live-1.1 모델 페이지는 이 모델을 "다국어 대화를 위한 전이중 음성 모델"이라고 소개합니다. 전이중(full-duplex)이란 전화 통화처럼 오디오가 양방향으로 동시에 흐른다는 의미로, 한쪽이 기다려야 하는 무전기 방식과는 다릅니다.
이 설계의 또 다른 축은 위임(delegation)입니다. GPT-Live는 요청에 실질적인 작업이 필요한 시점을 판단해 백엔드(OpenAI Responses 모델 또는 직접 만든 에이전트)로 전달하고, 백엔드가 작업을 수행하는 동안에도 대화를 이어가다가 결과가 나오면 이를 음성으로 설명해 줍니다.
GPT-Live-1에서 달라진 점
GPT-Live-1.1은 GPT-Live-1과 동일한 엔드포인트, 가격, 기능 세트를 유지합니다. 달라진 부분은 음성 품질과 작업 처리 능력입니다. OpenAI가 모델 문서와 X 발표에 정리한 내용은 다음과 같습니다:
| 영역 | GPT-Live-1 | GPT-Live-1.1 |
|---|---|---|
| 음성 전사 | 기준선 | 모델 페이지 기준, 더 정확함 |
| 언어 간 억양과 목소리 | 기준선 | 모델 페이지 기준, 더 일관성 있음 |
| 유휴 세션 | 페이지에 표기된 대기 요금 | 대기가 새 옵션으로 발표됨, 분당 $0.02 |
| 작업 완수 | 기준선 | OpenAI 발표 기준, "작업을 한층 더 안정적으로 완수" |
| 엔드포인트 | v1/live/sessions |
v1/live/sessions |
| 가격(활성) | 분당 $0.05 | 분당 $0.05 |
| 요금 제한 | 동시 세션 | 별도의 동시 세션 제한 |
OpenAI는 전사 정확도나 안정성 향상에 대한 벤치마크 수치를 공개하지 않았으므로, 직접 측정해 보기 전까지는 벤더 주장으로 받아들이는 것이 좋습니다. 또한 OpenAI의 발표는 대기 모드를 이번 릴리스의 신규 기능으로 소개하지만, GPT-Live-1 페이지에도 이제 동일한 분당 $0.02 대기 요금이 표기되어 있습니다.
두 모델은 엔드포인트와 가격을 공유하므로, 전환은 세션의 model을 gpt-live-1.1로 설정하는 것에서 시작합니다. 이후 자체 음성 평가를 다시 실행해 실제 트래픽에서 개선 효과를 확인하세요.
GPT-Live-1.1 가격
GPT-Live-1.1은 음성 세션을 토큰이 아닌 시간 기준으로 과금합니다. 2026년 11월 20일 기준 OpenAI 가격 페이지에 표시된 요금은 다음과 같습니다:
| 항목 | 가격 |
|---|---|
| 활성 세션 시간 | 분당 $0.05 |
| 대기 세션 시간 | 분당 $0.02 |
| 백엔드 모델 및 도구 | 해당 모델의 일반 요율로 별도 과금 |
비용을 추정할 때 알아두어야 할 과금 세부 사항은 다음과 같습니다:
- 초 단위 과금. 사용 시간은 다음 정각 분 단위로 올림되지 않습니다.
- 대기 요금은 WebRTC 전용. 할인된 요금은 추론이 일시 중지된 WebRTC 세션에 적용됩니다.
- 초기화 요금. WebRTC 세션 생성 시 설정 과정에서 15초가 과금되며, 세션이 시작되면 사용 시간 요금에서 차감됩니다.
- 백엔드는 두 번째 청구서. 위임된 Responses 토큰과 도구 호출에도 요금이 부과됩니다.
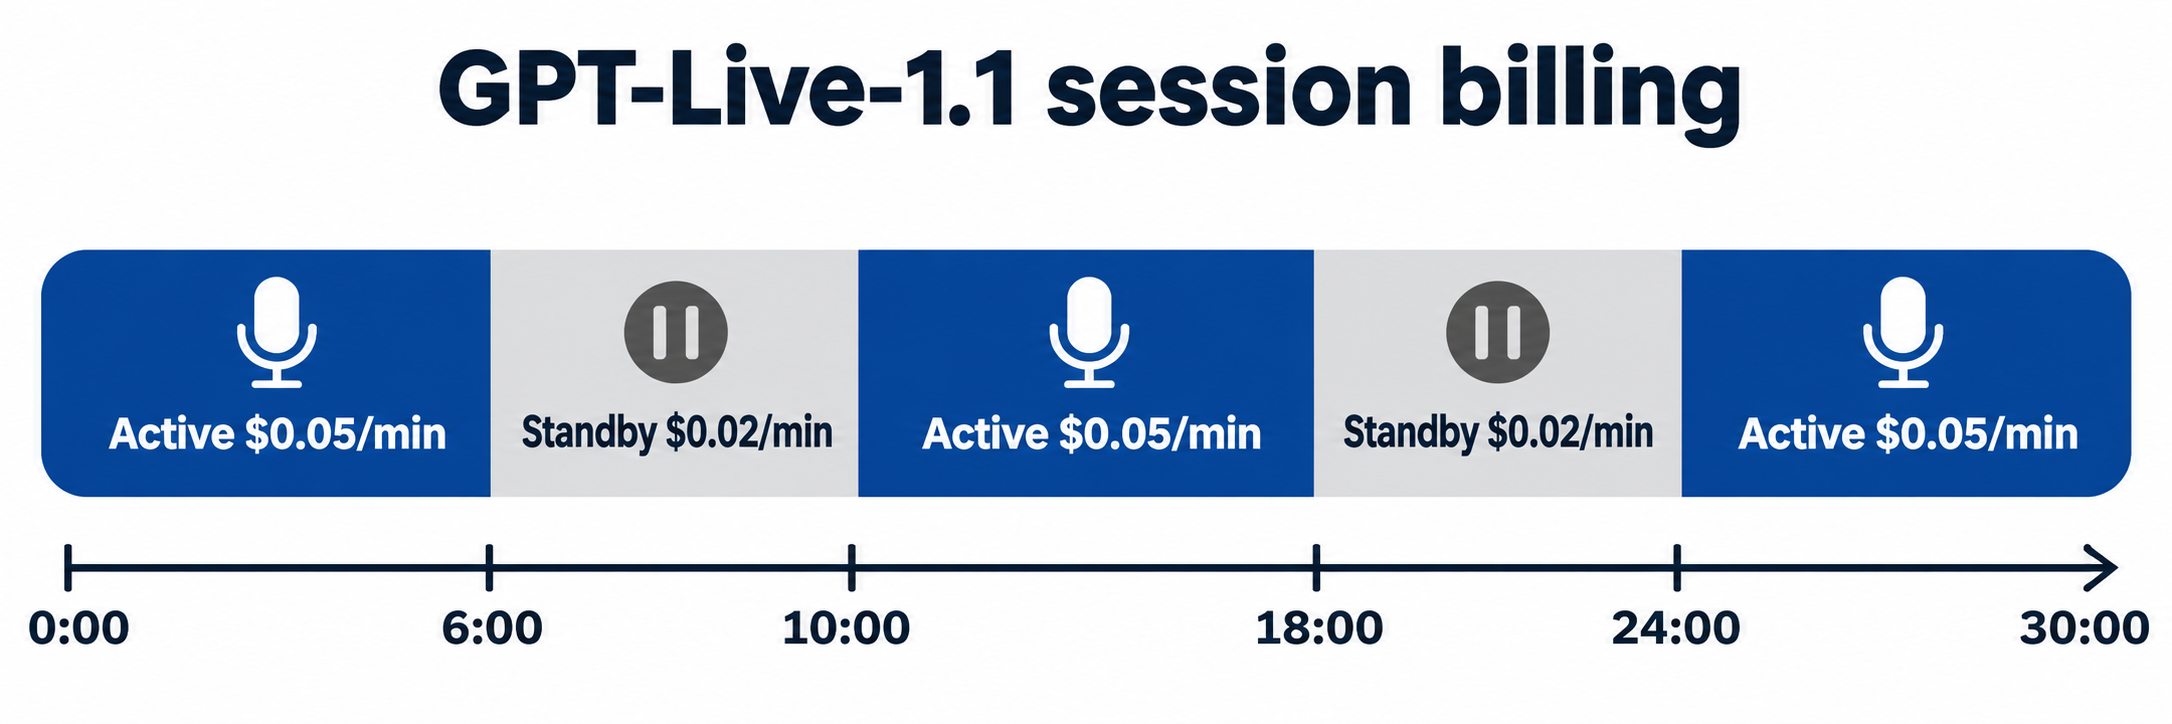
위 타임라인을 활용한 계산 예시: 30분짜리 고객 지원 세션에서 상담원이 자료를 확인하는 동안 20분은 활성 상태, 10분은 대기 상태였다고 가정해 봅시다. 음성 비용은 20 x $0.05 + 10 x $0.02 = $1.20입니다. 대기 모드가 없었다면 같은 세션은 30 x $0.05 = $1.50의 비용이 듭니다. 여기에 백엔드 모델이 위임 작업에 소비한 비용을 더하면 됩니다.
GPT-Live-1.1의 동작 방식: 음성 + 위임
GPT-Live 애플리케이션은 두 부분으로 구성됩니다. 시작 가이드는 이를 다음과 같이 구분합니다:
- GPT-Live는 대화를 담당합니다. 듣고, 말하고, 백엔드의 도움이 필요한 시점을 판단합니다. 말투와 위임 시점에 대한 짧은 프롬프트를 제공하면 됩니다.
- 백엔드는 위임된 작업을 처리합니다. 추론하고, 도구를 호출하고, 결과를 반환하면 GPT-Live가 이를 음성으로 전달합니다. 상세 지침, 비즈니스 규칙, 도구 워크플로가 이곳에 위치합니다.
- 애플리케이션은 위험 요소를 담당합니다. 권한 확인, 확인 절차 수집, 시스템에 접근하는 함수 실행, 작업 진행 상태 저장을 처리합니다.
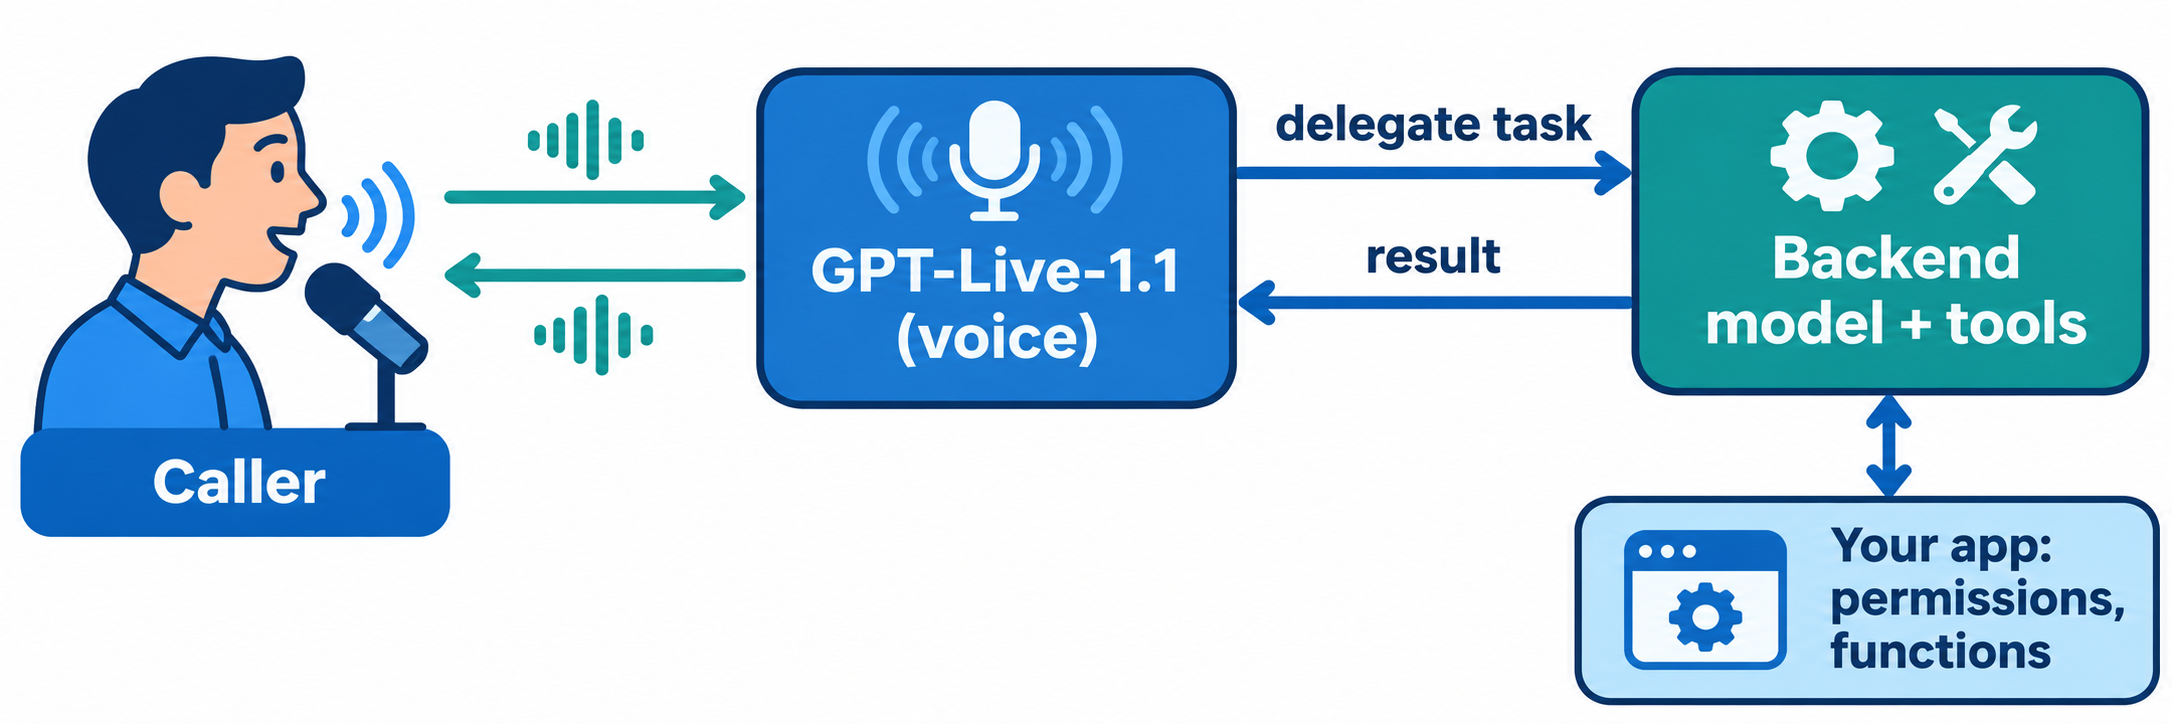
세션을 생성할 때 두 가지 위임 모드 중 하나를 선택하며, 세션 도중에 모드를 변경할 수 없습니다:
| 모드 | 백엔드 실행 주체 | 선택 시점 |
|---|---|---|
| Responses 위임 | OpenAI가 구성된 Responses 모델을 호출하고 컨텍스트와 결과를 전달 | GPT-Live가 백엔드 요청을 대신 관리하기를 원할 때 |
| 클라이언트 위임 | 애플리케이션이 임의의 모델, 에이전트 또는 서비스를 실행하고 결과를 반환 | 결과를 검증, 마스킹, 조합해야 하거나 OpenAI 외 백엔드를 사용할 때 |
위임 가이드는 Responses 위임부터 시작할 것을 권장합니다. 클라이언트 위임은 기존 텍스트 에이전트 앞에 음성을 붙이려는 팀에 적합합니다.
첫 GPT-Live-1.1 세션 만들기
GPT-Live는 자체 엔드포인트를 사용합니다. 모델 페이지는 v1/live/sessions를 지원 대상으로 표기하고, Chat Completions, Responses, v1/realtime은 지원하지 않는 것으로 표시합니다. OpenAI는 오디오에 WebRTC를 권장하며, WebSockets과 SIP를 대안으로 제시합니다.
퀵스타트의 WebRTC 흐름은 다음 5단계로 진행됩니다:
- 브라우저가 마이크 접근 권한을 요청하고 트랙을 피어 연결에 추가합니다.
- 데이터 채널을 생성한 뒤 SDP 오퍼를 만듭니다.
- 브라우저가 오퍼를 서버로 전송합니다.
- 서버가
session과transport: { type: "webrtc", sdp }를 API 키와 함께POST /v1/live/sessions로 전송합니다. - 브라우저가 반환된 SDP 응답을 적용하고
session.started를 기다립니다.
다음은 OpenAI의 TypeScript 예제에서 세션 설정 부분만 발췌한 서버 호출입니다:
const result = await client.live.create({
  session: {
    model: "gpt-live-1.1",
    instructions:
      "Be concise. Delegate requests needing current information to the backend, which can search the web.",
    delegation: {
      type: "responses",
      responses: {
        model: "gpt-5.6-terra",
        instructions:
          "Use web search when current facts are needed. Return concise, grounded results for a spoken conversation.",
        tools: [{ type: "web_search" }],
        tool_choice: "auto",
      },
    },
  },
  transport: { type: "webrtc", sdp: request.body.sdp },
});
API 키는 서버에 두고, 데이터 채널로 session.start를 보내지 마세요. HTTP 요청이 이미 세션을 시작합니다. OpenAI는 대화, 위임, 백엔드 도구 활동을 관찰할 수 있는 로컬 샘플 앱인 OpenAI Live Console도 제공합니다.
대기 모드: 유휴 비용 줄이기
대기 모드는 아무도 말하지 않는 동안 WebRTC 연결을 유지하다가, 누군가 말을 하면 추론을 재개합니다. 연결과 세션 ID는 그대로 유지되며, 세션이 재개되면 대화 기록도 복원됩니다.
세션 필드 두 개로 활성화합니다:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 20
  }
}
wake_policy.type: "speech"는 추론을 시작하기 전에 음성이 감지되기를 기다립니다.idle_timeout_s는 5~60 사이의 정수를 받습니다. 입력 또는 출력 전사가 이 시간(초) 동안 없으면 세션이 대기 상태로 전환됩니다.vad_threshold는 0~1 범위이며 기본값은 0.5입니다. 값이 높을수록 대기를 깨우기 위해 더 확실한 음성 감지가 필요합니다.
상태를 추적하려면 session.paused와 session.resumed 이벤트를 수신하고, 마이크 트랙은 활성 상태로 유지하세요. 세션 관리 가이드에서 언급하는 트레이드오프 하나: 대기 후 짧은 발화에 대한 첫 응답은 더 오래 걸릴 수 있습니다. 공백이 길어질 것 같다면 대기 모드보다 세션을 닫고 새로 시작하는 편이 비용이 저렴할 수 있습니다.
GPT-Live-1.1 vs GPT-Realtime
OpenAI의 음성 에이전트 가이드는 아키텍처를 기준으로 선택 기준을 제시합니다. GPT-Live는 별도 백엔드를 갖춘 전이중 대화에 적합하고, Realtime API는 듣고, 추론하고, 도구를 호출하고, 말하는 것을 하나의 세션에서 처리하는 단일 모델에 적합합니다.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| 엔드포인트 | v1/live/sessions |
v1/realtime |
| 설계 | 음성 프론트엔드 + 위임된 백엔드 | 단일 음성 대 음성 모델 |
| 입력 | 오디오, 텍스트 | 텍스트, 오디오, 이미지 |
| 과금 | 활성 분당 $0.05, 대기 분당 $0.02 | 토큰 기준: 오디오 토큰 100만 개당 입력 $32, 출력 $64 |
| 백엔드 비용 | 별도 과금 | 토큰 가격에 포함 |
| 적합한 용도 | 기존 텍스트 에이전트에 음성 추가 | 자체 완결형 음성 에이전트 |
분 단위 과금 덕분에 GPT-Live는 긴 통화의 음성 비용을 예측하기 쉽습니다. Realtime의 토큰 과금은 오디오와 텍스트 처리량에 따라 달라지며, 추론 비용까지 한 가격에 포함됩니다. 이전 비교에 대한 자세한 내용은 GPT-Live vs GPT-Realtime과 GPT-Realtime-2 API 가이드를 참고하세요.
요금 제한과 접근
GPT-Live의 제한은 토큰이 아닌 동시 세션 수를 기준으로 합니다. GPT-Live-1.1과 GPT-Live-1은 인퍼런스 리전 전체에 적용되는 별도의 제한을 갖습니다. GPT-Live-1 페이지는 Build 티어에서 50개, Launch에서 300개, Grow에서 500개의 동시 세션을 허용하며 Free 티어는 미지원으로 표기합니다. GPT-Live-1.1 페이지에는 아직 자체 표가 공개되지 않았으므로, 부하 계획 전에 조직의 제한 페이지를 확인하세요.
Apidog CLI로 세션 서버 테스트하기
GPT-Live 통합에는 직접 소유하는 HTTP 영역이 있습니다. SDP 오퍼를 주고받는 /api/session 엔드포인트입니다. OpenAI의 예제는 예상치 못한 오리진에 대해 403을, SDP 오퍼가 없으면 400을 반환합니다. 이 경로는 OpenAI에 도달하지 않으므로 음성 비용 0으로 매 커밋마다 테스트할 수 있습니다. Apidog CLI를 사용해 코딩 에이전트가 테스트를 작성하고 실행하도록 하세요.
CLI를 설치하고, 로그인한 뒤, 에이전트에 Apidog 스킬을 추가합니다:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그리고 에이전트에 프롬프트 하나를 전달합니다:
In Apidog project <projectId>, add POST /api/session for my GPT-Live-1.1 server.
Create test cases that assert: a request with a wrong Origin header returns 403,
a request with no sdp field returns 400. Run them against the local environment
and summarize any failures.
에이전트는 스키마를 읽고, 페이로드를 검증하고, 엔드포인트와 테스트 케이스를 생성한 뒤 실행합니다:
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file ./endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
동일한 apidog run 명령에 -r junit 옵션을 붙이면 CI에 바로 연동할 수 있습니다. CI/CD 파이프라인에서 Apidog CLI 실행하기를 참고하세요. Claude Code를 사용한다면 Claude Code에서 Apidog CLI 사용 가이드가 설정 과정을 안내합니다. Apidog의 Free 플랜은 최대 4명의 팀까지 무료로 사용할 수 있습니다.
FAQ
GPT-Live-1.1은 API에서 사용할 수 있나요? 네. OpenAI는 2026년 11월 20일부터 GPT-Live-1.1을 API에서 제공하며, 모델 ID는 gpt-live-1.1, 엔드포인트는 v1/live/sessions입니다. 이전에 발행한 GPT-Live API 글은 이 릴리스 이전의 내용입니다.
GPT-Live-1.1 비용은 얼마인가요? 활성 분당 $0.05, 대기 분당 $0.02이며 초 단위로 과금됩니다. 백엔드 모델과 도구 사용은 일반 요율로 별도 과금됩니다.
GPT-Live-1과 GPT-Live-1.1의 차이는 무엇인가요? GPT-Live-1.1은 음성을 더 정확하게 전사하고, 언어 간에 더 일관된 억양과 목소리를 유지하며, 유휴 세션을 위한 대기 옵션을 추가했습니다. 가격과 엔드포인트는 동일합니다.
GPT-Live-1.1은 이미지를 볼 수 있나요? 직접적으로는 불가능합니다. 이미지를 비전 기능이 있는 백엔드 모델로 보내고, 그 모델이 반환한 텍스트를 GPT-Live가 사용하도록 하세요.
GPT-Live-1.1은 함수 호출을 지원하나요? 네. 모델 페이지에 스트리밍과 함수 호출이 표기되어 있습니다. 실제로는 백엔드가 위임을 통해 도구 호출을 처리하고, 애플리케이션이 사용자 정의 함수를 실행합니다.