
DeepSeek은 가장 작은 모델로 주력 제품을 단종했습니다. 2026년 9월 10일, DeepSeek-V4.1-Flash가 API에서 정식 출시(GA)되었으며, 릴리스 노트에는 대부분의 연구소에서 숨길 법한 문구가 담겨 있습니다: 9월 14일부터 deepseek-v4-pro로 향하는 모든 요청은 V4.1-Flash로 라우팅되며 Flash 가격으로 청구됩니다. 입력 시 8B 매개변수가 활성화되는 552B 매개변수 Flash 모델이 이제 전체 V4 제품군을 담당합니다.
이것이 이번 주 "deepseek v4.1 flash" 검색의 배경이며, 두 가지 이유로 중요합니다. 첫째, 아키텍처가 새롭습니다. Causal Encoder-Decoder 분할, 토큰당 890바이트의 FP4 KV 캐싱, 그리고 첫 번째 사전 훈련 단계부터 기본적으로 지원되는 비전 기능은 DeepSeek V4에 대한 점진적인 변경 사항이 아닙니다. 둘째, 요금표가 함께 변경되었습니다. V4-Pro 요금을 지불하고 있었다면, 9월 14일에는 변경 여부와 관계없이 청구 금액이 70% 이상 감소합니다.
이 가이드는 출시된 내용, 개발자 관점에서 아키텍처가 작동하는 방식, 공급업체 벤치마크 결과, 그리고 가격 계산에 대해 다룹니다. 벤치마크 표는 시작점이지 최종 판단이 아니므로, Apidog에서 자신의 프롬프트를 사용하여 모델을 테스트하는 워크플로우로 마무리합니다.
요약
- 2026년 9월 10일부로 DeepSeek-V4.1-Flash가 정식 출시(GA)되었습니다. 모델 ID:
deepseek-flash. 기본 URL은https://api.deepseek.com으로 변경되지 않았습니다. - 552B MoE (비전 인코더 포함 시 763B), 사전 채우기(prefill)에 8B 활성, 디코드(decode)에 16B 활성. 1M 컨텍스트, 최대 384K 출력.
- DeepSeek 자체 수치에 따르면 HumanEval, GSM8K, DeepSWE 및 Terminal-Bench에서 V4-Pro를 능가합니다.
- 최고 요금: 캐시 미스 입력 1M당 $0.30, 출력 1M당 $1.20. 비수기에는 절반입니다.
- V4-Pro 요청은 9월 14일 04:00 UTC에 V4.1-Flash로 다시 라우팅됩니다.
9월 10일에 출시된 내용
DeepSeek은 9월 8일부터 deepseek-v4.1-flash-expires-on-0910이라는 모델 이름으로 2일간 내부 베타를 실행했으며, 계정당 동시 요청 20개로 제한되었고 deepseek-v4-flash와 동일한 가격으로 책정되었습니다. 테크노드(TechNode)가 이 베타에 대해 보도했습니다. 이틀 후 모델은 2026년 9월 10일자 변경 로그 항목과 X에 대한 발표와 함께 정식 출시(GA)되었습니다.
코드에 중요한 세 가지 이름 변경 사항:
- 새로운 모델 ID는
deepseek-flash입니다. 새로운 통합에 사용하세요. - 레거시 이름인
deepseek-v4-flash및deepseek-v4-flash-vision-exp는 여전히 인식되지만, V4.1-Flash에서 제공됩니다. V4-Flash 및 V4-Flash-Vision-Exp는 별도의 모델로 단종되었습니다. deepseek-v4-pro는 9월 14일까지 계속 작동하며, 그 이후에는 V4.1-Flash로 라우팅됩니다.
기본 URL은 변경되지 않았습니다: OpenAI 형식의 경우 https://api.deepseek.com, Anthropic 형식의 경우 https://api.deepseek.com/anthropic. Responses API는 이미 Flash 라인에서 지원되었으므로, Codex 스타일 통합은 그대로 유지됩니다. 이미지 입력 및 추론 노력(reasoning effort)을 포함한 매개변수 세부 정보는 DeepSeek-V4.1-Flash API 사용 방법을 참조하세요.
개발자를 위한 Causal Encoder-Decoder 아키텍처
모델 카드는 DeepSeek이 Causal Encoder-Decoder, 즉 CED라고 부르는 설계를 설명합니다. 토큰 비용을 지불하는 사람으로서 각 숫자가 의미하는 바는 다음과 같습니다.
552B 매개변수, 비전 포함 시 763B. 언어 핵심(backbone)은 552B 매개변수의 전문가 혼합(MoE) 모델입니다. 이번 출시를 위해 처음부터 훈련된 DeepSeek-ViT 인코더를 추가하면 전체 모델은 763B에 도달합니다. 이는 저장된 매개변수이며, 요청 비용을 의미하는 것이 아닙니다.
사전 채우기(prefill)에 8B 활성, 디코드(decode)에 16B 활성. 이것이 주요 변경 사항입니다. 40개의 레이어가 20개의 인코더 레이어와 20개의 디코더 레이어로 분할됩니다. 프롬프트를 읽는 단계(사전 채우기)에서는 토큰당 약 8B 매개변수가 활성화됩니다. 답변을 작성하는 단계(디코드)에서는 약 16B가 활성화됩니다. 이전 DeepSeek MoE 모델은 두 단계 모두에 대해 하나의 활성 매개변수 예산을 사용했습니다.
이 분할이 왜 중요할까요? 사전 채우기는 계산 제약(compute-bound)이 있습니다: 200K 토큰 문서를 모델에 한 번에 통과시킵니다. 디코드는 메모리 제약(memory-bound)이 있습니다: 한 번에 하나의 토큰을 생성하며, 비용은 HBM에서 가중치와 KV 캐시를 읽는 것입니다. 사전 채우기에 더 적은 매개변수를 사용하면 긴 입력에서 첫 번째 토큰까지의 시간이 단축됩니다. 디코드에 더 많은 매개변수를 사용하면 메모리 트래픽에 비해 추가 계산 비용이 저렴한 곳에서 답변 품질을 확보할 수 있습니다. 2K 토큰 답변을 생성하는 1M 컨텍스트 에이전트 트레이스는 토큰의 99.8%에 대해 저렴한 경로를 택합니다.
계층당 384개의 라우팅된 전문가와 1개의 공유 전문가. 라우터는 토큰당 384개 전문가 중 몇 개를 선택하고, 공유 전문가는 항상 실행됩니다. 이것이 552B 저장 매개변수가 8B 또는 16B 활성 매개변수가 되는 방식입니다.
CSA2 및 FP4 KV 캐시. Compressed Sparse Attention 2는 세 가지 정적 어텐션 모드와 함께 제공됩니다. 메인 KV 캐시를 위한 FP4 스토리지와 결합하여, 전역 캐시 공간은 토큰당 890바이트로, DeepSeek-V4-Flash의 약 4분의 1입니다. 릴리스 노트에 따르면 이전 세대의 HBM의 1/4, SSD 스토리지의 1/8이라고 합니다. 토큰당 890바이트 기준으로, 전체 1M 토큰 컨텍스트는 약 0.9GB의 KV 캐시가 필요합니다. 이것이 Flash의 동시성 제한이 2,500인 반면 Pro는 500인 이유 중 일부입니다.
1M 컨텍스트, 384K 출력. 희소 어텐션(Sparse attention)은 64K에서 훈련되었으며, 45T 토큰 멀티모달 코퍼스의 34T 토큰 지점에서 1M으로 확장되었습니다. 추론 노력(Reasoning effort)은 1에서 100까지의 척도로 지속적으로 제어 가능하다고 설명됩니다. 해당 척도에 대한 정확한 API 매개변수 형태는 [문서와 대조하여 확인 필요]합니다.
벤치마크: DeepSeek 보고서
이 섹션의 모든 수치는 모델 카드에서 DeepSeek이 보고한 것입니다. 9월 10일 현재 독립적인 평가는 발표되지 않았습니다. 이를 공급업체의 주장으로 읽고, 자체적으로 테스트를 실행해 보세요.
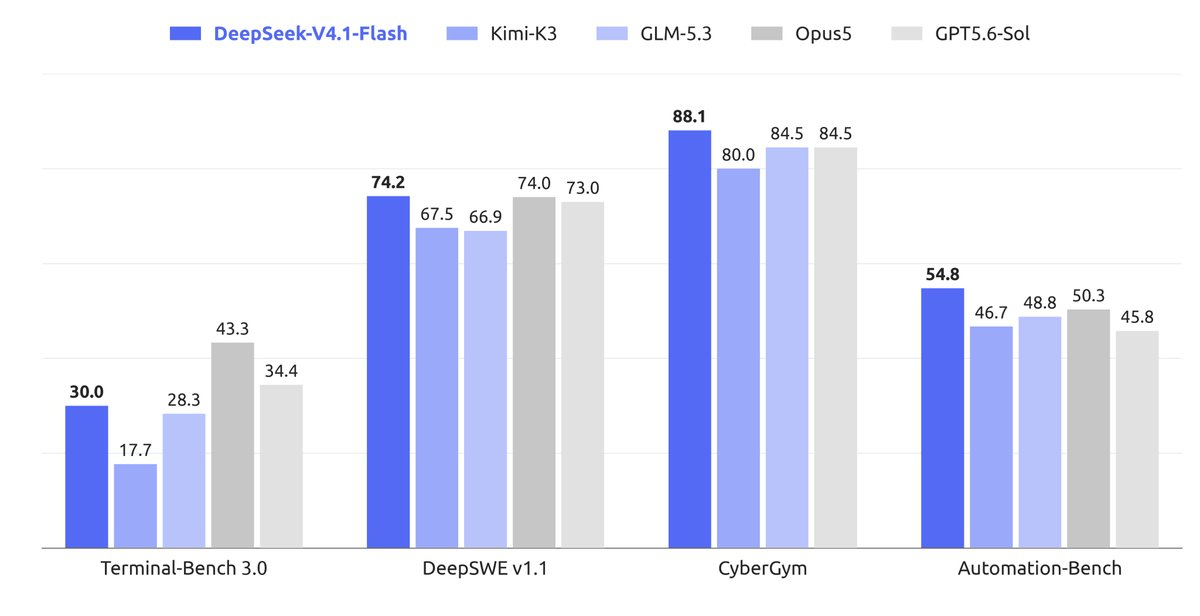
패턴은 일관적입니다: V4.1-Flash는 모든 지표에서 V4-Pro를 앞서며, 에이전트 코딩에서 가장 큰 격차를 보입니다. DeepSWE는 Pro보다 11.5포인트, 이전 Flash보다 거의 20포인트 상승했습니다. GSM8K는 포화 상태이므로 0.4포인트의 우위는 큰 의미가 없습니다.
비전 점수는 다시 공급업체 보고입니다: MMMU-Pro 56.5, CVBench 77.9, DocVQA 95.6, RefCOCO 86.0. 문서 구문 분석이 대부분의 실제 비전 트래픽이 발생하는 곳이므로, DocVQA 수치를 주목해야 합니다.
V4-Pro 재라우팅에 대한 DeepSeek의 설명은 V4.1-Flash가 "여러 당사자의 테스트를 인용하여 성능, 비용, 속도 및 총 시간 면에서 V4 Pro를 종합적으로 능가했다"는 것입니다. 해당 당사자들은 명시되어 있지 않습니다. 이 문장을 확인할 수 있는 주장으로 간주하세요.
가격 및 V4-Pro 재라우팅
아래 요금은 가격 페이지에서 가져온 것이며, 9월 10일 04:00 UTC부터 적용되며, 100만 토큰당 USD 기준입니다.
| deepseek-flash 비수기 | deepseek-flash 최고 요금 시간 | deepseek-v4-pro 비수기 | deepseek-v4-pro 최고 요금 시간 | |
|---|---|---|---|---|
| 입력, 캐시 적중 | $0.003 | $0.006 | $0.022 | $0.044 |
| 입력, 캐시 미스 | $0.15 | $0.30 | $0.66 | $1.32 |
| 출력 | $0.60 | $1.20 | $1.98 | $3.96 |
최고 요금 시간은 주중 01:00부터 04:00, 06:00부터 10:00 UTC입니다. 비수기 요금은 최고 요금의 50%입니다. 컨텍스트 캐싱은 자동이며, 캐시 적중은 캐시 미스보다 50배 저렴합니다.
V4-Flash의 8월 요금과 비교했을 때, V4.1-Flash는 캐시 적중 입력 비용을 약 57%, 캐시 미스 입력 비용을 약 32%, 출력을 약 9% 절감합니다.
V4-Pro 열을 주목해야 합니다. 9월 14일 이후 deepseek-v4-pro로 전송된 요청은 Flash 요금으로 청구됩니다. 최고 요금 시간 기준으로, 캐시 미스 입력 1M당 $1.32 대신 $0.30 (77% 절감), 출력 1M당 $3.96 대신 $1.20 (70% 절감)입니다. 코드를 변경하지 않아도 할인을 받을 수 있지만, 단종된 별칭에 의존하기보다는 모델 ID를 업데이트하는 것이 좋습니다. 마이그레이션 가이드는 체크리스트를 안내하며, 가격 심층 분석은 장기 에이전트 세션에 대한 캐시 적중 계산을 다룹니다.
Apidog에서 자체 프롬프트로 V4.1-Flash 평가하기
공급업체 표에는 모델이 DeepSWE에 뛰어나다고 명시되어 있습니다. 그러나 모델이 사용자의 추출 스키마, 도구 호출 형식 또는 30만 토큰 지원 스크립트를 처리하는지 여부는 언급되어 있지 않습니다. 다음은 Apidog에서 이러한 질문에 대한 답을 오후 내에 찾고, 모든 모델 자동 업데이트 후에도 계속 답을 제공하는 워크플로우입니다.
- 키를 환경 변수로 저장합니다. Apidog 환경을 생성하고 DeepSeek 플랫폼에서
DEEPSEEK_API_KEY를 추가합니다. Authorization 헤더에서Bearer {{DEEPSEEK_API_KEY}}로 참조합니다. - 엔드포인트를 추가합니다.
POST https://api.deepseek.com/chat/completions를 생성하거나 OpenAPI 사양을 가져옵니다. - 실제 프롬프트당 하나의 요청을 저장합니다. 프로덕션 로그에서 5~10개의 프롬프트를 가져와 각각
"model": "deepseek-flash"를 사용하여 별도의 요청으로 저장합니다. 9월 14일까지deepseek-v4-pro를 가리키는 사본을 유지하여 출력을 나란히 비교할 수 있도록 합니다. - 스트림 및 이벤트 관찰.
"stream": true로 설정합니다. Apidog는 SSE 응답을 이벤트별로 렌더링하므로, 추론 변경 사항과 답변 변경 사항이data:줄의 벽 대신 별도로 표시됩니다. 이는 긴 사전 채우기에서 첫 번째 토큰까지의 시간을 확인하는 가장 빠른 방법입니다. - 어설션을 추가하고 테스트 시나리오를 구축합니다. 상태 코드, 예상되는
tool_calls필드, 출력의 JSON 유효성에 대해 어설션을 추가합니다. 저장된 요청들을 테스트 시나리오로 연결합니다. - 모든 모델 업데이트 시 재실행. DeepSeek이
deepseek-flash뒤에 다음 변경 사항을 적용하면, 시나리오를 실행합니다.apidog-cli와 함께 CI에 연결하여 모든 배포 시 실행되도록 합니다.
OpenAI SDK를 사용하여 저장된 프롬프트 중 하나에 대한 본문은 다음과 같습니다.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "Extract the order ID, SKU list, and refund amount as JSON."},
        {"role": "user", "content": "Ticket #48213: customer wants a refund of $42.90 for SKUs KB-220 and MS-114 from order ORD-99117."},
    ],
    stream=True,
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
Apidog를 다운로드하여 해당 본문을 저장된 요청에 붙여넣으세요. Apidog는 모델 호스트가 아닌 API 계층을 테스트하므로, 사용자에게 표시되는 응답이 그대로 나타납니다.
자주 묻는 질문
- DeepSeek-V4.1-Flash가 V4-Pro를 대체하나요? 네, DeepSeek의 결정에 따라 그렇습니다. 9월 14일 04:00 UTC부터
deepseek-v4-pro요청은 Flash 가격으로 V4.1-Flash에 의해 처리됩니다. V4 API 라인업에는 더 이상 큰 모델이 남아있지 않습니다. - 모델 ID를 변경해야 하나요? 즉시 변경할 필요는 없습니다.
deepseek-v4-flash,deepseek-v4-flash-vision-exp, 그리고 (14일 이후)deepseek-v4-pro는 모두 V4.1-Flash로 해석됩니다. 통합 작업을 다시 할 때deepseek-flash로 전환하세요. API 가이드에는 전체 매개변수 참조가 있습니다. - 8B 사전 채우기(prefill) / 16B 디코드(decode)는 지연 시간에 어떤 의미인가요? 입력에 활성 매개변수가 적다는 것은 긴 프롬프트에서 첫 번째 토큰까지의 시간이 더 빠르다는 것을 의미합니다. 출력에 더 많은 매개변수를 사용한다는 것은 생성 품질이 결정되는 곳에 연산 자원이 투입된다는 것을 의미합니다. 토큰당 890바이트 KV 캐시는 긴 세션을 메모리에 저렴하게 유지합니다.
- 로컬에서 실행할 수 있나요? 가중치는 Hugging Face에서 MIT 라이선스로 제공됩니다. 언어 핵심(backbone)만 해도 8비트에서 약 552GB, 4비트에서 280GB이므로, 이는 노트북용 프로젝트가 아니라 멀티 GPU 또는 SSD 스트리밍 프로젝트입니다. 출시 초기 추론 엔진 지원은 [확인 필요]합니다.
- 벤치마크는 독립적인가요? 아니요. 위에 언급된 모든 점수는 DeepSeek의 모델 카드에서 나온 것입니다. 기술 보고서에 방법론이 있습니다.
V4 라인의 현재 위치
DeepSeek은 두 가지 모델 API를 하나로 통합했습니다. 이는 16B 디코드 예산, 4분의 1 크기 KV 캐시, 계정당 2,500개의 동시 세션을 갖춘 552B 모델이 3~4배 더 비싼 더 큰 모델보다 에이전트 워크로드를 더 잘 처리할 것이라는 예상입니다. 공급업체의 수치는 이 예상을 뒷받침하지만, 실제 적용 여부는 사용자의 워크로드에 따라 결정됩니다.
SDK를 deepseek-flash로 지정하고, 14일 이전에 자체 프롬프트를 통해 실행하며, 테스트 시나리오를 유지하세요. 원래 V4-Flash API를 기반으로 구축했다면, 통합은 이미 작동합니다. 변경된 것은 그 뒤에 있는 모델이며, 이 부분이 측정할 가치가 있습니다.