
Together AI, Fireworks AI, Groq는 모두 같은 제안을 내세웁니다. 기존 OpenAI 클라이언트의 base URL만 새 주소로 바꾸고 키만 교체하면, 훨씬 저렴한 비용으로 오픈 웨이트 모델을 쓸 수 있다는 것이죠. 이 제안은 사실입니다. 하지만 사실이 아닌 것은, 이들의 무료 티어를 비교하는 일이 세 개의 숫자를 나란히 놓는 것만큼 간단하다는 생각입니다. 세 제공자 중 두 곳은 고정된 숫자를 아예 공개하지 않기 때문입니다.
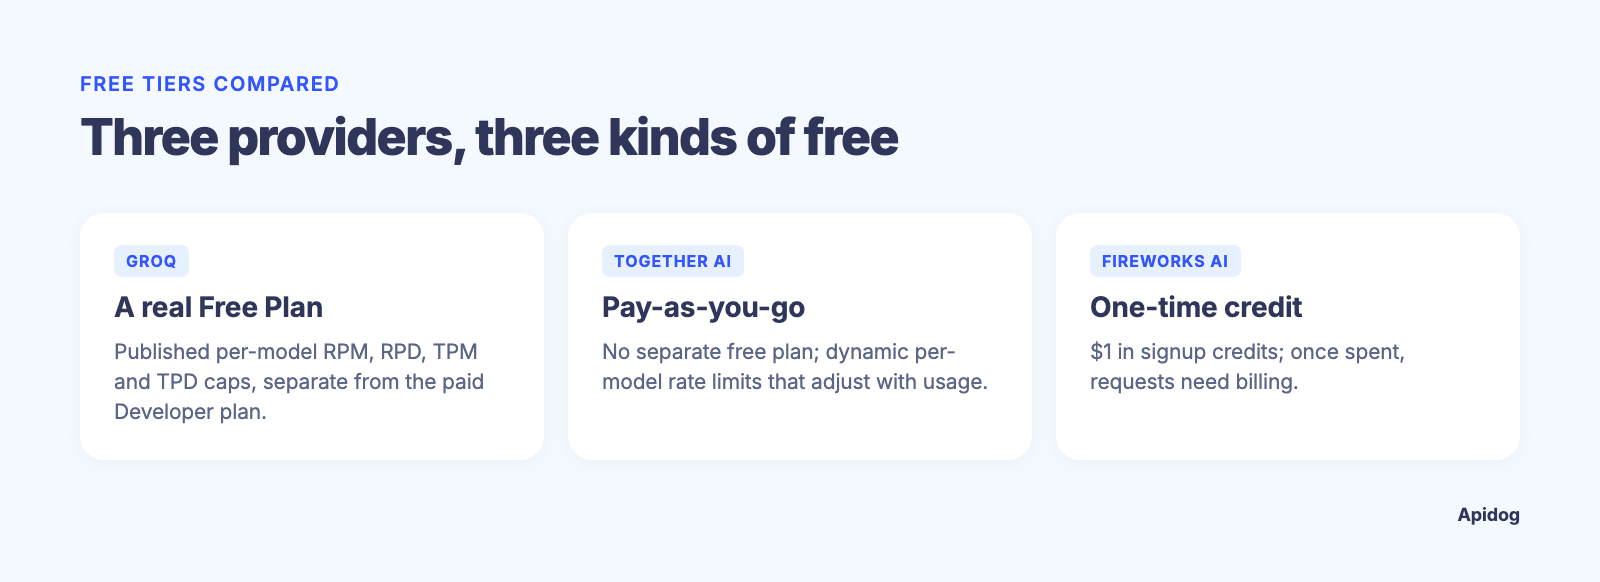
Groq은 예외입니다. 실제로 Groq의 rate-limits 페이지는 바로 옆의 Developer Plan 탭으로 넘어가느라 대부분의 독자가 그냥 지나치는 탭에, 모델별 Free Plan 실제 숫자를 공개해 두었습니다. Together AI는 자사 문서에서 고정된 모델별 한도를 공개할 게 없다고 분명히 밝혔습니다. 한도는 사용량에 따라 움직입니다. Fireworks AI는 무료 접근을 요금제 등급이 아니라 일회성 크레딧 잔액에 묶어 두었습니다. 세 가지 서로 다른 설계이고, "어느 무료 티어가 더 큰가"라는 글은 여전히 이걸 하나의 숫자로 정리할 수 없습니다.
TL;DR
Groq, Together AI, Fireworks AI는 모두 OpenAI 호환 엔드포인트를 제공하므로, 이들 사이를 전환하는 일은 코드 재작성이 아니라 base URL과 API 키를 바꾸는 일입니다. Groq은 접근 권한을 Free Plan과 유료 Developer Plan으로 나누며, 다른 두 곳과 달리 모델별 Free Plan 실제 숫자를 공개합니다. 예를 들어 gpt-oss-120b와 gpt-oss-20b에서 30 RPM / 1K RPD / 8K TPM / 200K TPD 같은 식입니다. Together AI는 고정된 무료 티어 숫자를 공개하지 않으며, 문서에 따르면 한도는 실시간 용량과 최근 성공한 사용량에 따라 동적으로 움직입니다. Fireworks AI는 반복되는 무료 할당량이 아니라 신규 계정에 일회성 크레딧 잔액(자사 가격 페이지 기준 $1)을 제공합니다. 헤드라인 숫자보다 더 중요한 판단 기준은 실제로 어떤 모델이 필요한지, 그리고 한도에 도달했을 때 각 제공자의 상한이 어떻게 작동하는지입니다. Apidog를 쓰면 요청 하나를 저장해 두고 환경별로 base URL과 키를 바꿔가며 쓸 수 있으므로, 표를 믿는 대신 세 곳 모두를 직접 측정할 수 있습니다.
하나의 API 형태, 세 개의 키
세 제공자 모두 의도적으로 OpenAI Chat Completions 스키마를 그대로 따릅니다. 그래서 이 도구들의 마이그레이션 가이드는 매번 똑같이 읽힙니다. base_url을 바꾸고, Authorization 헤더를 바꾸고, 나머지 코드는 그대로 두라는 것이죠. Groq의 OpenAI 호환 base는 https://api.groq.com/openai/v1/입니다. Together AI의 base는 https://api.together.ai/v1이며, 이는 퀵스타트 문서에서 직접 확인할 수 있습니다. Fireworks AI의 base는 https://api.fireworks.ai/inference/v1이며, 이는 자사의 OpenAI 호환성 가이드에 나와 있습니다.
이 공통된 형태 덕분에 일대일 비교 테스트를 할 가치가 있습니다. 네 번째, 다섯 번째 제공자를 끼워 넣는 데 드는 비용은 재설계가 아니라 몇 분이면 충분합니다. 이런 멀티 프로바이더 구성 관리의 작동 방식은 Apidog에서 환경별로 base URL을 관리하는 방법에서 다루며, 라우팅 옵션을 더 폭넓게 저울질하고 있다면 OpenRouter 대안 정리 글에서 이 세 곳이 그 그림 속 어디에 들어가는지 다룹니다.
각 무료 티어에 대해 실제로 검증할 수 있는 것
다음은 2026년 9월 기준으로 각 제공자가 공개적으로 밝힌 내용만으로 구성한 비교입니다. 제공자가 숫자를 공개하지 않은 경우에는 추측하지 않고 표에 그렇게 표시했습니다.
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| 무료 접근 모델 | Free Plan(유료 Developer Plan과 별도) | 가입 시점부터 종량제, 별도의 "무료 플랜" 명칭 없음 | 가입 시 일회성 크레딧 |
| 문서화된 무료 할당량 | 모델별 공개: gpt-oss-120b/gpt-oss-20b 30 RPM, 1K RPD, 8K TPM, 200K TPD; compound 30 RPM, 250 RPD, 70K TPM (Groq rate limits 기준, 2026-09-15 확인) |
고정 숫자로 공개되지 않음, 조직별 동적이라고 설명됨 | Fireworks 가격 기준 무료 크레딧 $1 |
| 한도가 정해지는 방식 | 모델별 RPM/RPD/TPM/TPD 상한, 조직 단위로 적용 | 모델별 동적 rate, 실시간 용량과 최근 성공 사용량에 따라 조정 | 지출 기반, 크레딧을 다 쓰면 요청하려면 결제 활성화 필요 |
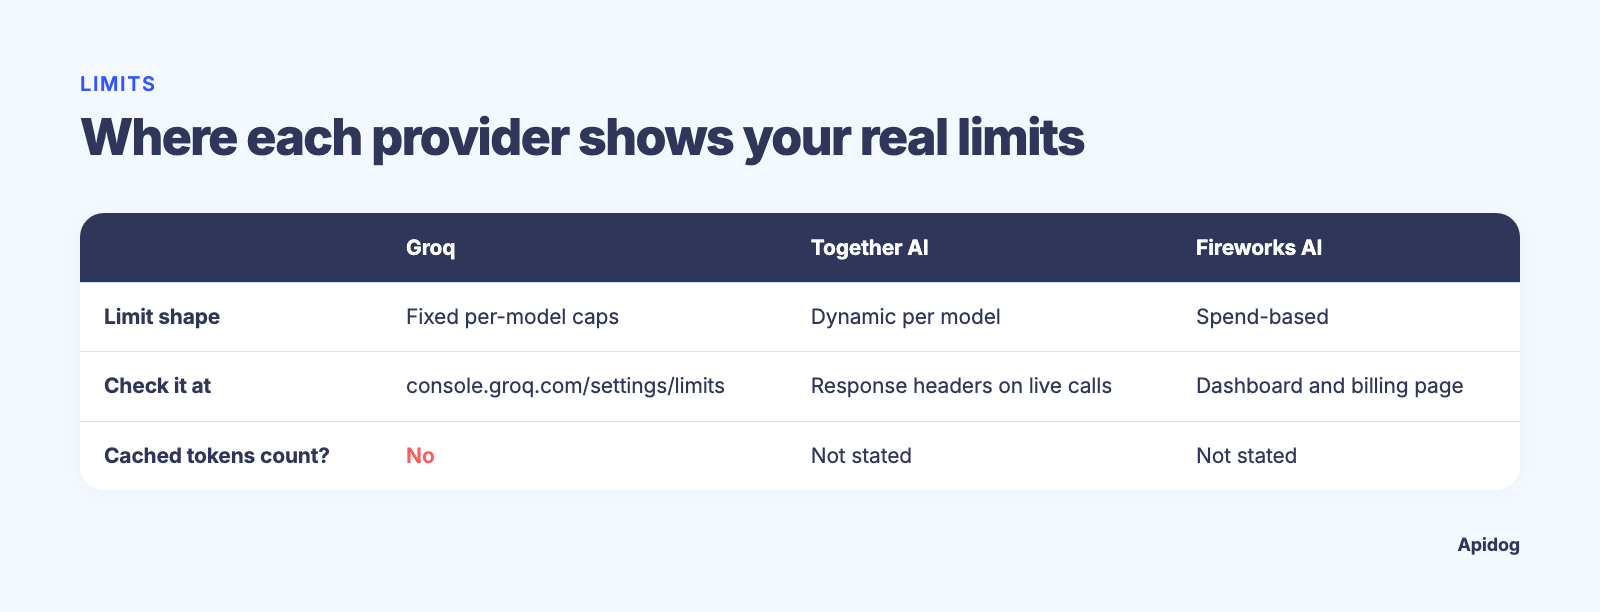
| 내 숫자를 확인할 곳 | console.groq.com/settings/limits |
실제 호출의 응답 헤더, 예: x-ratelimit-reset |
계정 대시보드와 결제 페이지 |
| 캐시된 토큰도 한도에 포함되나? | 아니오, Groq 자체 문서 기준 | 확인한 페이지에는 명시되지 않음 | 확인한 페이지에는 명시되지 않음 |
스펙 요약본이 아니라 실제 원문 페이지를 읽어보면 두 가지가 눈에 띕니다. 첫째, 위의 Groq Free Plan 숫자는 공개된 기본값입니다. 같은 페이지에는 상한이 더 높은 Developer Plan 탭도 있으며, 본인 숫자가 다르다면 console.groq.com/settings/limits가 기준입니다. 둘째, Together AI의 rate limiting은 표가 전혀 아닙니다. 자사의 rate-limits 페이지에는 "공개된 고정 모델별 한도는 없다"라고 분명히 적혀 있고, 상한은 "지속적이고 성공적인 트래픽"에 따라 올라간다고 합니다. 이는 정적인 무료 티어 행과는 의미 있게 다른 모델이며, "Together의 무료 RPM이 얼마냐"라는 질문에 대한 정직한 답은 표에서 뽑아낸 숫자가 아니라 "응답 헤더를 확인하세요"라는 것입니다.
제품 하나씩 확인 가능한 숫자와 함께 단일 제공자 심층 분석을 보고 싶다면, Groq API 무료 티어와 Cerebras API 무료 티어에 관한 자매 글을 참고하세요. 이 글은 허브 역할을 하고, 저 두 글은 제공자별 파고들기를 온전히 다룹니다.
요청 대 토큰, 고정 대 동적
이 세 곳의 진짜 설계 차이는 무료 할당량의 크기가 아니라 상한의 형태입니다.
Groq의 모델은 대부분의 개발자가 다른 곳에서 rate limit을 다루며 이미 익숙한 방식입니다. 시간 창별 고정 상한을 RPM, RPD, TPM, TPD로 나누어 적용하며, API 키별이 아니라 조직 단위로 적용됩니다. 즉 하나의 Groq 계정 아래 세 개의 서비스용으로 키를 세 개 만들어도 이들은 하나의 풀을 공유합니다. 토큰 기반 상한을 다뤄본 적이 없다면, GPT API rate limit에 관한 일반 가이드에서 같은 RPM/TPM 구조를 더 깊이 다룹니다.
Together AI의 모델은 버스트 트래픽을 단단한 벽으로 벌하기보다 꾸준하고 성공적인 트래픽에 보상합니다. 조용한 계정과 트래픽이 많고 잘 작동하는 계정은 같은 상한을 받지 않습니다. 상한이 계정 자체의 최근 이력과 그 시점의 모델 실시간 용량에 맞춰 조정되기 때문입니다. 워크로드가 안정적이라면 좋은 소식이고, 트래픽이 본질적으로 버스트성이 강하다면 진짜 미지수입니다.
Fireworks AI는 신규 사용자에게 있어 rate-limit 설계를 거의 완전히 우회합니다. 무료 기간을 요청 속도 창이 아니라 달러 잔액에 묶어 두기 때문입니다. API를 얼마나 빠르게 호출하는지로 상한이 정해지는 게 아니라, 잔액이 소진되기 전까지 호출 비용이 얼마인지로 상한이 정해집니다. 그러면 계획 질문이 "분당 몇 건의 요청인가"에서 "이 모델의 토큰당 가격으로 $1이면 토큰을 몇 개 살 수 있는가"로 바뀌며, 이는 전적으로 어떤 모델을 고르느냐에 달려 있습니다.
"무료" 티어가 무엇으로부터 사용자를 보호해야 하는지에 대한 서로 다른 베팅입니다. 지속적 볼륨인지, 버스트 스파이크인지, 총 지출인지 말이죠. 어느 쪽을 기준으로 개발하든 결국 429를 만나게 되고, 제공자가 그 순간을 어떻게 알리는지는 이를 유발한 숫자만큼이나 중요합니다. rate limit 초과 트러블슈팅 가이드에서 이런 응답 헤더를 읽는 방법과 문제를 악화시키지 않는 재시도 로직을 만드는 방법을 다룹니다.
5분 만에 직접 증명하기
이 데이터 대부분이 로그인 화면이나 실시간 응답 헤더 뒤에 있다는 점을 감안하면, 진짜 답을 얻는 가장 빠른 길은 또 한 편의 스펙 요약 글이 아니라 코딩 에이전트가 세 곳 모두에 대해 실행하는 테스트 하나입니다. Apidog CLI를 쓰면 프롬프트 하나면 됩니다. 한 번 설정하세요:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
토큰은 Apidog의 Account Settings, API Access Token 아래에서 발급받습니다. 그다음 에이전트에 프롬프트 하나를 주세요:
Use Apidog CLI on project <id>. Create Groq, Together and Fireworks environments
with the OpenAI-compatible base URLs from this article and a comparable model id
in a MODEL variable. Add POST /chat/completions with Bearer auth from {{API_KEY}}
and one test case with an identical prompt and max_tokens. Run it once per
environment with that provider's key, then compare status, latency and the
x-ratelimit headers.
Apidog CLI 2.2.7 기준으로 확인한, 실행되는 명령은 다음과 같습니다:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog environment create Together --project <id> --base-url https://api.together.ai/v1
apidog environment create Fireworks --project <id> --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project <id> --file chat-case.json
apidog run --test-case <caseId> --project <id> -e <togetherEnvId> \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
이제 제공자 전환은 재작성이 아니라 환경 ID를 바꾸는 일이 됩니다. Together AI의 동적 상한이 실시간으로 드러나는 곳이 바로 헤더이며, 여기서 본인의 Groq 조직이 공개된 Free Plan 표와 일치하는지 확인할 수 있습니다. 비교에 지연 시간도 넣어 두세요. 기술적으로 무료지만 느린 모델은 그 모델을 우회하느라 쓴 시간을 계산하면 실제로 더 저렴하지 않습니다. 이렇게 하면 마케팅 페이지 세 개가 본인 계정에서 나온 하나의 비교 가능한 데이터셋으로 바뀝니다. 더 큰 에이전트 빌드 안에서 이 비교를 지속적으로 돌리고 싶다면 AI 에이전트용 API 테스트 도구 가이드에서 다루고, Cursor에서의 Apidog CLI에서 에이전트 설정을 보여줍니다.
어느 무료 티어가 사용 사례에 맞는가
오늘 검증 가능한 내용만을 바탕으로 한 몇 가지 솔직한 권장 사항입니다:
- 로그인 없이 읽을 수 있는 예측 가능한 모델별 상한: Groq는 실제 Free Plan 숫자를 공개합니다(
gpt-oss모델에서 30 RPM / 1K RPD / 8K TPM / 200K TPD). 또한llama-3.1-8b-instant,llama-3.3-70b-versatile,openai/gpt-oss모델 전반의 131,072 토큰 컨텍스트 윈도우는 하나의 엔드포인트로 폭넓은 오픈 웨이트 워크로드를 커버합니다. - 꾸준하고 안정적인 트래픽, rate limit 추적에 관심 없음: Together AI의 동적 모델이 그 패턴에 맞습니다. 지속적으로 성공적인 사용량이 있으면 첫날 정해진 숫자에 묶이지 않고 시간이 지나며 본인의 상한이 올라갑니다.
- 설정 마찰 제로, 지출 한도에 부딪히는 게 부담 없음: Fireworks AI의 크레딧 기반 무료 접근은 첫 호출부터 실제 토큰당 가격을 테스트하게 해줍니다. 실제 질문이 요청 수가 아니라 규모에서의 비용일 때 유용합니다.
세 곳 모두 서로 다른 오픈 웨이트 모델 부분집합을 호스팅하며, 한 제공자에서 작업에 맞는 모델이 다른 곳에는 없을 수도 있습니다.
FAQ
Together AI, Fireworks AI, Groq 모두 OpenAI SDK를 쓰나요? 네. 세 곳 모두 OpenAI 호환 엔드포인트를 문서화하고 있어, base URL과 키만 바꾸면 표준 openai 클라이언트 라이브러리가 어디든 작동합니다.
어느 제공자의 무료 티어가 가장 큰가요? 직접 비교할 수 있는 방식으로는 아닙니다. Groq는 모델별 실제 Free Plan 숫자를 공개하고(gpt-oss-120b/gpt-oss-20b에서 30 RPM / 1K RPD / 8K TPM / 200K TPD), Together AI는 고정 숫자를 아예 정하지 않으며, Fireworks AI는 무료 접근을 할당량이 아니라 일회성 크레딧 잔액에 묶어 둡니다. 본인 숫자가 다르면 console.groq.com/settings/limits를 확인하세요.
rate limit은 API 키별로 적용되나요, 계정별로 적용되나요? Groq의 경우 한도는 조직 단위로 적용되므로, 하나의 계정 아래 여러 키가 같은 풀을 공유합니다(자사 rate-limits 문서 기준). Together AI와 Fireworks AI는 확인한 페이지에 이를 명시하지 않았습니다. 다르게 가정하기 전에 본인 대시보드에서 확인하세요.
이 제공자 중 하나에서 rate limit에 걸리면 어떻게 되나요? HTTP 429 응답을 받게 됩니다. 세부 사항은 다르니, 대부분의 OpenAI 호환 API가 반환하는 재시도 헤더를 읽는 방법과 추측 대신 백오프 로직을 만드는 방법은 rate limit 초과 가이드를 참고하세요.
모든 문서 페이지를 직접 읽는 것보다 이들을 비교하는 더 빠른 방법이 있나요? 위에서 설명한 대로 코딩 에이전트가 세 환경에 대해 Apidog CLI 테스트 케이스 하나를 실행하게 하세요. Apidog CLI로 보내는 20분이, 이 글을 포함한 어떤 비교 표보다 본인의 실제 워크로드에 대해 더 많은 것을 알려줄 것입니다.