
Claude Fable 5.2 API 통합을 테스트하려면 인증, Messages 요청 본문, 타입이 지정된 응답 블록, 그리고 예측 가능한 실패 사례를 검증해야 합니다. 그런 다음 이러한 검증 항목들을 코딩 에이전트가 CLI를 통해 실행할 수 있는 재사용 가능한 Apidog 테스트 케이스로 저장하세요. 전송 계층 검증과 작업 품질 검증을 분리해 두면, HTTP 응답이 성공하더라도 실제로는 쓸모없는 답변인 경우를 놓치는 일을 방지할 수 있습니다.
Anthropic의 공식 발표에 따르면 claude-fable-5-2가 Claude Platform의 모델 ID입니다. 이 가이드는 성공 응답 한 번으로 끝내는 것이 아니라, 해당 모델을 중심으로 회귀 테스트 워크플로를 구축하는 방법을 다룹니다. Apidog를 사용하면 에이전트가 엔드포인트, 테스트 케이스, 실행 리포트를 공동으로 관리할 수 있습니다.
Claude Fable 5.2 API 테스트는 무엇을 다뤄야 할까?
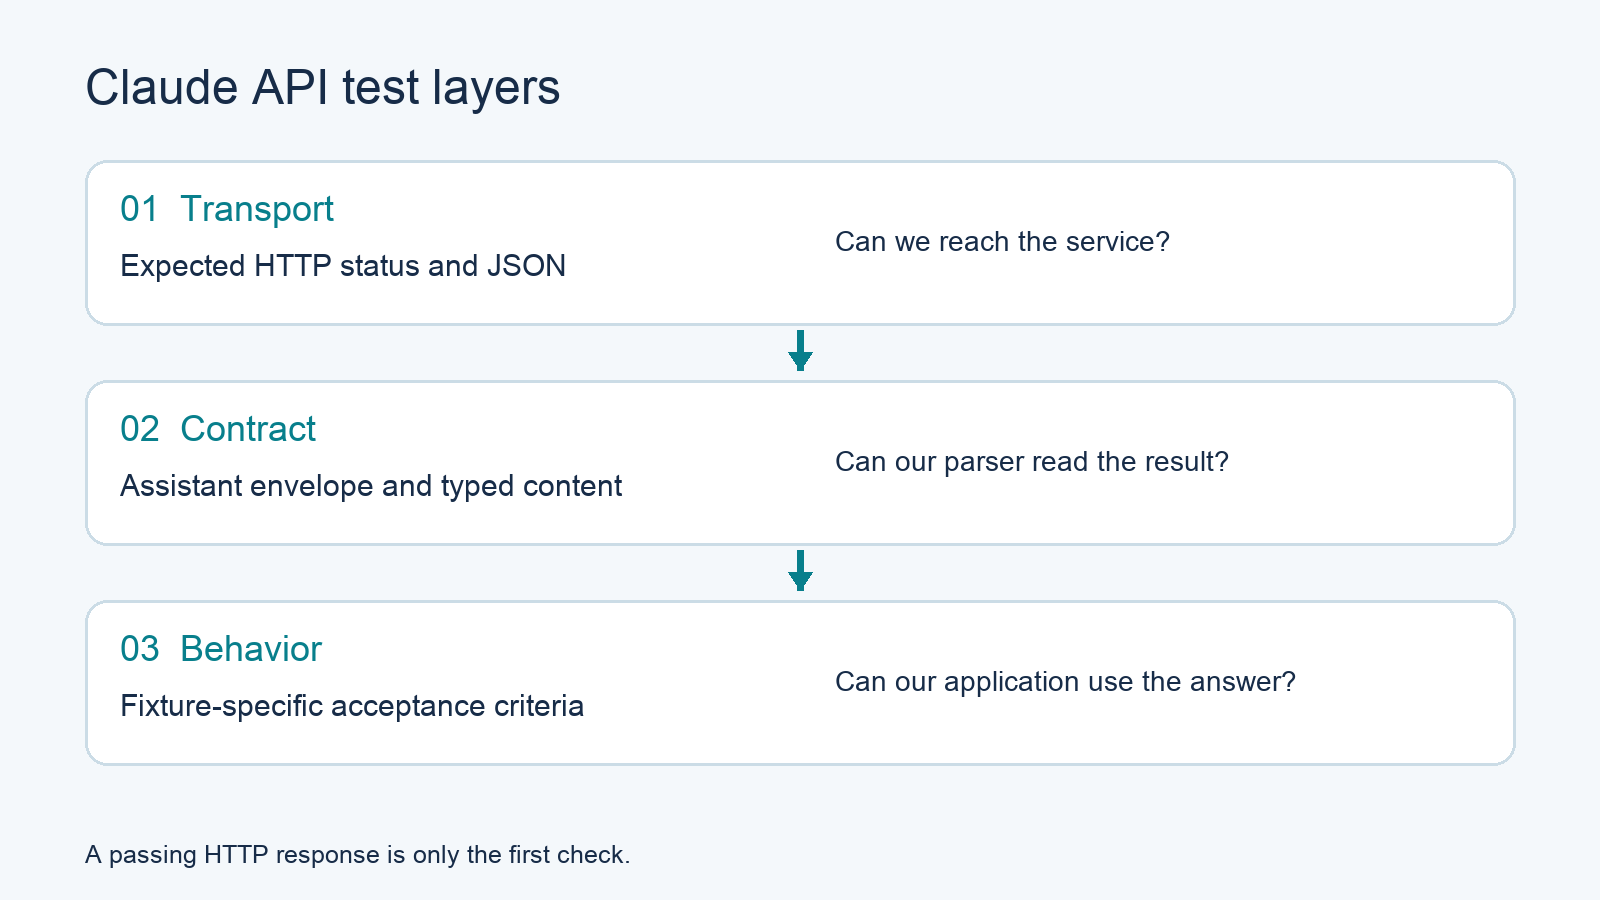
세 가지 계층으로 테스트를 구성하세요. 전송 검증은 요청이 서비스에 도달했는지 확인하고, 계약(Contract) 검증은 응답 구조가 올바른지 확인하며, 동작(Behavior) 검증은 애플리케이션이 그 결과를 실제로 사용할 수 있는지 확인합니다. 처음 두 계층은 모든 픽스처(fixture)에 대해 실행하세요. 동작 검증의 합격 기준은 작업별로 정의하고, 생성된 답변 전체를 바이트 단위로 비교하는 방식은 피하세요.
| 계층 | 검증 예시 | 실패의 의미 |
|---|---|---|
| 전송(Transport) | 기대한 상태 코드와 JSON 응답 | 자격 증명, 네트워크 또는 서비스 문제 |
| 계약(Contract) | 타입이 지정된 콘텐츠 블록을 포함한 어시스턴트 메시지 | 파서 또는 API 계약 불일치 |
| 동작(Behavior) | 추출된 텍스트에서 올바른 산술 결과 확인 | 출력이 해당 픽스처의 요구사항을 충족하지 못함 |
작고 무해한 픽스처로 시작하세요. "2 + 2는 무엇인가요? 숫자만으로 답하세요." 이 픽스처는 파일, 도구, 대화 기록을 도입하지 않고도 합격 기준을 명확히 보여줍니다. 기본 계약이 정상 동작하는 것을 확인한 뒤, 실제 애플리케이션을 대표하는 픽스처를 추가하세요.
이 픽스처를 추론 능력 벤치마크로 취급하지 마세요. 목적은 통합 회귀 문제를 잡아내는 것입니다. 예를 들어 thinking 블록을 사용자에게 보이는 텍스트로 추출해 버린다거나, 잘린 응답을 그대로 받아들이는 경우 등을 잡아낼 수 있습니다.
테스트 전에 인증과 요청 설정을 고정하기
Claude API를 직접 호출할 때는 Messages 엔드포인트, 워크스페이스 범위의 API 자격 증명, 명시적인 API 버전, 고정된 요청 본문을 사용하세요. 실행 간에 이 입력값들이 변하지 않도록 유지해야 합니다. API 개요 문서는 Bearer 인증, 워크스페이스 선택, 버전 헤더를 설명합니다. 이 설정들은 클라우드 프로바이더의 IAM 인증 방식과 다릅니다.
Claude Console API 키는 로컬 시크릿 환경을 통해 전달하세요. Apidog 액세스 토큰은 CLI가 Apidog에 인증하는 용도이며, Anthropic에 대한 요청 인증에는 사용되지 않습니다. 두 자격 증명을 분리해서 관리하세요.
다음 요청은 2026년 11월 10일 기준으로 확인한 최신 Messages 문서를 따릅니다. JSON을 request.json으로 저장하세요:
{
  "model": "claude-fable-5-2",
  "max_tokens": 1024,
  "stream": false,
  "thinking": { "type": "adaptive" },
  "messages": [
    {
      "role": "user",
      "content": "What is 2 + 2? Reply with the numeral only."
    }
  ]
}
터미널에서 직접 전송하거나, 코딩 에이전트에게 실행을 맡기세요:
curl https://api.anthropic.com/v1/messages \
  -H "Authorization: Bearer $ANTHROPIC_API_KEY" \
  -H 'anthropic-version: 2026-10-21' \
  -H 'Content-Type: application/json' \
  --max-time 600 \
  --dump-header response.headers \
  --output response.json \
  --write-out '%{http_code}\n' \
  --data-binary @request.json
API 키가 워크스페이스 범위가 아니라면, 대상 워크스페이스에 맞는 anthropic-workspace-id 헤더를 문서에 따라 포함하세요. 실제 자격 증명을 픽스처나 생성된 리포트에 그대로 넣는 일은 절대 없어야 합니다.
메시지 생성(Create a Message) 레퍼런스는 model, messages, max_tokens와 함께 반환되는 메시지 필드들을 정의합니다. 여기서 1,024는 선택한 출력 예산일 뿐이며, 문서에 명시된 최솟값도 아니고 모든 작업에 충분하다는 보장도 아닙니다. 픽스처에 더 많은 공간이 필요하면 의도적으로 값을 올리세요.
이 템플릿은 문서 기반으로 검증된 것입니다. 합격 기준선(baseline)을 기록하기 전에 반드시 여러분의 승인된 API 계정으로 직접 실행해 보세요. 여기서는 실제 Fable 응답이나 지연 시간 측정 결과를 주장하지 않습니다.
생성 결과의 변화를 견딜 수 있는 응답 검증 추가하기
응답 봉투(envelope)를 검증하고, 블록 타입을 확인한 뒤, 텍스트를 추출하고, 그다음 픽스처의 합격 기준을 적용하세요. Messages 응답에는 content 배열이 들어 있으므로 content[0].text에 답이 있다고 가정해서는 안 됩니다. 애플리케이션이 이후 대화 턴에서 원본 메시지를 다시 전송해야 한다면, 전체 원본 메시지는 별도로 보존하세요.
산술 픽스처의 경우, 에이전트에게 다음 응답 후 스크립트를 Apidog 테스트 케이스에 붙이도록 요청하세요:
pm.test("HTTP success", function () {
  pm.response.to.have.status(200);
});

const body = pm.response.json();

pm.test("Assistant message contract", function () {
  pm.expect(body.type).to.eql("message");
  pm.expect(body.role).to.eql("assistant");
  pm.expect(body.id).to.be.a("string");
  pm.expect(body.model).to.be.a("string");
  pm.expect(body.content).to.be.an("array");
});

const text = body.content
  .filter(block => block.type === "text")
  .map(block => block.text)
  .join("\n").trim();

pm.test("Arithmetic fixture is complete", function () {
  pm.expect(body.stop_reason).to.eql("end_turn");
  pm.expect(text).to.eql("4");
});
이처럼 의도적으로 제약된 숫자 픽스처에는 정확한 일치(Exact equality)가 적절합니다. 요약 작업이라면 필수 사실 포함 여부, 근거 없는 주장 금지, 길이 범위 같은 기준을 사용하세요. 무해한 표현 변화 때문에 유용한 요약 테스트가 실패해서는 안 됩니다.
진단을 위해 usage와 응답의 request-id 헤더를 기록하세요. 반환된 모델 식별자가 선택한 식별자에 대한 문서화된 동작과 일치하는지 확인하고, 폴백(fallback) 응답을 몰래 Fable 결과로 표기하지 마세요.
max_tokens 정지 사유는 답변이 출력 한도에 도달했다는 뜻입니다. 이 경우 산술 픽스처를 실패로 처리하고 토큰 예산을 점검하세요. 다른 작업은 도구 호출 요청 등 정당한 이유로 다른 정지 사유를 반환할 수 있으므로, 각 케이스마다 고유한 완료 판정 기준을 두세요.
Claude Fable 5.2 API 부정(negative) 케이스 테스트하기
잘못된 입력마다 별도의 케이스를 만들고, 한 번에 한 필드씩만 변경하세요. 사람이 읽는 전체 에러 메시지를 비교하지 말고, HTTP 상태 코드와 구조화된 에러 타입을 확인하세요. 유효한 기준선은 그대로 유지해서 부정 픽스처가 다음 정상 케이스 실행을 오염시키지 않도록 하세요.
공식 에러 가이드는 다음과 같은 유용한 케이스들을 문서화하고 있습니다:
| 케이스 | 기준선에서의 변경 | 기대 결과 |
|---|---|---|
| 잘못된 인증 | Bearer 자격 증명을 더미 값으로 교체 | 401, authentication_error |
| thinking 비활성화 | thinking.type을 disabled로 설정 |
400, invalid_request_error |
| 레거시 확장 thinking | thinking.type을 enabled로 설정 |
400, invalid_request_error |
| 어시스턴트 프리필(prefill) | 대화를 어시스턴트 프리필로 끝맺음 | 400, invalid_request_error |
Fable 5.2는 항상 켜져 있는(always-on) thinking을 사용합니다. 이를 비활성화하거나 확장 thinking 예산을 설정하는 오래된 Claude 튜토리얼을 그대로 따라 하지 마세요. thinking 비활성화 케이스는 공유 요청 빌딩 코드를 업그레이드할 때 특히 유용합니다.
각 에러 케이스에서 body.type === "error", 기대한 body.error.type, 그리고 비어 있지 않은 에러 메시지를 검증하세요. 가능하면 요청 ID를 보존하세요. DNS 실패와 클라이언트 타임아웃은 별도의 결과로 다뤄야 합니다. 이런 경우 Claude의 JSON 에러가 아예 반환되지 않을 수 있기 때문입니다.
애플리케이션의 레이트 리밋 및 서비스 장애 처리는 제어된 픽스처나 모크(mock)로 테스트하세요. 429를 일부러 만들려고 실제 API에 요청을 몰아서 보내지 마세요. 재시도 가능한 용량 문제와 인증·검증 실패를 구분하고, 애플리케이션의 재시도 로직에는 유한한 재시도 예산을 설정하세요.
코딩 에이전트에게 Apidog 회귀 테스트 케이스 구축 맡기기
에이전트에게 엔드포인트, 픽스처, 검증 로직, 대상 프로젝트를 제공하세요. 에이전트는 최신 CLI 스키마를 파악하고, 각 페이로드를 검증하며, 테스트 케이스를 생성하고 실행할 수 있습니다. 여러분은 생성된 케이스와 실패 요약을 검토하면 됩니다. 이렇게 하면 재사용 가능한 워크플로가 Apidog CLI 안에 유지됩니다.
CLI를 설치하고 Apidog 토큰으로 인증하세요:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
에이전트 설정 방법은 Claude Code 또는 Codex의 최신 가이드를 참고하세요. 그다음 에이전트에게 다음 프롬프트 하나를 주세요:
In Apidog project <PROJECT_ID>, define POST /v1/messages for the
Claude API. Use model claude-fable-5-2 and version 2026-10-21.
Keep the Anthropic credential in a private runtime variable.
Create the arithmetic success case and four negative cases above.
Read CLI help and input schemas before generating payloads.
Discover valid endpoint and category IDs; validate every payload.
Attach the response assertions, then run each case against
<ENVIRONMENT_ID>. Report failures, request IDs, and token usage.
Do not print credentials or claim unexecuted cases passed.
아래 명령들은 설치된 CLI 2.2.12 기준으로 확인되었습니다. 에이전트에게는 실제 엔드포인트 ID와 카테고리 ID가 필요합니다. test-case-create는 엔드포인트에 기반한 케이스를 다루므로, 무관한 독립 JSON 요청을 생성하는 것만으로는 부족합니다.
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
엔드포인트가 존재하지 않으면 에이전트에게 엔드포인트 명령어의 도움말과 스키마를 확인하도록 하세요. 다른 프로젝트에서 복사한 예시용 숫자가 아니라 반환된 실제 ID를 사용하세요. case.json을 작성하기 전에 검증하고, 생성된 케이스를 다시 읽어 의도한 헤더, 본문, 검증 로직이 제대로 저장되었는지 확인하세요.
CI에서 Claude API 회귀 테스트 실행하기
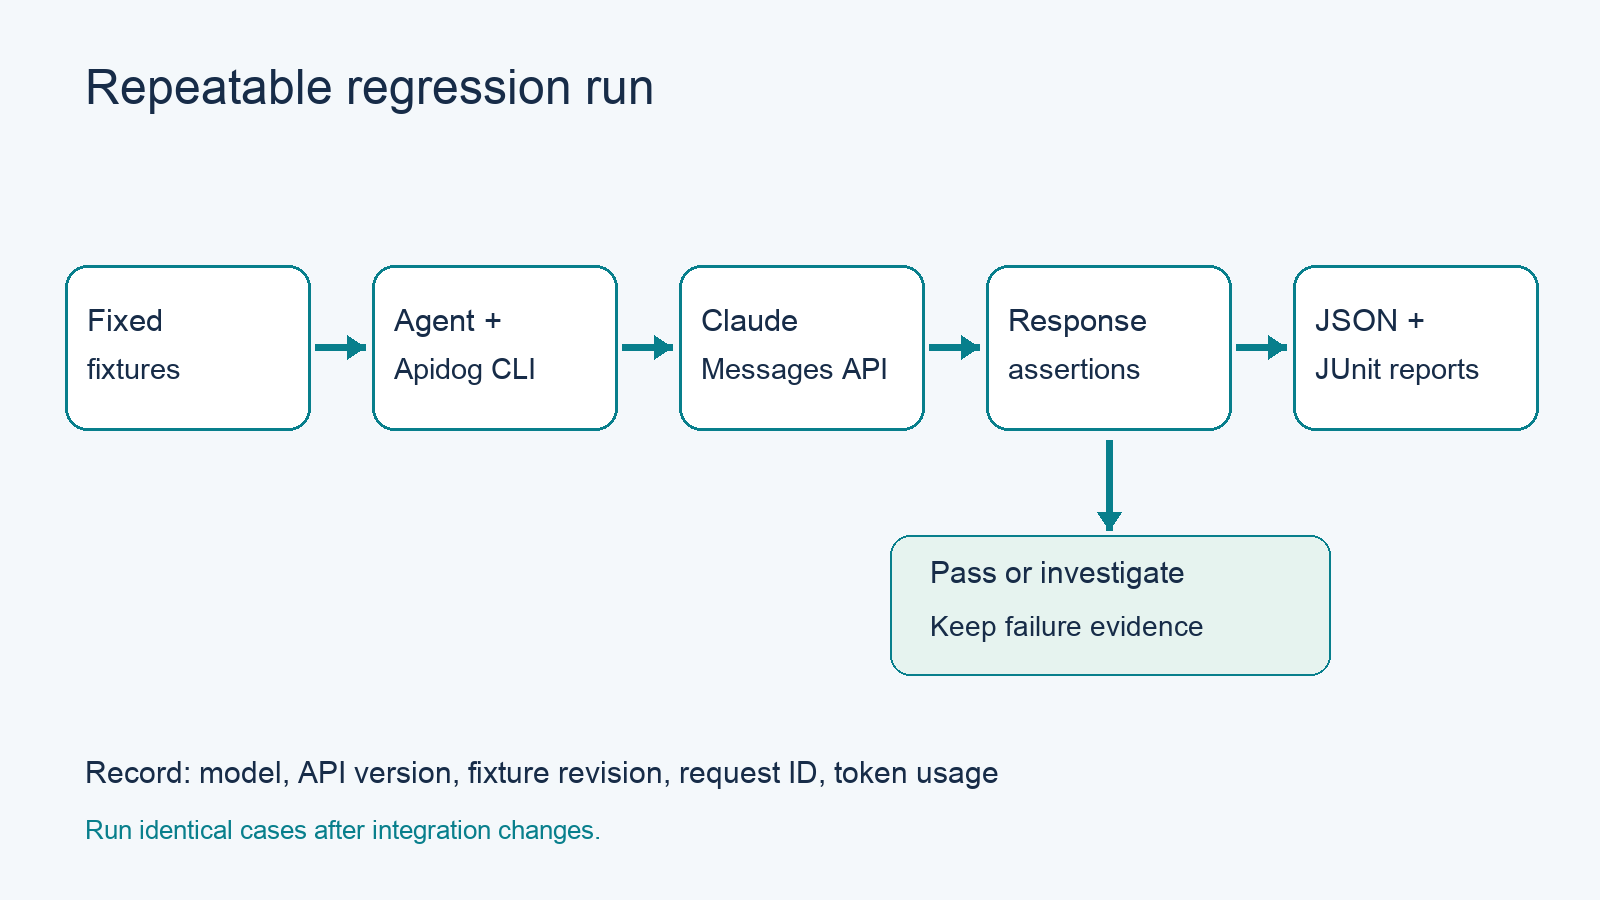
인증, 메시지 직렬화, 블록 파싱, 재시도 처리 등에 변경이 있을 때마다 동일한 케이스를 실행하세요. 기계가 읽을 수 있는 리포트를 내보내고, 픽스처 버전을 애플리케이션 변경 사항과 함께 관리하세요. 비교를 시작하기 전에 먼저 합격 기준선을 확립하고, 실패가 발생하면 빌드가 우연히 통과될 때까지 재실행하는 대신 각 실패를 개별적으로 조사하세요.
Apidog에 이미 생성된 케이스를 CI에서 실행하려면 다음과 같이 호출하세요:
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json,junit \
  --out-dir ./apidog-reports
나머지 케이스 ID에도 같은 작업을 반복하거나, 에이전트에게 최신 스위트(suite) 스키마를 사용해 케이스들을 테스트 스위트로 정리하도록 하세요. 파이프라인 통합 방법은 Apidog CI/CD 가이드에서 다룹니다.
실행 기록에는 모델, API 버전, 요청 본문, 출력 예산, 픽스처 리비전, CLI 버전을 함께 남기세요. 자격 증명은 CI 시크릿 메커니즘을 통해 관리하세요. 리포트를 공유하기 전에 민감한 요청 데이터가 포함되어 있지 않은지 검토하세요.
일상적인 변경에는 작은 라이브 스모크(smoke) 테스트 세트를, 릴리스 전에는 더 포괄적인 동작 테스트 세트를 사용하세요. 지출과 실행 시간 예산은 직접 설정하세요. API 계약 테스트 통과는 통합 호환성을 확인해 줄 뿐이며, 출력이 실제로 유용한지는 애플리케이션 고유의 수용 기준 테스트가 판단해야 합니다.
FAQ
어떤 모델 ID로 테스트해야 하나요?
이 직접 Claude Platform 워크플로에는 claude-fable-5-2를 사용하세요. 기준선을 저장하기 전에 내 계정에서 해당 모델을 사용할 수 있는지 확인하세요.
HTTP 200이면 통과하기에 충분한가요?
아니요. 메시지 봉투, 타입이 지정된 콘텐츠, 완료 사유, 픽스처 수용 기준을 모두 확인해야 합니다. 스트리밍의 경우 응답 헤더 수신 후에도 실패가 발생할 수 있으므로 이벤트 단위의 추가 검증이 필요합니다.
Fable 5.2의 thinking을 비활성화할 수 있나요?
아니요. Anthropic은 이 모델에 대해 항상 켜져 있는 thinking을 문서화하고 있습니다. thinking 비활성화는 검증 에러를 기대하는 부정 케이스로 유지하세요.
모든 답변이 정확히 일치해야 하나요?
숫자 예시처럼 제약된 픽스처에는 정확한 일치를 사용하세요. 개방형 작업에는 유효한 표현 변화를 허용하는 사실적·구조적 기준을 정의하세요.
수정 후 에이전트가 테스트를 다시 실행할 수 있나요?
네. 저장된 케이스 ID와 환경을 에이전트에게 제공하면, 동일한 CLI 명령을 실행하고 리포트를 요약할 수 있습니다. 에이전트 설정이 필요하면 Claude Code CLI 워크플로부터 시작하세요.