
Qwen 3.8 27B를 로컬에서 실행하려면 Ollama를 설치하고 ollama pull qwen3.8:27b를 실행한 뒤, ollama run qwen3.8:27b를 입력하면 됩니다. 기본 빌드는 18 GB 크기의 4비트 다운로드이므로, VRAM이 24 GB 이상인 GPU 또는 통합 메모리가 32 GB인 Mac이 필요합니다. 가중치는 Apache-2.0 라이선스로 공개되어 있어 모델 자체는 무료입니다. 비용은 오직 하드웨어와 전기 요금뿐입니다.
위가 요약본입니다. 이 가이드의 나머지 부분에서는 사용할 가치가 있는 4가지 실행 환경(Ollama, LM Studio, llama.cpp, MLX), 양자화(quant)별 요구 메모리, 실제 하드웨어에서 기대할 수 있는 속도, 그리고 로컬 엔드포인트가 구동된 후 코딩 에이전트로 Apidog CLI를 사용해 테스트하는 방법을 다룹니다.
이 계열이 처음이라면? Qwen 3.8이란? 글에서 2.4조 파라미터 규모의 Max 플래그십을 소개합니다. 이 가이드는 그보다 작고 책상 위에 올려둘 수 있는 밀집(dense) 형제 모델에 관한 내용입니다.
Qwen 3.8 27B란?
Qwen 3.8 27B는 Alibaba의 Qwen 팀이 2026년 8월 Apache-2.0 라이선스로 공개한, 270억 파라미터 규모의 밀집(dense) 비전-언어 모델입니다. 텍스트, 이미지, 비디오를 처리하며, 기본적으로 답변 전에 추론(thinking) 과정을 거치고, 네이티브 컨텍스트 윈도우는 262,144토큰이며 YaRN 스케일링을 통해 최대 100만 토큰까지 확장할 수 있습니다.
공식 모델 카드에는 다음과 같은 스펙이 나와 있습니다:
| 스펙 | Qwen 3.8 27B |
|---|---|
| 파라미터 | 27B dense (Hub에는 비전 인코더를 포함해 28B로 표기) |
| 레이어 | 64개, Gated DeltaNet과 Gated Attention 블록의 하이브리드 |
| 컨텍스트 | 262,144 네이티브, YaRN 사용 시 최대 1,000,000 |
| 입력 | 텍스트, 이미지, 비디오 |
| 추론(Thinking) | 기본 활성화, reasoning_effort는 xhigh, medium, low |
| 기타 | 멀티 토큰 예측(MTP) 레이어 |
| 라이선스 | Apache-2.0 |
Qwen 자체 벤치마크 표에서는 SWE-bench Pro에서 61.7, Terminal Bench 2.1에서 73.0, GPQA Diamond에서 89.2를 기록했습니다. 다만 이는 벤더가 발표한 수치입니다. 저희 Qwen 3.8 벤치마크 분석 글에서는 Qwen이 자체적으로 구축한 항목이 어떤 것인지 포함해, 그 표를 읽는 방법을 설명합니다.
로컬에서 주목할 점: 27B 밀집 모델은 4비트 양자화 시 소비자용 GPU 한 장에 들어가며, 툴 호출, 비전, 추론 기능이 모두 하나의 파일에 담겨 있습니다.
Qwen 3.8 27B에 필요한 RAM과 VRAM은 얼마인가?
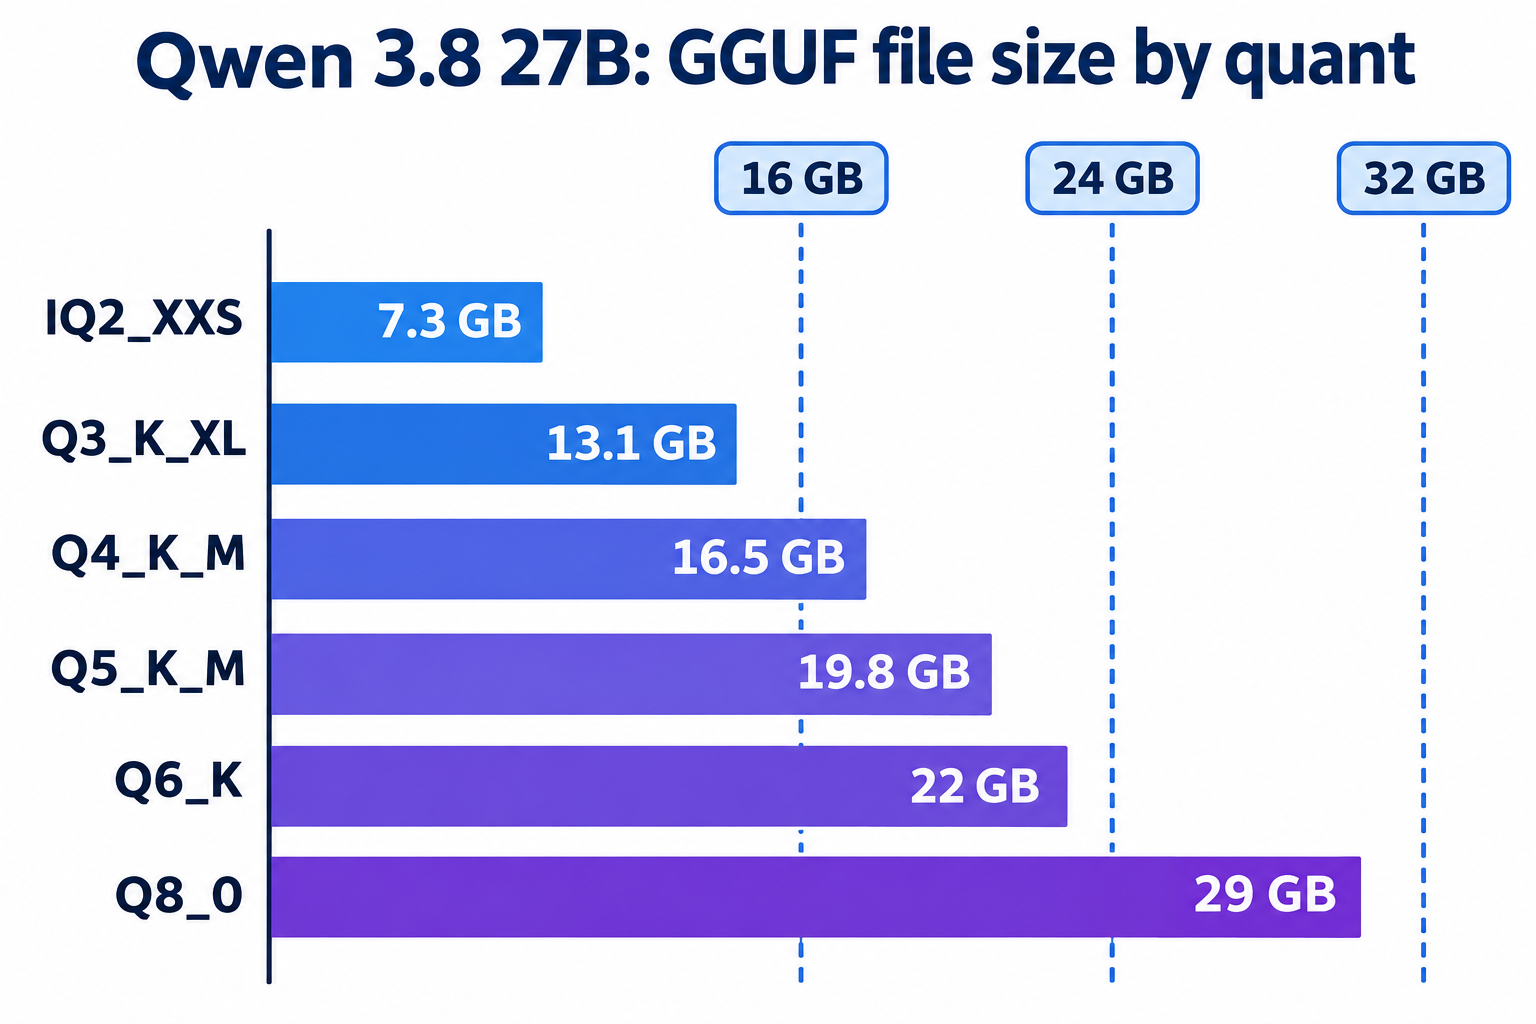
사용하려는 양자화 파일 크기에 KV 캐시와 런타임용 3~6 GB를 더한 값으로 계획하세요. 기본값인 Q4_K_M의 경우 GPU 기준 VRAM 24 GB 또는 32 GB Mac이 필요합니다.
다음은 2026년 11월 9일 기준으로 unsloth의 양자화 저장소에서 확인한 GGUF 파일 크기입니다:
| 양자화 | 파일 크기 | 현실적인 하드웨어 |
|---|---|---|
| UD-IQ2_XXS | 7.27 GB | 16 GB Mac 또는 12 GB GPU, 품질 저하가 뚜렷함 |
| UD-Q3_K_XL | 13.1 GB | 16 GB GPU, 24 GB Mac |
| UD-Q4_K_M | 16.5 GB | 24 GB GPU, 32 GB Mac (가장 적절한 지점) |
| UD-Q5_K_M | 19.8 GB | 짧은 컨텍스트를 사용하는 24 GB GPU, 32 GB Mac |
| UD-Q6_K | 22 GB | 32 GB GPU, 48 GB Mac |
| Q8_0 | 29 GB | 48 GB GPU, 64 GB Mac |
이미지 입력을 원한다면 비전 프로젝터(mmproj-F16.gguf)가 928 MB를 추가합니다. Ollama의 기본 qwen3.8:27b 태그는 비전 기능이 포함되어 있어 18 GB입니다.
컨텍스트 길이는 숨은 비용입니다. llm-speed의 계산에 따르면 Q4_K_M은 32,000토큰 컨텍스트 기준 약 21.9 GB가 필요합니다. 그래서 24 GB 카드가 Q4의 실질적인 최소 요구 사양이며, 메모리에 여유가 없다면 262K 전체 윈도우를 로드하지 않는 것이 좋습니다.
Mac의 경우 macOS가 통합 메모리의 일부를 시스템 용도로 남겨둔다는 점을 기억하세요. 24 GB Mac은 기술적으로 Q4_K_M을 로드할 수 있지만, 컨텍스트나 브라우저를 위한 여유 공간이 거의 남지 않습니다. 그런 경우 Q3_K_XL을 선택하는 것이 좋습니다.
Qwen 3.8 27B는 로컬에서 얼마나 빠른가?
RTX 3090 또는 4090에서 Q4_K_M과 llama.cpp 조합으로 초당 약 38~44 토큰, RTX 5090에서는 초당 65~75 토큰을 기대할 수 있습니다. M3 Ultra를 탑재한 Mac Studio는 초당 약 25~27 토큰 수준으로 디코딩합니다.
저희가 직접 벤치마크를 진행한 것은 아닙니다. 다음 수치는 llm-speed가 공개한 실측 결과로, 명시된 하드웨어와 런타임 조건입니다:
| 하드웨어 | 양자화 / 런타임 | 디코딩 tok/s | 프리필 tok/s |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M, llama.cpp | 38.6 (짧은 대화, 4K ctx) | 482 |
| RTX 4090 24 GB | Q4_K_M, llama.cpp | 43.4 (짧은 대화, 4K ctx) | 448 |
| RTX 5090 32 GB | Q4_K_M, llama.cpp | 75.2 (짧은 대화, 4K ctx) | 563 |
| L40S 45 GB | Q4_K_M, llama.cpp | 34.3 (짧은 대화) | 569 |
| M3 Ultra 96 GB | Q4_K_M, llama.cpp | 25.2 (짧은 대화) | 45 |
| M3 Ultra 96 GB | 4비트, MLX 0.31.3 | 27.3 (짧은 대화) | 12 |
GPU에서는 컨텍스트가 길어져도 디코딩 속도가 거의 떨어지지 않습니다. 4090은 33,133토큰 프롬프트 이후에도 초당 39.0 토큰을 유지했습니다. Mac이 뒤처지는 부분은 프리필(prefill)입니다. 11,827토큰 프롬프트에서 M3 Ultra는 초당 약 283 토큰을 처리한 반면, 4090은 대략 초당 2,000~3,000 토큰을 처리했습니다. 즉, 대규모 코드베이스의 경우 첫 토큰이 나오기까지 수십 초가 걸릴 수 있습니다.
추론(thinking) 모드도 시간 예산을 잡아먹습니다. Simon Willison이 로컬 Qwen 3.8 27B에 원시 모델 가중치로 게임을 식별하게 했을 때, 한 답변에 46분과 43,506개의 추론 토큰이 소요되었습니다. 일상적인 작업에서는 reasoning_effort를 low로 낮추거나 추론 기능을 끄는 것이 좋습니다.
Ollama로 Qwen 3.8 27B 실행하기
Ollama는 어떤 OS에서든 가장 빠른 방법입니다. ollama.com에서 설치한 뒤 다음을 실행하세요:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
Apple Silicon에서는 qwen3.8:27b-mlx 태그를 사용해 보세요. 동일한 18 GB 용량으로 MLX 백엔드를 사용합니다.
Ollama의 기본 컨텍스트 크기는 작아서 긴 에이전트 세션에서는 문제가 됩니다. 서버를 시작하기 전에 다음과 같이 늘리세요:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
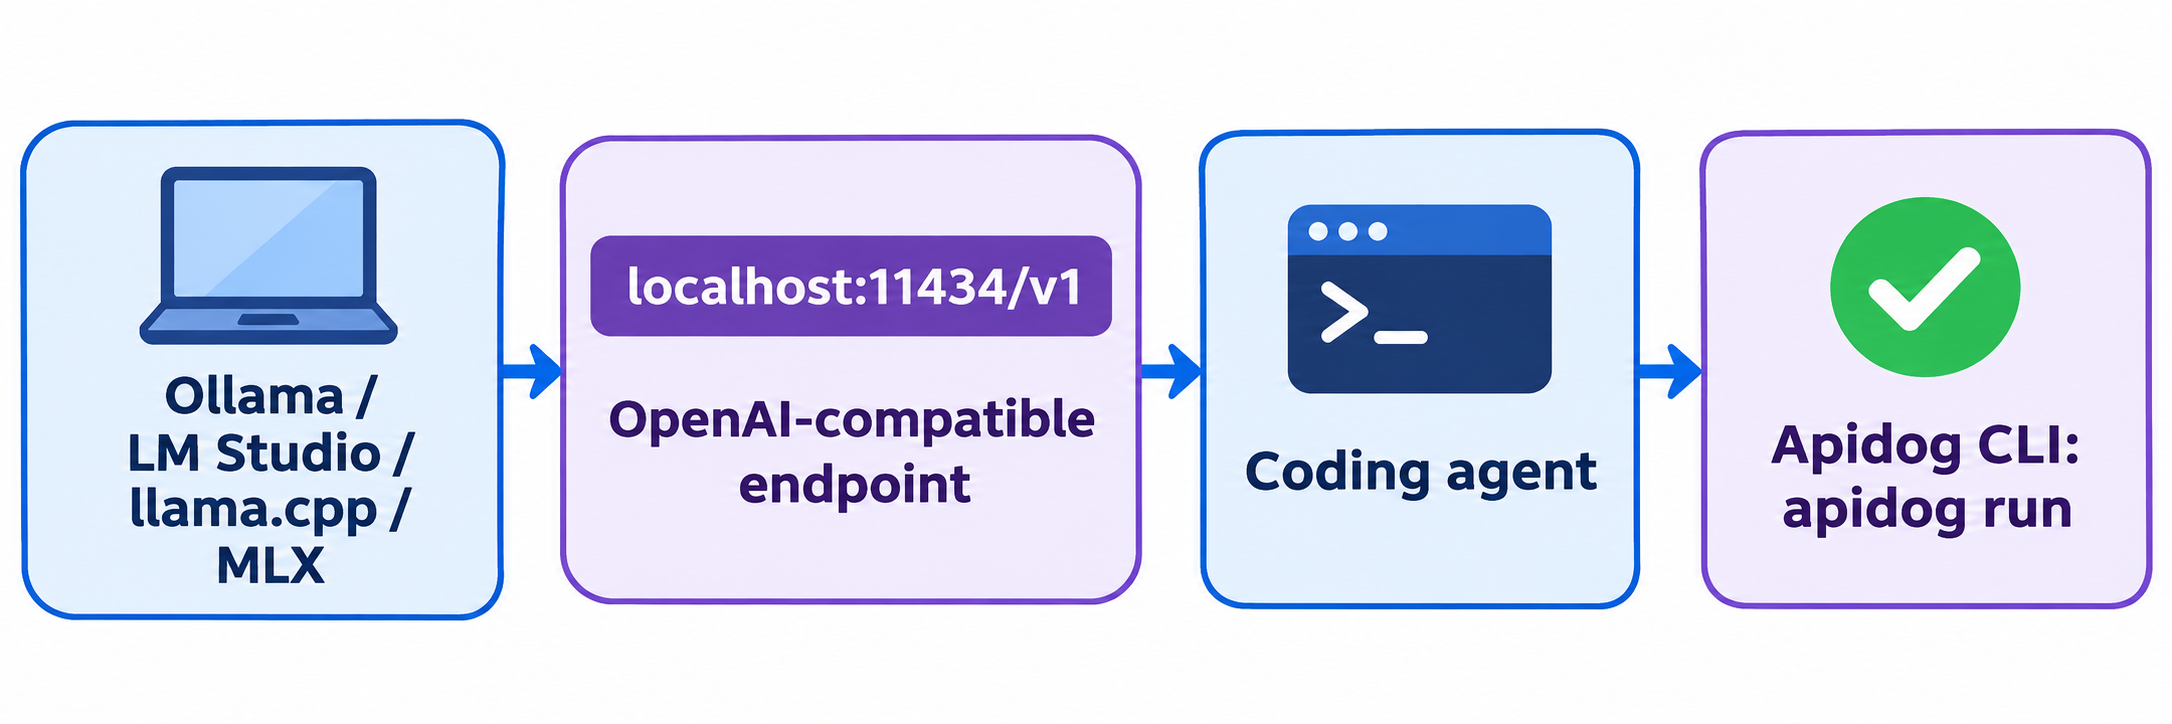
Ollama는 http://localhost:11434/v1에서 OpenAI 호환 API도 제공하므로, 베이스 URL만 바꾸면 어떤 OpenAI SDK든 사용할 수 있습니다:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
코딩 에이전트 안에서 사용하고 싶으신가요? Ollama는 실행 단축 명령을 제공합니다. ollama launch claude --model qwen3.8은 로컬 모델로 Claude Code를 시작하고, ollama launch opencode --model qwen3.8은 OpenCode에서 동일하게 작동합니다.
LM Studio로 실행하기
GUI와 모델별 로드 설정이 필요하다면 LM Studio가 좋은 선택입니다. Qwen 3.8 27B를 검색하고, Q4_K_M(16.8 GB)의 lmstudio-community/Qwen3.8-27B-GGUF 빌드를 다운로드한 뒤 로드하세요.
중요한 설정이 하나 있습니다: 모델을 로드할 때 컨텍스트 길이를 늘리는 것입니다. Simon Willison은 기본 8,192토큰 컨텍스트가 긴 프롬프트에서 오류가 발생해 더 큰 윈도우를 로드해야 했습니다.
이후 Developer 탭을 열어 로컬 서버를 시작하거나, 터미널에서 lms server start를 실행하세요. OpenAI 호환 엔드포인트는 http://localhost:1234/v1에 있습니다.
llama.cpp로 실행하기
llama.cpp는 가장 세밀한 제어를 제공하며, 위의 벤치마크 대부분도 이 런타임으로 측정된 결과입니다. macOS 또는 Linux에서:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf는 양자화 모델을 Hugging Face에서 바로 다운로드하고, --jinja는 모델의 채팅 템플릿(툴 호출과 추론에 필요)을 적용하며, -c는 컨텍스트를 설정하고 -ngl 99는 모든 레이어를 GPU에 올립니다. 샘플링 값은 추론(thinking) 모드에 대한 Qwen의 권장 설정입니다. 비추론 모드에서는 모델 카드가 temperature 0.7, top_p 0.8, top_k 20, presence_penalty 1.5를 권장합니다.
특정 요청에서만 추론을 끄려면 본문에 "chat_template_kwargs": {"enable_thinking": false}를 전송하세요.
Mac에서 MLX로 실행하기
MLX는 Apple 자체 배열 프레임워크로, Apple Silicon에서 디코딩 속도가 가장 빠른 런타임인 경우가 많습니다. mlx-lm을 설치하고 mlx-community의 4비트 변환본을 사용하세요:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server는 OpenAI 호환 /v1/chat/completions 라우트를 제공합니다. mlx-community 조직은 메모리를 품질이나 속도와 교환하고 싶다면 8비트, mxfp4, MTP 변형 모델도 공개하고 있습니다.
Apidog CLI로 코딩 에이전트가 로컬 엔드포인트를 테스트하게 하기
모든 실행 환경이 동일한 OpenAI 호환 형식을 제공하지만, 추론 블록, 툴 호출, 타임아웃 처리는 각각 다르게 작동합니다. 앱을 localhost로 연결하기 전에 코딩 에이전트가 Apidog CLI로 반복 가능한 테스트를 만들게 하세요. 그러면 깨진 템플릿이나 컨텍스트 제한 문제가 작업 도중이 아니라 몇 초 안에 드러납니다.
한 번만 설정해 두세요:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그다음 Claude Code, Codex 또는 Cursor에 다음 프롬프트 하나를 주세요:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
에이전트가 각 페이로드 스키마를 읽고 JSON을 검증한 뒤, 리소스를 생성하고 테스트 케이스를 실행합니다:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
긴 --timeout-request 값이 여기서 중요합니다: 추론 모드의 27B 모델은 Mac에서 몇 분이 걸릴 수 있습니다. 베이스 URL을 http://localhost:1234/v1 또는 :8080/v1로 바꾸면 같은 케이스로 LM Studio, llama.cpp 또는 MLX도 확인할 수 있습니다. 더 많은 에이전트 설정은 Claude Code에서의 Apidog CLI와 apidog run 명령어 참조를 확인하세요. Apidog의 무료 플랜은 최대 4명의 사용자까지 지원합니다.
로컬 실행 vs 호스팅 Qwen 3.8 API
로컬 실행은 프롬프트가 내 컴퓨터에 머물고, 오프라인에서도 작동하며, 토큰당 비용이 없다는 장점이 있습니다. 대가는 속도와 규모입니다. 호스팅 엔드포인트는 훨씬 큰 Qwen 3.8-Max를 1M 컨텍스트와 프리필 대기 없이 제공합니다. 플래그십 모델이 필요하다면 Qwen 3.8 API 가이드나 무료 이용 방법을 참고하세요. 어느 쪽이든 에이전틱 코딩을 위해서는 코딩용 Qwen 3.8 글에서 하네스 설정을 비교하고 있습니다.
FAQ
Qwen 3.8 27B를 로컬에서 무료로 실행할 수 있나요? 네. 가중치는 Hugging Face에서 Apache-2.0으로 공개되어 있고, Ollama, LM Studio, llama.cpp, MLX 모두 무료입니다. 비용은 하드웨어와 전기 요금뿐입니다.
16 GB Mac에서 Qwen 3.8 27B를 실행할 수 있나요? UD-IQ2_XXS(7.27 GB) 같은 2비트 양자화와 짧은 컨텍스트로만 가능하며, 품질 저하가 눈에 띕니다. Q4_K_M을 돌리는 32 GB Mac이 편안한 구성입니다.
Qwen 3.8 27B는 RTX 3090에서 돌아가나요? 네. Q4_K_M은 24 GB 안에 16K~32K 컨텍스트까지 여유 있게 들어가며, llm-speed는 llama.cpp에서 초당 약 38 토큰을 측정했습니다.
추론(thinking) 모드는 어떻게 끄나요? llama.cpp나 vLLM에서는 "chat_template_kwargs": {"enable_thinking": false}를 보내거나, reasoning_effort를 low로 낮추세요. 비추론 모드에서는 Qwen이 temperature 0.7과 top_p 0.8을 권장합니다.
로컬 모델은 이미지를 지원하나요? 네. Ollama의 18 GB 태그에는 비전 기능이 포함되어 있습니다. llama.cpp에서는 모델과 함께 mmproj-F16.gguf 파일을 다운로드하세요.
Qwen 3.8 27B와 Qwen 3.8-Max의 차이는 무엇인가요? Max는 Alibaba API를 통해 제공되는 2.4조 파라미터 혼합 전문가(mixture-of-experts) 플래그십입니다. 27B는 GPU 한 장이나 32 GB Mac에서 돌아갈 만큼 작은 밀집(dense) 모델입니다.