
NVIDIA의 새로운 Nemotron 3.5 Transcribe를 GPU 한 대에서 실행하여 40개 언어로 한 시간 분량 녹음을 분당 요금을 내거나 오디오를 누구에게도 보내지 않고 전사할 수 있습니다. 이 모델은 Hugging Face Open ASR Leaderboard에서 최고 오픈 가중치 모델이며, 상업적 사용이 가능한 OpenMDW-1.1 라이선스로 제공되고, NVIDIA는 출시일인 2026년 10월 28일에 BF16, FP8, NVFP4 가중치를 공개했습니다.
이 가이드는 필요한 하드웨어, 실행하는 세 가지 방법(vLLM, SGLang-Omni, Transformers), 공식 모델 카드의 정확한 명령어, 그리고 사람들이 자주 실수하는 설정을 다룹니다. 모든 명령어는 2026년 10월 29일에 해당 카드에서 복사했습니다.
이 모델이 처음인가요? 무료 가이드에서 이 모델이 무엇을 하는지와 순위를 설명합니다. GPU가 없나요? 호스팅 API는 분당 $0.002입니다.
로컬에서 실행하는 이유
- 분당 요금 없음. DeepInfra의 분당 $0.002라면 10,000시간에 $1,200입니다. 자체 GPU에서는 전기 요금만 냅니다.
- 개인정보 보호. 고객 통화, 의료 받아쓰기, 법률 녹음이 네트워크를 떠나지 않습니다.
- 전체 기능. vLLM 경로는 단어 타임스탬프, 화자 분리, 번역, 컨텍스트 프롬프트를 지원합니다. 일부 호스팅 엔드포인트는 그중 일부만 제공합니다.
- 미세 조정. NVIDIA의 출시 게시물은 의료 미세 조정으로 WER을 30.8%에서 11.8%로 낮춘 사례를 보여줍니다. 이는 가중치가 있어야만 가능합니다.
하드웨어: 무엇으로 실행되는가
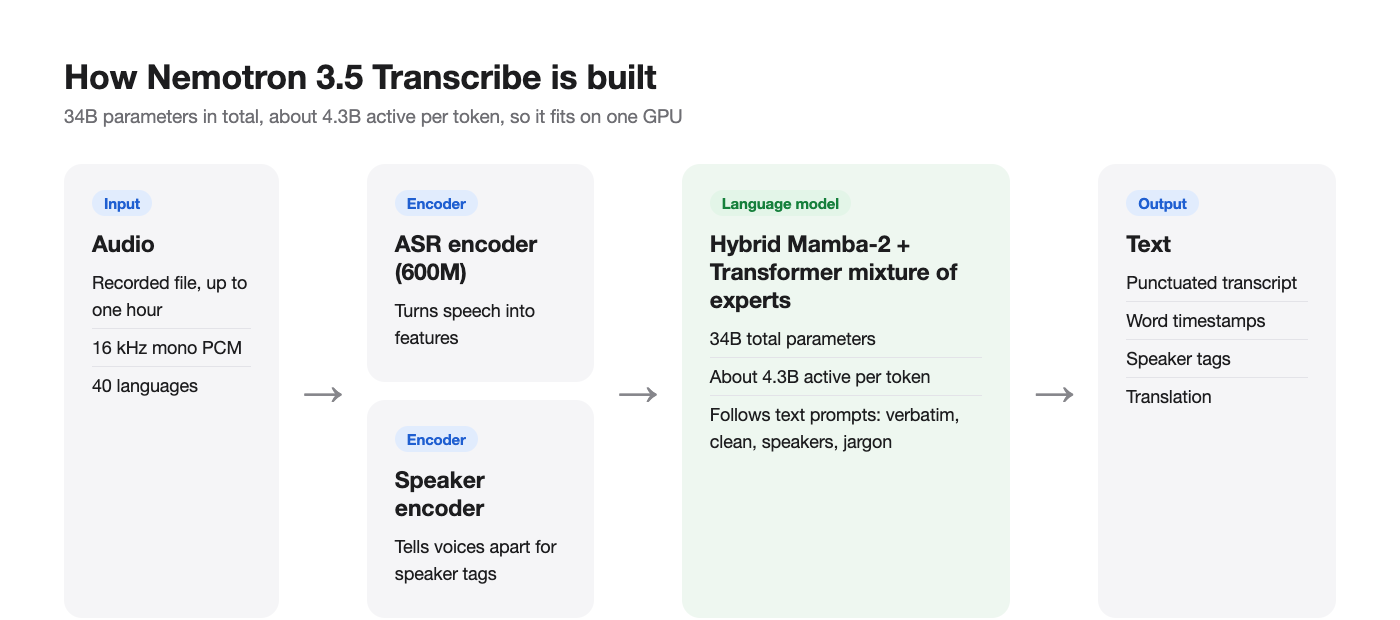
이 모델은 총 34B 파라미터이고 약 4.3B가 활성화되므로, 토큰당 연산은 적지만 가중치는 큽니다. NVIDIA의 기준 대상은 BF16의 H100 80GB 한 대입니다. 모델 카드의 호환성 표는 다음과 같습니다:
| GPU | 정밀도 | 런타임 |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | NVFP4만 | vLLM 0.32.0, Transformers, GGML |
사용하는 카드에 맞는 체크포인트를 고르세요:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
RTX 4090 같은 24GB 카드는 목록에 없고, Apple Silicon은 지원되지 않습니다. 운영체제는 Linux 또는 WSL2를 통한 Windows입니다. GGML은 네이티브 Windows에서도 실행되지만, NVIDIA의 출시 게시물에 따르면 NeMo-Speech.cpp 로컬 빌드는 아직 “곧 제공될 예정”입니다.
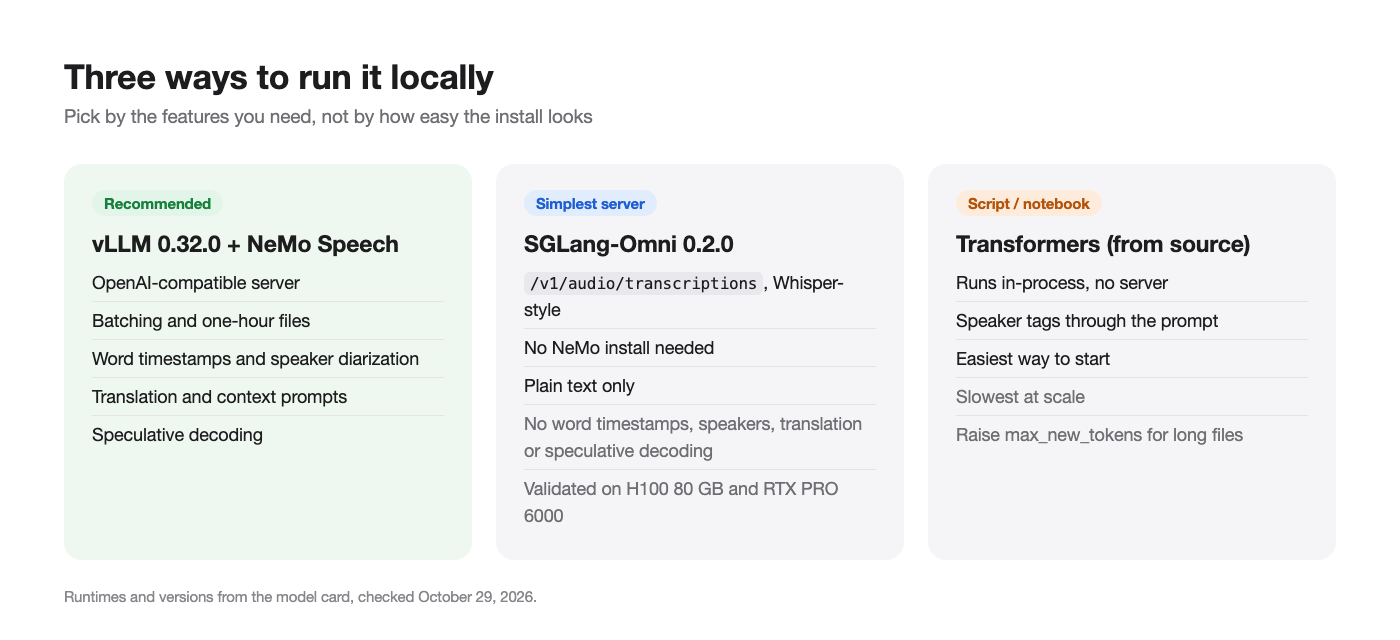
옵션 1: vLLM 서버(권장)
vLLM은 배치 처리, 한 시간 파일, 추측 디코딩, 단어 타임스탬프를 갖춘 OpenAI 호환 엔드포인트를 제공합니다. vLLM 0.32.0과 모델의 vLLM 플러그인을 제공하는 최신 NeMo Speech 메인 브랜치가 필요합니다.
설치
모델 카드는 uv와 Python 3.13을 사용합니다:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
PyAV(av)는 시스템 FFmpeg 없이 M4A 및 기타 압축 형식을 디코딩할 수 있게 합니다. OpenCV는 vLLM에 필요하지만 NeMo의 의존성 설정에서 빠져 있기 때문에 포함됩니다.
서버 시작
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
이해할 가치가 있는 플래그:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600은 vLLM의 오디오 제한을 600초에서 한 시간으로 늘립니다. 이를 빼먹으면 긴 파일이 실패합니다.VLLM_USE_V2_MODEL_RUNNER=0은 단어 타임스탬프에 필요한 V1 러너를 유지합니다.--speculative-config는 8개의 드래프트 토큰을 사용하는 다중 토큰 예측(MTP8)을 켭니다. H100에서 NVIDIA는 배치 영어 RTFx가 MTP8에서 270, MTP2에서 410이라고 측정했으므로, 지연 시간보다 처리량이 중요하면"num_speculative_tokens":2를 시도하세요.--middleware ... ctc_timestamp_middleware와--trust-request-mm-kwargs를 사용하면 요청에서 단어 타임스탬프를 요청할 수 있습니다.- 이 설정은 80GB H100을 대상으로 합니다. 다른 카드에서는
--gpu-memory-utilization,--max-model-len또는--max-num-seqs를 낮추세요.
서버는 127.0.0.1:8000에서 수신 대기합니다. 네트워크의 다른 머신에서 접속하려면 --host 0.0.0.0을 추가하세요.
파일 보내기
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
텍스트 지시문을 원하는 작업 프롬프트로 바꾸세요. 여러 목소리가 있는 회의의 경우:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
단어 타임스탬프 요청에는 규칙이 있습니다: 요청당 녹음 하나, stream=false, n=1입니다. 그러면 응답에 단어, 초 단위 시작 및 종료 시간, 화자 태그가 포함된 ctc_timestamps 객체가 포함됩니다.
옵션 2: 일반 전사를 위한 SGLang-Omni
전체 파일에서 텍스트만 필요하다면 SGLang-Omni 0.2.0이 더 간단하고 NeMo가 필요하지 않습니다. BF16 또는 FP8 체크포인트로 H100 80GB 한 대와 RTX PRO 6000 Blackwell 한 대에서 검증되었습니다.
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
그 /v1/audio/transcriptions 경로는 OpenAI의 Whisper API가 사용하는 형태와 일치하므로, 기존 Whisper 클라이언트 코드는 대개 새 base URL만 필요합니다. 단점: 이 통합에서는 단어 타임스탬프, 화자 레이블, 번역, 추측 디코딩이 없습니다.
옵션 3: 스크립트에서 Transformers 사용
노트북과 일회성 작업에는 소스에서 설치한 Hugging Face Transformers로 프로세스 내에서 실행하세요:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
시작하기 가장 쉽고 대규모로 실행하기에는 가장 느린 방법입니다. 긴 파일에서는 max_new_tokens를 높이세요: 밀도 높은 한 시간은 약 20,000토큰을 생성할 수 있습니다.
자체 GPU에서 얼마나 빠른가요?
NVIDIA의 대표 수치는 RTX PRO 6000 Blackwell 한 대에서 NVFP4 가중치와 DFlash2 추측 디코딩을 사용할 때 초당 2,238초 오디오이며, 30초 클립을 반환하는 데 0.13초입니다. 각주를 읽어보세요: 이 수치는 최적화된 NIM에서 나온 것이며, 해당 서빙 변경 사항은 아직 오픈 소스가 아닙니다. 모델 카드에 따르면 오픈 vLLM 통합은 약 두 배 느릴 것으로 예상됩니다.
BF16의 H100 배치 영어 전사에 대해 모델 카드는 다음 RTFx 수치(연산 1초당 오디오 초)를 나열합니다:
| 추측 디코딩 | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
가장 느린 행도 배치 작업에서 GPU 시간 15초 이내에 한 시간 오디오를 처리합니다. DFlash2 드래프트 모델을 원한다면, vLLM 0.32.0에 모델 카드의 작은 패치가 필요하고, DFlash2는 단어 타임스탬프를 비활성화하며, MTP와 함께 사용하면 안 된다는 점에 유의하세요.
일반적인 문제와 해결 방법
- 긴 파일이 10분에서 잘림.
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600을 건너뛰었습니다. - 응답에 타임스탬프가 없음.
VLLM_USE_V2_MODEL_RUNNER=0,--middleware플래그, 요청에stream=false와 녹음 하나가 있는지 확인하세요. - 더 작은 카드에서 메모리 부족. FP8 또는 NVFP4 체크포인트로 전환하고
--max-num-seqs를 낮추세요. - 전사 끝부분에서 반복되는 구절. 모델 카드는 최종 출력에 생성 루프 가드레일을 권장합니다.
max_tokens를 제한하고 반복을 잘라내세요. - 이름 철자가 틀림. 프롬프트에
Context terms: <names>를 추가하세요. - 전사에 배경 목소리가 포함됨. 모델 카드의 실험적 근거리(near-field) 프롬프트를 사용해 보세요. NVIDIA 테스트에서 혼합 오디오의 WER을 27.32%에서 4.78%로 낮췄습니다.
vLLM 자체가 처음이라면, vLLM 설명서에서 요청을 배치 처리하고 GPU 메모리를 관리하는 방법을 다룹니다.
Apidog CLI로 코딩 에이전트가 로컬 서버를 테스트하게 하기
로컬 모델은 vLLM 업그레이드, 프롬프트 조정, 체크포인트 교체 전반에 걸쳐 엔드포인트가 올바르게 유지될 때만 유용합니다. Apidog CLI를 사용하여 코딩 에이전트가 같은 머신에서 http://127.0.0.1:8000에 대해 검사를 실행하도록 맡기세요.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그런 다음 에이전트에 프롬프트 하나를 주세요:
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
에이전트는 스키마를 읽고, 페이로드를 검증하고, 케이스를 작성하고 실행합니다:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
서버를 업그레이드할 때마다 실행하거나, CI/CD 파이프라인에서의 Apidog CLI에 표시된 대로 apidog run ... -r junit을 CI에 연결하세요. 에이전트 설정은 Claude Code에서의 Apidog CLI를 참조하세요.
자주 묻는 질문
RTX 4090에서 Nemotron 3.5 Transcribe를 실행할 수 있나요? NVIDIA의 호환성 목록에 없습니다. 목록에 있는 가장 작은 소비자용 카드는 NVFP4 체크포인트를 사용하는 RTX 5090입니다.
Mac에서 실행되나요? 2026년 10월 29일 기준으로 Apple Silicon을 지원하는 공식 런타임은 없습니다.
상업적 제품에서 로컬 사용이 무료인가요? OpenMDW-1.1 라이선스는 상업적 및 비상업적 사용을 허용합니다. 출시 전에 저작자 표시 조건은 라이선스 본문을 읽어보세요.
실시간 오디오를 전사할 수 있나요? 아니요. 녹음 파일용 오프라인 모델입니다. NVIDIA는 실시간 사용을 위해 별도의 Nemotron 3.5 ASR Streaming 모델을 제공합니다.
vLLM과 SGLang-Omni 중 어느 것이 더 빠른가요? NVIDIA는 직접 비교를 공개하지 않습니다. 타임스탬프, 화자 또는 번역이 필요하면 vLLM을 사용하고, 가장 간단한 텍스트 전용 서버에는 SGLang-Omni를 사용하세요.
다른 로컬 모델과 비교해 순위는 어떤가요? 10월 28일 Open ASR Leaderboard에서 모든 오픈 가중치 모델을 앞섭니다. 최고의 오픈 소스 음성-텍스트 모델 목록에서 Qwen3-ASR, Granite Speech, Canary-Qwen, Voxtral, Whisper와 비교합니다.
실행하기
GPU에 맞는 체크포인트를 다운로드하고, 한 시간 오디오 제한과 타임스탬프 미들웨어로 vLLM을 시작한 다음, OpenAI 클라이언트를 통해 WAV 파일을 보내세요. 그런 다음 에이전트가 로컬 엔드포인트에 대해 Apidog 검사를 실행하게 하여, 실제 녹음을 맡기기 전에 모든 업그레이드에서 여전히 전사되는지 확인하세요.