
개발자와 AI 애호가들은 방대한 자원을 요구하지 않으면서도 성능이 뛰어난 효율적인 모델을 끊임없이 찾고 있습니다. 구글은 2억 7천만 개의 매개변수를 가진 소형 언어 모델인 Gemma 3 270M을 소개합니다. 이 모델은 Gemma 3 제품군 중 가장 작은 모델로, 온디바이스 작업에 최적화되어 있습니다. 텍스트 생성, 질문 답변, 요약, 추론 기능을 모두 로컬에서 실행하면서도 활용할 수 있습니다.
Gemma 3 270M은 32,000 토큰의 컨텍스트 길이를 지원하여 상당한 입력을 효과적으로 처리할 수 있습니다. 또한 Q4_0 양자화 인식 훈련(QAT)과 같은 양자화 기술을 통합하여 품질 저하 없이 자원 요구 사항을 줄입니다. 결과적으로, 더 낮은 메모리와 컴퓨팅 요구 사항으로 전체 정밀도 모델에 가까운 성능을 달성할 수 있습니다.
그러나 Gemma 3 270M을 특히 매력적으로 만드는 것은 접근성입니다. 노트북이나 심지어 모바일 장치를 포함한 표준 하드웨어에서 실행할 수 있어 개인 정보 보호 및 낮은 지연 시간 애플리케이션을 촉진합니다. 다음으로, 이 모델이 효율성이 혁신을 주도하는 광범위한 AI 개발 트렌드에 어떻게 부합하는지 고려해 보세요.
Gemma 3 270M 아키텍처 이해하기
구글은 Gemma 3 270M을 트랜스포머 기반 아키텍처 위에 구축했으며, 256,000 토큰 어휘를 가진 임베딩에 1억 7천만 개의 매개변수를, 트랜스포머 블록에 1억 개의 매개변수를 특징으로 합니다. 이 설정은 다국어 지원 및 특정 작업 처리를 가능하게 합니다. INT4 양자화, 회전 위치 임베딩, 그룹 쿼리 어텐션과 같은 기술을 활용하여 추론 속도와 경량성을 향상시킬 수 있습니다.
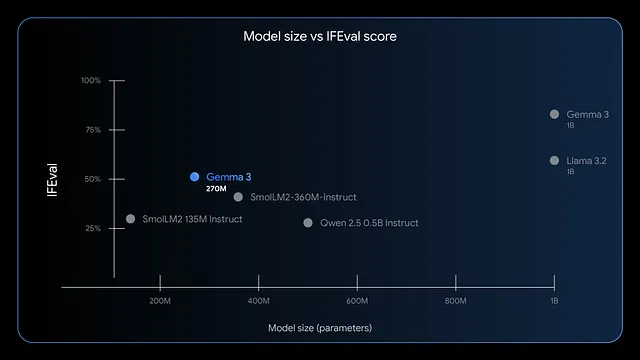
또한, 이 모델은 지시 따르기 및 데이터 추출에 탁월합니다. 벤치마크는 IFEval에서 높은 F1 점수를 보여주며, 평가 작업에서 강력한 성능을 나타냅니다. GPT-4 또는 Phi-3 Mini와 같은 더 큰 모델과 비교할 때, Gemma 3 270M은 효율성을 우선시하며, Apple의 M4 Max와 같은 장치에서 4비트 모드에서 200MB 미만을 사용합니다.
결과적으로, 실시간 감성 분석 또는 의료 엔티티 추출과 같이 빠른 응답이 필요한 시나리오에 배포할 수 있습니다. 그러나 작은 크기가 창의성을 제한하지는 않습니다. 창의적인 글쓰기 또는 금융 규정 준수 확인에 적용할 수 있습니다. 앞으로 이 모델을 로컬에서 실행할 때의 이점을 평가해 보세요.
Gemma 3 270M을 로컬에서 실행할 때의 이점
데이터를 장치에 보관하여 노출 위험이 있는 클라우드 전송을 피함으로써 개인 정보 보호를 강화합니다. Gemma 3 270M은 지연 시간을 줄여 몇 초가 아닌 밀리초 단위로 응답을 제공합니다. 또한 클라우드 기반 API에 대한 구독료를 피할 수 있으므로 비용을 절감할 수 있습니다.
또한, 이 모델의 에너지 효율성은 두드러집니다. INT4 양자화 모드에서 25회 대화에 Pixel 9 Pro 배터리의 0.75%만 소비합니다. 이 특성은 전력이 중요한 모바일 및 엣지 컴퓨팅에 적합합니다. LoRA와 같은 도구를 사용하여 미세 조정을 통해 모델을 쉽게 사용자 정의할 수도 있으며, 최소한의 데이터만 필요합니다.
그럼에도 불구하고, 로컬 실행은 소규모 팀이나 개별 개발자에게 힘을 실어줍니다. 전자상거래 쿼리 라우팅 또는 법률 텍스트 구조화와 같은 애플리케이션을 자유롭게 실험하고 반복할 수 있습니다. 진행하면서 시스템이 요구 사항을 충족하는지 확인하세요.
Gemma 3 270M 추론을 위한 시스템 요구 사항
Gemma 3 270M은 겸손한 하드웨어를 요구하므로 접근성이 높습니다. CPU 전용 추론의 경우, 최소 4GB RAM과 Intel Core i5 또는 동급의 최신 프로세서가 필요합니다. 그러나 GPU 가속은 속도를 향상시킵니다. 양자화된 버전을 위해서는 2GB VRAM을 가진 NVIDIA 카드로 충분합니다.
특히 4비트 모드에서 모델은 200MB 메모리 내에 맞으므로 리소스가 제한된 장치에서도 실행할 수 있습니다. Apple silicon 사용자는 MLX-LM의 이점을 누릴 수 있으며, M4 Max에서 초당 650개 이상의 토큰을 달성합니다. 미세 조정을 위해서는 작은 데이터 세트를 효율적으로 처리하기 위해 8GB RAM과 4GB VRAM을 가진 GPU를 할당하세요.
중요한 것은 Windows, macOS 또는 Linux와 같은 운영 체제가 작동하지만, 라이브러리 호환성을 위해 Python 3.10+를 확인해야 합니다. 저장 공간은 모델 파일에 약 1GB가 필요합니다. 이들이 갖춰지면 문제없이 설치하고 실행할 수 있습니다. 이제 설치 방법을 살펴보겠습니다.
Gemma 3 270M을 로컬에서 실행하기 위한 올바른 도구 선택
몇 가지 프레임워크가 Gemma 3 270M을 지원하며, 각 프레임워크는 고유한 강점을 제공합니다. Hugging Face Transformers는 Python 스크립팅 및 통합을 위한 유연성을 제공합니다. LM Studio는 모델 관리를 위한 사용자 친화적인 인터페이스를 제공합니다.
또한, llama.cpp는 효율적인 C++ 기반 추론을 가능하게 하여 저수준 최적화에 완벽합니다. Apple 장치의 경우, MLX는 M-시리즈 칩에서 성능을 최적화합니다. 전문 지식에 따라 선택하세요. 초보자는 LM Studio를 선호하고, 개발자는 Transformers를 선호합니다.
따라서 이러한 도구는 접근성을 민주화합니다. 다음 섹션에서는 인기 있는 방법에 대한 단계별 가이드를 따르세요.
단계별 가이드: Hugging Face Transformers로 Gemma 3 270M 실행하기
필요한 라이브러리를 설치하는 것부터 시작합니다. 터미널을 열고 다음을 실행하세요:
pip install transformers torch
이 명령은 Transformers와 PyTorch를 가져옵니다. 다음으로, Python 스크립트에서 구성 요소를 가져옵니다:
from transformers import AutoTokenizer, AutoModelForCausalLM
모델과 토크나이저를 로드합니다:
model_name = "google/gemma-3-270m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
device_map="auto"는 사용 가능한 경우 모델을 GPU에 배치합니다. 입력을 준비합니다:
input_text = "Explain quantum computing in simple terms."
inputs = tokenizer(input_text, return_tensors="pt").to(model.device)
출력을 생성합니다:
outputs = model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(response)
이것은 일관된 설명을 생성합니다. 최적화를 위해 양자화를 추가합니다:
from transformers import BitsAndBytesConfig
quant_config = BitsAndBytesConfig(load_in_4bit=True)
model = AutoModelForCausalLM.from_pretrained(model_name, quantization_config=quant_config)
양자화는 메모리 사용량을 줄입니다. 게이트 모델의 경우 Hugging Face 로그인을 확인하여 오류를 처리합니다:
from huggingface_hub import login
login(token="your_hf_token")
Hugging Face 계정에서 토큰을 얻으세요. 이 설정을 통해 추론을 반복적으로 실행할 수 있습니다. 그러나 Python 사용자가 아니라면 다음으로 LM Studio를 고려해 보세요.
단계별 가이드: LM Studio로 Gemma 3 270M 실행하기
LM Studio는 직관적인 인터페이스를 제공합니다. lmstudio.ai에서 다운로드하여 설치하세요.
앱을 실행한 다음 모델 허브에서 "gemma-3-270m"을 검색합니다.
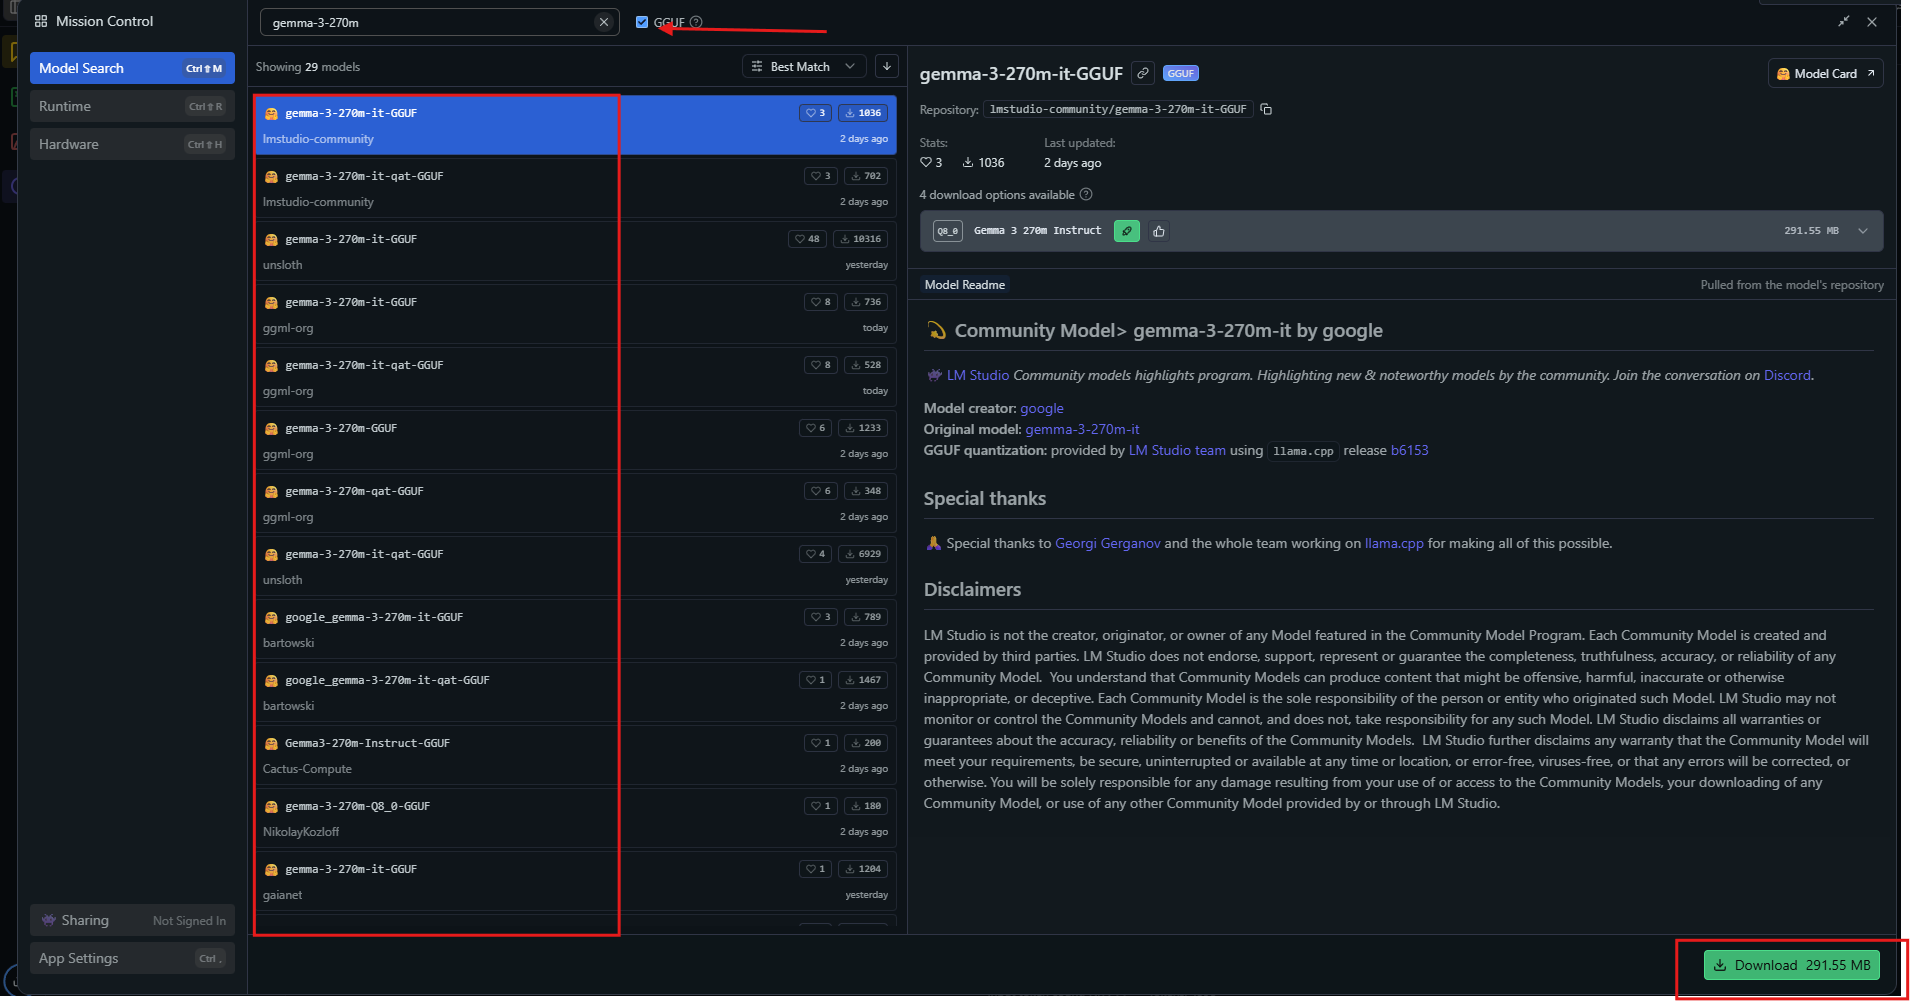
Q4_0과 같은 양자화된 변형을 선택하고 다운로드합니다. 준비가 되면 사이드바에서 모델을 로드합니다. 설정을 조정합니다: 컨텍스트를 32k로, 온도를 1.0으로 설정합니다.
채팅 창에 프롬프트를 입력하고 보내기를 누릅니다. LM Studio는 토큰 속도와 함께 응답을 표시합니다. 채팅을 내보내거나 통합 도구를 통해 미세 조정할 수 있습니다.
고급 사용의 경우 설정에서 GPU 오프로딩을 활성화합니다. LM Studio는 최적의 소스를 자동으로 선택하여 호환성을 보장합니다. 이 방법은 시각 학습자에게 적합합니다. 또한 성능 조정을 위해 llama.cpp를 탐색해 보세요.
단계별 가이드: llama.cpp로 Gemma 3 270M 실행하기
llama.cpp는 고효율 추론을 제공합니다. 저장소를 복제합니다:
git clone https://github.com/ggerganov/llama.cpp
빌드합니다:
make -j
Hugging Face에서 GGUF 파일을 다운로드합니다:
huggingface-cli download unsloth/gemma-3-270m-it-GGUF --include "*.gguf"
추론을 실행합니다:
./llama-cli -m gemma-3-270m-it-Q4_K_M.gguf -p "Build a simple AI app."
전체 GPU 사용을 위해 --n-gpu-layers 999와 같은 매개변수를 지정합니다. llama.cpp는 속도와 정확성의 균형을 맞추는 양자화 수준을 지원합니다. NVIDIA GPU의 경우 CUDA로 컴파일합니다:
make GGML_CUDA=1
이것은 처리를 가속화합니다. llama.cpp는 임베디드 시스템에서 탁월합니다. 이제 실제 예제에서 모델을 적용해 보세요.
Gemma 3 270M을 로컬에서 사용하는 실제 예제
감성 분석기를 만듭니다. 고객 리뷰를 입력하고 모델이 긍정 또는 부정으로 분류합니다. Python으로 스크립트를 작성합니다:
prompt = "Classify: This product is amazing!"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(**inputs)
print(tokenizer.decode(outputs[0]))
Gemma 3 270M은 "Positive"를 출력합니다. 요약으로 확장합니다:
text = "Long article here..."
prompt = f"Summarize: {text}"
# Generate summary
콘텐츠를 효과적으로 압축합니다. 질문 답변의 경우 다음을 쿼리합니다:
"기후 변화의 원인은 무엇인가요?"
모델은 온실가스를 설명합니다. 의료 분야에서는 노트에서 엔티티를 추출합니다. 이러한 사용은 다재다능함을 보여줍니다. 또한 전문화를 위해 미세 조정합니다.
Gemma 3 270M 로컬에서 미세 조정하기
미세 조정은 모델을 조정합니다. Hugging Face의 PEFT 라이브러리를 사용합니다:
pip install peft
LoRA 구성으로 로드합니다:
from peft import LoraConfig, get_peft_model
lora_config = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"])
model = get_peft_model(model, lora_config)
데이터셋을 준비한 다음 훈련합니다:
from transformers import Trainer, TrainingArguments
trainer = Trainer(model=model, args=TrainingArguments(output_dir="./results"))
trainer.train()
LoRA는 적은 데이터를 필요로 하며, 겸손한 하드웨어에서 빠르게 완료됩니다. 어댑터를 저장하고 다시 로드합니다. 이것은 체스 움직임 예측과 같은 사용자 정의 작업에서 성능을 향상시킵니다. 그러나 과적합을 모니터링해야 합니다.
Gemma 3 270M 성능 최적화 팁
4비트 또는 8비트로 양자화하여 속도를 극대화합니다. 여러 추론을 위해 배치 처리를 사용합니다. 권장되는 대로 온도를 1.0, top_k=64, top_p=0.95로 설정합니다.
GPU에서는 혼합 정밀도를 활성화합니다. 긴 컨텍스트의 경우 KV 캐시를 신중하게 관리합니다. nvidia-smi와 같은 도구로 VRAM을 모니터링합니다. 최적화를 위해 라이브러리를 정기적으로 업데이트합니다.
결과적으로, 이러한 조정은 적절한 하드웨어에서 초당 130개 이상의 토큰을 생성합니다. 프롬프트에서 이중 BOS 토큰과 같은 일반적인 함정을 피하세요. 연습을 통해 효율적인 실행을 달성할 수 있습니다.
결론
이제 Gemma 3 270M을 로컬에서 실행하는 방법을 알게 되었습니다. 설정부터 최적화까지, 각 단계는 기능을 구축합니다. 실험하고, 미세 조정하고, 배포하여 잠재력을 실현하세요. 이와 같은 작은 모델은 AI 접근성에 큰 영향을 미 미칩니다.