
ERNIE 5.5 Flash를 로컬에서 실행하려면 vLLM 0.32.0과 바이두의 vLLM-ERNIE 플러그인을 설치한 뒤, 멀티 GPU 노드에서 데이터 병렬화와 엑스퍼트 병렬화를 활성화하여 vllm serve baidu/ERNIE-5.5-Flash-Base 명령을 실행하면 됩니다. 그러면 포트 8000에서 OpenAI 호환 서버가 열립니다. 다만 현재 공개된 가중치는 Base 모델로, 텍스트를 이어서 생성하는 사전학습 체크포인트이지 채팅 모델이 아닙니다.
아래에서는 다운로드할 수 있는 것, 바이두가 안내하는 하드웨어 요구 사항, 정확한 serve 명령어, 엔드포인트 테스트 방법을 다룹니다. 아래의 모든 명령어와 수치는 2026년 11월 12일 기준으로 바이두의 Hugging Face 모델 카드와 vLLM-ERNIE 저장소에서 확인한 것입니다.
이 모델이 처음이라면 ERNIE 5.5 Flash란 무엇인가부터 읽어보세요. GPU 클러스터 없이 채팅 모델을 사용하고 싶다면 ERNIE 5.5 Flash API 가이드가 더 빠른 방법입니다.
지금 로컬에서 실행할 수 있는 것은?
Hugging Face에 FP8과 BF16 형식으로 공개된 ERNIE 5.5 Flash Base를 실행할 수 있습니다. 이 모델은 토큰당 14B 파라미터만 활성화되는 280B 파라미터 희소 MoE(Mixture-of-Experts) 모델로, 33.5조 토큰으로 학습되었습니다. 채팅용으로 튜닝된 ERNIE 5.5 Flash Preview는 아직 API 전용이며, 바이두는 가중치가 Apache 2.0 라이선스로 "곧" 공개될 것이라고 밝혔습니다.
두 릴리스를 셀프 호스팅 관점에서 비교하면 다음과 같습니다:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| 정체 | 사전학습 완료 시점의 체크포인트 | 첫 번째 포스트트레이닝(채팅, 추론, 에이전트) 모델 |
| 가중치 | Hugging Face와 ModelScope, FP8 및 BF16 | 2026년 11월 12일 기준 미공개 |
| 호출하는 엔드포인트 | /v1/completions (텍스트 이어쓰기) |
추론 및 도구를 지원하는 채팅 완성 |
| 라이선스 | ERNIE 5.5 Flash Base Model License v1.0 | 출시 시 Apache 2.0 예정 |
| 현재 사용처 | 자신의 GPU | Qianfan API, OpenRouter |
현재 바이두의 ERNIE-5.5-Flash 컬렉션에는 두 개의 Base 체크포인트만 있으며, vLLM-ERNIE README는 채팅 모델을 "Coming soon"으로 표시하고 있습니다. Preview 출시 공지에는 구체적인 날짜가 없습니다.
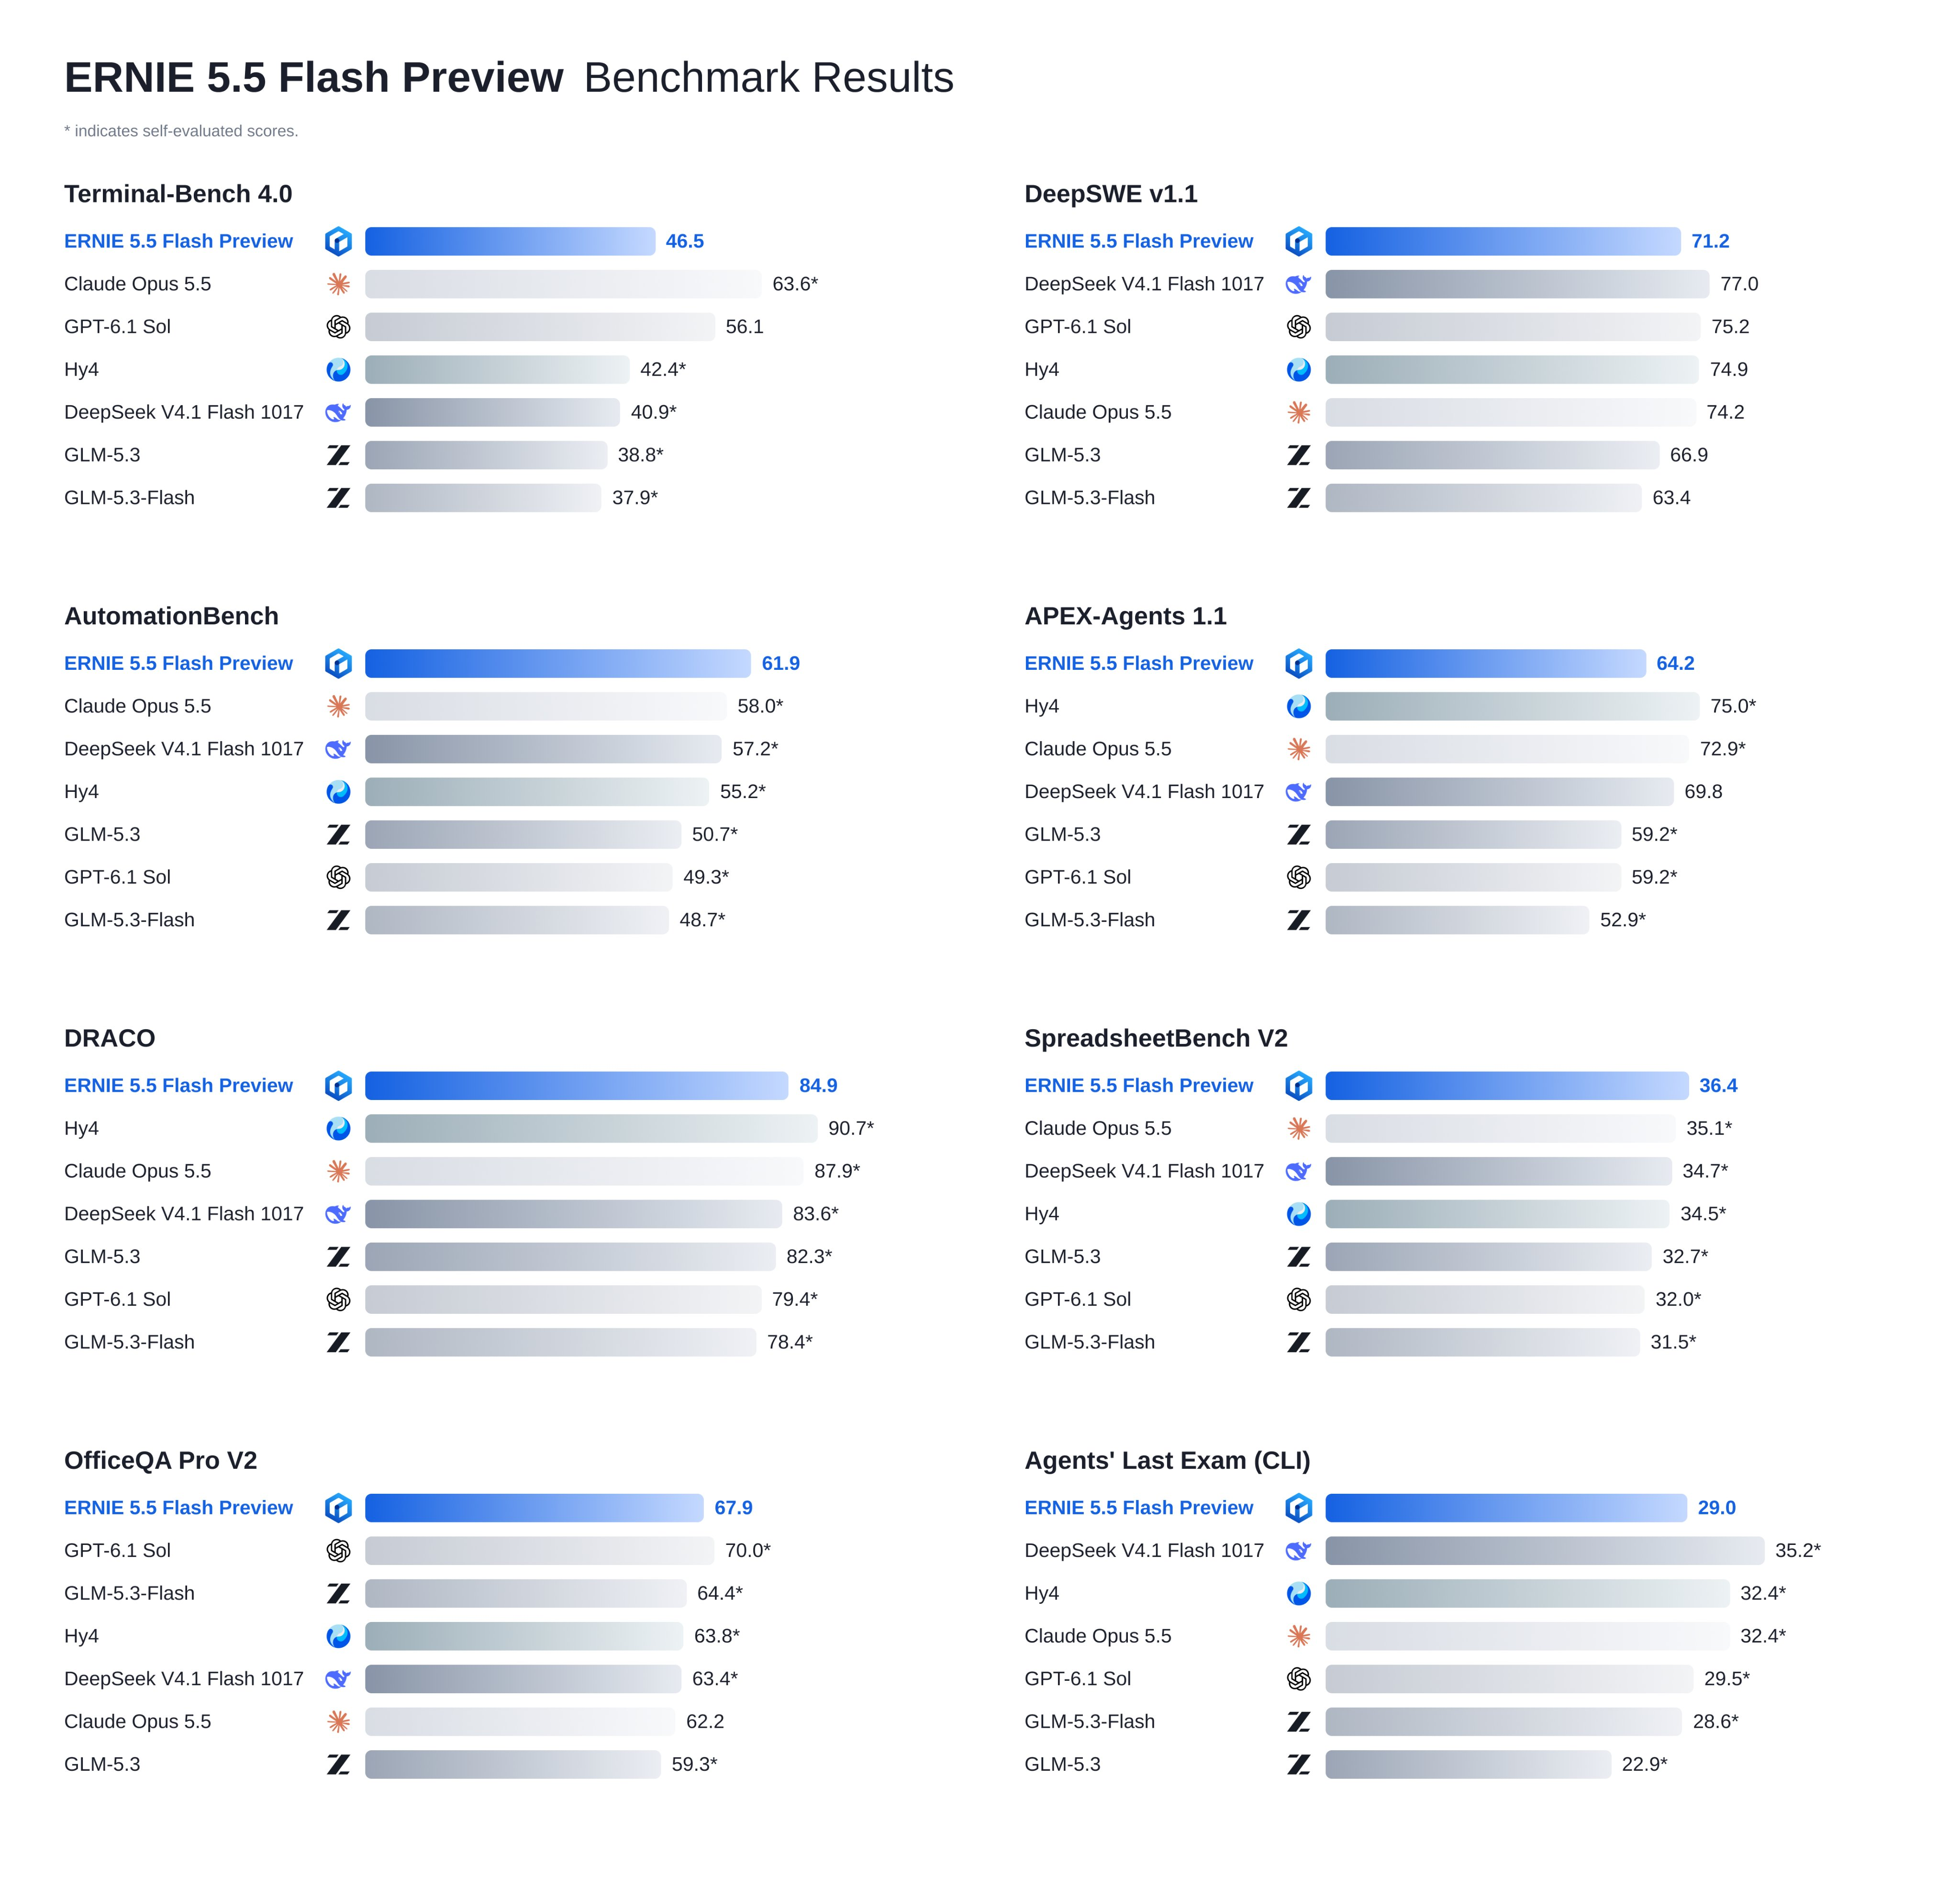
지금 당장 코딩 어시스턴트가 필요하다면 로컬 Base 모델로는 부족합니다. 반대로 파인튜닝이나 퓨샷(few-shot) 연구의 출발점이 필요하다면, 그것이 바로 Base 모델이 만들어진 목적입니다.
ERNIE 5.5 Flash 하드웨어 요구 사항
FP8 가중치는 약 280GB, BF16 가중치는 약 560GB의 GPU 메모리를 필요로 하므로, 노트북이 아니라 멀티 GPU 서버용 작업입니다. vLLM-ERNIE README는 가중치를 담을 수 있는 최소 GPU 수를 안내하며, 플러그인은 NVIDIA GPU에서만 실행됩니다.
| 카드당 GPU 메모리 | FP8 (가중치 약 280GB) | BF16 (가중치 약 560GB) |
|---|---|---|
| 288GB | 2 GPU | 4 GPU |
| 192GB | 4 GPU | 8 GPU (또는 2노드 x 4 GPU) |
| 80GB | 8 GPU | 2노드 x 8 GPU |
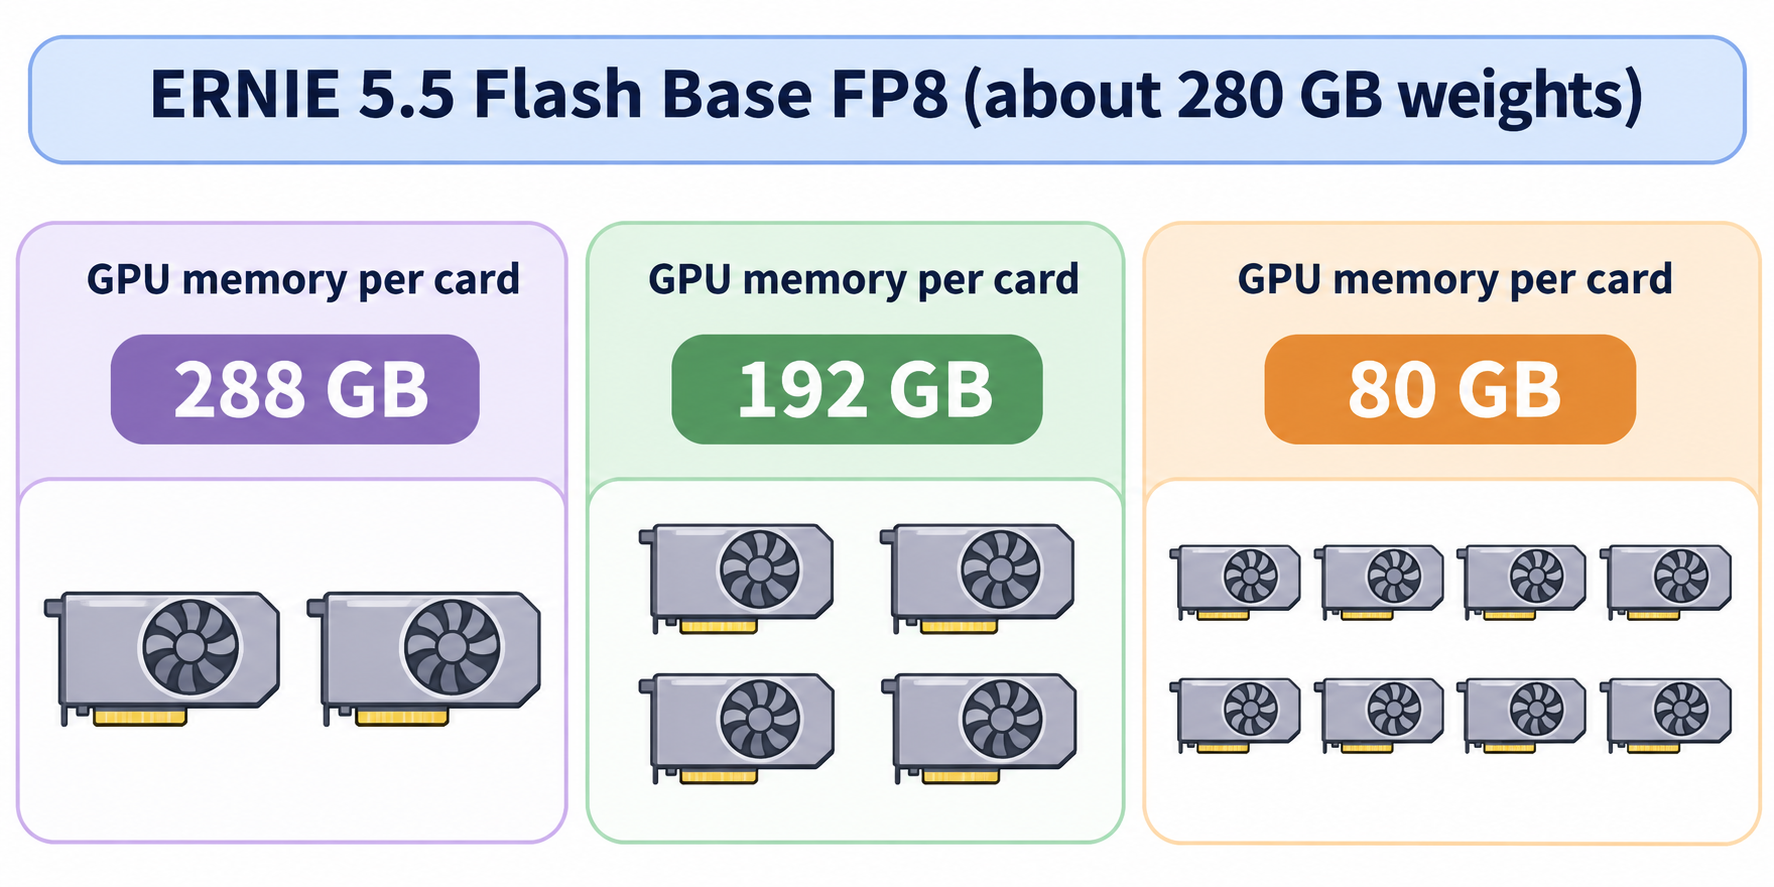
위 수치는 가중치를 로드하기 위한 최소 요건입니다. KV 캐시를 위한 공간이 추가로 필요하므로, 서비스 가능한 컨텍스트 길이는 사용하는 카드에 따라 달라집니다:
- 80GB GPU: GPU 8개에서
--data-parallel-size 8과--gpu-memory-utilization 0.93을 사용하여 FP8을 서비스합니다. 최대 262,144 토큰까지 가능하며, 100만 토큰은 불가능합니다. - 100만 토큰 컨텍스트: 바이두가 제시한 값은 184GiB 메모리 GPU 기준이며, 100만 토큰 프리필에 수십 GB의 임시 메모리가 필요하기 때문에 utilization을 0.85로 낮춥니다.
- 아키텍처가 중요합니다: FP8 명령어에는
--moe-backend humming이 포함되는데, 이는 Blackwell GPU에서 FP8 가중치와 함께 모델의 SiTU 활성화 함수를 지원합니다. Hopper GPU에서는 이 플래그를 빼고 vLLM의 기본 MoE 커널을 사용하세요.
여기서 "로컬"이란 직접 관리하는 하드웨어, 즉 임대한 8-GPU 노드, 온프레미스 서버 또는 연구실 클러스터를 의미합니다.
vLLM과 ERNIE 플러그인 설치
vLLM은 기본 상태로는 ERNIE 5.5 아키텍처(Ernie5_5_MoeForCausalLM)를 지원하지 않습니다. 바이두는 이를 플러그인 형태로 제공하며, 수정 없이 그대로 릴리스된 vLLM 0.32.0 휠 위에서 실행됩니다. Python 3.12 환경을 만들고 두 가지를 모두 설치하세요:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
플러그인은 모든 vLLM 프로세스에서 vLLM의 vllm.general_plugins 엔트리 포인트를 통해 로드됩니다. 이후 vllm serve가 Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported라는 메시지를 출력한다면, vllm을 실행하는 환경에 플러그인이 설치되어 있지 않거나, VLLM_PLUGINS가 설정되어 있는데 ernie가 포함되어 있지 않은 경우입니다.
Hugging Face 대신 ModelScope에서 가중치를 가져오려면 VLLM_USE_MODELSCOPE=True로 설정하세요. 두 허브에서 저장소 이름은 동일합니다. vLLM 자체가 처음이라면 vLLM 개요 문서에서 서버와 OpenAI 호환 API에 대해 설명합니다.
ERNIE 5.5 Flash용 vLLM serve 명령어
다음은 vLLM-ERNIE README에 있는 FP8 명령어로, 4-GPU 노드 1대에서 128K 학습 컨텍스트와 ECHO 스페큘러티브 디코딩을 켠 상태로 실행하는 것입니다:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
바이두의 설명에 따르면 각 선택지가 하는 일은 다음과 같습니다:
- 데이터 병렬 어텐션 + 엑스퍼트 병렬 MoE(
--data-parallel-size 4 --enable-expert-parallel)는 가장 많은 KV 캐시를 확보하고 가장 높은 처리량을 제공합니다. 텐서 병렬화(--tensor-parallel-size2, 4, 8)는 낮은 동시성에서 지연 시간을 줄이지만 KV 캐시는 더 적게 확보됩니다. - FP8 KV 캐시(
--kv-cache-dtype fp8)는 캐시를 FP8로 저장하며,auto는 BF16으로 유지합니다. - ECHO 스페큘러티브 디코딩은 모델 자체의 마지막 레이어를 내장 드래프트로 재사용합니다. 여기서는 2단계 드래프트를 사용하지만, 1단계나 3단계도 가능합니다.
--speculative-config를 빼면 드래프트 없이 서비스할 수 있습니다.
모델 카드에는 스페큘러티브 설정 없이 포트 30000을 사용하는 더 짧은 변형도 소개되어 있습니다.
보안 설정을 잊지 마세요. 이 명령어들은 인증 없이 0.0.0.0에 바인딩됩니다. 바이두의 README는 네트워크가 신뢰할 수 있는 환경이 아니라면 --api-key <key>를 추가하거나 127.0.0.1에 바인딩하라고 안내합니다. 포트를 외부에 노출하기 전에 둘 중 하나는 반드시 적용하세요.
BF16과 100만 토큰 컨텍스트
BF16은 두 대의 4-GPU 노드(DP8 + EP8)에서 --data-parallel-size 8, --data-parallel-size-local 4, --data-parallel-address ${HEAD_IP}, --data-parallel-hybrid-lb를 사용해 실행하며, 두 번째 노드에는 --data-parallel-start-rank 4를 추가합니다. 전체 명령어는 README에서 복사하세요. 노드 간 네트워크 인터페이스 설정도 포함되어 있습니다.
전체 1,048,576 토큰 창을 사용하려면 --max-model-len 1048576과 --gpu-memory-utilization 0.85를 지정하고, 각 랭크의 KV 캐시가 100만 토큰 요청 전체를 담을 수 있도록 --max-num-seqs를 낮추세요.
OpenAI 호환 엔드포인트 호출하기
vLLM은 OpenAI 스타일 라우트를 제공하지만, Base 모델에는 채팅 템플릿이 없으므로 원시 프롬프트로 /v1/completions를 호출해야 합니다. 퓨샷 방식으로 사용하려면 예시를 프롬프트에 넣고 답변 하나가 끝나는 지점에서 중단하도록 설정하세요:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
바이두의 README에 따르면 완성 텍스트로 36이 반환됩니다. 사람들이 자주 겪는 세 가지 함정이 있습니다:
- 그리디 디코딩을 위해서는
"temperature": 0을 명시적으로 전달하세요. 모델의generation_config.json은do_sample=false,temperature=1.0,top_p=0.95로 설정되어 있습니다. vLLM은 temperature와 top_p는 적용하지만do_sample은 무시하므로, 직접 재정의하지 않으면 샘플링이 발생합니다. <|ERNIE_MASK|>를 직접 넣지 마세요. 토크나이저가 완성 프롬프트에 자동으로 앞에 붙입니다(토큰 id 2).- 모델 이름을 정확히 맞추세요. BF16 가중치를 서비스할 때는
baidu/ERNIE-5.5-Flash-Base-BF16을 사용하세요.
base_url을 http://<host>:8000/v1로 지정하고 채팅 완성이 아닌 완성(completions)을 호출하면 어떤 OpenAI SDK든 사용할 수 있습니다.
Base vs Preview: 무엇을 사용해야 할까?
이 위에서 추가 학습을 할 계획이라면 Base를, 지금 당장 동작하는 어시스턴트가 필요하다면 Preview를 사용하세요. Base는 완전한 제어권과 서버 밖으로 절대 나가지 않는 데이터를 제공합니다. Preview는 채팅, 추론, 도구 호출 기능을 제공하지만 Qianfan 또는 OpenRouter를 통해서만 가능합니다.
Preview 가중치가 공개되면 플러그인은 이미 대비되어 있습니다. README에는 "Coming soon"으로 표시된 추가 플래그들이 문서화되어 있습니다: --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice와 스페큘러티브 디코딩용 DSpark 드래프트 모델이 그것입니다. 추론 과정은 reasoning_content로, 도구 호출은 message.tool_calls로 반환되므로, 오늘 구축한 같은 서버가 가중치 교체와 세 개의 플래그만으로 채팅 백엔드가 됩니다.
라이선스도 다른 차이점입니다. Base는 Apache 2.0이 아닌 ERNIE 5.5 Flash Base Model License Agreement v1.0으로 배포됩니다. 이를 기반으로 제품을 만들기 전에 전체 라이선스를 읽어보세요. 2026년 11월 12일 기준 내용은 다음과 같습니다:
- 비상업적 사용은 별도 통지 없이 무료입니다.
- 연간 매출이 미화 5,000만 달러 이하인 관련 제품의 상업적 사용은 라이선스 비용이 무료이지만, "Powered by ERNIE" 표시와 바이두에 대한 일회성 통지가 필요합니다.
- 연간 5,000만 달러를 초과하는 경우 바이두의 별도 서면 승인이 먼저 필요합니다.
- 라이선스의 "Territory(적용 지역)"에는 유럽 연합, 영국, 한국이 포함되지 않습니다.
더 적은 GPU로 셀프 호스팅할 수 있는 소형 오픈 웨이트 모델이 필요하다면 GLM-5.3 셀프 호스팅 가이드를 참고하세요.
Apidog CLI로 코딩 에이전트에게 엔드포인트 테스트 맡기기
새로 구축한 vLLM 배포에는 플래그를 바꿀 때마다 재실행할 수 있는 스모크 테스트, 즉 상태 코드, 응답 스키마, 초당 토큰 수 확인이 필요합니다. curl을 반복해서 입력하는 대신 코딩 에이전트와 Apidog CLI에 맡기세요.
CLI를 한 번만 설정하면 됩니다:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그런 다음 Claude Code, Codex 또는 Cursor에 프롬프트 하나를 입력하세요:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
에이전트가 페이로드 스키마를 읽고, 검증하고, 테스트 케이스를 작성한 뒤 실행합니다:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
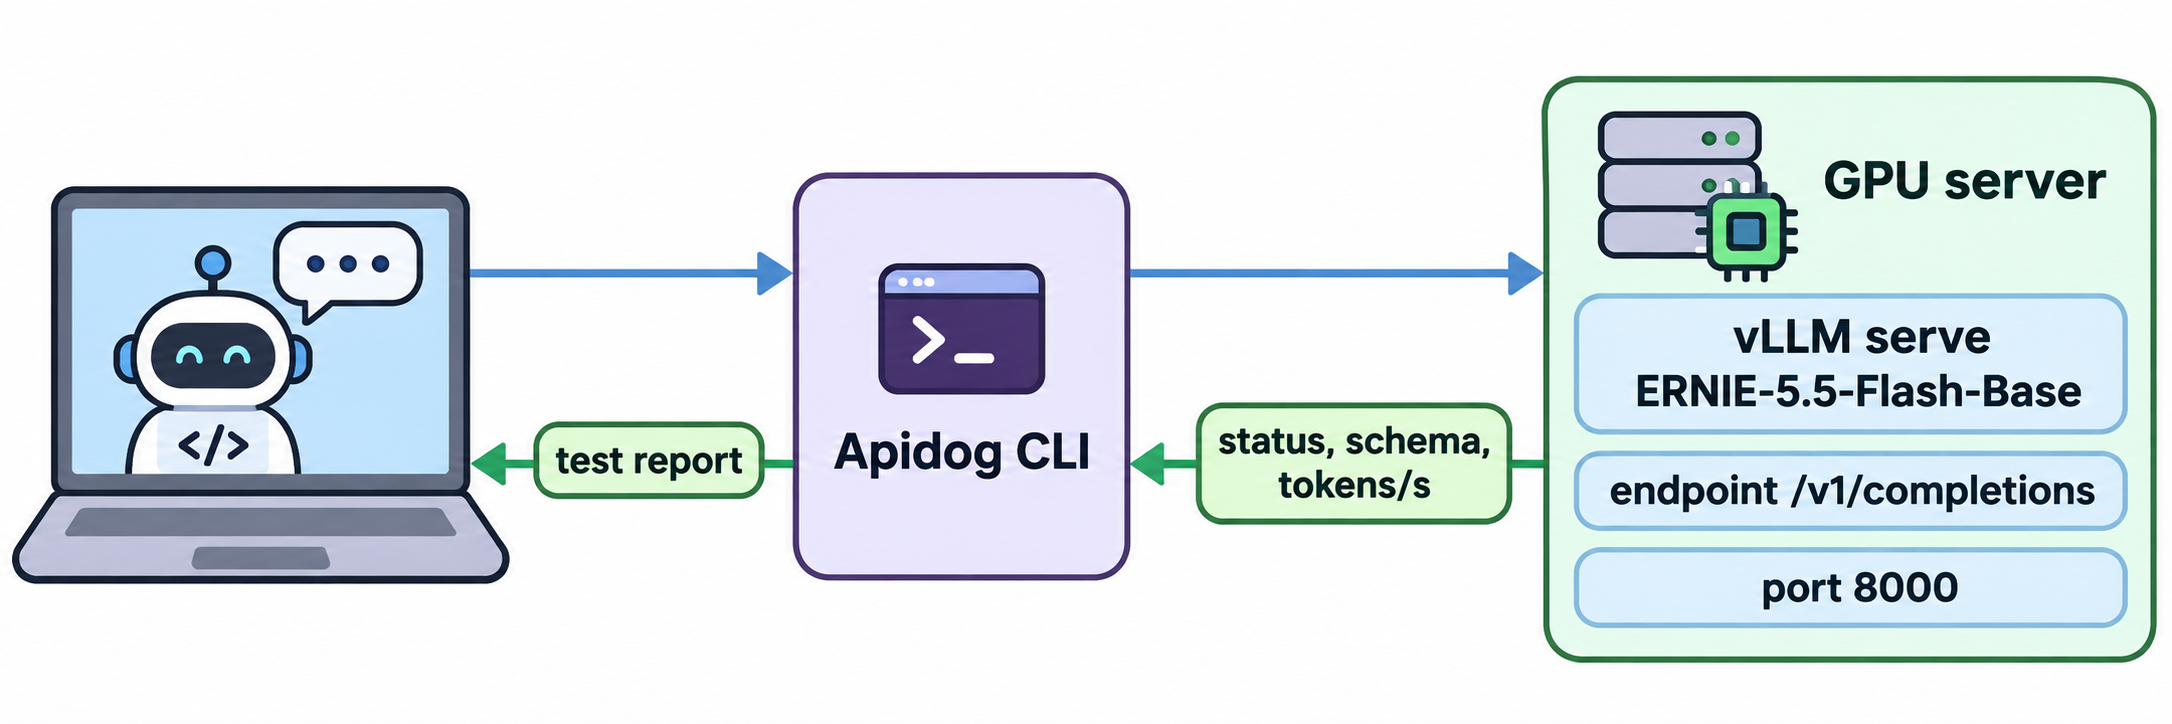
CLI는 포트 8000에 접근할 수 있는 머신에서 실행하세요. 서버에 --api-key를 설정했다면, 에이전트에게 이를 환경 변수로 저장하고 Bearer 토큰으로 전송하도록 지시하세요. --tensor-parallel-size를 변경하거나, 스페큘러티브 디코딩을 끄거나, --max-model-len을 늘린 후 같은 테스트 케이스를 다시 실행하면 동일 조건 비교가 가능합니다. -r junit을 추가하면 같은 실행 결과를 CI에 넣을 수 있습니다. 에이전트 설정 방법을 단계별로 알고 싶다면 Claude Code에서 Apidog CLI 사용하기를 참고하세요. Apidog Free 플랜은 최대 4명의 사용자까지 지원합니다.
FAQ
소비자용 GPU 한 장으로 ERNIE 5.5 Flash를 실행할 수 있나요? 아니요. FP8 가중치는 약 280GB이며, 바이두가 안내하는 최소 구성은 288GB GPU 2장입니다. 80GB 카드라면 8장이 필요합니다. 해당 하드웨어가 없다면 API를 통해 Preview를 사용하세요.
ERNIE 5.5 Flash Preview 가중치는 사용할 수 있나요? 2026년 11월 12일 기준으로는 아직입니다. 바이두는 곧 Apache 2.0으로 오픈소스화할 것이라고 밝혔으며, vLLM-ERNIE 플러그인은 채팅 모델을 "Coming soon"으로 표시하고 있습니다. 현재 Hugging Face에는 Base 가중치(FP8 및 BF16)만 있습니다.
Base 모델에서 /v1/chat/completions가 실패하는 이유는? Base에는 채팅 학습도 채팅 템플릿도 없습니다. 바이두는 원시 텍스트 프롬프트로 /v1/completions를 통해 이를 서비스합니다. 프롬프트에 퓨샷 예시를 넣고 stop 시퀀스를 사용하세요.
vLLM은 ERNIE 5.5를 기본 지원하나요? vLLM 코어에는 포함되어 있지 않습니다. vLLM 0.32.0 위에 바이두의 vLLM-ERNIE 플러그인이 필요하며, NVIDIA GPU에서만 실행됩니다. SGLang도 모델 카드에 명시된 전용 Docker 이미지를 통해 이 모델을 서비스할 수 있습니다.
ERNIE 5.5 Flash Base를 상업적으로 사용할 수 있나요? 네, 조건부로 가능합니다. 연간 매출이 미화 5,000만 달러 이하인 제품은 "Powered by ERNIE" 표시와 바이두에 대한 일회성 통지만으로 라이선스 비용 없이 사용할 수 있습니다. 그 이상은 서면 승인이 필요하며, 라이선스 적용 지역에서는 EU, 영국, 한국이 제외됩니다.