
GPU 없이 llama-modchip을 사용하면 DeepSeek V4 Flash를 로컬에서 실행할 수 있습니다. llama-modchip은 llama.cpp 패치를 모아놓은 오픈소스로, 284B 모델을 가중치당 1.71비트로 압축해 56.56 GiB GGUF로 줄여줍니다. 64GB RAM을 탑재한 16코어 AMD Zen 5 노트북 칩에서 프리필(prefill)은 초당 약 44 토큰, 디코드는 초당 9~15 토큰 속도가 나오며 스왑은 전혀 발생하지 않습니다.
이 가이드에서는 필요한 하드웨어, 실행 명령어, 품질 트레이드오프, 그리고 코딩 에이전트로 로컬 엔드포인트를 테스트하는 방법까지 다룹니다.
llama-modchip이 실제로 하는 일
llama-modchip은 희소 Mixture-of-Experts 모델을 시스템 RAM만으로 완전히 구동할 수 있게 해주는 ggml 및 llama.cpp 커널 패치, 양자화 트랜스코더, 런타임 도구 모음입니다. v2.4.0 릴리스는 두 가지 모델 크기를 지원합니다. 64GB 머신에서 284B DeepSeek-V4-Flash, 16~32GB 머신에서 30B MoE 모델입니다.
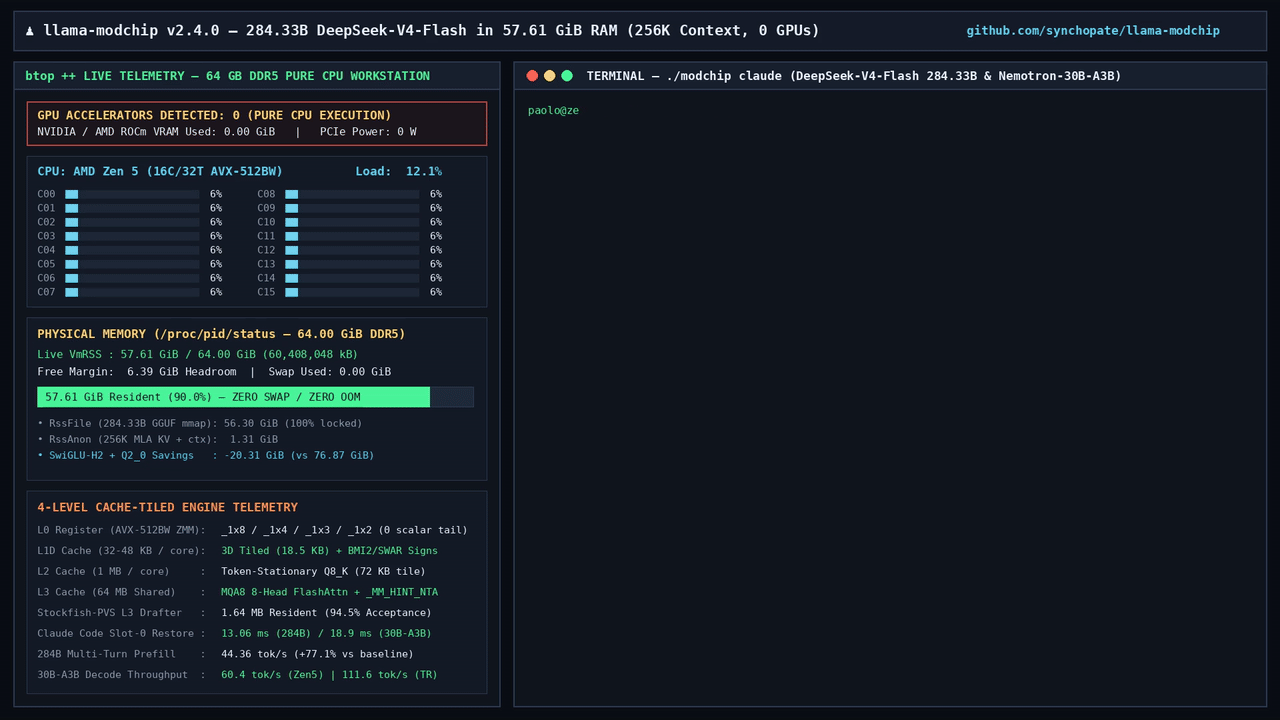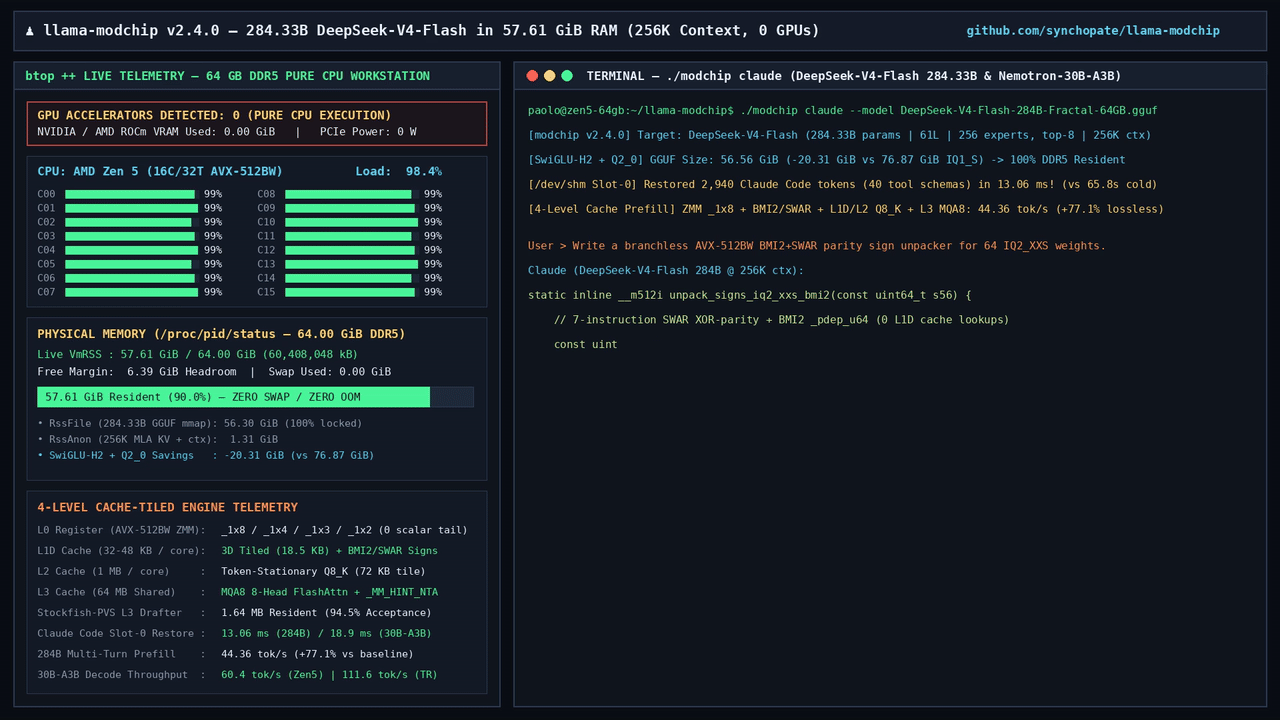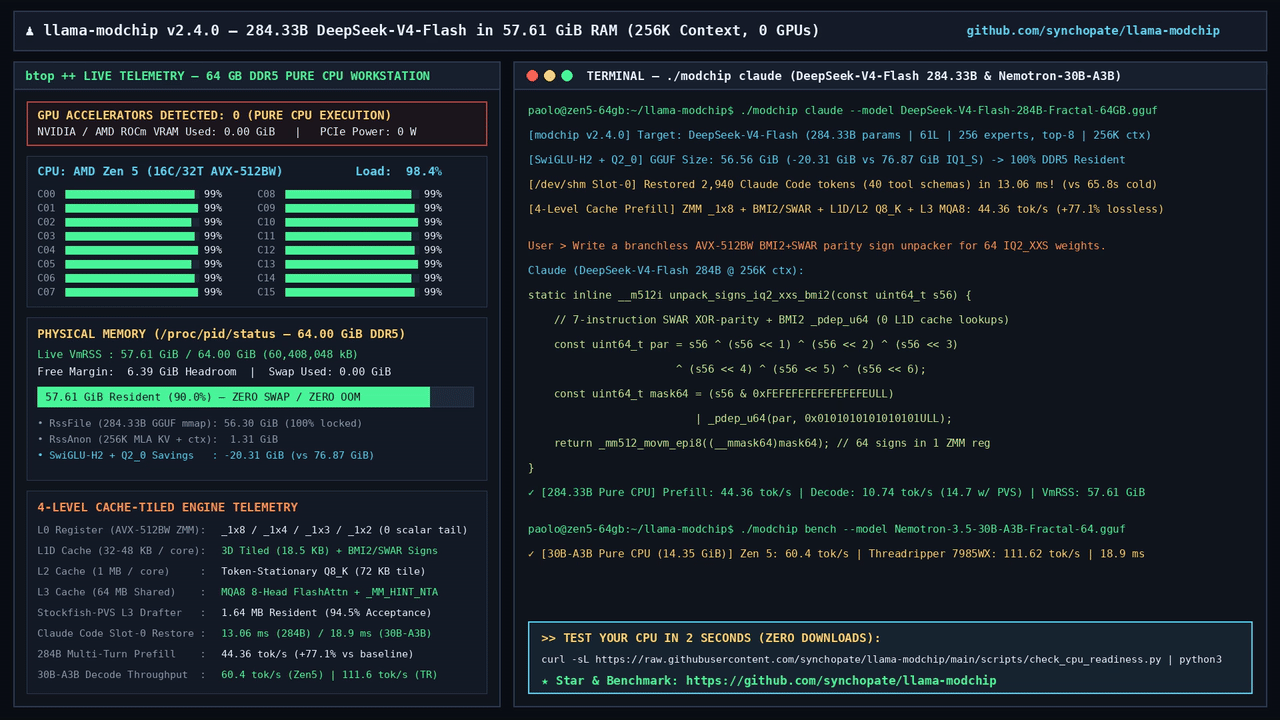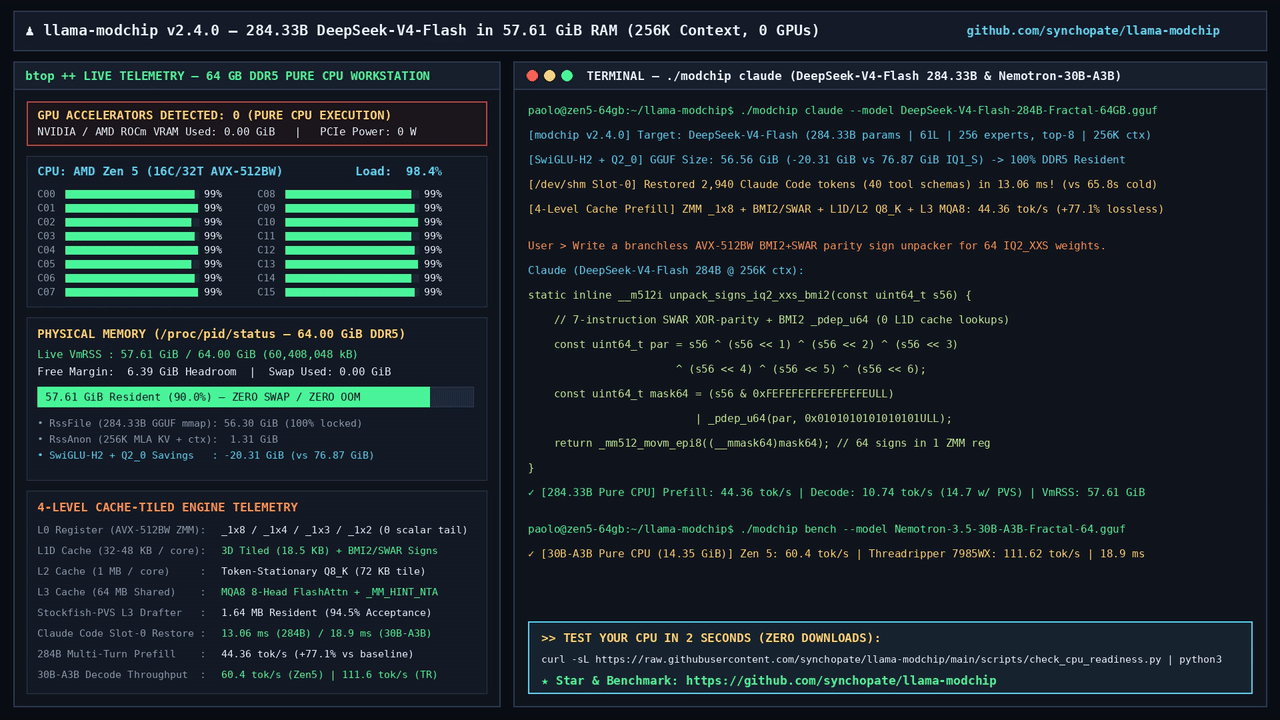
이 프로젝트는 2026년 11월 8일 Hacker News에 게시되어 370포인트를 넘었습니다. 저장소는 Apache 2.0 라이선스로 배포됩니다.
284B 모델이 64GB에 들어갈 수 있는 비결은 세 가지입니다:
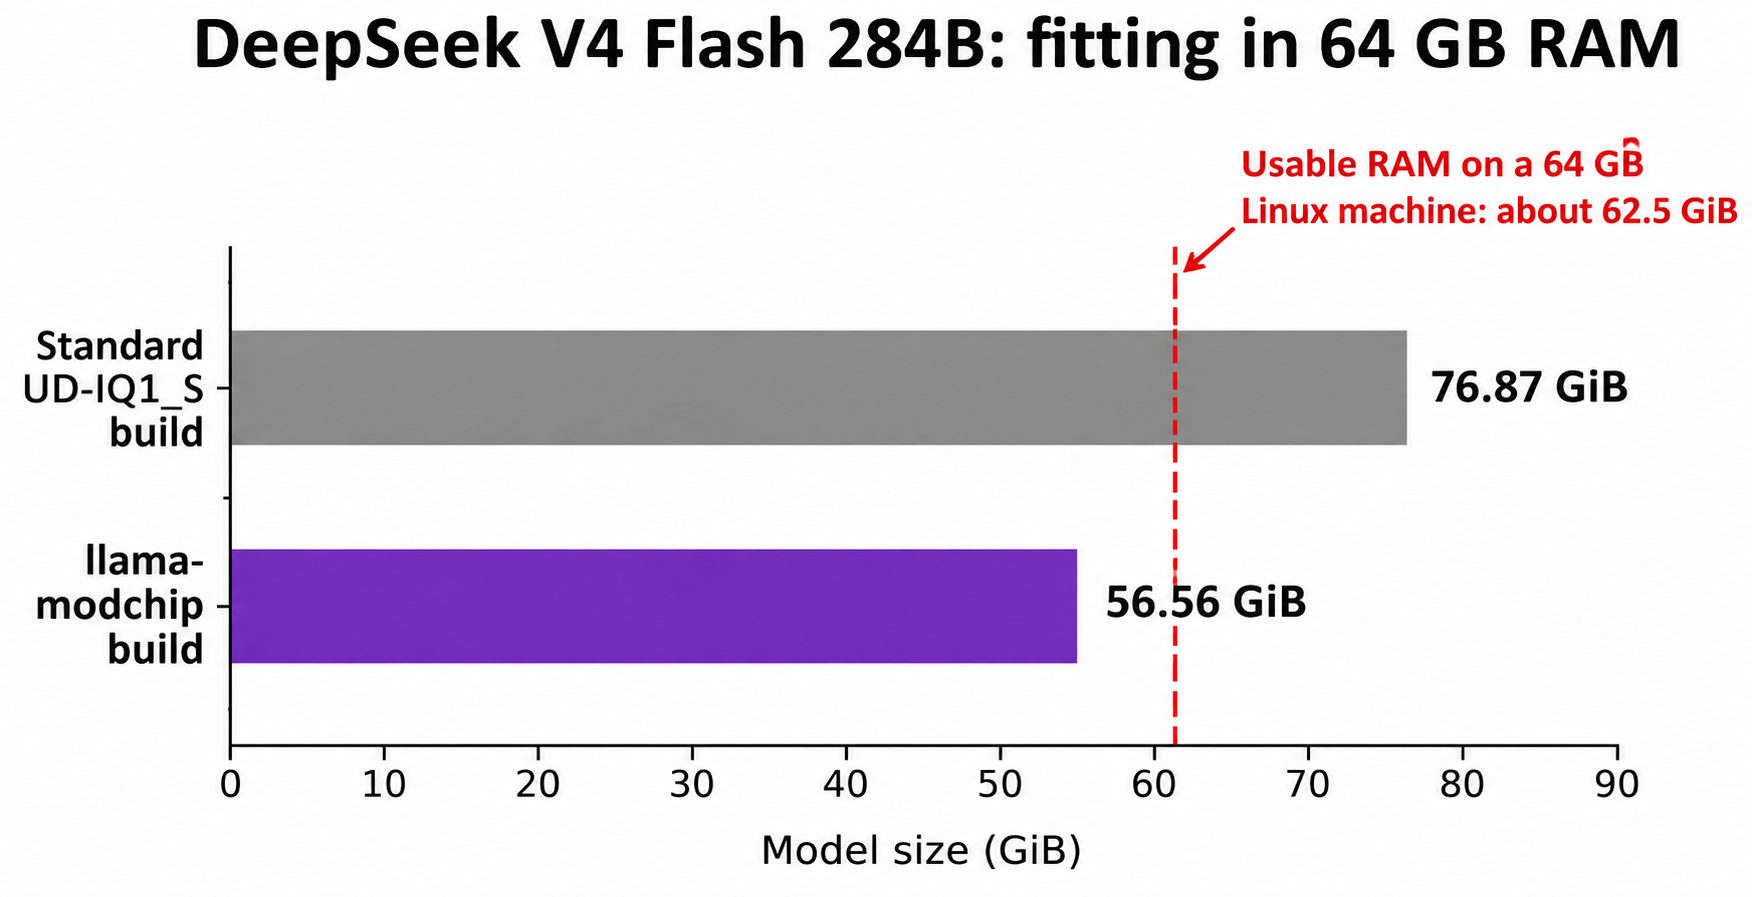
- 더 작은 체크포인트. 표준 Unsloth
UD-IQ1_S빌드는 76.87 GiB로, 64GB 리눅스 머신에서 실제 사용 가능한 약 62.5 GiB를 초과합니다. llama-modchip은 이를 56.56 GiB로 트랜스코딩합니다. - CPU 캐시 타일링. 프리필 커널이 작업을 레지스터와 L1~L3 캐시에 걸쳐 타일링하여 16코어 Zen 5에서 초당 25.0~44.36 토큰, 즉 77%의 성능 향상을 얻습니다.
- 자체 스페큘러티브 디코딩. 1.64 MB 크기의 n-gram 드래프터가 디코드 속도를 초당 약 9에서 최대 14.7 토큰까지 끌어올립니다.
기본 설정에서는 모든 레이어에서 라우팅된 6개 전문가와 공유 전문가가 모두 실행되므로 어떤 것도 프루닝되지 않습니다.
DeepSeek V4 Flash를 로컬에서 실행하기 위한 하드웨어
시스템 RAM 64GB와 최신 x86_64 CPU, 가급적이면 AVX-512를 지원하는 CPU가 필요합니다. 이 가이드의 284B 관련 수치는 모두 관리자가 한 대의 머신에서 측정한 것입니다. AMD Ryzen 9 9955HX(16코어, 32스레드, 64MB L3)에 64GB DDR5를 장착한 리눅스 머신이며, GPU는 없습니다.
| 내 머신 | RAM | README에서 함께 소개하는 모델 | 보고된 속도 (GPU 0개) |
|---|---|---|---|
| 노트북 또는 미니 PC | 16~32GB | Nemotron-3.5-30B-A3B, 14.35 GiB | 25.0~60.4 tok/s |
| 데스크톱 또는 서버 | 64GB | DeepSeek-V4-Flash 284B, 56.56 GiB | 프리필 44.4 tok/s, 디코드 9.1~14.7 tok/s |
| 8채널 워크스테이션 | 128GB 이상 | DeepSeek 284B 또는 Nemotron 30B | 111.62 tok/s (30B 한정) |
- 메모리 사용량은 256K 컨텍스트에서 57.61~58.9 GiB로 정점을 찍으며, 사용 가능 한도인 62.5 GiB 이하입니다. 모델을 로드하기 전에 다른 프로그램은 모두 종료하세요.
- 프리빌트 바이너리는 리눅스 x86_64 전용입니다 (
llama-server-modchip-linux-x86_64)../modchip셋업 스크립트는 리눅스와 macOS를 지원합니다. README의 Apple Silicon 결과는 284B가 아닌 30B 모델 기준입니다. 64GB Mac에서 284B가 구동되는지는 [VERIFY]가 필요합니다. - 메모리 대역폭이 상한선입니다. FAQ에 따르면 8채널 또는 12채널 서버 보드는 듀얼채널 DDR5 대비 디코드 속도가 대략 3~4배까지 확장됩니다.
저장소에는 모델을 다운로드하지 않는 준비 상태 확인 스크립트가 포함되어 있습니다:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
파이프로 Python에 넘기기 전에 스크립트 내용을 먼저 확인하세요.
GPU 없이 DeepSeek V4 Flash 실행하기, 단계별 가이드
방법 1: 가이드형 셋업
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat은 실시간 토큰 속도를 보여주는 터미널 채팅을 엽니다. 그 외 하위 명령어:
| 명령어 | 기능 |
|---|---|
./modchip web |
http://127.0.0.1:8787에서 웹 채팅 및 텔레메트리 제공 |
./modchip bench |
공유 가능한 스코어카드와 함께 30초 속도 테스트 실행 |
./modchip claude |
로컬 엔진에 연결된 Claude Code 실행 |
./modchip status / stop |
준비 상태 확인 또는 백그라운드 서비스 중지 |
방법 2: 직접 서버 실행
이 방법은 Hugging Face 저장소에서 GGUF와 프리빌트 서버를 받아 포트 8080에서 실행합니다:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
-t는 물리 코어 수로 설정하세요. 예시는 32K 컨텍스트를 사용하며, 256K 수치는 -c 262144를 사용할 때의 값입니다.
주의할 함정이 하나 있습니다. 기본 llama.cpp, Ollama, LM Studio는 이 파일을 로드할 수 없습니다. 체크포인트가 커스텀 텐서 타입(ID 40)을 사용하기 때문에, 패치되지 않은 빌드는 unknown tensor type 40 오류로 실패합니다. ./modchip 스크립트나 번들된 바이너리를 사용하세요.
이 서버는 패치된 llama.cpp llama-server이므로 OpenAI 스타일의 /v1/chat/completions 라우트를 지원합니다:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
8787 포트의 게이트웨이
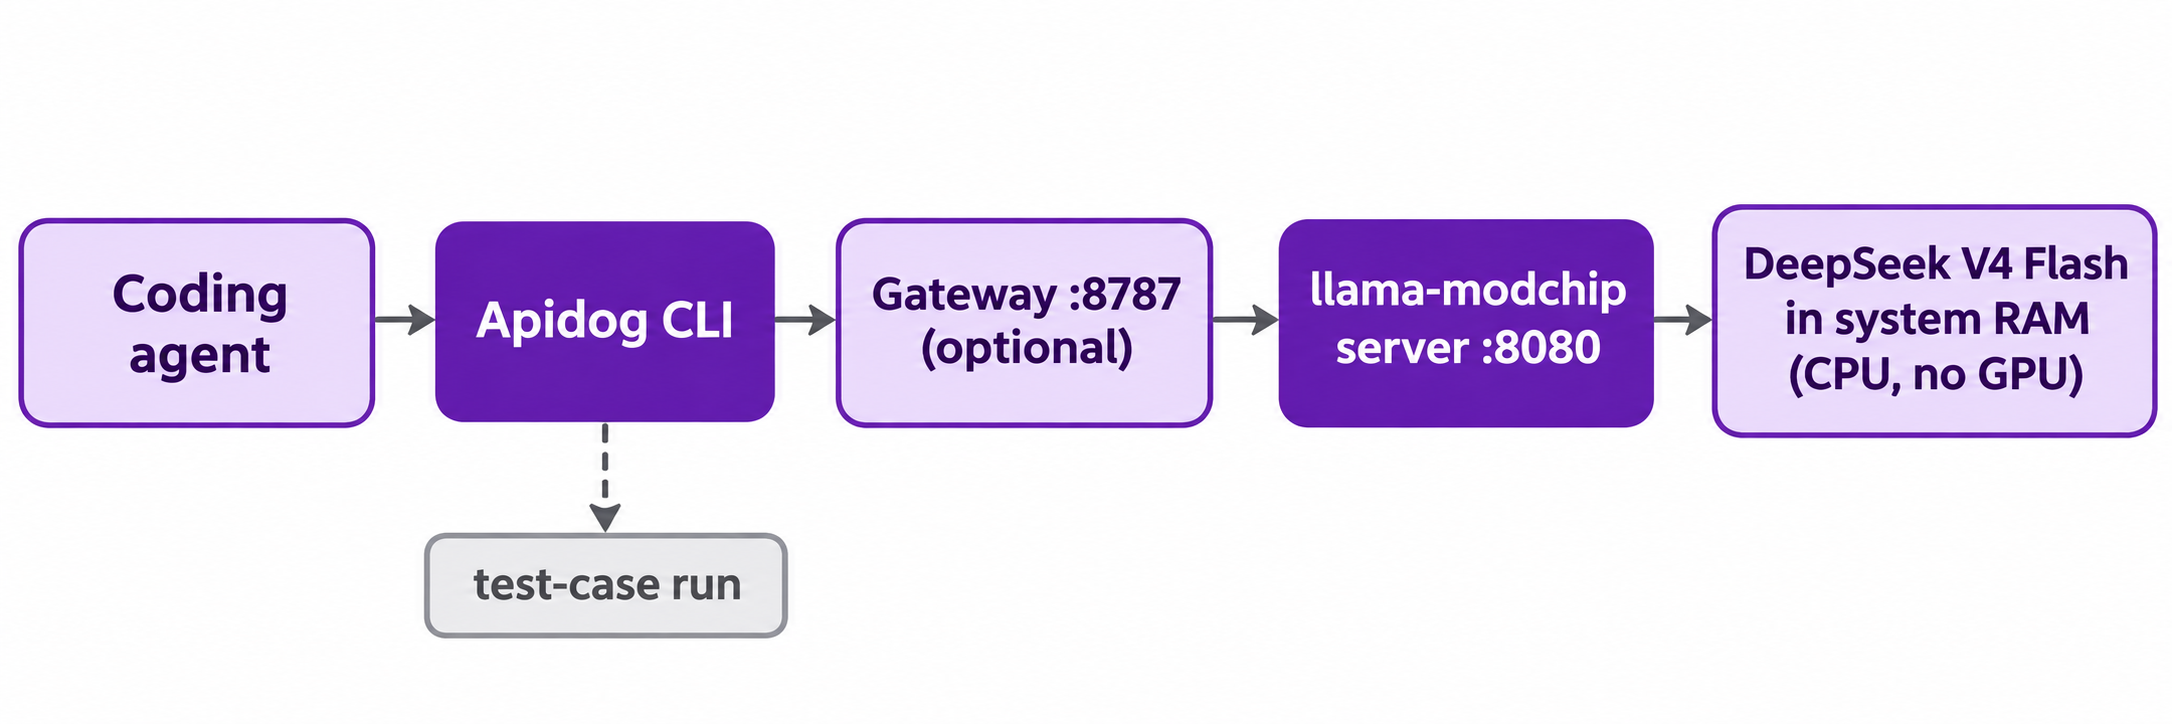
gateway/sse_gateway.py는 127.0.0.1:8787에서 동작하며 엔진으로 요청을 전달하는 프록시입니다(업스트림은 LLAMA_BACKEND_URL로 설정). /v1/chat/completions, /v1/messages, /v1/models, /health 엔드포인트를 제공합니다. GATEWAY_API_KEY를 설정하면 베어러 토큰이 필요해집니다. ./modchip claude는 Claude Code를 이 게이트웨이로 연결합니다.
속도와 품질: 가중치당 1.71비트의 대가
속도 수치는 실제이지만 특정 환경에 한정된 값입니다. Ryzen 9 9955HX에서 256K 컨텍스트로 측정한 DeepSeek-V4-Flash 관리자 표입니다:
| 구성 | 프리필 | 디코드 | 드래프터 사용 시 디코드 |
|---|---|---|---|
패치 없는 UD-IQ1_S (76.87 GiB) |
64GB에서 OOM 또는 스왑 발생 | 5.91 tok/s | N/A |
| v2.4.0 기본값 (Top-6, 56.56 GiB) | 43.16~44.36 tok/s | 9.06~9.95 tok/s | 11.5~14.7 tok/s |
| 후반 레이어에 Top-5 적용 | 43.16~44.36 tok/s | 9.68~9.87 tok/s | 12.2~15.1 tok/s |
| Top-4 + gate-first SwiGLU | 43.16~44.36 tok/s | 10.12~10.74 tok/s | 13.0~16.0 tok/s |
LLAMA_MOE_TOP_K=5 또는 4로 설정하면 더 빠른 행으로 전환됩니다. README에 따르면 Top-5는 자체 기본값 대비 퍼플렉시티를 약 0.42% 높입니다.
Hacker News에서 반복적으로 제기된 두 가지 유의점:
- "무손실"은 1.71 bpw 파일 기준으로 무손실이라는 뜻이지, 원본 가중치 대비 무손실이 아닙니다. 1.00000 코사인 유사도는 압축된 동일한 체크포인트에서 패치 적용 런타임과 미적용 런타임을 비교한 것이며, 대부분의 라우팅 전문가는
IQ1_S(약 1.56비트)로 양자화되어 있습니다. 댓글 작성자들은 4비트 이하에서 품질이 보통 떨어진다고 지적했고, README에는 전체 정밀도 출력과의 비교가 없습니다. - 에이전트에게는 프리필이 병목입니다. 초당 44 토큰 속도라면 10,000 토큰 프롬프트는 첫 출력 토큰이 나오기까지 약 225초가 걸립니다. KV 스냅샷(40개 도구를 사용하는 Claude Code 프롬프트 기준 복원에 13.1~32.6 ms)은 반복 대화에서는 도움이 되지만, 새로운 컨텍스트에서는 도움이 되지 않습니다.
한 가지 더: 이것은 7월의 0731 V4-Flash 체크포인트입니다. DeepSeek은 이후 V4.1 Flash를 출시했습니다. 최신 가중치가 중요하다면 먼저 DeepSeek V4.1 Flash와 V4 Pro, V4 Flash 비교를 읽어보세요.
로컬 284B 모델은 초안 작성, 배치 작업, 실험용으로 쓰는 비공개 오프라인 모델로 취급하고, 실제 사용 전에 본인의 프롬프트로 먼저 테스트해 보세요.
Apidog CLI로 코딩 에이전트가 로컬 엔드포인트를 테스트하게 하기
로컬 모델도 결국 API입니다. 응답하는지, JSON이 유효한지, 마지막 플래그 변경으로 무언가가 깨지지 않았는지 확인해야 합니다. 코딩 에이전트는 Apidog CLI로 이런 검증을 수행할 수 있으며, Apidog CLI는 로컬 머신에서 실행되고 127.0.0.1에 직접 접근합니다. 한 번만 설정하면 됩니다:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill install은 Apidog 스킬을 추가해 에이전트가 명령어들을 알 수 있게 합니다. 그다음 에이전트(예: Claude Code)에 프롬프트 하나를 주세요:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
에이전트는 스키마를 읽고 페이로드를 검증한 뒤 다음을 작성하고 실행합니다:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request(밀리초) 설정이 중요합니다: CPU 기반 284B 모델은 기본 타임아웃을 넘길 만큼 느립니다.
이 방식의 진짜 장점은 비교입니다. 두 번째 환경을 DeepSeek 호스팅 API로 향하게 하고 동일한 테스트 케이스를 실행하면, 로컬 양자화 모델이 어디서 어긋나는지 확인할 수 있습니다. --upload-report를 추가하면 앱에서 실행 결과를 볼 수 있습니다. Claude Code에서의 Apidog CLI와 Apidog CLI 설치 가이드도 참고하세요. Apidog의 무료 플랜은 최대 4명까지 사용할 수 있습니다.
로컬 CPU vs GPU vs 호스팅 API
| 옵션 | 필요한 것 | 적합한 용도 |
|---|---|---|
| CPU에서 llama-modchip | 64GB RAM, 최신 x86_64 CPU | 느린 프리필을 감수하면 API 비용 없이 비공개 오프라인 작업 가능 |
| vLLM 또는 SGLang으로 GPU 서빙 | 대용량 VRAM 또는 멀티 GPU 머신 | 빠르고 더 높은 정밀도의 셀프호스팅 |
| DeepSeek 호스팅 API | API 키 | 프로덕션 수준의 속도로 최고 품질 출력 |
GPU 방식에 대해서는 vLLM과 SGLang을 다루는 DeepSeek V4 로컬 실행 방법을 참고하세요. 최신 체크포인트의 메모리 계산은 DeepSeek V4.1 Flash 로컬 실행 방법에서 확인할 수 있습니다. 모든 로컬 모델을 API로 테스트하는 방법은 로컬 LLM을 API로 테스트하기를 참고하세요.
FAQ
정말 GPU 없이 DeepSeek V4 Flash를 실행할 수 있나요?
네, llama-modchip과 64GB RAM이 있으면 가능합니다. 관리자는 16코어 Ryzen 9 9955HX에서 56.56 GiB 모델 전체를 RAM에 올리고 스왑 없이 프리필 초당 44.36 토큰, 디코드 초당 9~15 토큰을 보고했습니다.
Ollama나 LM Studio에서도 작동하나요?
아니요. 체크포인트가 커스텀 텐서 타입을 사용하기 때문에, 패치되지 않은 llama.cpp, Ollama, LM Studio는 unknown tensor type 40 오류로 거부합니다. 저장소의 ./modchip 스크립트나 번들된 llama-server-modchip-linux-x86_64 바이너리를 사용하세요.
RAM이 16GB나 32GB뿐이라면?
대신 30B MoE 모델을 실행하세요. README는 이 등급에 14.35 GiB 파일인 Nemotron-3.5-30B-A3B를 소개하며 CPU에서 초당 25.0~60.4 토큰을 보고합니다.
가중치당 1.71비트에서 출력 품질은 어느 정도인가요?
이 프로젝트는 전체 정밀도 DeepSeek과의 비교를 제공하지 않으며, Hacker News 댓글 작성자들도 이 크기에 회의적이었습니다. 실제 의존하기 전에 호스팅 API와 비교해 본인의 프롬프트를 테스트해 보세요.
로컬 서버는 OpenAI 호환인가요?
네. 패치된 llama.cpp llama-server이므로 8080 포트에서 /v1/chat/completions가 작동합니다. 8787 포트의 선택적 게이트웨이는 Claude Code가 사용하는 Anthropic 스타일 라우트인 /v1/messages도 제공합니다.
코딩 에이전트가 로컬 모델을 자동으로 테스트하게 할 수 있나요?
네. Apidog CLI를 설치하고 apidog skill install을 실행한 뒤, 에이전트에게 http://127.0.0.1:8080을 가리키는 환경과 /v1/chat/completions용 테스트 케이스를 만들어 달라고 요청하면 됩니다. 그러면 에이전트가 apidog test-case run을 실행하고 실패 내역을 보고합니다.