
Qwen4-Max 벤치마크 한 줄 요약: 알리바바의 차트에 따르면 Qwen4-Max는 두 모델이 함께 등장하는 15개 테스트 전부에서 Qwen3.8-Max를 앞서며, 16개 중 4개에서 전체 1위를 차지합니다. 다만 이 수치 대부분은 알리바바 자체 측정 결과입니다. Work360에서는 47.74 대비 52.69를 기록했고, 작업당 평균 비용은 $4.43에서 $1.67로 감소했습니다.
벤치마크는 "누가, 어떻게 측정했는가"에 대한 답이 있어야만 의미가 있습니다. 이 가이드는 알리바바가 2026년 11월 16일에 발표한 모든 점수를 다루고, 자체 측정 결과와 제3자 측정 결과로 구분한 뒤, Qwen4-Max API를 대상으로 직접 검증을 수행하는 방법으로 마무리합니다. 기본 내용은 Qwen4-Max란 무엇인가와 이용 방법 문서에서 시작하세요.
Qwen4-Max 벤치마크 점수 한눈에 보기
알리바바의 출시 포스트는 Qwen4-Max를 Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra, Kimi K3.1과 16개 벤치마크에서 비교합니다.
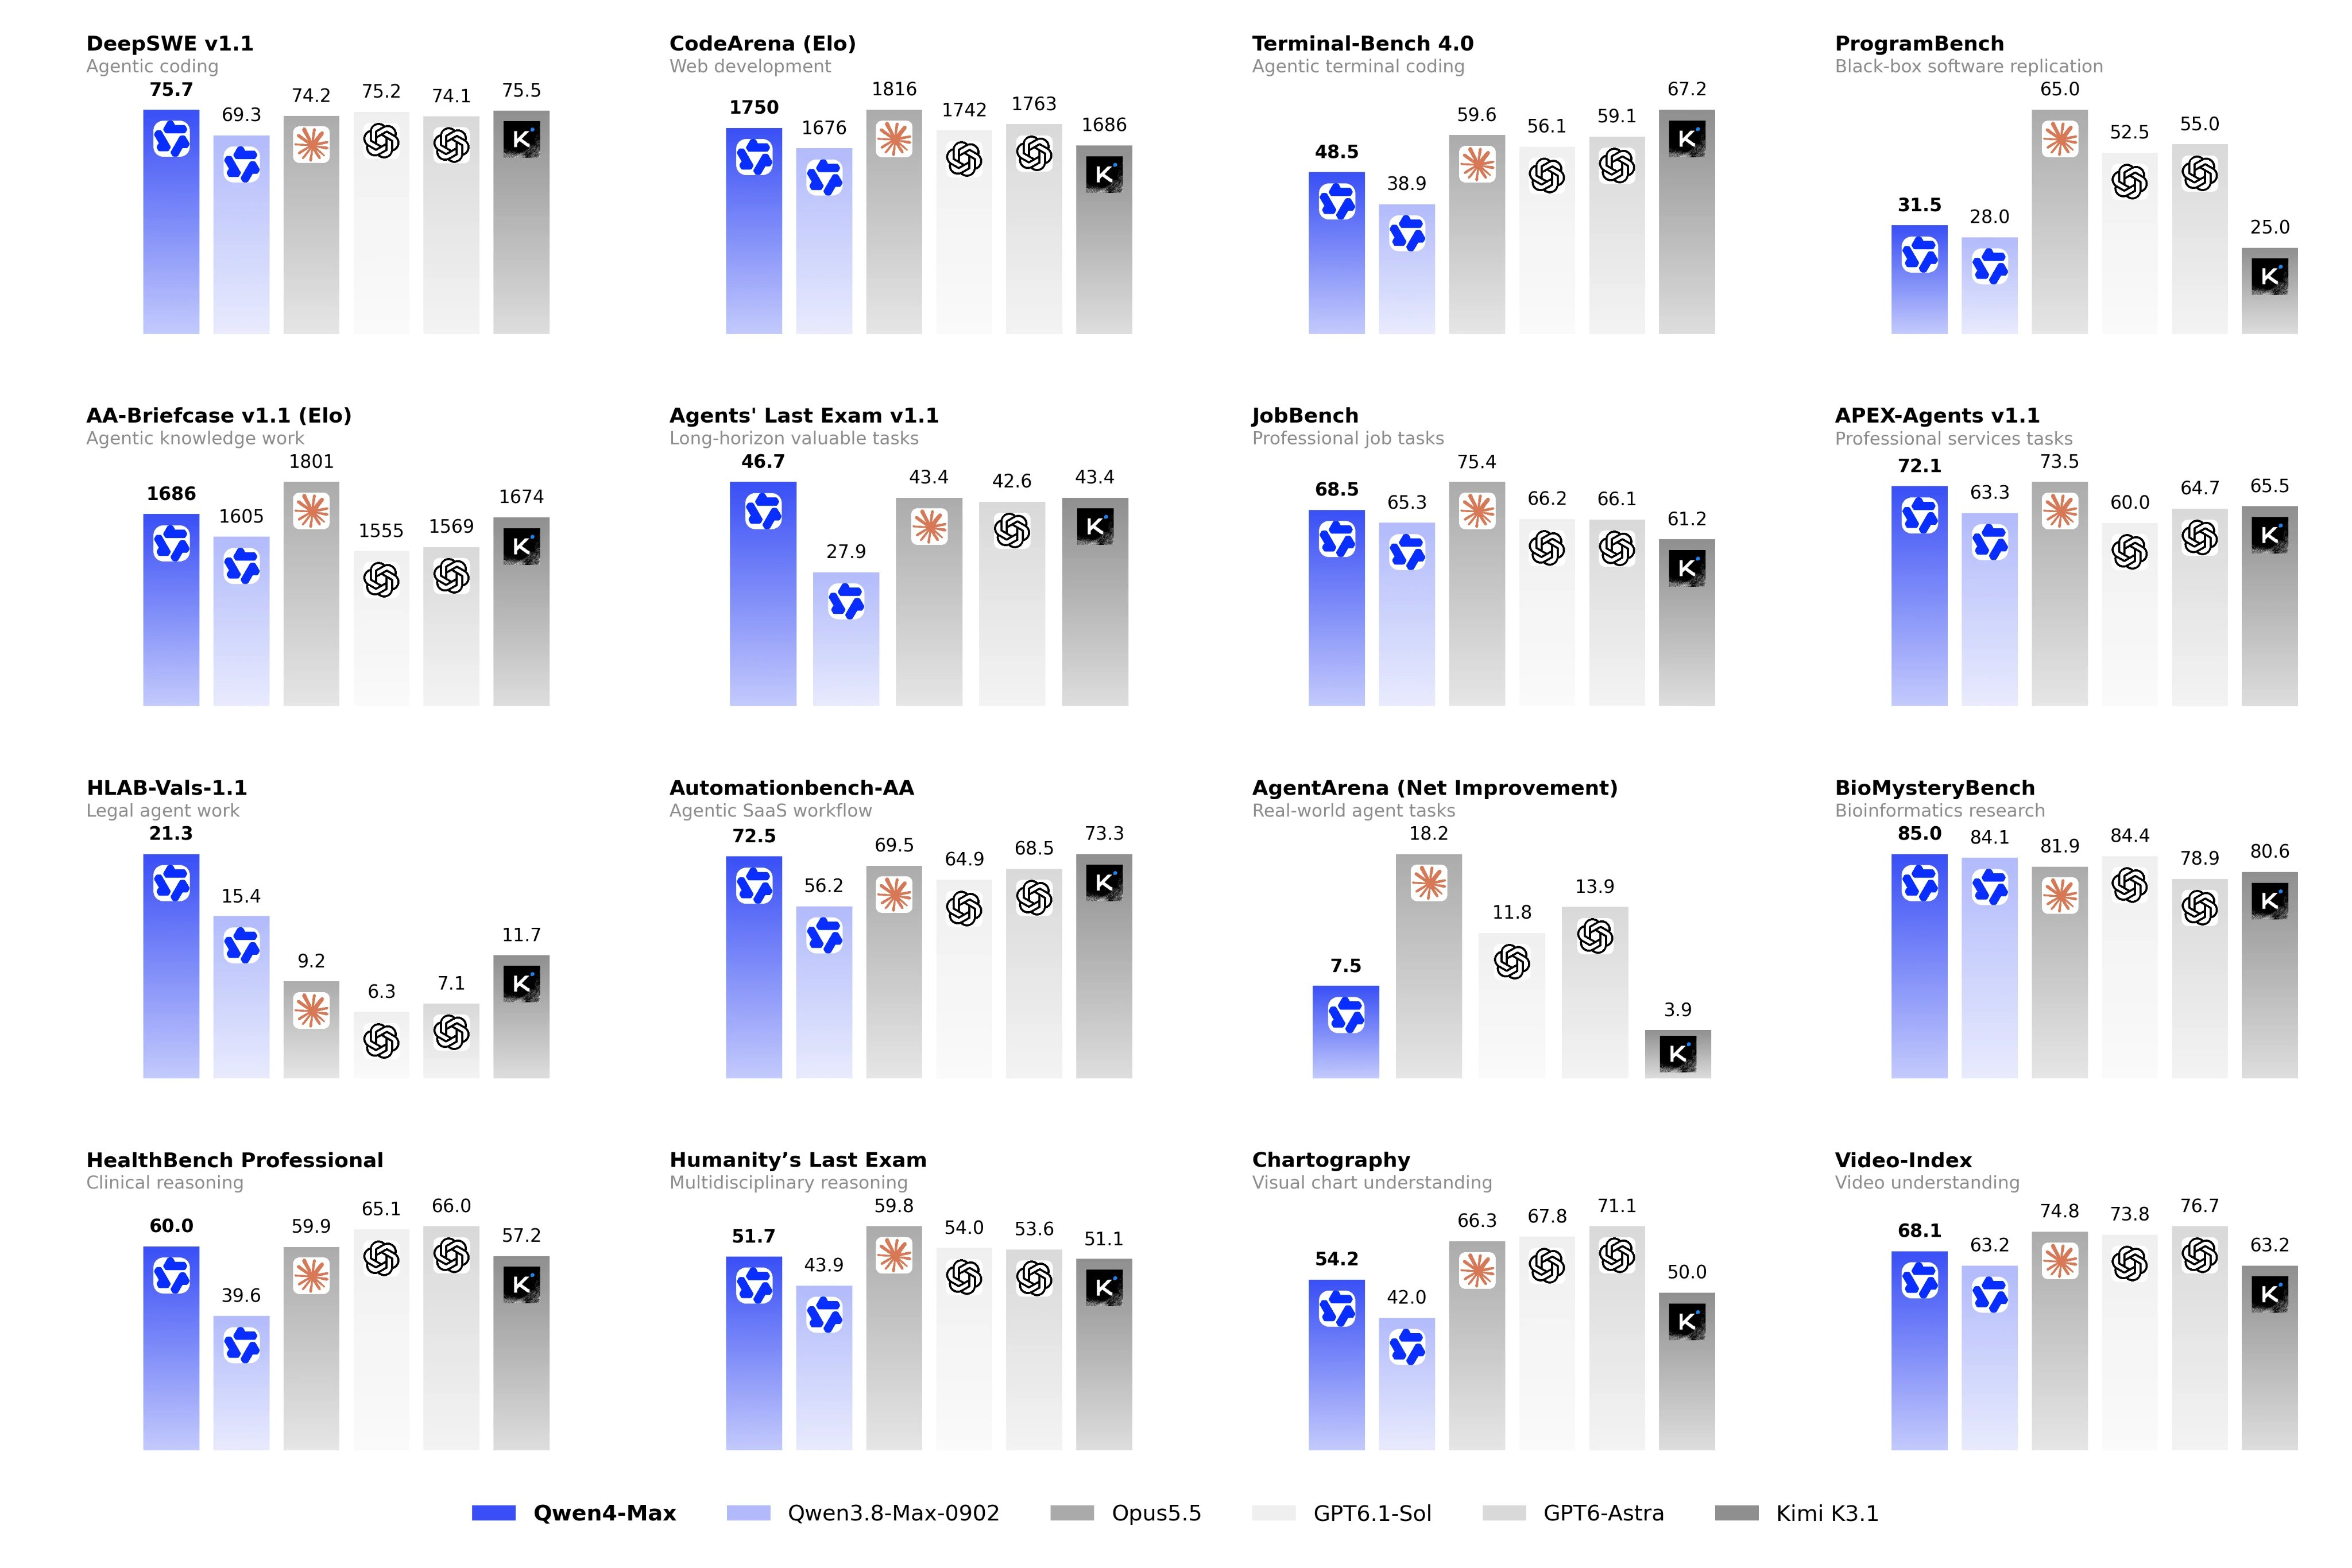
굵게 표시된 점수가 차트 내 최고 점수입니다. "Alibaba"로 표시된 것은 해당 테스트의 각주에서 외부 리더보드를 인용하지 않았다는 뜻이므로, 알리바바 자체 측정 결과로 봐야 합니다(JobBench와 Chartography 각주에는 알리바바의 테스트 환경만 설명되어 있습니다).
자체 측정 vs 제3자 측정: 각 테스트는 누가 수행했는가
16개 점수 중 10개는 자체 측정 결과이고, 6개는 타 기관이 운영하는 공개 리더보드에서 인용한 것입니다. 이 구분이 가장 유용한 필터입니다.
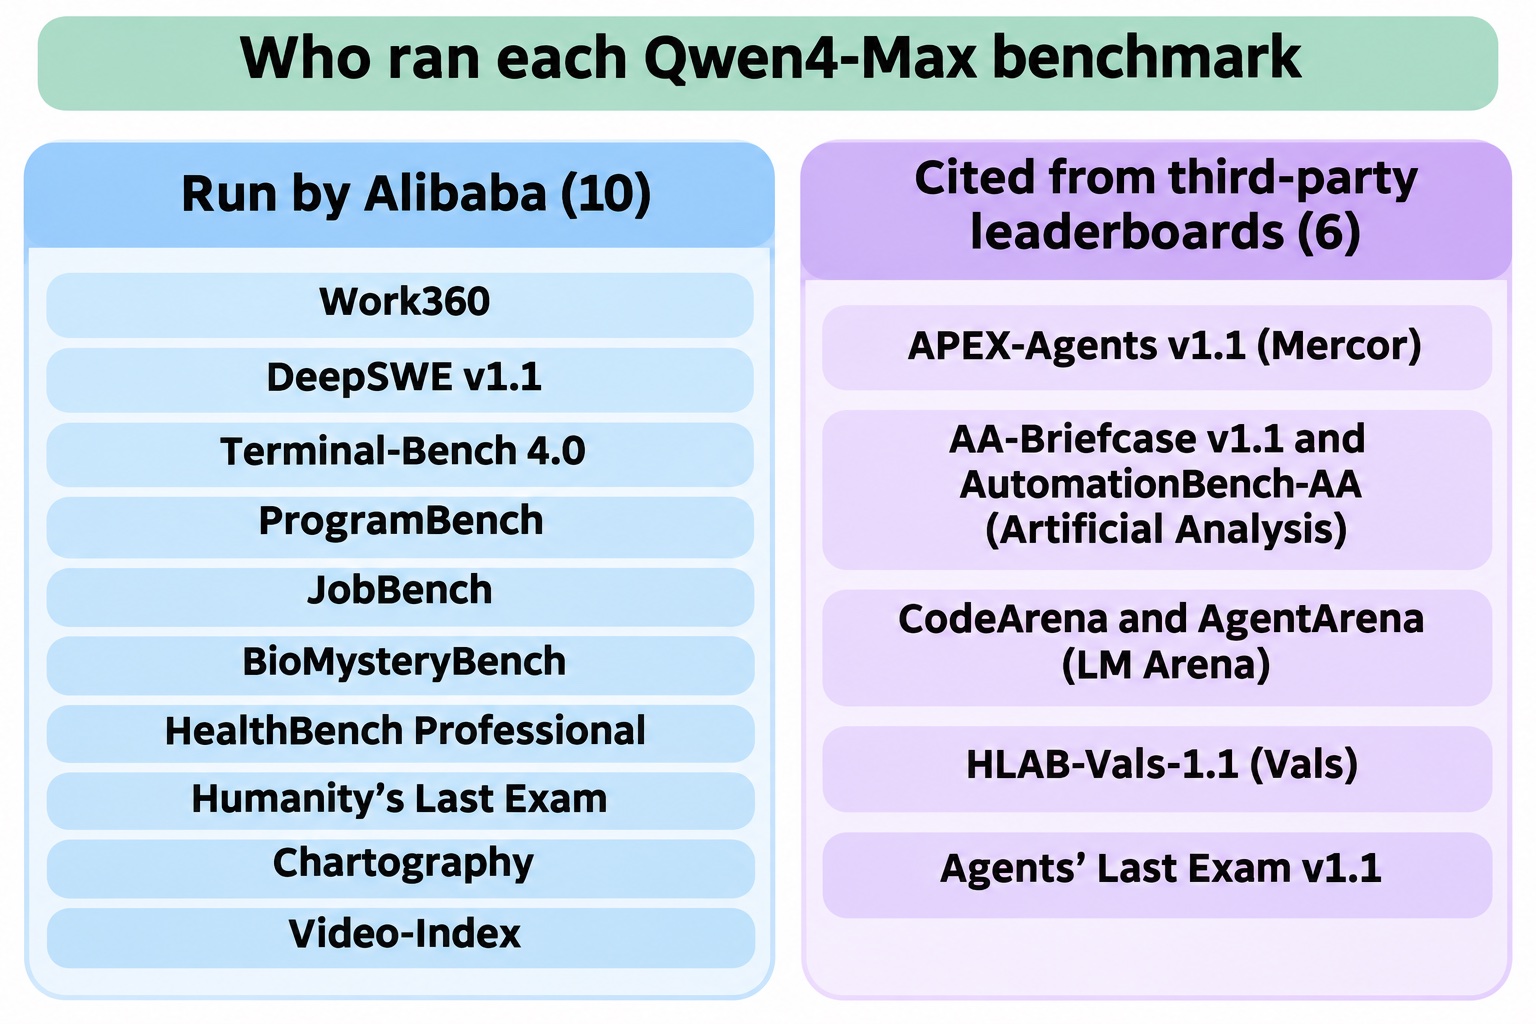
출시 포스트의 각주에 따른 제3자 측정 그룹은 다음과 같습니다:
- APEX-Agents v1.1: Mercor APEX-Agents 리더보드에서 인용
- AA-Briefcase v1.1 및 AutomationBench-AA: Artificial Analysis에서 인용
- CodeArena 및 AgentArena: LM Arena에서 인용
- HLAB-Vals-1.1: Vals Index에서 인용
- Agents' Last Exam v1.1: 자체 리더보드에서 인용
지금 바로 확인할 수 있는 독립적인 수치가 하나 있습니다. Vals Index(2026년 11월 15일 업데이트된 버전 2.2)는 Qwen 4 Max를 전체 63.20%, 11위, 테스트당 $9.33로 기록하고 있습니다. 이는 71.31%로 선두인 Claude Fable 5.2를 포함한 10개 모델에 뒤지고, Kimi K3.1 Pro(62.52%)와 Qwen 3.8 Max 0902(59.05%)를 각각 근소하게 앞서는 수준입니다. 헤드라인 차트보다는 훨씬 소박한 그림입니다.
Work360: 알리바바 자체 업무 벤치마크
Work360은 26개 도메인, 182개 하위 도메인, 721개 전문 분야를 아우르는 알리바바의 복잡한 산업 과제 벤치마크입니다. Qwen4-Max는 52.69를 기록했으며, Qwen3.8-Max의 47.74에서 상승한 수치입니다.
이 수치는 신중하게 읽어야 합니다. 벤치마크를 설계하고 모델을 측정한 것도 알리바바이며, 공개된 비교는 Qwen4-Max와 Qwen3.8-Max만을 다루고, 아직 공개 리더보드도 없습니다. 이는 세대 간 비교 수치일 뿐, 다른 연구소 대상 순위가 아닙니다.
Work360이 실제로 제공하는 것은 비용 수치입니다. 작업당 평균 비용이 $4.43에서 $1.67로, 62% 감소했으며, 이는 작업당 토큰 수 감소와 가격 인하가 함께 작용한 결과입니다. Qwen4-Max는 QwenCloud 모델 페이지에서 100만 입력 토큰당 $1.50, 100만 출력 토큰당 $4.50의 정가를 제시합니다. 전체 내용은 Qwen4-Max 가격 가이드에서 확인하세요.
Terminal-Bench 4.0과 토큰 효율성
Terminal-Bench는 에이전트가 터미널에서 실제 작업을 수행하는 능력을 측정합니다. 알리바바는 Qwen4-Max가 버전 4.0에서 48.5를 기록했다고 보고하며, 이는 Qwen3.8-Max의 38.9에서 상승한 수치입니다. 알리바바 자체 차트에서 나머지 4개 비-Qwen 모델은 56.1에서 67.2 사이로, 모두 이보다 높습니다.
더 주목할 주장은 효율성입니다. 알리바바에 따르면 토큰 사용량은 Terminal-Bench 4.0에서 Xhigh 노력 수준에서 약 48%, High 수준에서 약 49% 감소했으며, Work360에서는 약 24%(Xhigh), 35%(High) 감소했습니다. 점수 대비 토큰 차트는 그 모습을 보여줍니다:
- Work360에서 Qwen4-Max는 High 수준만으로도 Xhigh 수준의 Qwen3.8-Max를 이미 근소하게 앞서며, 작업당 약 96K 토큰 대 약 165K 토큰입니다(차트에서 읽은 수치이므로 근사치입니다).
- Terminal-Bench 4.0에서 Qwen4-Max는 Xhigh 수준에서 작업당 약 150K 토큰으로 48.5에 도달하는 반면, Qwen3.8-Max는 Xhigh에서 약 290K 토큰으로 약 38에 그칩니다.
토큰당 비용을 지불한다면 더 적은 토큰으로 더 나은 점수를 얻는 것은 바람직한 방향입니다. 다만 이 역시 자체 측정 결과입니다.
알아두면 좋은 확인 사항: 공개 Terminal-Bench 리더보드는 현재 버전 4.1을 기본으로 표시하며, 11월 16일 기준 Qwen4-Max는そこ에 등재되어 있지 않습니다. Qwen3.8-Max-0902는 4.1에서 27.0%를 기록했는데(Claude Code로 max effort 실행), 이는 알리바바의 4.0 차트에 있는 38.9와 비교됩니다. 버전과 실행 환경이 다르므로 단순히 빼서 비교할 수는 없지만, 점수가 설정에 따라 얼마나 달라질 수 있는지 보여줍니다.
Qwen4-Max가 앞서는 분야와 뒤처지는 분야
차트의 다른 프론티어 모델과 비교하면, 상황은 엇갈립니다:
앞서는 분야 (16개 중 4개): DeepSWE v1.1 (75.7, Kimi K3.1 대비 0.2점 우위), Agents' Last Exam v1.1 (46.7), HLAB-Vals-1.1 (21.3), BioMysteryBench (85.0, GPT-6.1 Sol 대비 1점 미만 우위).
근소한 2위: APEX-Agents v1.1 (72.1 vs 73.5), AutomationBench-AA (72.5 vs 73.3), AA-Briefcase (1686 vs 1801 Elo).
명확히 뒤처지는 분야: ProgramBench (31.5 vs 65.0), Terminal-Bench 4.0 (48.5 vs 67.2), AgentArena (7.5 vs 18.2), Chartography (54.2 vs 71.1), Humanity's Last Exam (51.7 vs 59.8).
4개 선두 중 2개인 Agents' Last Exam과 HLAB-Vals는 제3자 리더보드에서 나온 것이므로, 차트에서 가장 신뢰할 수 있는 주장입니다. 코딩 성능은 엇갈립니다: DeepSWE에서는 근소한 리드를 보이지만, ProgramBench와 Terminal-Bench에서는 큰 격차를 보입니다. 장시간 실행되는 터미널 에이전트를 운영한다면, 전환 전에 직접 테스트해 보세요. 지난 세대와의 변화가 궁금하다면 Qwen4-Max vs Qwen 3.8을 참고하세요.
보안 코딩 및 사전 학습 수치
보안 코딩. Last Secure Code Bench에서 기능성과 취약점을 모두 검사하는 "보안 힌트 없는 코드 재구성" 설정에서, 함수 수준 통과율은 Qwen3.8-Max의 22.0%에서 31.8%로 상승했습니다. 세 수준(함수, 파일, 저장소) 모두를 통과한 코드 비율은 8%에서 14.7%로 상승했습니다. 함수 수준 출력의 약 3분의 2는 여전히 검사에 실패하므로, 보안 검토는 여전히 사용자의 몫입니다.
사전 학습. 지식, 코드, QA, STEM에 걸친 사내 평가에서 Qwen4-Max-Base는 25% 더 적은 파라미터를 활성화하면서 Qwen3.8-Max-Base 대비 약 5%에서 13% 낮은 바이트당 비트를 기록합니다. 알리바바는 이 비교에 포함된 두 체크포인트(GLM-5.3과 Kimi-K3.1-Pro)는 포스트 학습된 모델이므로 결과가 왜곡될 수 있다고 언급합니다.
여전히 부족한 것들
- 대부분의 테스트에 대한 평가 설정. 출시 포스트는 각 막대가 어떤 노력 수준(High 또는 Xhigh)과 어떤 에이전트 하네스에서 나왔는지 밝히지 않습니다.
- 변동성. 오차 막대나 실행 횟수가 없습니다. Terminal-Bench 같은 리더보드는 약 3~4점의 오차 범위를 보고하는데, 이는 위의 일부 격차보다 큽니다.
- 독립적인 Terminal-Bench 및 Work360 실행. 어느 쪽도 아직 공개 리더보드에 없습니다.
Apidog CLI로 직접 Qwen4-Max 벤치마크 실행하기
어떤 공개 벤치마크도 여러분의 프롬프트나 스키마를 사용하지 않습니다. 가장 빠르고 정직한 검증은 자체 요청으로 구성된 작은 스위트를 매번 동일한 방식으로 실행하고, 토큰 사용량을 기록해 작업당 비용을 직접 계산하는 것입니다.
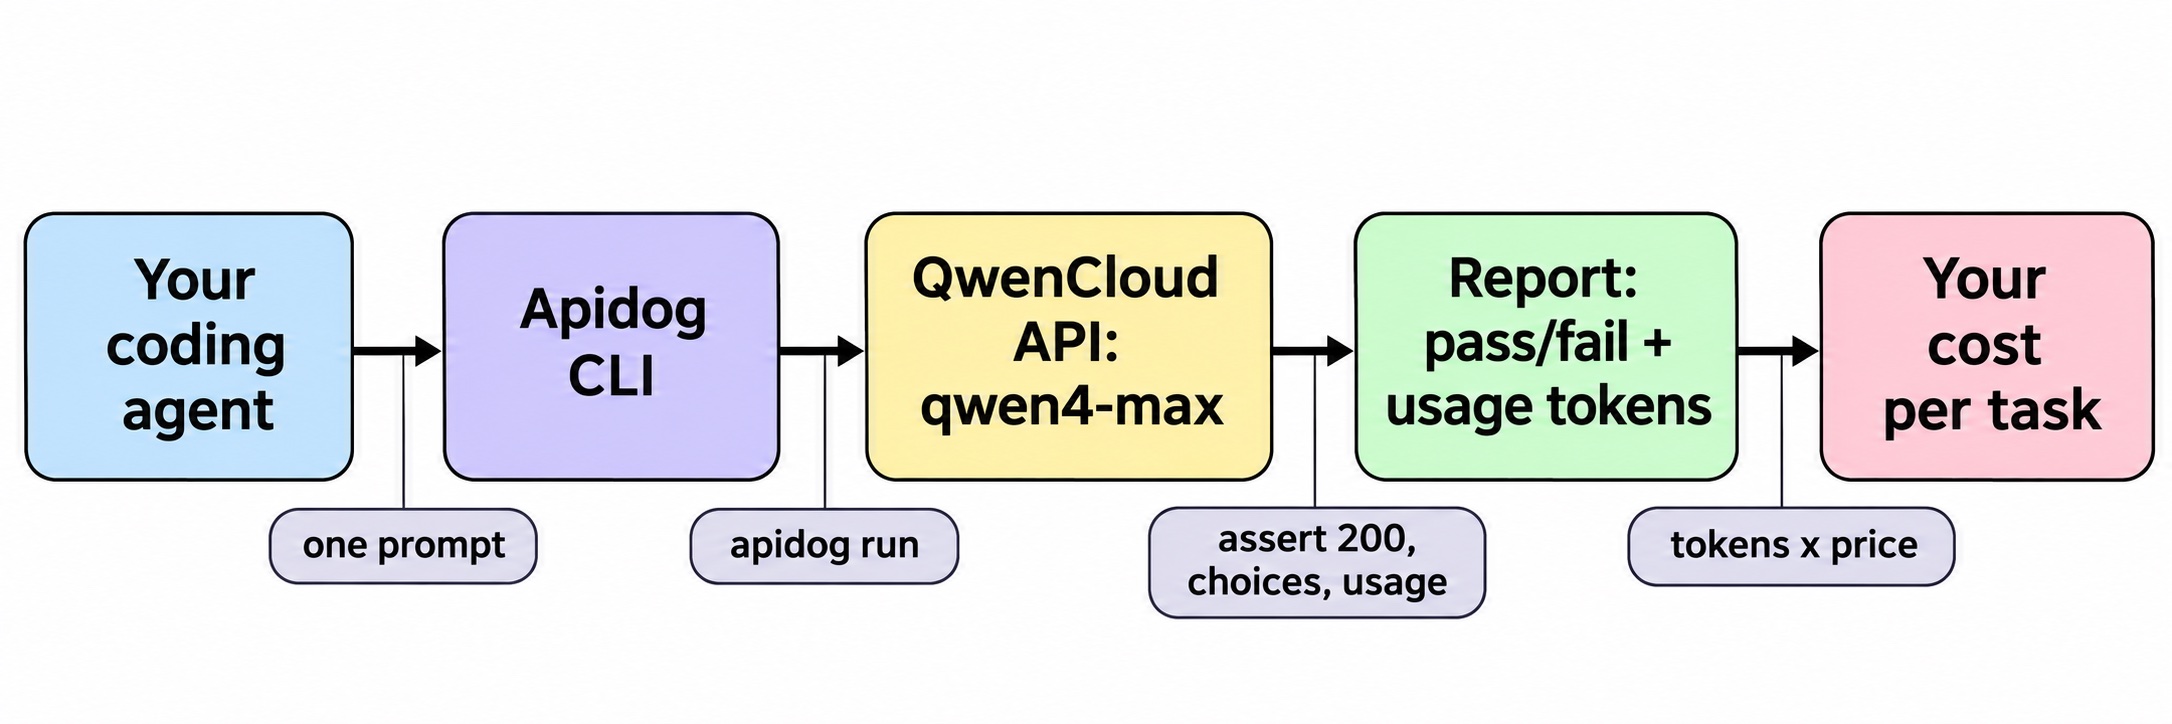
Apidog CLI를 사용해 코딩 에이전트에게 설정을 맡기세요. 한 번만 설치하면 됩니다:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install은 에이전트에게 CLI 사용법을 가르치고, 설치 가이드에서 토큰 관련 내용을 다룹니다. 그다음 프롬프트 하나만 주면 됩니다:
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
에이전트는 무엇이든 작성하기 전에 각 페이로드 형식을 확인합니다. 아래의 모든 플래그는 Apidog CLI 2.2.12의 apidog <command> --help에서 가져온 것입니다:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
-d는 프롬프트 파일의 각 행마다 한 번의 반복을 실행하며, --env-var는 실행 시점에 키를 전달하므로 프로젝트에 저장되지 않습니다. 에이전트는 apidog-reports의 JSON 보고서에서 각 usage 블록을 읽습니다. 프롬프트 토큰에 $1.50, 완성 토큰에 $4.50를 백만 토큰 기준으로 곱하면, 알리바바의 $1.67과 비교할 수 있는 자체 작업당 비용이 산출됩니다.
환경을 바꿔서 동일한 스위트를 현재 사용 중인 모델로 실행하고, 출시 차트에서는 볼 수 없는 변동성을 파악하기 위해 두세 번 반복해 보세요. 동일한 apidog run 명령은 -r junit 옵션으로 CI에 넣을 수 있습니다. 자세한 내용은 CI/CD 가이드를 참고하세요. 단계별 에이전트 설정은 Claude Code에서의 Apidog CLI를 참고하세요. Apidog의 무료 플랜은 최대 4명의 사용자까지 지원합니다.
FAQ
Qwen4-Max 벤치마크는 독립적인가요? 대부분 아닙니다. 알리바바 차트의 16개 점수 중 10개는 자체 측정 결과입니다. 6개는 제3자 리더보드에서 인용한 것입니다: APEX-Agents (Mercor), AA-Briefcase 및 AutomationBench-AA (Artificial Analysis), CodeArena 및 AgentArena (LM Arena), HLAB-Vals (Vals), Agents' Last Exam.
Work360이란 무엇인가요? 26개 도메인에 걸친 복잡한 산업 과제를 다루는 알리바바 자체 벤치마크입니다. Qwen4-Max는 47.74를 기록한 Qwen3.8-Max에 대해 52.69를 기록했으며, 공개된 비교에는 이 두 모델만 등장합니다.
Qwen4-Max의 Terminal-Bench 4.0 성적은 어떤가요? 알리바바는 38.9에서 48.5로 상승했으며, 토큰 사용량은 약 절반으로 줄었다고 보고합니다. 차트의 다른 프론티어 모델은 56.1에서 67.2를 기록합니다.
Qwen4-Max가 Qwen3.8-Max보다 운영 비용이 저렴한가요? 알리바바의 Work360 평가에서 작업당 평균 비용은 $4.43에서 $1.67로 감소했습니다. 정가는 100만 토큰당 입력 $1.50, 출력 $4.50입니다. 구독 옵션은 Token Plan 가이드를, 무료 이용 경로는 Qwen4-Max 무료로 사용하기를 참고하세요.
Qwen4-Max 출시에서 Live Delivery란 무엇인가요? 사용 가능한 첫 버전을 조기에 출시하고 사용자의 방향 제어 하에 지속적으로 개선하는 에이전트 워크플로우입니다. 벤치마크는 아닙니다. 자세한 내용은 Qwen Live Delivery 플러그인 가이드를 참고하세요.