
Qwen4-Max API가 QwenCloud에서 토큰 단위 종량제 모델로 출시되었으며, 모델 ID는 qwen4-max입니다. 사용 중인 리전에서 종량제 키를 생성하고, OpenAI SDK의 base URL을 https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1(싱가포르)로 지정한 뒤 호출하면 됩니다. 비용은 입력 토큰 백만 개당 $1.50, 출력 토큰 백만 개당 $4.50이며, 컨텍스트 길이는 1M 토큰입니다.
이 가이드에서는 API 키, base URL, thinking, 비전, 도구(function calling), 구조화된 출력, 캐싱, Anthropic 경로, 속도 제한 및 오류를 다룹니다. 모든 코드 예제는 2026년 11월 16일 기준으로 확인한 QwenCloud 공식 문서를 따릅니다.
배경 정보가 필요하면 Qwen4-Max란 무엇인가 문서를 읽어보세요. 토큰 종량제 대신 구독 방식을 원한다면 Qwen4-Max 사용 방법 총정리와 Token Plan 가이드를 참고하세요.
Qwen4-Max API가 제공하는 기능
Qwen4-Max API는 알리바바의 플래그십 모델을 QwenCloud를 통해 제공하는 서비스로, OpenAI 호환, Anthropic 호환, DashScope 엔드포인트를 지원합니다. 텍스트, 이미지, 비디오 입력을 받아 텍스트를 반환하며, 기본적으로 답변 전에 추론(thinking)을 수행하고, function calling, 구조화된 출력, 컨텍스트 캐싱, 배치 작업, 웹 검색, 파인튜닝을 지원합니다.
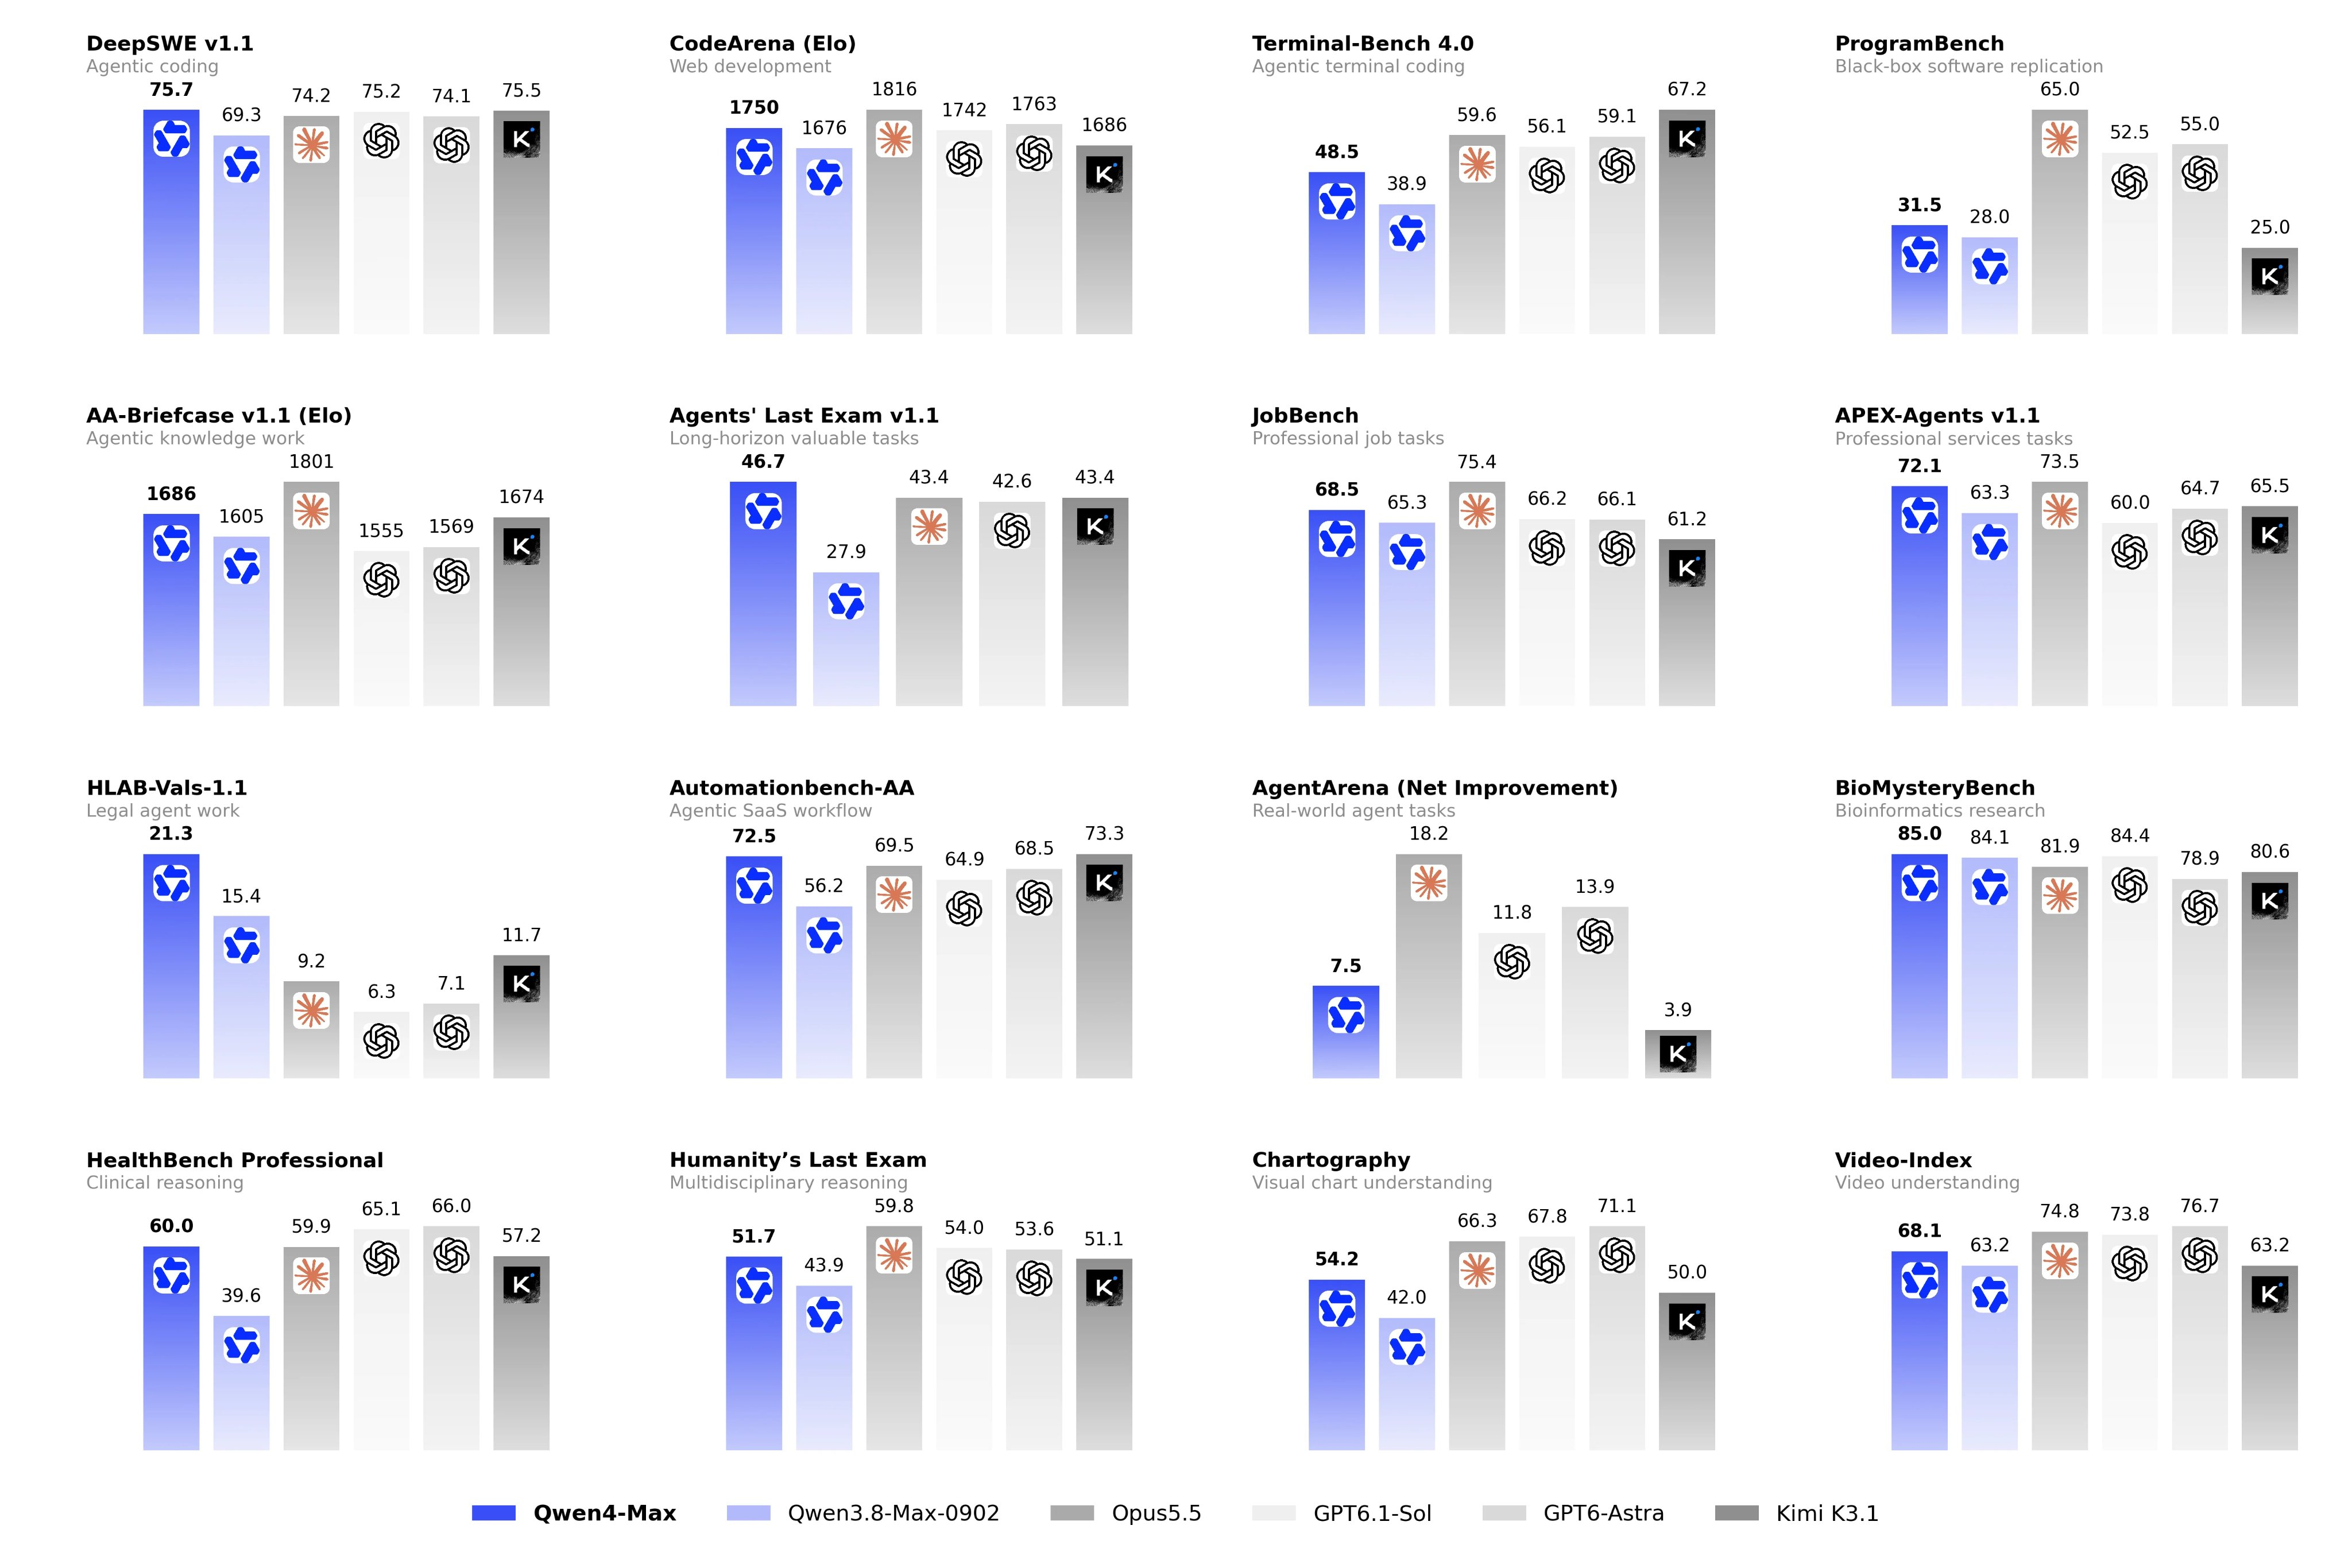
qwen4-max 모델 페이지에 나온 수치는 다음과 같습니다:
| 항목 | 값 |
|---|---|
| 모델 ID | qwen4-max |
| 입력 가격 | 1M 토큰당 $1.50 |
| 출력 가격 | 1M 토큰당 $4.50 |
| 암시적 캐시 입력 / 명시적 캐시 읽기 | 1M 토큰당 $0.075 |
| 명시적 캐시 생성 | 1M 토큰당 $1.875(5분) 또는 $3(1시간) |
| 컨텍스트 윈도우 | 1M 토큰 |
| 최대 입력 | 991K (thinking 사용 시 983K) |
| 최대 출력 | 393K |
| 최대 추론 | 262K |
| 처리량 | 5,000,000 TPM |
Thinking 토큰은 출력 토큰으로 과금됩니다. 전체 비용 내역은 Qwen4-Max 가격 가이드를 참고하세요.
API 키 발급과 올바른 base URL 선택
API 키는 리전에 종속되며, 키 유형이 엔드포인트와 일치해야 합니다.
- QwenCloud 콘솔을 열고 오른쪽 상단의 선택기에서 리전을 선택합니다.
- API Keys로 이동해 Create API key를 클릭하고, 설명을 추가한 뒤 Generate Key를 클릭합니다.
- 키는 한 번만 표시되므로 즉시 복사해 두세요. 새 종량제 키는
sk-ws-로 시작합니다. - 키를 환경 변수로 내보냅니다:
export DASHSCOPE_API_KEY="sk-ws-...".
모든 리전은 {region}.maas.qwencloudapi.com 도메인을 사용합니다. 싱가포르는 ap-southeast-1, 프랑크푸르트는 eu-central-1, 도쿄는 ap-northeast-1, 미국(버지니아)은 us-east-1입니다. 이후 프로토콜 경로를 붙입니다:
| 프로토콜 | Base URL (싱가포르) |
|---|---|
| OpenAI 호환 (Chat Completions, Responses) | https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 |
| Anthropic 호환 | https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic |
| DashScope HTTP | https://ap-southeast-1.maas.qwencloudapi.com/api/v1 |
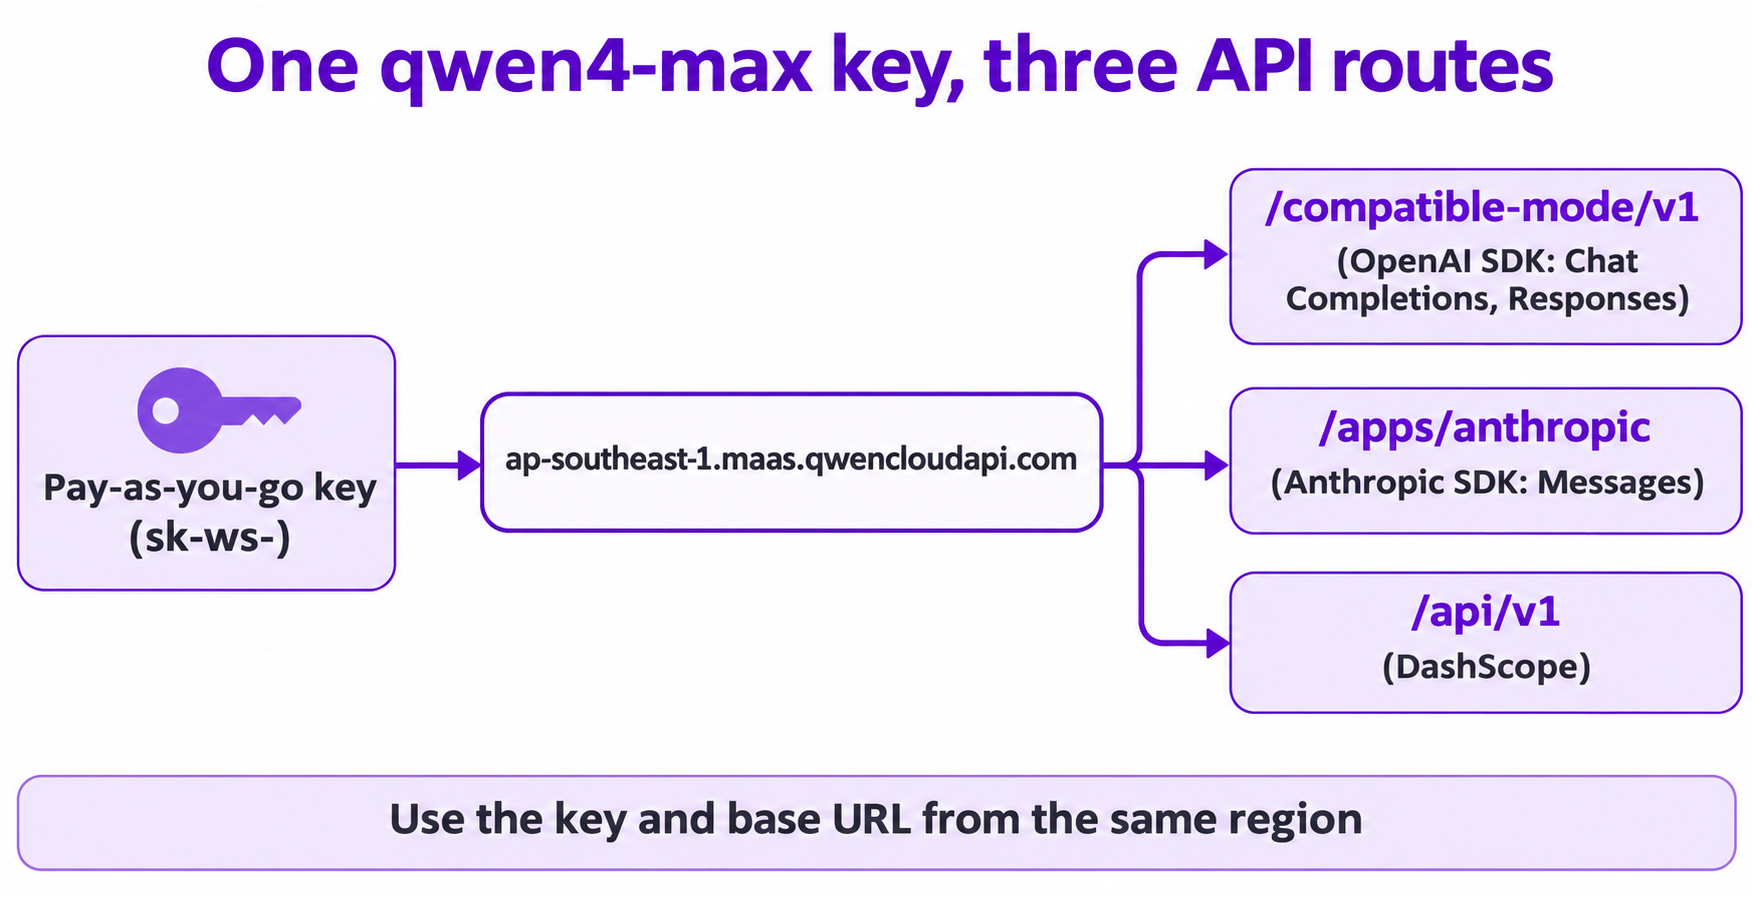
Token Plan 키(sk-sp-)는 token-plan.maas.qwencloudapi.com에서만 작동하고, 종량제 키는 해당 리전의 도메인에서만 작동합니다. 이 둘을 혼용하면 401 오류가 발생합니다. 자세한 내용은 리전 및 엔드포인트 문서를 참고하세요.
첫 번째 Qwen4-Max API 호출
OpenAI SDK를 설치하고(pip install openai) 공식 문서의 퀵스타트 코드를 실행해 보세요:
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.getenv("DASHSCOPE_API_KEY"),
  base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1"
)
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Summarize the benefits of solar energy in three bullet points."}]
)
print(completion.choices[0].message.content)
qwen4-max는 thinking이 기본적으로 켜져 있으므로 이 호출에서도 추론 토큰이 소비됩니다. 긴 프롬프트를 사용하는 경우 스트리밍을 사용하거나 클라이언트 타임아웃을 180초 이상으로 설정하세요.
Thinking 모드와 reasoning_content 스트리밍
Qwen4-Max는 하이브리드 thinking 모델입니다. 공식 문서의 기본값은 enable_thinking=true, reasoning_effort=high, thinking_budget=131072입니다. Effort 레벨은 low, high, xhigh이며, none은 thinking을 끕니다.
추론과 답변을 두 단계로 나누어 스트리밍하는 예제입니다(모델 페이지 샘플 기반으로 수정):
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
messages = [{"role": "user", "content": "Who are you"}]
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True)  # phase 1: thinking
    if delta.content:
        print(delta.content, end="", flush=True)            # phase 2: answer
세 가지 주요 규칙:
max_completion_tokens로 출력을 제한하세요. thinking이 켜져 있으면max_tokens는 1~32,768 범위만 허용합니다(그 외 값은 400 오류).max_completion_tokens는 추론과 답변을 모두 포괄하며 이런 제한이 없습니다.extra_body로 추론 깊이를 조절하세요. 어려운 문제에는{"enable_thinking": True, "reasoning_effort": "xhigh"}를, 간단한 문제에는"low"를 사용하세요.- 멀티턴 대화에서 추론 내용을 유지하세요.
qwen4-max는preserve_thinking이 기본 켜져 있으므로, 이전 추론 내용을 각 어시스턴트 메시지의reasoning_content필드로 되돌려 보내야 하며, 절대content안에 넣으면 안 됩니다.
thinking을 건너뛰려면 {"enable_thinking": False}를 전달하세요.
이미지 및 비디오 입력
이미지는 image_url 파트로, 비디오는 video_url 파트로 전송합니다. 다음은 공식 문서의 비전 샘플을 모델을 qwen4-max로 바꾼 예제입니다:
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{
    "role": "user",
    "content": [
      {"type": "image_url", "image_url": {"url": "https://example.com/invoice.jpg"}},
      {"type": "text", "text": "Describe what you see in this image"},
    ],
  }],
)
비디오는 {"type": "video_url", "video_url": {"url": "..."}, "fps": 2} 형태로 사용합니다. 로컬 파일은 Base64 Data URI로 전달합니다.
비전 가이드에 따르면 URL 이미지는 최대 2,048개(각 20 MB), Base64 이미지는 250개까지 가능하고, 요청당 최대 64 MB입니다. 이미지 detail은 기본값이 high이며, 이 경우 더 많은 입력 토큰이 소비됩니다.
Function calling
다른 OpenAI 호환 모델과 마찬가지로 tools 배열을 전달합니다:
tools = [{
  "type": "function",
  "function": {
    "name": "get_current_weather",
    "description": "Useful when you want to check the weather for a specific city.",
    "parameters": {
      "type": "object",
      "properties": {"location": {"type": "string", "description": "City or county, such as Singapore or New York."}},
      "required": ["location"],
    },
  },
}]
completion = client.chat.completions.create(model="qwen4-max", messages=messages, tools=tools)
message.tool_calls를 읽고, 함수를 실행한 뒤, tool 메시지를 추가하고 다시 호출합니다.
thinking 모드에서는 tool_choice가 "auto" 또는 "none"만 허용하므로, 특정 함수를 강제하려면 먼저 thinking을 비활성화해야 합니다. thinking이 켜져 있을 때는 도구 결과와 함께 reasoning_content를 되돌려 보내야 정확도가 유지됩니다.
구조화된 출력
qwen4-max는 strict JSON Schema 모드를 지원합니다:
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Extract the name and age: Ana is 31."}],
  response_format={
    "type": "json_schema",
    "json_schema": {
      "name": "user_info",
      "strict": True,
      "schema": {
        "type": "object",
        "properties": {"name": {"type": "string"}, "age": {"type": "integer"}},
        "required": ["name", "age"],
        "additionalProperties": False,
      },
    },
  },
)
더 느슨한 {"type": "json_object"} 모드에서는 메시지에 "JSON"이라는 단어가 반드시 포함되어야 하며, 그렇지 않으면 API가 요청을 거부합니다. 이미지나 비디오 입력 시에는 json_object로 폴백되므로, 멀티모달 호출에서는 스키마가 강제되지 않습니다.
컨텍스트 캐시와 배치
캐시. 아무 설정도 하지 않으면 암시적 캐시가 프리픽스를 매칭하지만 히트를 보장하지 않습니다. 결정적인 히트를 보장하려면 Qwen4 명시적 캐시를 사용하세요. 콘텐츠 블록에 "prompt_cache_breakpoint": {"mode": "explicit"}를 표시하고(메시지 content가 배열이어야 함), extra_body={"prompt_cache_options": {"mode": "explicit", "ttl": "5m"}}로 TTL을 설정합니다. TTL은 5m 또는 1h이며, 캐시된 프리픽스는 최소 1,024 토큰 이상이어야 합니다. 캐시 읽기 비용은 백만 토큰당 $0.075로, 새 입력 대비 95% 저렴합니다.
배치. 배치 가이드에 따르면 입력과 출력이 실시간 가격의 50%로 과금되며, 결과는 24시간 이내에 반환됩니다. 다만 qwen4-max의 Batch File은 싱가포르 외 한 리전에서만 실행되며 컨텍스트 캐싱을 지원하지 않으므로, 이를 기반으로 파이프라인을 설계하기 전에 배치 가이드를 확인하세요.
Anthropic 호환 경로
이미 Anthropic SDK로 구축되어 있나요? base URL과 키만 바꾸면 됩니다:
import anthropic
import os

client = anthropic.Anthropic(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic",
)
message = client.messages.create(
    model="qwen4-max",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Who are you?"}],
    thinking={"type": "disabled"},
)
print(message.content)
이 샘플은 공식 문서의 샘플과 마찬가지로 thinking을 끕니다. base URL은 /apps/anthropic에서 끝나야 합니다. /v1/을 추가하면 /v1/v1/...이 되어 404 오류가 발생합니다. 여기서도 thinking이 기본적으로 켜져 있으며, thinking이 활성화된 경우 max_tokens가 thinking 예산보다 커야 합니다. Effort는 output_config.effort(low, high, xhigh)로 설정하며, 이 경로에서는 내장 web_search 및 web_fetch 도구도 사용할 수 있습니다.
Qwen4-Max API 속도 제한
속도 제한 페이지 기준:
| 리전 | RPM | TPM |
|---|---|---|
| 싱가포르 | 동적 | 동적 티어: 5M, 10M, 20M |
| 프랑크푸르트, 도쿄, 미국(버지니아) 등 기타 글로벌 스코프 리전 | 30,000 | 5,000,000 |
제한은 계정당 리전별로 적용되며 초당 단위로도 적용됩니다(RPS = RPM / 60). 따라서 순간적인 요청 폭주가 분당 총량 이하임에도 스로틀링될 수 있습니다.
무료 할당량 페이지에 따르면 무료 할당량은 싱가포르 리전에만 존재하고, 모델별로 제공되며(일반적으로 1,000,000 토큰), 90일간 유효하고, 결제 정보 등록이 필요합니다. 페이지에서 qwen4-max가 명시되어 있지 않으므로 콘솔의 Free Tier 페이지를 확인하거나, Qwen4-Max 무료로 사용하는 방법 문서를 참고하세요.
Qwen4-Max API의 일반적인 오류
| 코드 | 의미 | 해결 방법 |
|---|---|---|
401 InvalidApiKey |
키와 base URL의 리전이 다르거나, Token Plan 키를 종량제 엔드포인트에서 사용한 경우 | URL과 동일한 리전에서 생성한 키를 사용하세요 |
400 InvalidParameter |
대부분 thinking이 켜진 상태에서 max_tokens가 1~32,768 범위를 벗어난 경우 |
max_completion_tokens로 전환하세요 |
403 AllocationQuota.FreeTierOnly |
결제 설정 전에 무료 할당량을 모두 사용한 경우 | Free Tier 페이지에서 결제 정보를 추가하세요 |
404 ModelNotFound |
호출한 리전에서 qwen4-max를 제공하지 않는 경우 |
해당 리전의 모델 가격을 확인하세요 |
429 Throttling |
RPM 또는 TPM 제한에 도달한 경우 | 잠시 대기 후 재시도하거나, 요청을 초 단위로 분산하세요 |
Apidog CLI로 코딩 에이전트에게 Qwen4-Max API 테스트 맡기기
코딩 에이전트가 통합 코드를 작성한다면, 회귀 테스트도 함께 작성하게 하세요. Apidog CLI를 사용하면 에이전트가 엔드포인트를 저장하고, 키를 보관하며, 어설션을 실행할 수 있습니다.
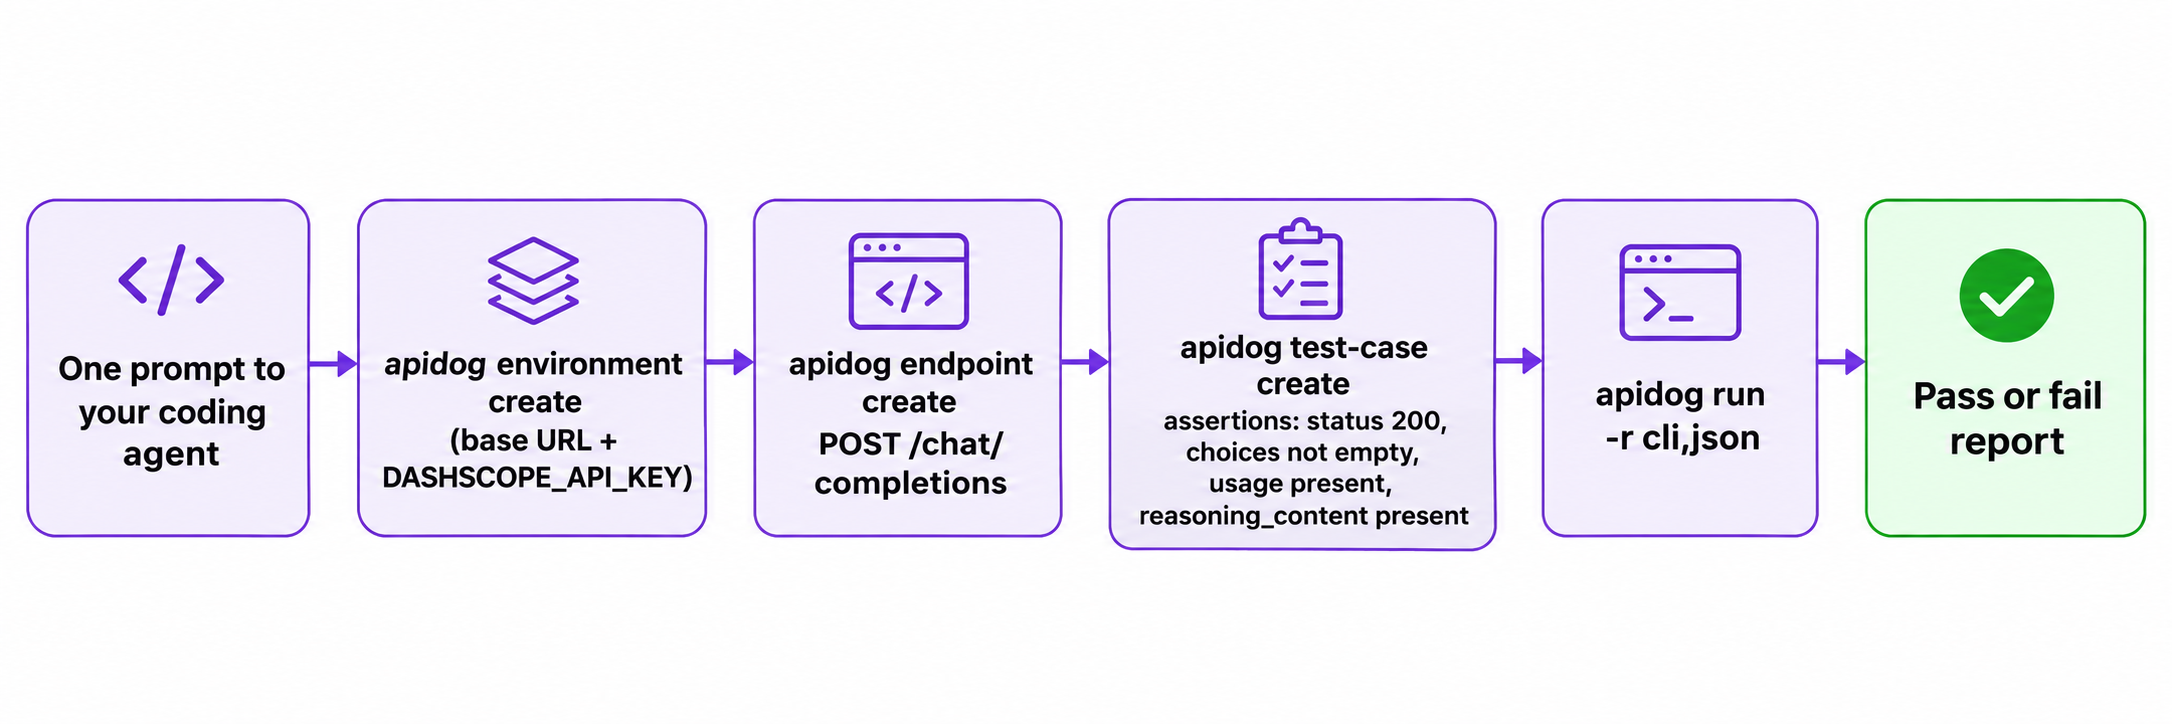
한 번만 설정하면 됩니다:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그런 다음 에이전트에게 프롬프트 하나를 주세요:
In Apidog project <projectId>, create an environment "Qwen Singapore" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable DASHSCOPE_API_KEY. Add POST /chat/completions with a Bearer auth header,
model qwen4-max and enable_thinking true. Create a test case asserting status 200,
a non-empty choices array, a usage object, and reasoning_content present on the
first choice's message. Run it and summarize any failures.
에이전트는 작성 전에 각 페이로드 스키마를 읽은 후 케이스를 실행합니다:
apidog environment create "Qwen Singapore" --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get environment-update
apidog environment update <envId> --project <projectId> --file env.json
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
cli 리포터는 통과 또는 실패를 출력하고, json은 에이전트가 읽을 수 있는 리포트를 생성합니다. 동일한 apidog run ... -r junit을 CI로 옮기려면 Apidog CLI CI/CD 가이드를, 추가 프롬프트 예시는 Claude Code에서의 Apidog CLI 문서를 참고하세요. Apidog의 Free 플랜은 최대 4명의 사용자까지 지원합니다.
FAQ
Qwen4-Max API의 모델 ID는 무엇인가요?
안정적인 ID는 qwen4-max입니다. 이전의 qwen4-max-preview ID는 2026년 11월 11일에 시작된 프리뷰 기간 동안 Token Plan 전용이었습니다.
Qwen4-Max API는 OpenAI 호환인가요?
네. Chat Completions와 Responses API를 위해 /compatible-mode/v1 base URL과 함께 OpenAI SDK를 사용할 수 있습니다. Anthropic 호환 엔드포인트와 DashScope API도 제공됩니다.
Qwen4-Max API에서 thinking을 끄는 방법은?
extra_body={"enable_thinking": False}를 전달하세요. reasoning_content를 사용할 수 없게 되지만, 지연 시간과 출력 토큰이 줄어듭니다. 모델 비교가 필요하다면 Qwen4-Max vs Qwen3.8을 참고하세요.
Qwen4-Max API 비용은 얼마인가요?
입력 토큰 백만 개당 $1.50, 출력 토큰 백만 개당 $4.50이며, 캐시 읽기는 백만 개당 $0.075입니다.
Token Plan 키를 토큰 종량제 API에서 사용할 수 있나요?
아니요. Token Plan 키(sk-sp-)는 token-plan.maas.qwencloudapi.com에서만 작동하고, 종량제 키는 해당 리전의 도메인에서만 작동합니다.