
Alibaba는 2026년 8월 초 Qwen 3.8-Max를 출시했습니다. 만약 프로덕션 환경에서 이미 qwen3.7-max를 실행하고 있다면, 중요한 결정을 내려야 할 때입니다. 새로운 모델은 에이전트 및 연구 벤치마크에서 큰 성과를 보였고, 이미지 입력을 추가했으며, 더 낮은 정가로 출시되었고, 이전 모델에서는 Alibaba가 약속하지 않았던 개방형 가중치(open weights)를 제공합니다.
하지만 결정이 단순히 "새로운 모델이 더 좋다"고 말할 수만은 없습니다. Qwen 3.7-Max는 현재 3.8-Max보다 절대적으로 저렴하게 만드는 50% 한정 할인 프로모션을 진행 중입니다. 일부 벤치마크 차이는 극적이지만, 다른 일부는 사실상 0에 가깝습니다. 이 글은 중요한 모든 변경 사항을 자세히 설명하여, 지금 전환할지, 기다릴지, 아니면 아예 하위 티어로 내려갈지 결정하는 데 도움을 드립니다.
새 모델에 대한 전체적인 내용을 먼저 알고 싶다면, 저희의 Qwen 3.8-Max 설명으로 시작하세요. 이전 플래그십 모델에 대한 배경 정보는 Qwen 3.7의 특징을 참조하십시오.
수치를 살펴보기 전에 방법론에 대한 한 가지 설명을 드립니다. 아래의 모든 벤치마크 수치는 공식 Qwen 3.8 출시 게시물에 있는 Alibaba 자체 표에서 가져온 것입니다. 이는 여기에서 실제로 유용합니다. 두 모델 모두 동일한 벤더 실행 환경에서 평가되었으므로, 독립적인 검증이 아직 보류 중이더라도 차이점은 내부적으로 일관성이 있습니다. 대부분의 코딩 관련 항목은 Claude Code 하네스에서 실행되었으며, 몇몇 벤치마크는 Qwen 자체 벤치마크입니다.
요약
| 변경 사항 | Qwen 3.7-Max | Qwen 3.8-Max |
|---|---|---|
| Terminal Bench 2.1 | 74.5 | 86.6 |
| SWE-bench Pro | 60.6 | 67.7 |
| PaperBench | 64.8 | 93.0 |
| IFBench | 79.1 | 82.8 |
| GPQA Diamond | 92.4 | 92.6 |
| HLE | 41.4 | 43.6 |
| 정가 (100만 토큰당) | $2.5 입력 / $7.5 출력 | $2 입력 / $6 출력 |
| 현재 가격 (할인) | $1.25 입력 / $3.75 출력 | $2 입력 / $6 출력 |
| 이미지 입력 | 아니요 | 예 |
| 공개된 아키텍처 | 미공개 | 총 2.4조, 활성 MoE 950억 |
| 개방형 가중치 | 미출시 | "다음 주"(~8월 10일) 약속됨 |
| 컨텍스트 창 | 100만 토큰 | 100만 토큰 |
이제 세부 사항입니다.
벤치마크 차이: 실제 성능 향상 지점
주요 개선 사항은 에이전트 작업, 즉 모델이 계획하고 실행하며 자체 수정하는 장기적인 작업에 집중되어 있습니다.
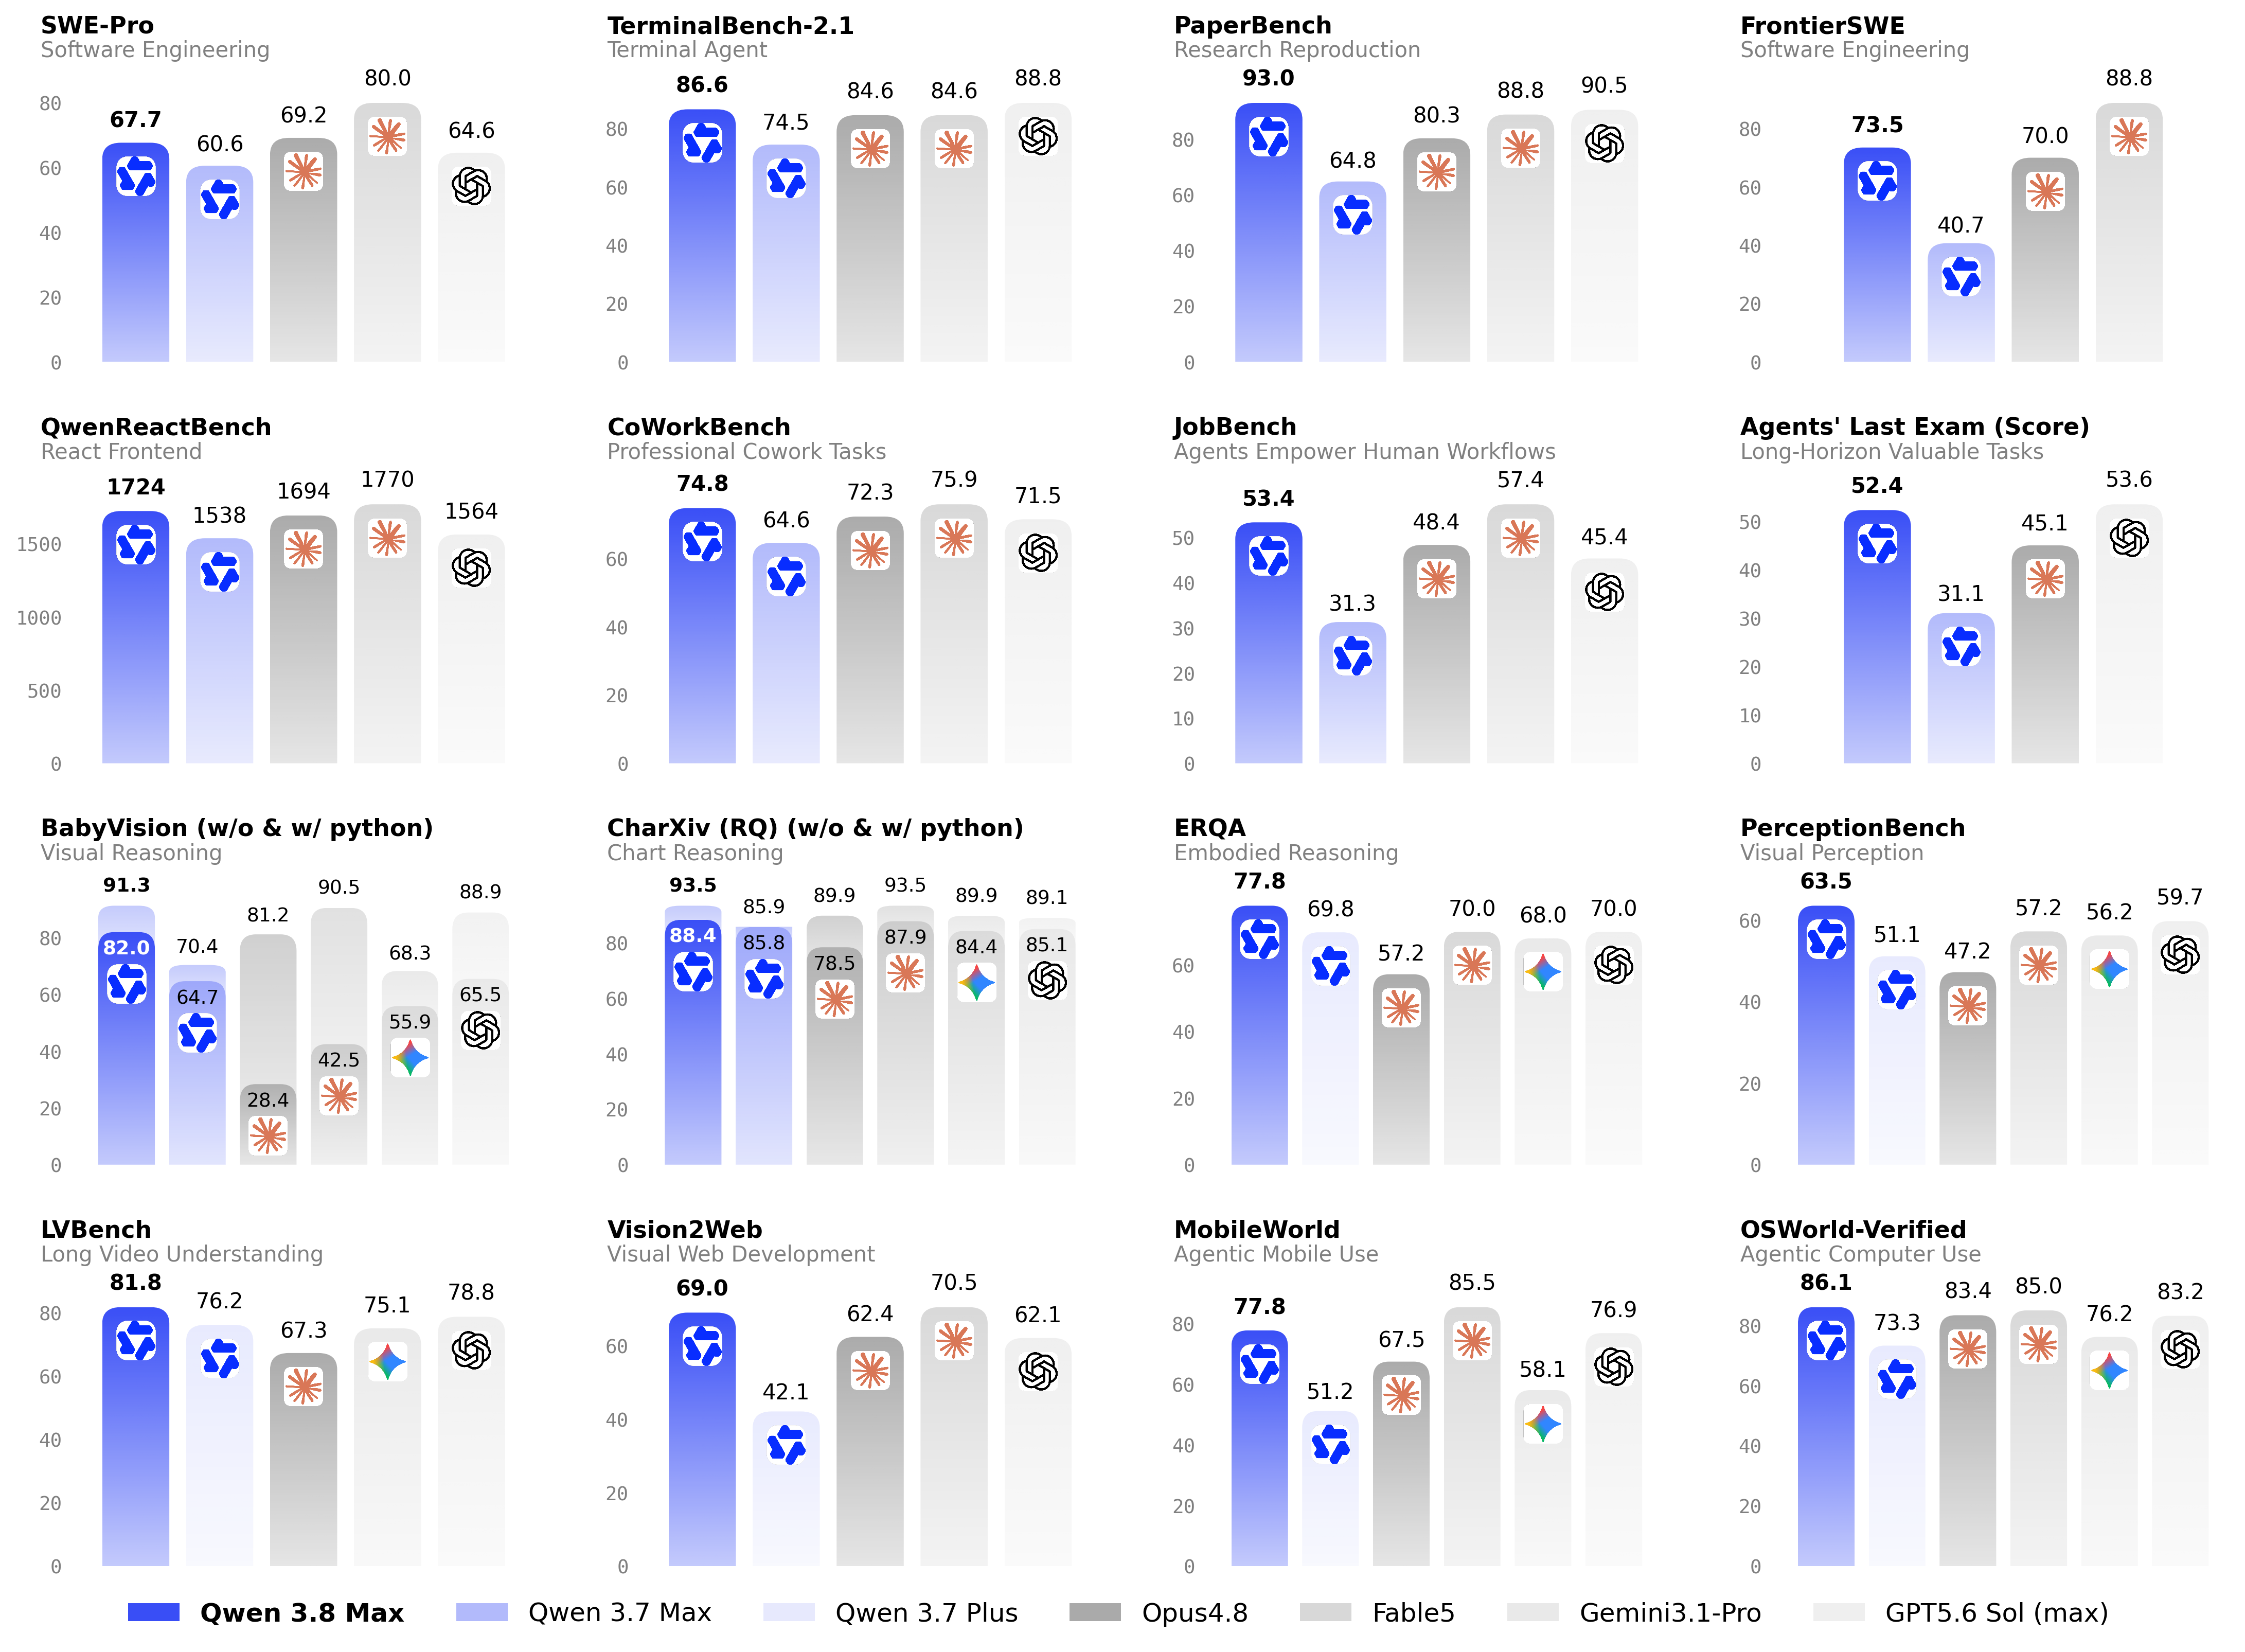
터미널 벤치 2.1: 74.5에서 86.6으로. 터미널 기반 에이전트 작업에서 12점 상승한 수치로, Qwen은 확실히 뒤쳐져 있던 상태에서 진정으로 경쟁력 있는 위치로 올라섰습니다. 동일한 표에서 Alibaba는 Claude Opus 4.8과 Fable 5에 각각 84.6점을 부여했는데, 이는 3.8-Max가 이 항목에서 두 모델을 모두 앞서는 수치입니다. GPT-5.6 Sol은 여전히 88.8점으로 선두를 유지하고 있습니다.
SWE-bench Pro: 60.6에서 67.7으로. 실제 소프트웨어 엔지니어링 작업에서 7점 상승했습니다. 의미 있는 결과이지만, 솔직히 말하자면 동일한 표에서 Fable 5는 80.0점에 머물러 있으므로, 이는 따라잡는 과정이지 추월한 것은 아닙니다. 만약 SWE-bench Pro 성능이 주요 구매 기준이라면, 최첨단은 여전히 다른 곳에 있습니다.
PaperBench: 64.8에서 93.0으로. 표에서 가장 큰 단일 차이로, AI 연구 논문을 재현하는 능력에서 28점이나 크게 도약했습니다. 이는 또한 3.8-Max의 최고 플래그십 항목으로, Alibaba 비교 대상의 모든 경쟁자를 앞섰습니다. 만약 작업 부하가 연구 재현, 긴 기술 문서 또는 다단계 과학적 추론과 관련되어 있다면, 이 수치가 주목해야 할 부분입니다.
IFBench: 79.1에서 82.8으로. 지시 따르기(Instruction following) 능력이 거의 4점 향상되었습니다. 주목할 점은 3.7-Max가 이미 이 분야에서 강했으며(79.1점은 동일한 실행에서 Opus 4.8과 Fable 5를 이겼습니다), 이는 약점을 고치는 것이 아니라 기존의 강점을 더욱 확장한 것입니다.
GPQA 다이아몬드: 92.4에서 92.6으로. 사실상 변동이 없습니다. 대학원 수준의 과학 QA는 3.7-Max에서도 이미 포화 상태에 가까웠으며, 새 모델은 이를 움직이지 못했습니다. 작업 부하가 GPQA와 유사하다면, 업그레이드는 품질 측면에서 아무런 이득을 주지 않습니다.
HLE: 41.4에서 43.6으로. 인류의 마지막 시험(Humanity's Last Exam)은 2점 향상되었지만 여전히 최첨단에는 뒤쳐집니다. 동일한 표에서 Fable 5는 53.3점, GPT-5.6 Sol은 47.2점을 기록했습니다. Qwen 3.8-Max는 여러 부분에서 격차를 좁혔지만, 이 부분은 해당되지 않습니다.
패턴: 에이전트 및 연구 벤치마크에서 엄청난 성능 향상, 지시 따르기(instruction following)에서 점진적인 향상, 포화된 지식 벤치마크에서는 변동 없음, 그리고 가장 어려운 추론 평가에서는 지속적인 격차를 보였습니다. 하네스 및 자체 벤치마크에 대한 세부 사항을 포함하여 전체 표에 대한 더 깊은 내용은 Qwen 3.8 벤치마크 분석을 참조하십시오.
아키텍처: Alibaba, 마침내 수치를 공개하다
Qwen 3.8-Max는 Qwen 3.5 아키텍처 기반 위에 구축된, 순방향 패스당 950억 개의 활성 매개변수를 가진 총 2.4조 개의 매개변수 혼합 전문가(MoE) 모델입니다. 이는 대략 4%의 활성화 비율인데, 이는 서비스 비용에 중요합니다. 즉, 2.4조가 아닌 950억 개의 계산에 대해 비용을 지불합니다.
3.7-Max와의 대조점은 바로 공개 여부입니다. Alibaba는 Qwen 3.7-Max에 대해 비교 가능한 규모 수치를 발표한 적이 없습니다. 매개변수 개수, 활성화 비율, 전문가 구성 등 모든 것이 미공개였습니다. 3.8-Max에서는 모델 스튜디오 모델 문서와 출시 게시물에서 아키텍처를 자세히 설명하여, 용량 계획 및 비용 모델링이 훨씬 덜 추측 게임이 되었습니다.
개방형 가중치 경쟁 맥락에서: Kimi K3는 총 2.8조, 활성 1040억 개의 매개변수로 실행됩니다. Qwen 3.8-Max는 두 축 모두에서 더 작습니다.
멀티모달: 3.7-Max가 결코 가지지 못했던 기능
Qwen 3.7-Max는 텍스트 모델입니다. Qwen 3.8-Max는 이미지 입력을 기본적으로 지원하며, Alibaba는 Gemini 3.1 Pro 및 GPT-5.6 Sol에 대해 대부분의 항목에서 선두를 차지하는 별도의 멀티모달 벤치마크 표를 공개했습니다.
Alibaba의 멀티모달 표에서 눈에 띄는 점수: MathVision 95.2점, LogicVista 91.9점, 그리고 컴퓨터 사용 작업에 대한 OSWorld-Verified 86.1점입니다. 해당 표에는 3.7-Max 열이 비교 대상으로 없는데, 그럴 수밖에 없습니다. 이전 모델은 이미지를 처리하지 않습니다.
실질적으로, 이는 이전에 별도의 비전 모델로 라우팅해야 했던 워크로드(스크린샷 이해, 문서 이미지, UI 자동화, 차트 추출)가 이제 텍스트 트래픽과 동일한 모델 ID에서 실행될 수 있음을 의미합니다. 출시 게시물은 또한 긴 문서 및 비디오 이해를 시연하지만, 이는 별개의 API 입력 유형이라기보다는 블로그에서 시연된 기능이므로, 특정 사례에 대해서는 API 문서를 통해 확인하십시오.
가격: 현재를 제외하면 새 모델이 더 저렴함
여기서 업그레이드 계산이 흥미로워집니다.
Qwen 3.8-Max는 전체 100만 컨텍스트에 걸쳐 단일 고정 티어로 100만 토큰당 $2 입력 / $6 출력으로 출시됩니다. Qwen 3.7-Max의 정가는 $2.5 / $7.5입니다. 따라서 새로운, 더 유능한 모델이 이전 모델의 정가보다 20% 저렴하게 출시되었습니다. 플래그십 세대 교체에서는 거의 발생하지 않는 일입니다.
하지만 함정이 있습니다. Alibaba는 현재 3.7-Max에 대해 50% 한정 프로모션을 진행 중이며, 이로 인해 실제 요금은 $1.25 / $3.75가 됩니다. 현재 가격 기준으로, 이전 모델은 새 모델보다 38% 저렴합니다. 모든 요금은 공식 모델 스튜디오 가격 페이지에서 확인할 수 있습니다.
두 가지 사항을 염두에 두십시오:
- 프로모션은 종료될 수 있습니다. Alibaba는 이를 한정 기간이라고 명시했지만, 종료 날짜는 공개하지 않았습니다. $1.25 / $3.75를 기준으로 아키텍처를 설계한다면, 예산 가정에는 보이지 않는 만료일이 있습니다. 정가 기준으로는 3.8-Max가 더 저렴한 모델입니다.
- 추론 토큰이 실제 청구 금액을 부풀립니다. Qwen 3.8-Max는 기본적으로
reasoning_effort: xhigh로 설정되며, 추론 토큰은 출력으로 청구됩니다. 요청당 실제 비용은 명시된 가격보다 훨씬 높을 수 있습니다. 저희의 Qwen 3.8 가격 가이드는 캐시 경제학과 작업당 비용 계산을 다룹니다.
만약 두 Max 모델 모두 예산에 맞지 않는다면, $0.4 / $1.6($20% 할인 중)의 qwen3.7-plus가 여전히 가성비 티어로 남아있습니다. Plus vs Max 비교는 Plus가 충분한 경우를 다룹니다.
개방형 가중치: Max 클래스 최초
Qwen Max 클래스 모델 중 개방형 가중치를 제공한 모델은 없었습니다. Qwen 3.7-Max는 제공하지 않았고, Alibaba는 그렇게 할 것이라고 시사한 적도 없습니다. Qwen 3.8-Max는 이러한 패턴을 깨고, 출시 게시물에서 "다음 주"(대략 8월 10일경) Hugging Face와 ModelScope에 가중치를 제공할 것을 약속했습니다.
이 글을 쓰는 시점(2026년 8월 3일) 현재, 가중치는 다운로드할 수 없습니다. 이 약속을 약속으로 받아들이십시오. 이전 사례는 고무적입니다. Kimi K3의 가중치는 출시 11일 후에 공개되었고, Alibaba는 더 작은 Qwen 모델에 대해 오랜 개방형 가중치 제공 기록을 가지고 있습니다. 하지만 2.4조 매개변수 다운로드는 양자화된 상태에서도 다중 노드 자체 호스팅 프로젝트이므로, 대부분의 팀에게 실질적인 영향은 서드파티 호스팅 액세스와 가격 압력이 될 것이며, 자체 서버에서 모델을 실행하는 것은 아닐 것입니다.
만약 개방형 가중치가 조달 또는 규정 준수에 중요하다면, 그것만으로도 3.7 대 3.8의 질문을 해결할 수 있습니다. 한 모델은 (아마도) 그것을 가질 것이고, 다른 모델은 결코 가지지 않을 것입니다.
변하지 않은 것
업그레이드 게시물은 과대 포장하는 경향이 있으므로, 명확히 밝힐 가치가 있습니다:
- 컨텍스트 창: 둘 다 100만 토큰. 확장은 없습니다. 긴 컨텍스트를 위해 3.7-Max를 선택했다면, 3.8-Max도 동일하게 100만 토큰을 유지하며 전체 창에 걸쳐 동일한 가격이 적용됩니다.
- 접근 경로: 동일. 두 모델 모두 OpenAI 호환 엔드포인트를 통해 Alibaba Cloud Model Studio를 통해 서비스됩니다. 전환은 모델 ID 변경(
qwen3.7-max에서qwen3.8-max로)일 뿐, 마이그레이션 프로젝트가 아닙니다. 3.8-Max는 추가적으로 Anthropic 호환 API 표면을 제공하며, 만약 사용하는 툴링이 해당 프로토콜을 지원한다면 Apidog와 같은 클라이언트에서 활용해볼 가치가 있습니다. - 추론 제어: 이제 공식 기능.
reasoning_effort는 3.8-Max에서 문서화되고 지원되는 매개변수로,enable_thinking및preserve_thinking과 함께 세 가지 수준(기본값은 xhigh, 중간, 낮음)을 제공합니다. 3.7-Max에서 암묵적인 추론 동작을 중심으로 프롬프트를 조정했다면, 이제 명시적인 다이얼을 사용할 수 있습니다.
업그레이드해야 할까요? 세 가지 솔직한 경로
지금 바로 업그레이드하세요. 작업 부하가 에이전트 기반이거나 연구 중심적이라면 지금 업그레이드하십시오. 터미널 벤치(74.5에서 86.6) 및 PaperBench(64.8에서 93.0)의 차이는 프로덕션 환경에서 체감할 수 있는 종류의 도약이며, 이미지 입력과 더 낮은 정가는 보너스로 얻을 수 있습니다. 터미널을 작동하거나, 기술 작업을 재현하거나, 스크린샷을 처리하는 에이전트를 구축 중이라면, 업그레이드 사례는 명확합니다.
3.7-Max 프로모션을 이용하세요. 작업 부하가 변동이 없는 영역에 속한다면 3.7-Max 프로모션을 활용하십시오. GPQA 스타일 지식 작업은 0.2점 이동했습니다. 트래픽이 Q&A, 요약 또는 일반 채팅이고 3.7-Max가 이미 품질 기준을 충족한다면, $1.25 / $3.75는 두 Max 모델 중 토큰당 최고의 거래입니다. 프로모션 상태를 매달 다시 확인할 수 있도록 캘린더 알림을 설정하고, 대체 가격은 정가 기준 3.7-Max가 아닌 $2 / $6의 3.8-Max임을 알아두십시오.
qwen3.7-plus로 전환하세요. 가격에 민감하고 작업이 일상적인 경우라면 $0.4 / $1.6의 qwen3.7-plus로 전환하십시오. 이는 입력 기준으로 3.8-Max보다 5배 저렴하며, 분류, 추출 및 템플릿 기반 생성 작업에서는 Max 클래스 기능이 종종 낭비되는 지출입니다.
결정하기 전에 전환을 테스트하세요
벤더 벤치마크는, 내부적으로 일관성이 있더라도, 모델이 귀하의 프롬프트에서 어떻게 작동할지 예측하지 못합니다. 이를 해결하는 저렴한 방법은 실제 작업 부하에 대해 병렬로 비교해보는 것입니다.
Apidog에서는 몇 분 만에 이를 설정할 수 있습니다. 한 컬렉션을 모델 스튜디오의 OpenAI 호환 엔드포인트로 지정한 다음, 모델 ID 변수만 다른 두 개의 환경을 생성합니다. 하나는 qwen3.7-max로, 다른 하나는 qwen3.8-max로 설정합니다. 동일한 요청 세트를 두 환경에 대해 실행하고, 한 번의 클릭으로 환경을 전환하며, 응답 뷰어에서 출력, 지연 시간 및 토큰 사용량을 비교할 수 있습니다. 두 모델 모두 동일한 API 표면을 공유하므로, 단일 컬렉션으로 두 모델을 모두 처리할 수 있으며, 대표적인 프로덕션 프롬프트를 테스트 시나리오로 저장하고 Alibaba가 업데이트를 출시하거나 프로모션 가격이 변경될 때마다 다시 실행할 수 있습니다.
이는 "업그레이드해야 할까?"라는 벤치마크 논쟁을 오후의 실제 증거 수집으로 바꿉니다. 프로덕션 구성을 변경하기 전에 Apidog를 무료로 다운로드하여 실제 트래픽에 대해 비교를 실행해 보세요.
자주 묻는 질문
Qwen 3.8-Max는 Qwen 3.7-Max보다 저렴합니까?
정가 기준으로는 그렇습니다: 100만 토큰당 $2 / $6 대 $2.5 / $7.5입니다. 현재 실제 가격 기준으로는 아닙니다: 3.7-Max의 한정 기간 50% 프로모션으로 인해 $1.25 / $3.75가 되어 3.8-Max보다 38% 저렴합니다. 이 프로모션은 공개된 종료 날짜가 없습니다. 전체 비용 분석은 저희의 Qwen 3.8 가격 가이드를 참조하십시오.
qwen3.7-max에서 qwen3.8-max로 전환하려면 코드를 변경해야 하나요?
기본적인 사용의 경우, 아니요. 두 모델 모두 동일한 OpenAI 호환 모델 스튜디오 엔드포인트를 통해 서비스되므로, 전환은 모델 ID 교체입니다. 3.8-Max는 기본적으로 xhigh로 설정되며 추론 토큰이 출력으로 청구되므로, reasoning_effort를 명시적으로 설정하는 것이 좋습니다. 이미지를 전송하는 경우, 이는 3.8-Max 전용 기능이며 표준 이미지 입력 메시지 형식이 필요합니다.
Qwen 3.7-Max는 개방형 가중치를 가지고 있습니까?
아니요, Alibaba의 이전 사례를 볼 때 앞으로도 없을 것입니다. Qwen 3.8-Max는 개방형 가중치를 약속한 최초의 Max 클래스 모델이며, 2026년 8월 10일경 Hugging Face와 ModelScope에 공개될 것으로 예상됩니다. 8월 3일 현재, 아직 다운로드할 수 없습니다.
Qwen 3.8-Max가 이제 Claude나 GPT보다 낫습니까?
항목에 따라 다릅니다. 그리고 이는 Alibaba 자체 수치임을 기억하십시오. Alibaba의 표에 따르면, 3.8-Max는 터미널 벤치 2.1에서 Opus 4.8과 Fable 5를 이겼고, PaperBench와 IFBench에서는 모든 경쟁자를 앞섰습니다. 하지만 SWE-bench Pro에서는 Fable 5에 크게 뒤쳐지며(67.7 대 80.0), HLE에서는 최첨단 모델들보다도 뒤쳐집니다. 아직 독립적인 벤치마크 수치가 존재하지 않으므로, 제3자 평가가 나올 때까지 최종 판단을 보류하십시오.