
Jev는 TypeSafe AI의 시스템 원 모델입니다. 프로그램 상태와 유형화된 질문을 보내면, 산문 대신 보정된 확률을 포함한 결정을 반환합니다. (이것은 모델 Jev를 의미하며, 스트리머 FaZe Jev 또는 JEV 백신을 의미하지 않습니다.) 가중치가 비공개이며, API를 통해서만 `jev-latest`로 `POST https://api.typesafe.ai/v1/systemone`에서 제공됩니다. 따라서 "Jev를 로컬에서 실행"하는 것은 Jev 자체를 의미할 수 없습니다. 이는 OpenJev가 이끄는, 오픈 모델로 아이디어를 재현하는, 며칠 된 커뮤니티 프로젝트들의 모음을 의미합니다. 모델 자체에 익숙하지 않다면, 먼저 Jev가 무엇인지 읽어보세요. 이 글은 모방 프로젝트들을 다룹니다.
이 글은 각 README가 주장하는 내용, 충실도, 필요한 하드웨어, 그리고 TypeSafe API를 테스트하는 방식과 동일하게 Apidog의 로컬 HTTP 엔드포인트를 통해 이들 중 하나를 테스트하는 방법을 총정리하고 현실을 점검합니다. 이들 중 어느 것도 제3자에 의해 벤치마크되지 않았으며, TypeSafe에서 나온 것도 없습니다.
로컬에서 "Jev 실행"이 의미할 수 있는 것
TypeSafe의 출시 게시물은 RLCD(Reinforcement Learning for Calibrated Decisions)로 훈련된 모델, 세 가지 기본 요소(noul, choice, score), 70ms에서 500ms의 응답 시간, 그리고 출력 무료에 백만 입력 토큰당 $0.042의 비용을 설명합니다. 이는 공급업체의 주장이며, 훈련 방식은 공개되지 않았습니다. 한 커뮤니티 스레드에서는 Jev가 100% 합성 데이터로 훈련되었다고 언급했습니다. 이는 확인되지 않은 소문으로 간주해야 합니다.
훈련 방식이 비밀이기 때문에, 모든 "오픈 Jev"는 다음 세 가지 지름길 중 하나를 택합니다:
- 고정된 채팅 모델에서 로짓 읽기. 작은 Qwen 모델에 객관식 질문을 던지고, 생성 과정을 건너뛰고, 각 옵션에 대한 다음 토큰 로짓을 확률로 변환합니다. OpenJev와 mini-jev가 이 방식을 사용합니다.
- 작은 스코어러를 처음부터 훈련. N개의 옵션을 한 번에 컨텍스트에 대해 점수 매기는 것만을 담당하는 모델입니다. jevlike가 이 방식입니다.
- 디코딩 엔진 변경. 기본 모델을 유지하고, 제한된 후보에 대해 모든 필드를 병렬로 평가합니다. 이는 Hugging Face의 Apple Silicon 엔진과 vLLM 풀 리퀘스트에서 사용하는 방식입니다.
이들 중 어느 것도 RLCD를 재현하지 못합니다. 이것이 솔직한 결론입니다.
OpenJev: 3090 하나에서 고정된 Qwen의 로짓 읽기
OpenJev는 “집에서 3090으로 Jev와 비슷한 것을 실행할 수 있을까?”라는 질문에 MIT 라이선스 파이썬 패키지로 답합니다. README는 다음과 같이 신중하게 언급합니다: "이 프로젝트는 오픈 모델로 인터페이스 패턴을 재현하지만, Jev의 비공개 모델이나 훈련 방식을 재현하지는 않습니다."
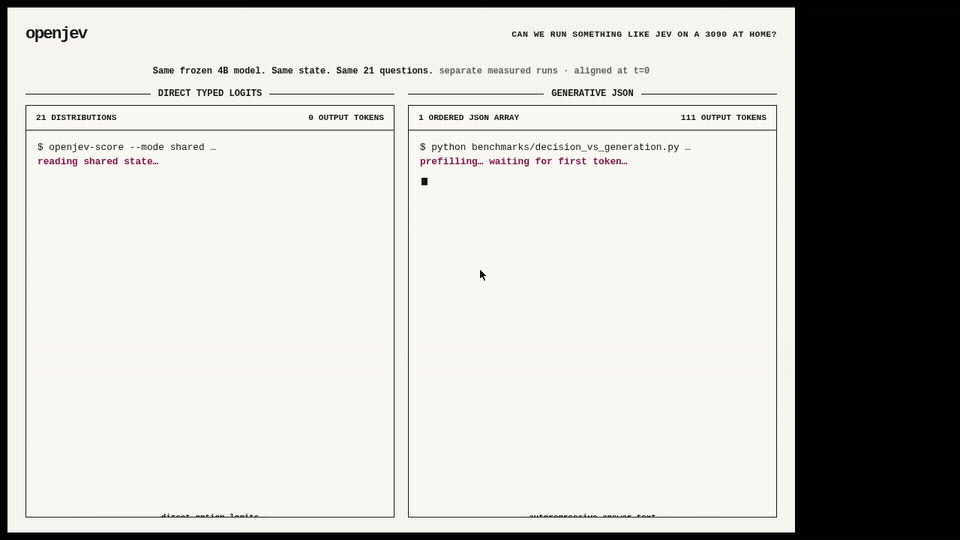
이 메커니즘은 선언된 옵션 로짓을 읽는 단 한 번의 순방향 통과이며, 답변 토큰은 샘플링되지 않습니다. 기준과 옵션은 각 요청과 함께 전달되므로, 작업별로 미세 조정되는 것은 없습니다. 주요 모델은 Qwen3.5-4B입니다.
Qwen3.5-4B와 RTX 3090 한 대로 README가 보고하는 수치:
- 직접 유형화된 로짓: 21개 확률 쌍에 1.023초, 자동 회귀 JSON 배열의 5.332초 대비 5.21배 느립니다.
- 102개 행의 TypeSafe 하위 집합에서 Jev의 공개된 수치인 0.883 대비 0.845의 모달 일치율을 보입니다.
입력은 `id`, `state`, `question`, 그리고 `{id, description}` 형태의 `options` 배열을 포함하는 JSONL이며, 출력은 옵션당 확률입니다. 레포지토리에는 HTTP 서버가 없습니다: `openjev-score --mode direct --model Qwen/Qwen3.5-4B --input examples/decisions.jsonl`를 실행하거나 openjev.com에서 WebGPU 데모를 사용해볼 수 있습니다. 하드웨어: CUDA 및 BF16으로 4B 모델을 담을 수 있는 GPU.
누락된 사항: noul 또는 score 기본 요소 없음, 그리고 확률은 RLCD로 보정된 신뢰도가 아닌 옵션 로짓에 대한 소프트맥스입니다.
mini-jev: 로컬 서버를 사용한 사전 등록 연구
mini-jev는 제품이라기보다는 실험에 가깝습니다. 그 슬로건은 "고정된 Qwen3-4B에서 Jev 스타일 인터페이스가 어떻게 보이는지, JSON 생성 대신 옵션 문자의 로짓을 읽는 방식"입니다. 이는 CLINC150 의도 분류에 Qwen3-4B-Instruct-2507을 실행하고, 문법 제약이 있는 JSON 생성과 옵션 문자의 로짓 읽기를 비교합니다.
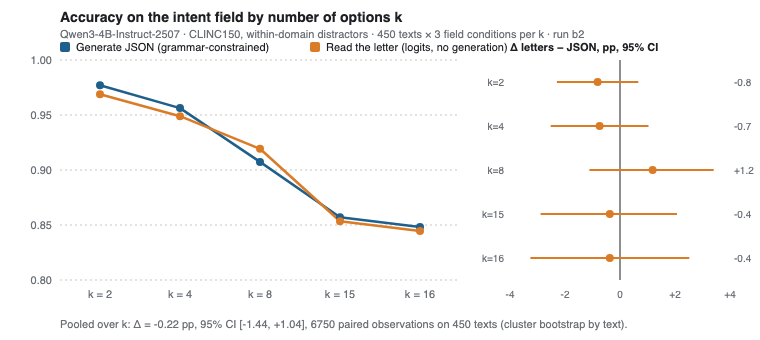
6,750쌍의 관찰 결과: JSON은 0.909 정확도, 문자는 0.907 정확도를 보였으며, 95% 신뢰 구간 [-1.44, +1.04] 내에서 -0.22점의 차이를 나타냈습니다. 문자 읽기는 32토큰 텍스트에서 약 4배 더 빨랐습니다.
README는 자체 용어를 TypeSafe의 용어에 매핑합니다: choice와 noul은 "고정된 모델에서 읽은 문자 및 불리언으로 이 연구가 측정하는 것; score(순서가 있는 척도)는 측정되지 않았다"고 설명합니다. 이는 "용어의 일치이지 모델의 재현이 아니다"라고 말하며, 이 글의 모든 프로젝트가 복사해야 할 주의 사항을 추가합니다: "문자 공유는 신뢰도 간격을 가진 순위일 뿐, 보정된 확률이 아닙니다."
HTTP 데모가 포함되어 있습니다. `MINIJEV_DEVICE=mps uv run python demo/server.py`는 `127.0.0.1:8765`에서 `POST /run`을 제공하며, 이는 `schema`와 `text`를 받아 필드별 `letter`, `p`, `gap`, `answer`를 반환합니다. Apple Silicon 또는 NVIDIA GPU에서 약 8.5GB의 메모리가 필요합니다. MIT 라이선스, 작성 시점 기준 별 11개입니다.
jevlike: 처음부터 만드는 옵션 스코어러
jevlike는 "역설계된 Jev 유사 모델"로 공유되고 있습니다. README는 다르게 말합니다: "TypeSafe는 설계를 공개하지 않았습니다. 이 리포지토리는 동일한 입출력 형태를 가진 독립적인 스타터 모델입니다." 저자들은 "Jev와 동등한 품질을 보여주거나 TypeSafe의 비공개 훈련 방식을 재현하지 않았다"고 덧붙였습니다.
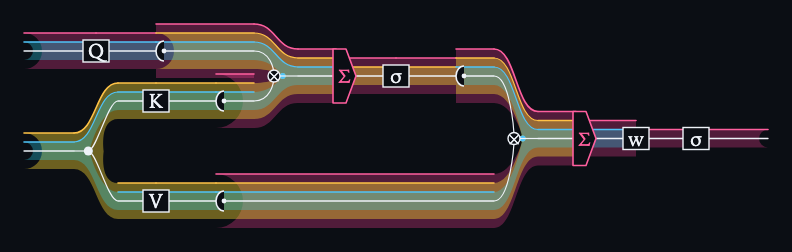
설계는 작습니다. 각 옵션은 컨텍스트 토큰에 어텐션하는 쿼리 벡터를 얻고, 공유된 내적곱이 각 쌍의 점수를 매기며, 소프트맥스가 점수를 확률로 변환합니다. 기본 인코더는 처음부터 학습된 바이트 임베딩이며, 선택적으로 고정된 Hugging Face 인코더를 사용할 수 있습니다.
보고된 수치: 합성 메뉴에서 약 98%, Wikispeedia에서는 8% 무작위 대조군 대비 고정된 Qwen2.5-0.5B 인코더로 26%, 그리고 한 번의 통과가 "400토큰을 작성하도록 강제된 작은 디코더보다 약 100배 빠르다"고 합니다. CPU, MPS 또는 CUDA에서 실행됩니다. MIT 라이선스, 별 764개.
이 그룹에서 충실도가 가장 낮습니다. 자체 레이블로 훈련시키므로, 임의의 기준을 전달할 수 있는 결정 모델이 아니라 직접 만든 분류기입니다. noul 또는 score 없음, 보정 주장은 없음, HTTP 서버 없음.
병렬 제약 디코딩: Apple Silicon 엔진
Hugging Face Space의 병렬 제약 디코딩은 "Typesafe.ai Jev 오픈 소스 대안"으로 유포되고 있지만, README에는 Jev, TypeSafe 또는 RLCD가 전혀 언급되지 않습니다. 이 프로젝트의 제목은 "Apple Silicon을 위한 병렬 제약 디코딩"이며, `mlx-community/Qwen2.5-1.5B-Instruct-4bit`에서 구조화된 추출을 위한 MLX 추론 엔진으로, 모든 `mlx-lm` 디코더를 교체할 수 있습니다.
방법: 컨텍스트를 KV 캐시에 한 번 미리 채우고, 모든 스키마 필드에 브로드캐스트하며, 필드별로 유효한 후보 토큰 ID만 평가하고, 해당 집합에 소프트맥스를 적용한 후, 코드로 JSON을 조립합니다. README는 M4 Max에서의 결과를 보고합니다: 4개 필드 사기 분류에서 자동 회귀는 420ms 대 병렬은 75ms (5.6배), 28개 필드 지원 분류에서 1,900ms 대 270ms (7.0배)입니다. 자유 텍스트를 샘플링하지 않으므로 100% 스키마 유효성을 주장합니다.
이 프로젝트는 uvicorn을 통해 8000번 포트에서 HTTP를 제공하며, `parsed_json`과 필드별 신뢰도를 포함한 `field_telemetry`를 반환합니다. 요구 사항: M1 이상 Mac, macOS 14+ 버전. Apache 2.0 라이선스. 정확도 수치는 없고 지연 시간만 있으며, 여기서 "보정됨"은 훈련된 보정이 아니라 후보에 대한 정확한 소프트맥스를 의미합니다.
vLLM PR 57250: DiffusionGemma용 Jev 유사 모드
vLLM 풀 리퀘스트 #57250(9월 16일 개설되어 아직 열려 있음)은 DiffusionGemma를 저자가 "보정된 객관식 기계"라고 부르는 형태로 변환합니다. 이는 단일 토큰 답변 슬롯을 가진 시드 캔버스이며, 단계 제한 내에서 읽히고, 로그 확률과 엔트로피에서 신뢰도를 얻습니다. 새로운 `vllm_xargs` 필드에는 `diffusion_seed_canvas`, `diffusion_max_steps`, `diffusion_read_only`가 포함되며, 예시 `structured_server.py`는 스키마를 캔버스로 변환합니다.
이 PR은 단일 캔버스 읽기에서 초당 8.7 요청, 32방향 동시성에서 54 요청, 그리고 언어 분류 말뭉치에서 대략 90%의 정확도를 보고합니다. 한 검토자는 경합 조건 테스트 누락과 제한 없는 스레드 생성을 블로킹 요인으로 지적했습니다. 병합되기 전까지는 배포할 것이 아니라 읽어볼 디자인입니다.
각각의 충실도는 얼마나 될까요?
| 프로젝트 | 기본 모델 | 기본 요소 | 보정 | HTTP 서버 | 하드웨어 |
|---|---|---|---|---|---|
| OpenJev | Qwen3.5-4B, 고정됨 | choice | 옵션 로짓에 대한 소프트맥스 | 아니요 (CLI + 브라우저 데모) | RTX 3090급, CUDA |
| mini-jev | Qwen3-4B-Instruct, 고정됨 | choice, noul | 간격을 가진 순위 | 예, 8765번 포트 | 8.5 GB 메모리, MPS 또는 CUDA |
| jevlike | 훈련하는 인코더 | choice | 주장된 것 없음 | 아니요 | CPU, MPS 또는 CUDA |
| MLX 엔진 | Qwen2.5-1.5B-Instruct-4bit | 스키마 필드 | 후보에 대한 소프트맥스 | 예, 8000번 포트 | Apple Silicon, macOS 14+ |
| vLLM PR | DiffusionGemma | 예/아니오, choice, scale | 로그 확률 및 엔트로피 | 예, OpenAI 호환 | vLLM급 GPU, 병합 안 됨 |
모든 항목은 로짓을 읽는 고정되거나 자체 훈련된 모델입니다. 이것은 Jev의 형태, 즉 유형화된 답변, 옵션당 확률, 한 번의 순방향 통과를 제공합니다. 하지만 RLCD가 이 확률들을 정직하게 만든다는 Jev의 핵심 주장을 얻지는 못합니다. OpenJev의 0.845 대 0.883은 실제 모델과의 유일한 비교이며, 이는 저자 자체의 평가입니다. 설정은 Kimi K3를 로컬에서 실행하는 가이드와 일치합니다: 가중치, GPU 또는 M-시리즈 Mac, 로컬 포트.
실제 Jev API처럼 Apidog에서 이들 중 하나를 테스트하기
로컬 재현의 목적은 통합을 다시 작성하지 않고도 실제 API로 교체하는 것이므로, 테스트는 동일한 본문을 양쪽에 보내야 합니다. 이 프로젝트들 중 어느 것도 Jev의 `{model, state, questions}` 스키마를 기본적으로 이해하지 못합니다. 실행하는 프로젝트 앞에 얇은 어댑터를 두세요: Jev 본문을 받아들이고, 도구를 호출하며, `choice`, `probabilities`, `confidence` 키를 가진 `{"answers": {...}}`를 반환하는 40줄짜리 FastAPI 앱입니다. 이제 Apidog는 하나의 계약을 보게 됩니다.
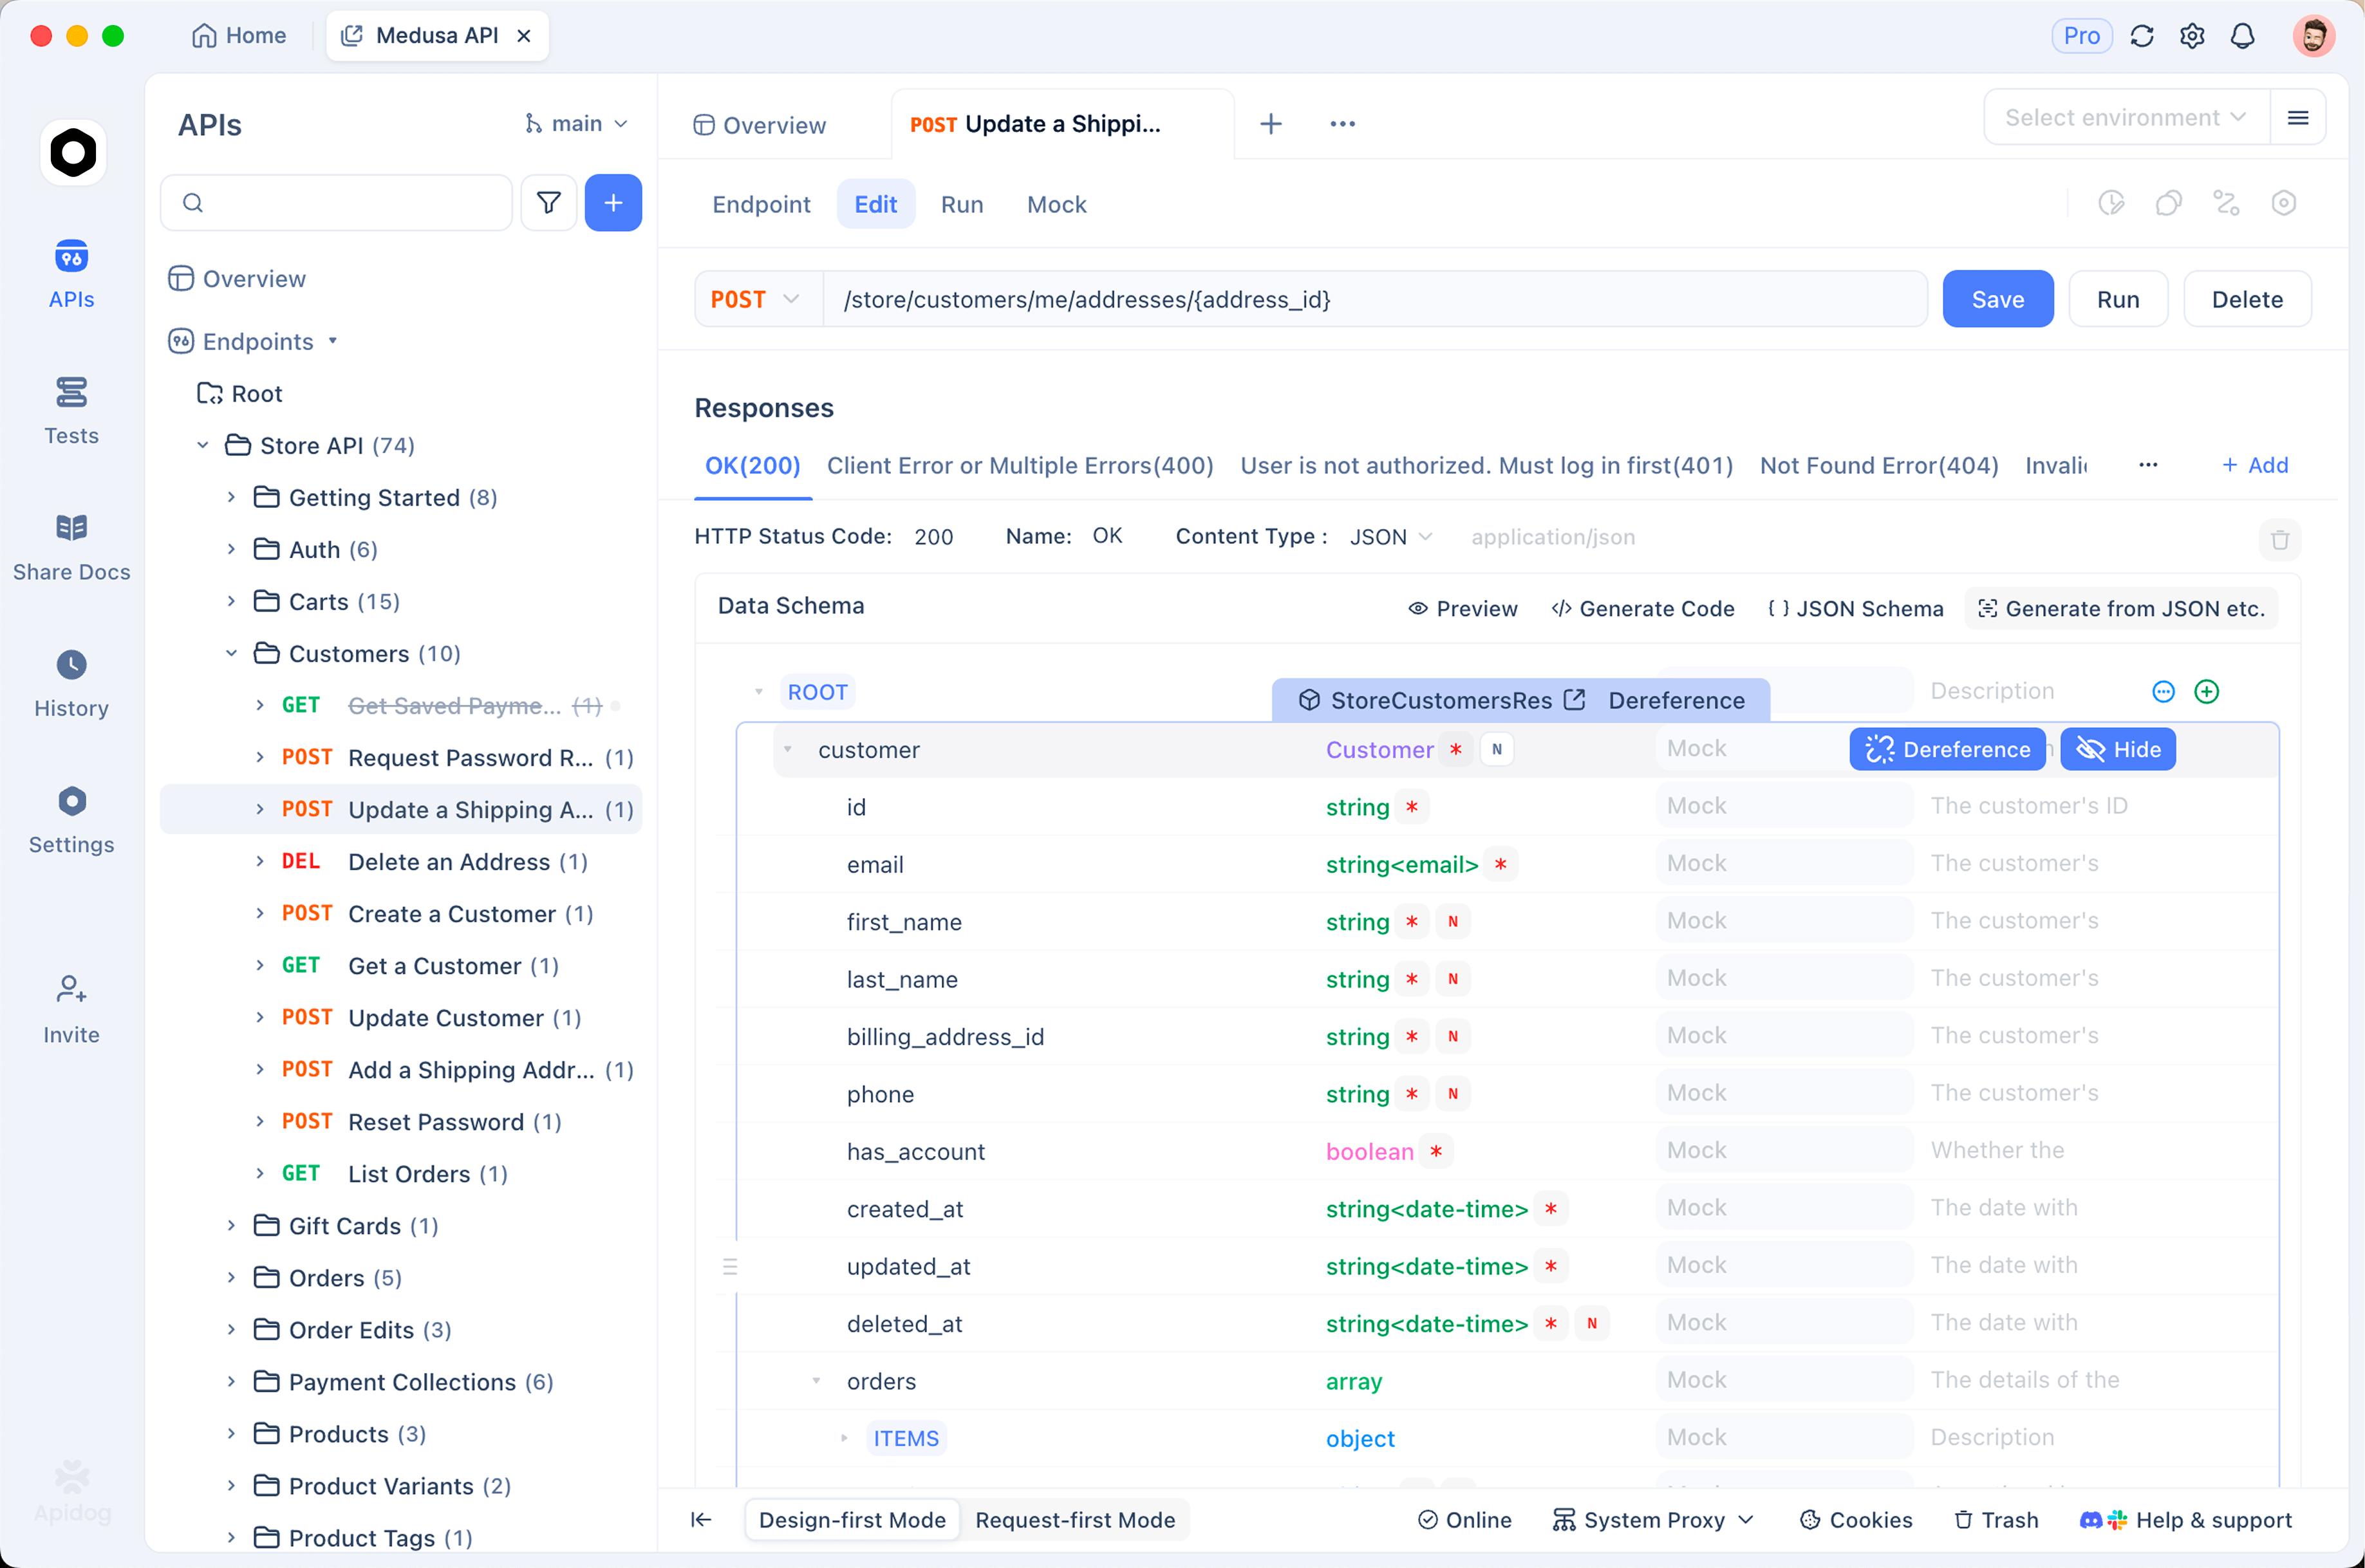
두 개의 환경, 하나의 요청 세트. `BASE_URL = http://localhost:8765`와 키 없음으로 `Local reproduction`을 생성하고, `BASE_URL = https://api.typesafe.ai`에 `TYPESAFE_API_KEY`를 로컬 필드에 추가하여 팀원에게 동기화되지 않도록 `TypeSafe API`를 생성하세요(범위 규칙은 여기). 모든 요청은 `{{BASE_URL}}/v1/systemone` 및 Bearer `{{TYPESAFE_API_KEY}}`를 사용하며, 로컬 서버는 헤더를 무시합니다.
Jev 본문 전송. `jev-latest`에 보낼 상태와 질문을 포함하여 `POST {{BASE_URL}}/v1/systemone`에 전송:
{
  "model": "jev-latest",
  "state": "My card was charged twice for one order and I need this fixed today.",
  "questions": {
    "department": { "type": "choice", "instructions": "Which team handles this?",
      "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
    "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
  }
}
확률 필드에 대한 어설션. 후처리 어설션을 추가하세요: `answers.department.choice`는 `billing`과 같고; `answers.department.probabilities.billing`은 `0.7`보다 크고; `answers.wants_refund.noul`은 `0.8`보다 크다고. 환경 드롭다운을 변경하고 TypeSafe에 대해 동일한 시나리오를 실행하세요. 두 실행 간의 차이는 README 테이블보다 더 가치 있는 충실도 수치입니다.
프런트엔드가 GPU 시간 없이 안정적인 `answers` 객체에 대해 빌드되도록 **로컬 실행을 모의(mock)로 저장**하세요. 설정하려면 Apidog를 다운로드하세요. 무료 플랜은 사용자 4명을 지원합니다. 채팅 모델에 대한 동일한 패턴은 LLM을 API로 로컬 테스트하기에서 확인할 수 있습니다.
자주 묻는 질문
OpenJev는 Jev와 동일한가요?
아닙니다. OpenJev는 고정된 Qwen3.5-4B에서 옵션 로짓을 읽으며, 이는 README에 명시되어 있습니다. Jev는 TypeSafe가 RLCD로 훈련한 비공개 모델입니다. OpenJev는 자체 저자의 평가에 따라 102개 행 하위 집합에서 Jev와 0.845의 모달 일치율을 보고합니다.
어떤 것을 먼저 시도해야 할까요?
Mac 사용자이고 오늘 HTTP 엔드포인트를 원한다면 mini-jev; NVIDIA GPU를 가지고 있고 Jev와 가장 가까운 공개 비교를 원한다면 OpenJev를 선택하세요. jevlike는 훈련할 레이블링된 데이터가 있는 경우에만 선택하세요.
고정된 모델에서 보정된 확률을 얻을 수 있나요?
로짓만 읽는 것으로는 불가능합니다. mini-jev의 README에서 설명하듯이, 옵션 토큰에 대한 소프트맥스는 간격을 가진 순위입니다. 보정을 위해서는 훈련 또는 레이블링된 데이터 세트에 대한 온도 스케일링과 같은 사후 단계가 필요하며, 이들 중 어느 것도 제공되지 않습니다.
TypeSafe에 비용을 지불하는 것보다 이들 중 하나를 실행하는 것이 더 저렴한가요?
출력 무료에 백만 입력 토큰당 $0.042라는 Jev의 가격은 이미 가장 저렴한 LLM API 제공업체의 최저 수준에 해당합니다. GPU 시간을 고려하면, 로컬 실행은 비용이 아니라 개인 정보 보호 및 오프라인 사용 측면에서 이점이 있습니다.
이 글이 남기는 결론
OpenJev, mini-jev, jevlike, MLX 엔진, 그리고 vLLM PR은 모두 하나의 아이디어를 증명합니다: 결정에 생성된 텍스트가 필요 없으며, 한 번의 통과로 로짓을 읽는 것이 더 빠르다는 것입니다. 이들 중 어느 것도 보정되었다는 것을 증명하지 못했으며, 어느 것도 Jev가 아닙니다. Jev 형태의 어댑터 뒤에서 하나를 실행하고, TypeSafe를 가리키는 두 번째 환경을 유지하며, 어설션이 얼마나 차이가 나는지 결정하도록 하세요.