OpenAI와 Anthropic은 2026년 7월 이후 API 가격을 크게 인하했으며, 그 인하 내용은 각자의 가격 페이지에 그대로 반영되어 있습니다. GPT-5.6 Luna는 하룻밤 사이 80% 인하되었고, GPT-6.1 Sol은 GPT-5.6 Sol의 $5/$30에 맞서 $2/$10에 책정되었으며, Claude Opus 5.5는 캐시 읽기 요금을 60% 인하했고, Claude Haiku 5.5는 Haiku 4.5의 10분의 1 가격에 책정되었습니다. 여러분의 비용 모델, 라우팅 규칙, 예산 알림이 9월 이전에 만들어졌다면, 지금은 그것들이 틀렸습니다. 대체로 여러분에게 유리한 방향으로요. 아래에서는 검증된 인하 전/후 가격, 요청당 계산, 여전히 청구서를 부풀리는 함정, 그리고 코딩 에이전트가 토큰 예산을 테스트로 바꾸게 하는 방법을 다룹니다.
이 글의 출발점은 Max Woolf의 에세이 OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?와 그 Hacker News 스레드입니다. 시장 측면은 2026년 9월 AI 모델 가격 전쟁에서 다뤘으니, 이 글은 팀이 무엇을 바꿔야 하는지에 관한 내용입니다.
검증된 인하 전/후 가격
백만 토큰당 USD (입력 / 출력 / 캐시된 입력), 표준 티어, 롱 컨텍스트 임계값 미만 기준입니다. OpenAI 항목은 2026-10-26에 확인한 OpenAI API 가격 페이지에서 가져왔으며, "인하 전" 가격은 해당 페이지의 아카이브 사본에서 가져왔습니다. Anthropic 항목은 구형 및 신형 모델을 나란히 나열한 Claude 가격 문서에서 가져왔습니다.
| 모델 변경 | 인하 전 | 인하 후 | 변동 | 시기 |
|---|---|---|---|---|
| GPT-5.6 Luna (가격 인하) | $1 / $6 / $0.10 | $0.20 / $1.20 / $0.02 | 전 항목 -80% | 2026-07-30 |
| GPT-5.6 Terra (가격 인하) | $2.50 / $15 / $0.25 | $2 / $12 / $0.20 | -20% | 2026-07-30 |
| GPT-5.6 Sol (프로모션) | $5 / $30 / $0.50 | $4 / $20 / $0.40 | 입력 -20%, 출력 -33% | 2026-08-21 |
| GPT-5.6 Sol 정가에서 GPT-6.1 Sol로 | $5 / $30 / $0.50 | $2 / $10 / $0.10 | 입력 -60%, 출력 -67%, 캐시 -80% | 2026-09-29 |
| GPT-5.6 Luna에서 GPT-6 Luna로 | $0.20 / $1.20 / $0.02 | $0.10 / $0.50 / $0.01 | 입력 -50%, 출력 -58% | 2026-09-22 |
| Claude Opus 5에서 Opus 5.5로 | $5 / $25 / $0.50 | $4 / $20 / $0.20 | 입출력 -20%, 캐시 -60% | 2026-09-22 |
| Claude Fable 5에서 Fable 5.1로 | $10 / $50 / $1 | $10 / $50 / $0.25 | 캐시만 -75% | 2026년 9월 |
| Claude Sonnet 5에서 Sonnet 5.5로 | $2 / $10 / $0.20 | $2 / $10 / $0.10 | 캐시만 -50% | 2026년 9월-10월 |
| Claude Haiku 4.5에서 Haiku 5.5로 | $1 / $5 / $0.10 | $0.10 / $0.50 / $0.01 | -90% (최대 100K 프롬프트) | 2026년 10월 |
동일 모델에 대한 인하는 GPT-5.6 항목뿐이며, 나머지는 더 저렴한 후속 모델이므로 품질과 토큰 수가 다릅니다. Sonnet 5의 $2/$10 출시 가격은 영구 가격이 되었고, 문서에는 $3/$15로의 예정된 전환이 "이루어지지 않을 것"이라고 명시되어 있습니다. GPT-5.6 Sol 할인은 프로모션으로 "최소 2026년 11월 21일까지 제공"됩니다. 인하 전 Luna 및 Terra 가격은 7월 29일자 아카이브된 OpenAI 가격 페이지에 있습니다.
모델별 상세 내용: GPT-5.6 가격 인하, GPT-6 Sol 가격, Claude Haiku 5.5 가격.
가격이 내려간 이유
유일한 1차 출처의 이유는 Anthropic에서 나옵니다. Claude Opus 5.5 발표에서는 이 모델이 "Opus 5보다 서빙에 더 적은 컴퓨팅을 필요로 하며, 가격이 이를 반영한다"고 밝히고, 일반적인 워크로드에서 비용이 40% 낮아진다고 추정합니다. OpenAI의 페이지는 아무런 이유도 제시하지 않습니다. 나머지는 의견입니다:
- 경쟁, 낮은 전환 비용. Woolf는 이제 모델들이 거의 대체재라고 주장합니다. 전환은 하네스의 토글이나 라우터를 통한 새 모델 문자열에 불과합니다. 여러 제공자가 서빙하는 오픈 웨이트 모델(그는 10월 24일 OpenRouter에서 한 DeepSeek Flash 변형에 대해 29개 제공자를 세었습니다)이 하한선을 형성합니다.
- 맞대응. 인하는 두 회사 사이에서 번갈아 이루어지며, 두 회사 모두 9월 22일에 더 저렴한 플래그십을 출시했습니다.
- IPO 시기. Woolf는 두 회사 모두 IPO를 앞두고 있다는 소문이 돌고 있으며 그 시기가 이상하다고 지적합니다. 이는 동기에 관한 추측입니다.
- 효율성. 많은 HN 댓글 작성자는 더 단순한 설명을 제시합니다: 더 나은 캐싱, 더 작은 모델, 더 저렴한 서빙.
Woolf는 또한 Vercel AI Gateway 데이터를 인용합니다: 토큰당 비용은 2026년 4월 수준의 43.3%로 떨어졌지만 총 지출은 증가했습니다. 더 저렴한 토큰은 지출 방식을 바꾸지 않는 한 청구서를 거의 줄여주지 않습니다.
인하가 바꾸는 것: 요청당 계산
캐시 비중이 큰 에이전트 턴
코딩 에이전트의 한 턴을 예로 들어봅시다: 캐시에서 읽은 100,000 토큰의 대화, 2,000개의 새 입력 토큰, 1,000개의 출력 토큰입니다.
| 모델 | 캐시 읽기 | 새 입력 | 출력 | 턴 비용 |
|---|---|---|---|---|
| GPT-5.6 Sol (정가) | $0.050 | $0.010 | $0.030 | $0.090 |
| GPT-5.6 Sol (프로모션) | $0.040 | $0.008 | $0.020 | $0.068 |
| GPT-6.1 Sol | $0.010 | $0.004 | $0.010 | $0.024 |
| Claude Opus 5 | $0.050 | $0.010 | $0.025 | $0.085 |
| Claude Opus 5.5 | $0.020 | $0.008 | $0.020 | $0.048 |
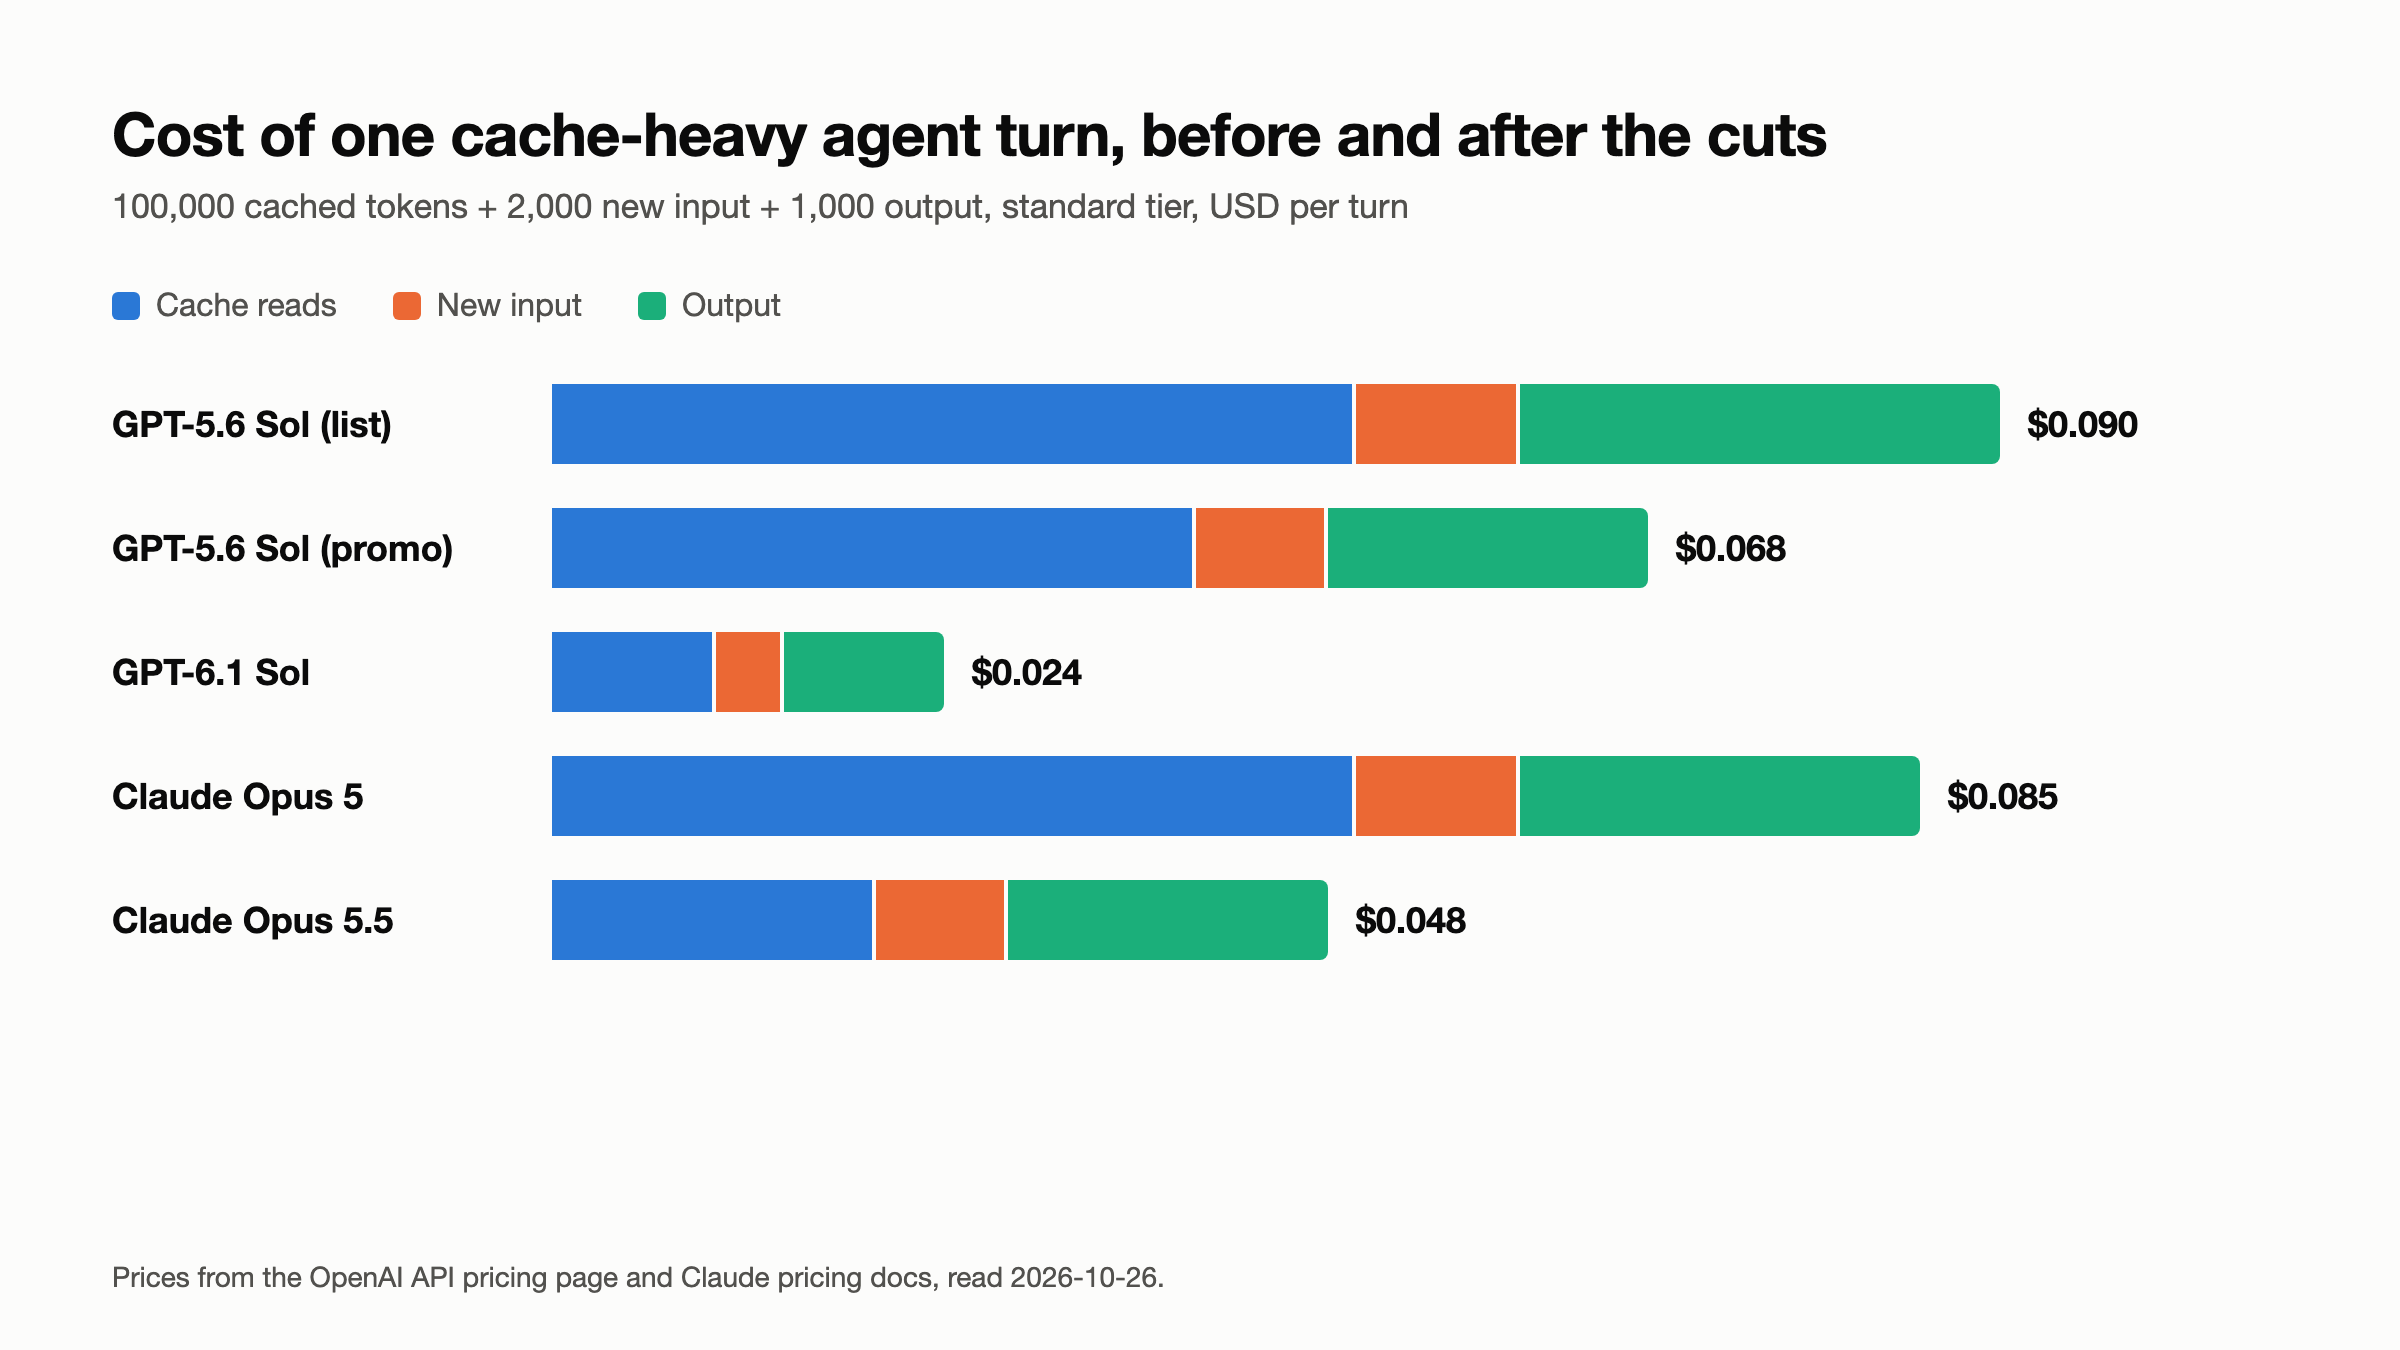
이 턴에서 GPT-6.1 Sol은 GPT-5.6 Sol 정가보다 73% 저렴하며, Opus 5.5는 Opus 5보다 44% 저렴한데, 이는 Anthropic의 40%에 근접합니다. 구형 모델에서는 캐시 읽기가 턴의 절반 이상을 차지했으므로, 이제 에이전트에게 중요한 숫자는 캐시 읽기 가격입니다. 그래서 Fable 5.1의 캐시 전용 인하가 변하지 않은 $10/$50보다 더 중요한 것입니다. Opus 5.5 캐싱 손익분기 계산과 GPT-6 프롬프트 캐싱 가이드를 참고하세요.
바꿔야 할 것: 정가 입력 가격이 아니라 실제 캐시 적중률에서의 턴당 비용으로 모델 순위를 매기세요.
대량 분류기
이제 라우터나 분류기를 살펴봅시다: 하루 100만 건의 요청, 각각 1,500 입력 토큰과 200 출력 토큰, 캐싱 없음.
- 7월 30일 이전 GPT-5.6 Luna: 15억 입력 × $1 + 2억 출력 × $6 = $2,700/일
- GPT-6 Luna: $150 + $100 = $250/일
- Claude Haiku 4.5: $1,500 + $1,000 = $2,500/일
- Claude Haiku 5.5: $150 + $100 = $250/일
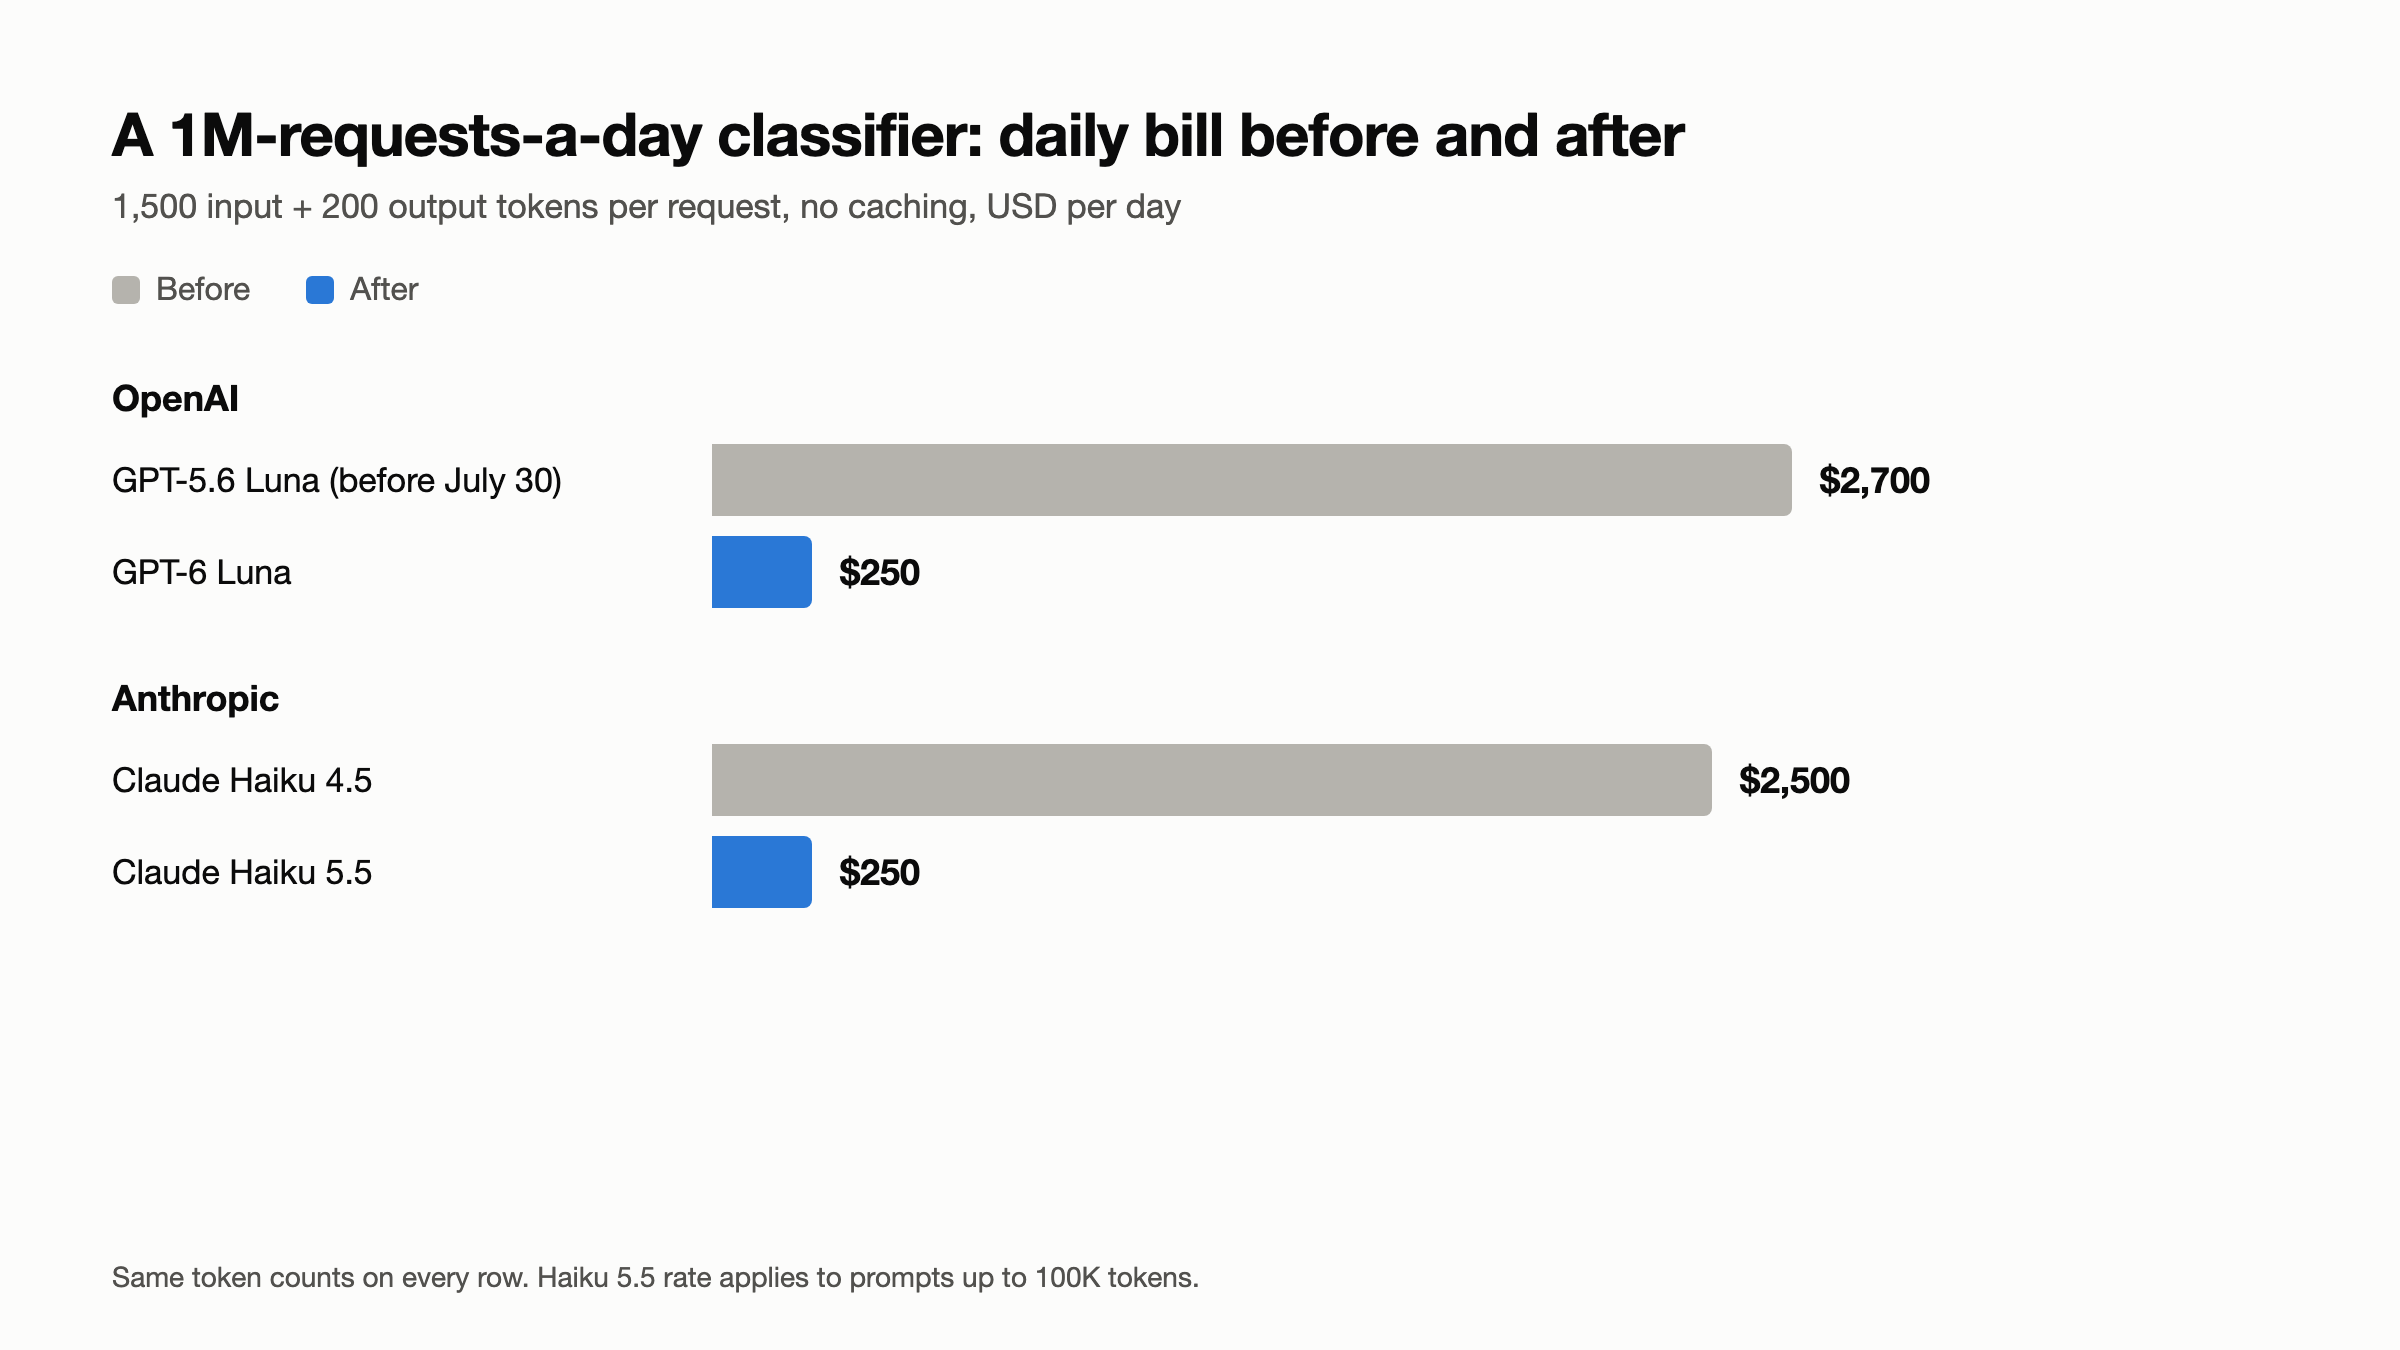
바꿔야 할 것: 소형 모델용 프롬프트를 줄이는 것을 멈추고, 중간 티어 트래픽이 이제 소형 모델에 맞는지 테스트하세요. 먼저 평가 세트를 실행하세요: 토큰당 가격은 여러분의 데이터에서의 정확도에 대해 아무것도 말해주지 않습니다.
배치: 금액은 줄고 비율은 그대로
둘 다 비동기 작업에 여전히 50% 할인을 적용합니다: Anthropic의 Batch API는 입력과 출력을 절반으로 줄이고, OpenAI의 Flex/Batch 티어는 캐시된 입력을 포함한 모든 것을 절반으로 줄입니다 (GPT-6.1 Sol: $1 / $5 / $0.05). 위의 분류기에서 배치는 이제 하루 $125를 절약합니다. 소규모 워크로드의 경우 추가 큐잉 인프라를 정당화하지 못할 수 있지만, 대규모의 경우에는 OpenAI Batch API 가이드가 여전히 유효합니다.
여전히 청구서를 부풀리는 함정
캐시 쓰기는 입력보다 비쌉니다. Anthropic은 5분 쓰기에 기본 입력의 1.25배, 1시간 쓰기에 2배를 부과합니다. OpenAI의 표에도 쓰기 열이 있습니다: 30분에 1.25배, 12시간에 2.5배 (GPT-6.1 Sol: $2 입력에 대해 $2.50과 $5). 접두사를 쓰고 한 번도 읽지 않으면 캐시를 쓰지 않는 것보다 25%에서 150% 더 비쌉니다. 읽기가 입력의 5%일 때, 짧은 쓰기는 한 번의 읽기 후에, 긴 쓰기는 두 번의 읽기 후에 이득을 봅니다.
롱 컨텍스트 배수. GPT-6.1 Sol과 GPT-6 Luna에서 OpenAI의 모델 페이지에 따르면 272K 입력 토큰을 초과하는 프롬프트는 "전체 요청에 대해" 입력 및 캐시 요율의 2배, 출력의 1.5배로 책정됩니다. Claude Haiku 5.5는 100,000 프롬프트 토큰을 초과하면 $0.10/$0.50에서 $0.50/$2.50으로 뛰며, Anthropic은 캐시 읽기와 쓰기도 이 임계값에 포함합니다. 다른 Claude 4.6 이후 모델은 전체 1M 윈도우를 표준 요율로 청구합니다. 핫 경로에서 프롬프트 하나가 너무 커지면 절감액이 사라질 수 있습니다.
추론 토큰은 출력 토큰입니다. OpenAI의 추론 가이드에 따르면 추론 토큰은 "출력 토큰으로 청구"되며 usage.output_tokens_details.reasoning_tokens에 표시됩니다. 응답은 눈에 보이는 출력이 나오기 전에 max_output_tokens에 도달할 수 있으며, 그래도 비용을 지불합니다. Anthropic의 사고 비용 문서는 보이는 요약이 아니라 전체 사고에 대해 청구하며, 이는 usage.output_tokens_details.thinking_tokens에 보고됩니다. 출력은 모든 행에서 비싼 쪽이므로, 노력 설정이 모델 선택보다 청구서를 더 많이 움직일 수 있습니다.
지역 할증. OpenAI는 2026년 3월 5일 이후 출시된 모델에 지역 처리(데이터 레지던시)에 대해 10%를 추가하고, FedRAMP 엔드포인트에 10%를 추가합니다. Anthropic은 inference_geo: "us"를 설정하면 1.1배 승수를 적용하며, Bedrock과 Google Cloud의 지역 엔드포인트는 글로벌 엔드포인트보다 10% 프리미엄이 붙습니다.
토크나이저와 프로모션. Anthropic의 문서에 따르면 Claude 4.7 이후 모델은 Sonnet 4.6 이전 모델보다 같은 텍스트에 대해 약 30% 더 많은 토큰을 생성하는 토크나이저를 사용하므로, 같은 텍스트에서 Haiku 4.5에서 Haiku 5.5로의 인하는 90%보다 87%에 더 가깝습니다. 그리고 프로모션 요율을 유지하기 위해 gpt-5.6-sol을 고정했다면, 2026년 11월 21일을 달력에 표시해 두세요.
Apidog CLI로 코딩 에이전트가 LLM 호출에 비용 검증을 추가하게 하세요
가격은 매달 바뀌고, 토큰 수는 누군가 프롬프트를 편집하거나 노력 설정을 높일 때마다 바뀝니다. 지속적인 해결책은 호출이 예산을 초과할 때 실패하는 테스트를 모든 풀 리퀘스트에서 실행하는 것입니다. Claude Code, Codex 또는 Cursor가 Apidog CLI로 이를 작성하게 하세요.
CLI와 에이전트 스킬을 한 번 설치하세요:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그런 다음 에이전트에게 프롬프트 하나를 주세요:
In Apidog project <id>, create an environment "openai" with base URL https://api.openai.com
and an endpoint POST /v1/responses. Add a test case that sends our support-ticket summary
prompt to gpt-6.1-sol and asserts: HTTP 200, usage.output_tokens at most 1500 and
usage.output_tokens_details.reasoning_tokens at most 1000. Use an API key variable,
not a literal. Run it and summarize any failures.
에이전트는 각 페이로드 스키마를 읽고, 작성 전에 검증하고, 케이스를 실행합니다:
apidog environment create openai --project <id> --base-url https://api.openai.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog test-case category --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
예산은 케이스의 postProcessors에 JSONPath에 대한 검증으로 존재하며, test-case-create 스키마의 isAtMost 및 isAtLeast와 같은 비교를 사용합니다:
{
  "type": "assertion",
  "defaultEnable": true,
  "enable": true,
  "data": {
    "name": "output tokens under budget",
    "subject": "responseJson",
    "comparison": "isAtMost",
    "value": "1500",
    "path": "$.usage.output_tokens"
  }
}
Claude의 경우 엔드포인트를 /v1/messages로 지정하고 $.usage.output_tokens와 $.usage.output_tokens_details.thinking_tokens에 대해 검증하세요. 그런 다음 같은 호출을 두 번 수행하고 두 번째 응답의 $.usage.input_tokens_details.cached_tokens(OpenAI) 또는 $.usage.cache_read_input_tokens(Claude)가 0보다 큰지 검증하는 테스트 시나리오를 요청하세요. 누군가 캐시된 접두사를 깨뜨리면, 청구서가 도착하기 전에 빌드가 실패합니다. -d로 대표적인 프롬프트를 제공하고, CI 시크릿에서 --env-var로 API 키를 전달하고, 파이프라인에서 -r junit을 사용하세요 (CI/CD 가이드). Claude Code에서의 Apidog CLI는 에이전트 설정을 다룹니다.
FAQ
OpenAI와 Anthropic이 정말 가격을 80% 인하했나요? 한 모델에 대해서는 그렇습니다: GPT-5.6 Luna는 2026년 7월 30일 $1/$6에서 $0.20/$1.20으로 인하되었습니다. 다른 대부분의 인하는 더 저렴한 후속 모델에서 비롯됩니다.
인하가 Claude Code와 Codex 구독에도 적용되나요? 가격 페이지는 API를 다룹니다. Woolf는 절감액이 구독 하네스에도 도달한다고 말하지만, OpenAI가 Codex의 $200 티어 사용 허용량을 절반으로 줄였다고도 보고하므로, 여러분의 플랜 한도를 확인하세요.
GPT-5.6 Sol 가격은 영구적인가요? 아닙니다. 최소 2026년 11월 21일까지의 프로모션입니다. 어차피 GPT-6.1 Sol이 더 저렴합니다.
지금 에이전트 청구서를 줄이는 가장 저렴한 방법은 무엇인가요? 캐시 적중률을 높이고 추론 노력을 낮추세요. 캐시 읽기가 긴 세션을 지배하며, 추론은 출력 요율로 청구됩니다.
다음 단계
가장 많이 사용하는 세 가지 LLM 호출에 대해 비용 계산을 다시 실행한 다음, 에이전트가 각각에 대해 토큰 예산 테스트를 추가하게 하세요. 시작하려면 Apidog를 다운로드하세요.